TurboT2VA: Score-Regularized Consistency Distillation for Fast Large-Scale Text-to-Video-Audio Generation
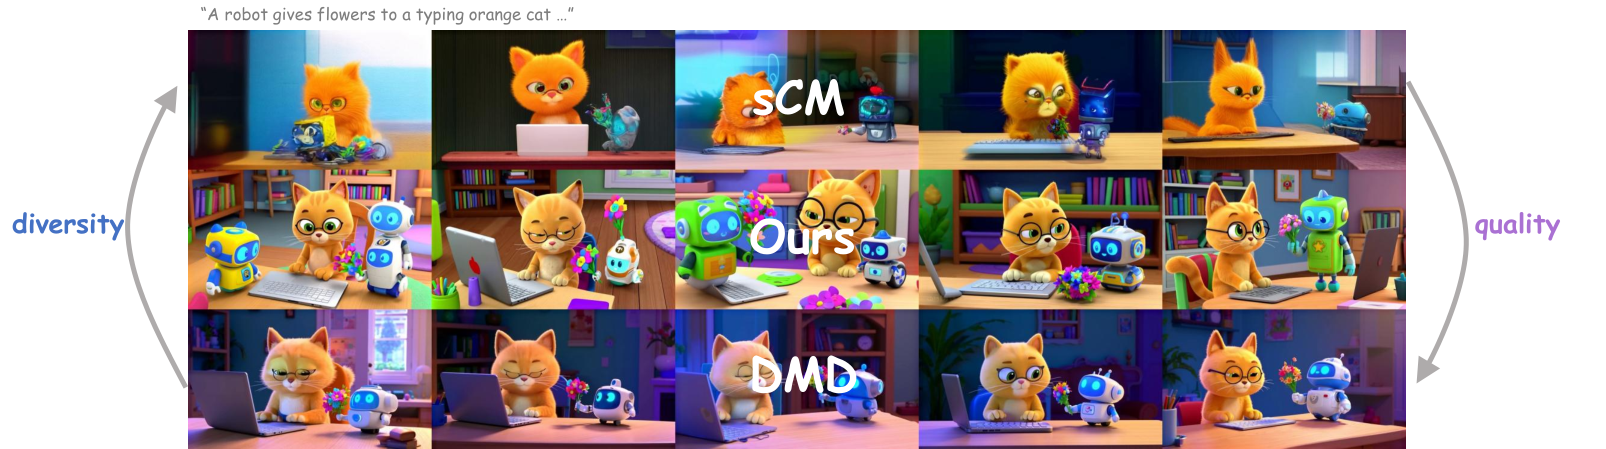
Joint text-to-video-audio generation is prohibitively expensive. TurboT2VA distills a 19B joint video-audio model via per-modality normalization and a progressive curriculum (discrete consistency warm-up, continuous refinement, joint consistency-distribution matching). On LTX-2, four-step distillation cuts 512x768 latency from 50.52s to 2.51s (20.1x) while preserving quality, audio fidelity, diversity and AV sync; an architecture-aware stack (guarded W8A8, fused ops, padded-text compaction, modality-aware sparse attention) reaches 5.83s from 318.74s at 1024x1792 on one H20 (54.67x).
Xiaoda Yang, Yuxiang Liu, Kaiwen ZhengAug 25, 2026
arXivTurboT2VAText-to-Video-AudioAug 25, 2026