ModularRSI:走向可泛化的 Harness 递归自我提升
ModularRSI 把 agent harness 拆成五个功能模块,用 2000 条与下游基准隔离的演化实例、对比轨迹诊断和验证门做独立演化,再合并模块。TB 演化 harness 在 Terminal-Bench 2.0 上把 Acc 从 47.57 提到 52.43,且改进能跨领域迁移到 SWE-Bench Verified,并跨模型迁移到 GLM-5.2、MiniMax-2.5 与不同 DeepSeek 版本。
一句话总结:现代智能体不只是基础模型本身,它的能力还取决于控制交互、观察、上下文、工具和任务完成判定的 harness。ModularRSI 关注的是:这样的 harness 能否从独立执行经验中改进,并且仍然迁移到未见任务、未见领域和不同基础模型?作者把演化与评测严格分开,构建了与下游基准不重叠的 2000 条演化实例,独立演化五个功能模块,验证每一处修改,然后展示合并后的 harness 在 Terminal-Bench 2.0 上把准确率从 47.57 提升到 52.43,并在跨领域、跨模型评测中保持增益。
作者:Siwei Wu, Jincheng Ren, Yizhi Li, Haau-Sing Li, Chengran Yang, Weicheng Gu, Yuxuan Zhang, Jian Yang, Riza Batista-Navarro, Chuanyi Zhang, Ming Zhou, Bryan Dai, Chenghua Lin。
* 共同一作;† 项目负责人;⋄ 通讯作者。¹ 北京航空航天大学;² University of Manchester;³ IQuest Research;⁴ M-A-P;⁵ Langboat;⁶ 河海大学。
1. 什么时候,harness 的改进才算真正泛化?
1.1 上升曲线还不等于自我提升
近年来的 agent self-improvement 展示了一个很有吸引力的图景:保持基础模型冻结,让周围的 agent 系统从执行经验中演化,并观察性能随代际上升 [1, 4, 7, 9–12, 19, 22, 24, 25]。
这在现代智能体中之所以可能,是因为模型只是系统的一部分 [3, 12, 13, 20]。可以把 agent 表示为
$$A=(M,H)$$
其中 $M$ 是基础模型,$H$ 是 harness。$H$ 控制模型如何与环境交互,包括 agent loop、观察处理、上下文管理、工具调用和任务完成判定 [3, 12, 13, 20]。即使 $M$ 保持不变,修改 $H$ 也能大幅改变最终 agent 的能力:
$$(M,H_0)\rightarrow(M,H_1)\rightarrow(M,H_2)\rightarrow\cdots$$
这让 harness 成为递归自我提升的一个实用载体:它可以直接编辑、可以执行,也能用当前 agent 产生的经验反复修改 [1, 9, 10, 19–21, 23]。作者把这一设定称为 Harness Recursive Self-Improvement,也就是 Harness RSI。
表面上看,一条持续上升的演化曲线似乎已经给出了想要的证据:模型不变,周围系统越来越强。但更根本的问题是:agent 究竟变得更强了,还是 harness 只是变得更擅长反复看到的那部分经验?仅靠更高的 benchmark 分数无法区分这两种情况 [17, 18]。
1.2 为什么 Harness RSI 特别容易被隐性过拟合欺骗
Harness 演化很容易陷入一种隐性的 benchmark 专业化。一旦 benchmark 奖励、轨迹或执行反馈被用来指导 harness 修改,benchmark 就不再只是一个评测集。反复交互可能暴露重复出现的任务结构、工具约定、失败模式和有效解题套路。演化出的 harness 因此可能靠越来越适配某个 benchmark 家族来提高分数,而不是学到能泛化到这个家族之外的机制。
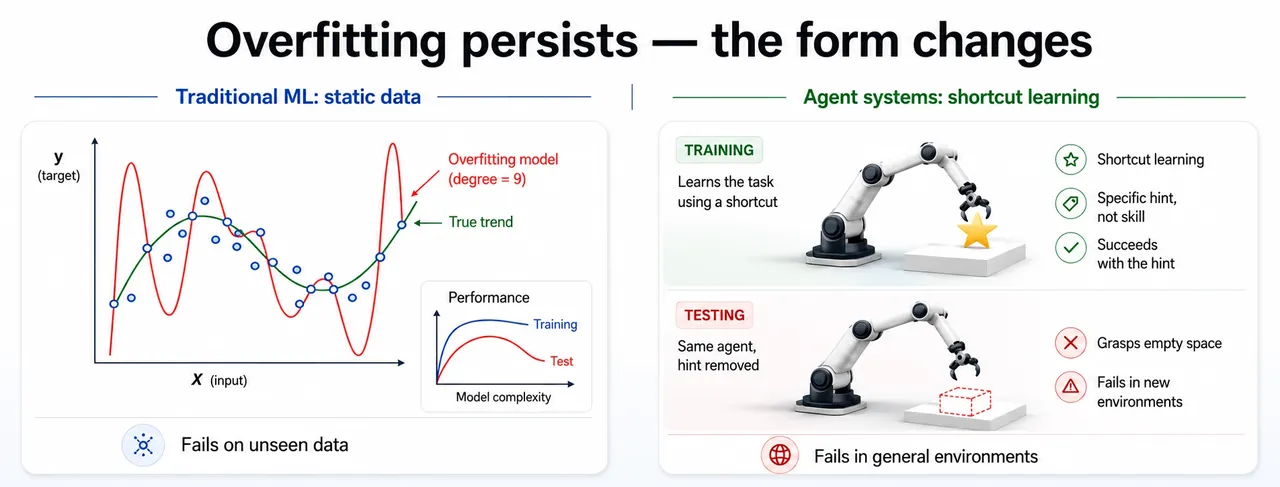
在同一个 benchmark 内做常规 train-test split,也未必能消除这个问题。即使具体实例不重叠,演化子集和评测子集仍可能共享相似的环境、任务格式、工具接口和底层问题分布。harness 可能在实例之间迁移,却没有迁移到整个 benchmark 家族之外。
当演化直接积累成功的 prompt 模式、工具调用启发式或任务专用恢复策略时,问题会更严重 [9–11, 22–25]。这些改动可能提高 benchmark 成绩,却没有修复 agent 底层机制中的普遍缺陷——例如如何控制“推理-行动”循环、如何处理观察、如何管理上下文,或者如何判断任务是否真正完成 [11–13, 18]。
在这种情况下,
$$[\Delta\text{Performance} > 0]$$
并不必然推出
$$[\Delta\text{General Capability} > 0].$$
上升曲线因此可能制造出自我提升的幻觉:系统在产生演化信号的分布上越来越强,但更广泛的问题求解能力几乎没有变化。所以 Harness RSI 的核心问题不是“harness 能否从经验中改进”,而是“它能否从经验中抽取可复用、并在产生经验之外仍然有效的改进”。
1.3 把泛化作为自我提升的判据
只有当改进泛化到产生它的经验之外时,自我提升才有意义 [17, 18, 20]。
Harness RSI 因此必须在一个明确分离演化与最终评测的协议下评估。下游 benchmark 任务、奖励、轨迹和评测反馈不能参与 harness 演化或模型选择;演化得到的 harness 应在下游测试前冻结。
除这一分离外,改进还应在多个迁移层级上检验:
- 未见任务泛化:演化后的 harness 能否改进从未参与演化的完全未见任务?
- 跨领域泛化:在一个任务领域学到的改进,能否迁移到另一个 benchmark 家族和环境?
- 跨模型泛化:替换底层基础模型后,演化出的机制是否仍然有效?
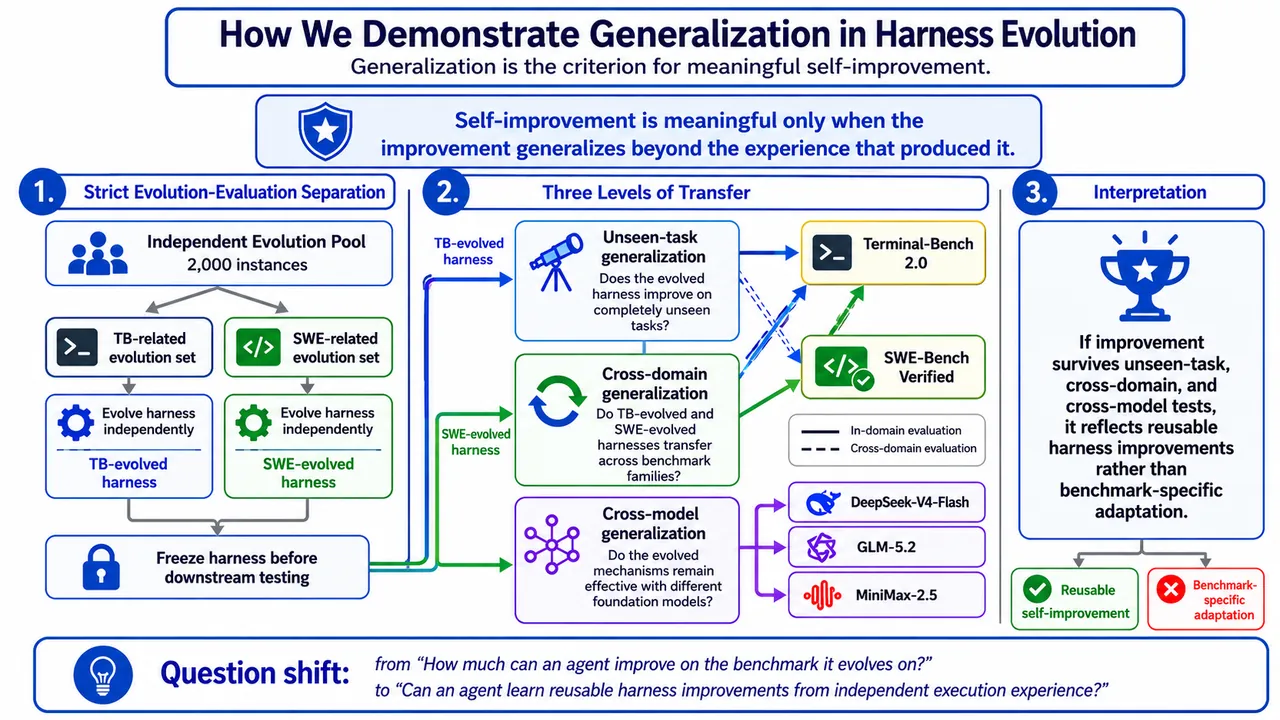
论文因此采用严格的演化-评测分离:先构建与所有下游基准完全不重叠的 2000 条演化实例,再从中分别抽取 TB 相关任务集和 SWE 相关任务集,并各自独立演化 harness。演化结束后冻结,分别在 Terminal-Bench 2.0 和 SWE-Bench Verified 上评测,包括跨领域迁移;还要在不同基础模型上验证。演化与模型选择期间,不使用任何下游 benchmark 任务、轨迹、奖励或评测反馈。
这改变了问题的问法:不再问“agent 能在自己演化的 benchmark 上提升多少”,而是问“agent 能否从独立执行经验中学到可复用的 harness 改进,并且这些改进能迁移到产生它们的数据、领域和模型之外?”接下来,论文用 ModularRSI 回答这个问题。
2. ModularRSI 一览
Harness RSI 的一个核心挑战是:应该从执行经验里学什么。现有方法经常直接用单条轨迹更新 harness,结果可能保留成功的 prompt 模式、工具调用策略或任务专用解题流程。这类更新也许能改进相似任务,但学到的是 benchmark 专用配方,而不是可复用的 harness 缺陷修复。
ModularRSI 转而使用对比轨迹来识别能稳定区分成功与失败执行的行为差异。重复出现的模式更可能揭示控制 agent 行为的机制性弱点,因此所得改进更容易迁移到产生它们的那部分经验之外。
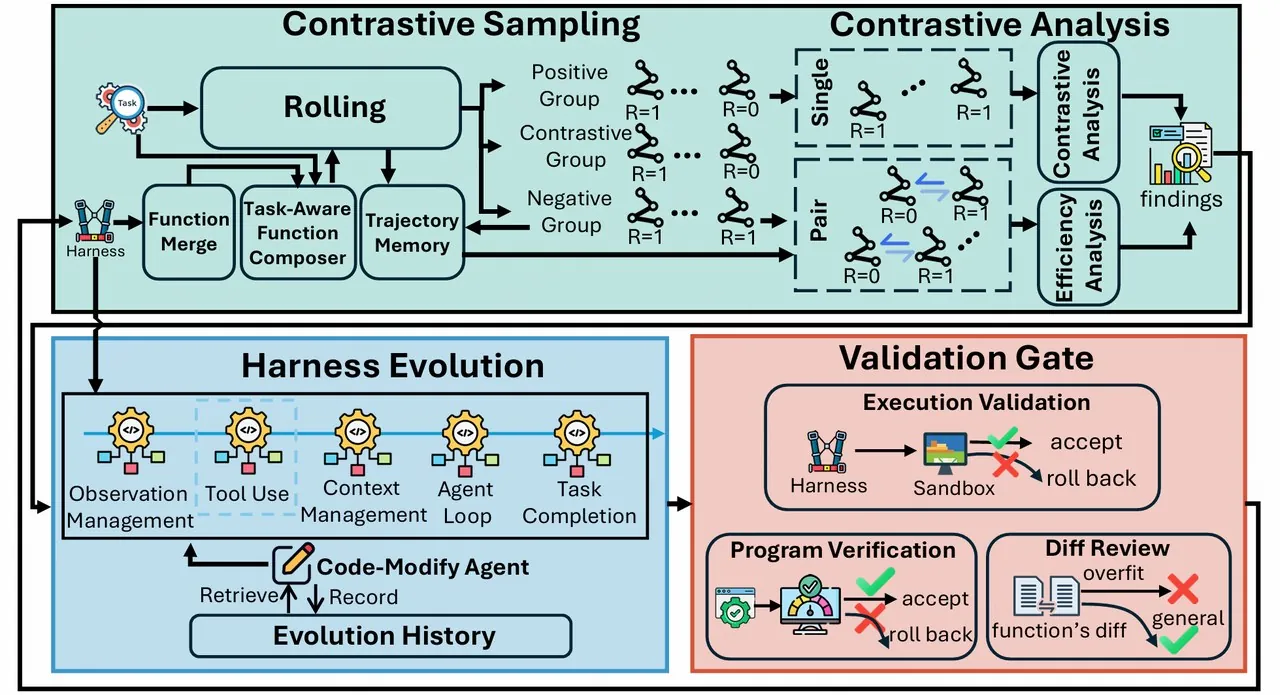
剩下的挑战是定位:即使识别出重复出现的缺陷,也很难确定单体 harness 中该修改哪一部分。ModularRSI 因此把 harness 拆成五个功能模块——Agent Loop、Observation Management、Tool Use、Context Management 和 Task Completion Detection——为“轨迹级证据 → 模块级演化”提供清晰的诊断边界。
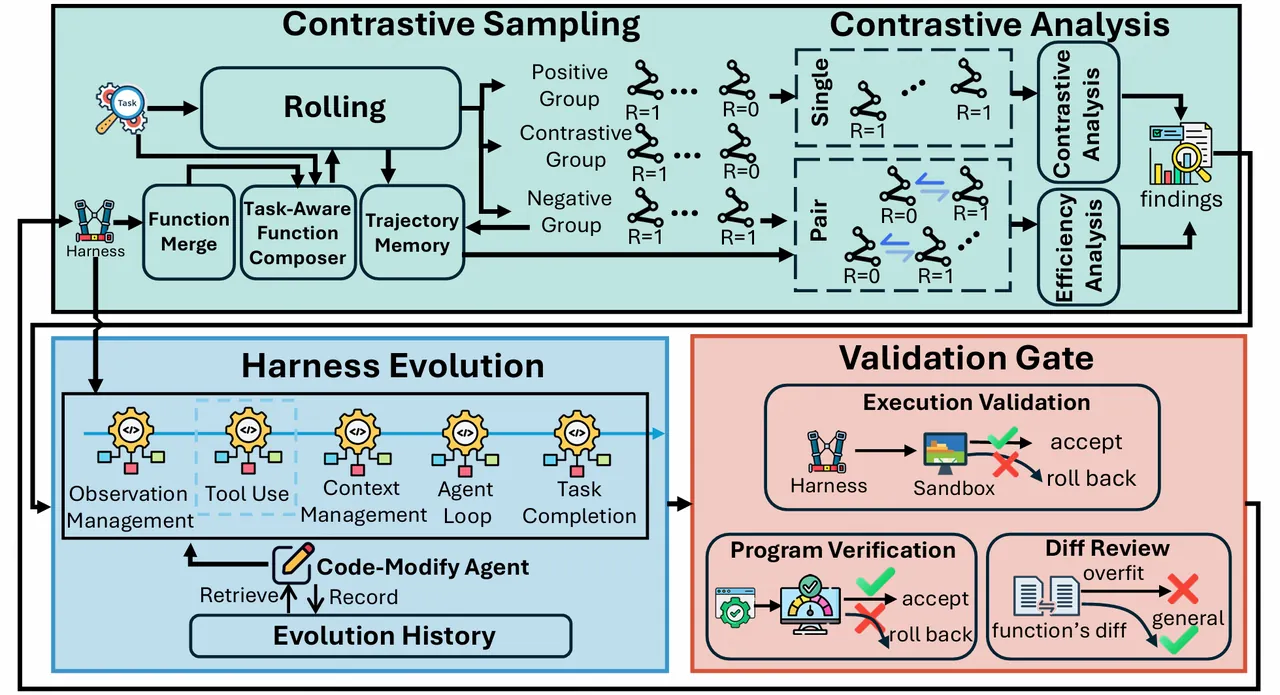
模块化不只方便演化,也是一项实用的 harness 工程原则。显式功能模块让系统能在推理时自适应选择并组合任务相关能力,避免不必要的功能;同时在 RSI 过程中,同一套边界也方便诊断。也就是说,模块化既改善了 harness 应该在哪里演化,也改善了哪些功能应该参与执行。
3. Harness 自我提升究竟有没有泛化?
核心问题不是“在用于演化的经验上性能是否提高”,而是“这些改进能否活到产生它们的经验之外”。按照上面的严格演化-评测分离,论文在三个逐渐更强的迁移维度上评估 ModularRSI:未见任务、未见领域和未见基础模型。
3.1 同一领域和跨领域中的未见任务泛化
首先看 ModularRSI 能否迁移到演化期间完全未见过的任务。作者构建独立 2000 条高质量实例池,从中抽取两个不相交的演化集:120 条 TB 相关实例和 120 条 SWE 相关实例。ModularRSI 分别应用于两个集合,得到 TB 演化 harness 和 SWE 演化 harness。两个演化集都不包含下游 benchmark 的实例。演化后 harness 冻结,并在 Terminal-Bench 2.0 和 SWE-Bench Verified 上评测。演化或模型选择期间不使用任何下游评测任务、轨迹、奖励或反馈。
| 方法 | 演化集 | Benchmark | Acc ↑ | Pass@3 ↑ | Pass₃ ↑ |
|---|---|---|---|---|---|
| Baseline | / | SWE-Bench Verified | 73.40 | 78.00 | 56.00 |
| ModularRSI | TB 相关 | SWE-Bench Verified(跨领域) | 75.80 | 79.20 | 57.60 |
| ModularRSI | SWE 相关 | SWE-Bench Verified(同领域) | 76.45 | 80.20 | 59.00 |
| Baseline | / | Terminal-Bench 2.0 | 47.57 | 58.43 | 30.34 |
| ModularRSI | SWE 相关 | Terminal-Bench 2.0(跨领域) | 49.40 | 60.67 | 30.34 |
| ModularRSI | TB 相关 | Terminal-Bench 2.0(同领域) | 52.43 | 64.04 | 39.33 |
表 1。Terminal-Bench 2.0 与 SWE-Bench Verified 上的结果。Acc 是多次运行的平均成功率;Pass@3 是三次运行至少一次解出的任务比例;Pass₃ 是三次运行全部解出的任务比例。
即便在同一大领域内,评测任务在演化期间也完全未见。TB 演化 harness 把 Terminal-Bench 2.0 准确率从 47.57 提升到 52.43,提高 4.86 个点;SWE 演化 harness 把 SWE-Bench Verified 从 73.40 提升到 76.45,提高 3.05 个点。这说明收益没有局限于产生演化信号的具体实例:harness 能从独立经验中抽取改进,并应用到同领域的新任务上。
3.2 跨领域泛化
只有未见任务迁移还不足以证明一般性的 Harness RSI。同一领域内的任务仍可能共享环境、交互模式和失败模式。所以更强的问题是:任务领域本身改变后,改进是否还存在?
表 1 给出了双向跨领域测试。仅用 TB 相关经验演化的 harness,把 SWE-Bench Verified 从 73.40 提高到 75.80,提升 2.40 个点。反过来,仅用 SWE 相关经验演化的 harness,把 Terminal-Bench 2.0 从 47.57 提高到 49.40,提升 1.83 个点。
这些增益小于同领域改进,但两个方向都是正迁移。这更强地说明 ModularRSI 不是只适配演化轨迹来源的任务分布;至少有一部分学习成果处在可复用 harness 机制层面,在领域偏移下仍然有用。
3.3 跨基础模型泛化
通用的 harness 改进不应只是补偿演化时那个基础模型的独特行为。不同模型的规划方式、错误恢复方式、工具 schema 遵循方式和长上下文管理方式都不同。如果演化只是为 DeepSeek-V4-Flash Preview 生成模型专用补丁,那么换模型后收益应当减弱。
为了测试这一点,论文把在 TB 相关集上用 DeepSeek-V4-Flash Preview 演化出的 harness 冻结,然后在 Terminal-Bench 2.0 上分别用 GLM-5.2、MiniMax-2.5 和 DeepSeek-V4-Flash 作为底层基础模型评测。
| 推理模型 | Scaffold | Acc ↑ | Pass@3 ↑ | Pass₃ ↑ |
|---|---|---|---|---|
| GLM-5.2 | Baseline | 59.55 | 70.79 | 46.07 |
| GLM-5.2 | Merge Evolved Modules(本文) | 61.80 | 74.16 | 49.44 |
| MiniMax-2.5 | Baseline | 41.57 | 56.18 | 24.72 |
| MiniMax-2.5 | Merge Evolved Modules(本文) | 44.94 | 57.30 | 30.34 |
| DeepSeek-V4-Flash | Baseline | 47.57 | 58.43 | 30.34 |
| DeepSeek-V4-Flash | Merge Evolved Modules(本文) | 52.43 | 65.17 | 35.96 |
表 2。Terminal-Bench 2.0 上不同推理模型的结果。
演化后的 harness 在三个基础模型上都带来提升,包括从未参与演化的模型。这说明学到的修改不是单纯补偿某个模型的行为,而是捕获了在不同底层模型间仍然有用的机制。三项实验递进地构成更强的泛化测试:
$$\text{未见任务}\rightarrow\text{跨领域迁移}\rightarrow\text{跨模型迁移}.$$
3.4 模块化演化为什么有帮助?
ModularRSI 通过独立演化功能能力来缩小诊断空间。论文提出两个问题:单个模块能否自己学到有用改进?独立模块演化是否比整个 harness 联合演化更有效?
单模块演化 vs 模块合并。不同模块作用于 agent 行为的不同方面。Agent Loop 带来最大的单模块准确率提升,把 Acc 从 47.57 提高到 50.56,增加 2.99 个点。Observation Management 对效率贡献最大,大幅降低平均交互步数。多个模块也提高了以 Pass₃ 衡量的执行可靠性。这些改进并不完全冗余:集成独立演化后的模块,能得到最强的总体准确率和可靠性。
| 方法 | Acc ↑ | Pass@3 ↑ | Pass₃ ↑ | StepNum ↓ |
|---|---|---|---|---|
| Baseline | 47.57 | 58.43 | 30.34 | 34.70 |
| 单模块演化(Context Management) | 49.44 | 61.80 | 31.40 | 35.10 |
| 单模块演化(Tool Use) | 50.19 | 62.92 | 30.34 | 41.28 |
| 单模块演化(Agent Loop) | 50.56 | 64.04 | 34.83 | 40.40 |
| 单模块演化(Observation Management) | 49.81 | 65.17 | 33.70 | 22.50 |
| 单模块演化(Task Completion Detection) | 49.44 | 65.17 | 31.40 | 31.06 |
| Merge Evolved Modules(本文) | 52.43 | 65.17 | 35.96 | 35.57 |
表 3。Terminal-Bench 2.0 上合并演化模块与单模块演化的对比。
独立演化 vs 联合演化。论文还将 ModularRSI 与 Joint All-Module Evolution 对比。后者在单个演化过程中对整个 harness 做诊断和修改。
| 方法 | Acc ↑ | Pass@3 ↑ | Pass₃ ↑ | StepNum ↓ |
|---|---|---|---|---|
| Baseline | 47.57 | 58.43 | 30.34 | 34.70 |
| Merge Evolved Modules | 52.43 | 65.17 | 35.96 | 35.57 |
| Joint All-Module Evolution | 44.19 | 61.80 | 24.72 | 44.34 |
表 4。Terminal-Bench 2.0 上合并演化模块与全模块联合演化的对比。
联合演化不仅没有超过独立演化后的模块,还在准确率和可靠性上低于 baseline。这与 ModularRSI 的动机一致:当所有相互作用的 harness 机制同时被诊断和修改时,定位“哪个能力该改”会困难得多,也更难做有针对性的修改。独立模块演化缩小了诊断范围,使重复出现的轨迹级证据能够先转化成更局部的机制级改进,再进入集成。
3.5 什么样的演化经验支持泛化?
泛化不只取决于 harness 怎么演化,也取决于它从什么经验中演化。ModularRSI 依赖成功与失败轨迹的对比来识别重复出现的缺陷。一条演化实例是否有用,取决于它是否提供有信息量的行为对比。几乎总能解出的任务缺少失败证据;几乎总是失败的任务缺少可与之对比的成功行为。
论文在 SWE 领域构造两种难度分布不同的演化集。实例难度由 8 条轨迹的成功率估计,底层模型包括 MiniMax M2.7、GLM-5.2、DeepSeek-V4-Pro 和 DeepSeek-V4-Flash。
| 难度分布 | 通过率 0–20% | 20–40% | 40–60% | 60–80% | 80–100% |
|---|---|---|---|---|---|
| Medium-centered | 10% | 15% | 50% | 15% | 10% |
| Hard & Easy | 35% | 10% | 10% | 10% | 35% |
表 5。Medium-centered 与 Hard & Easy 两种数据设置。
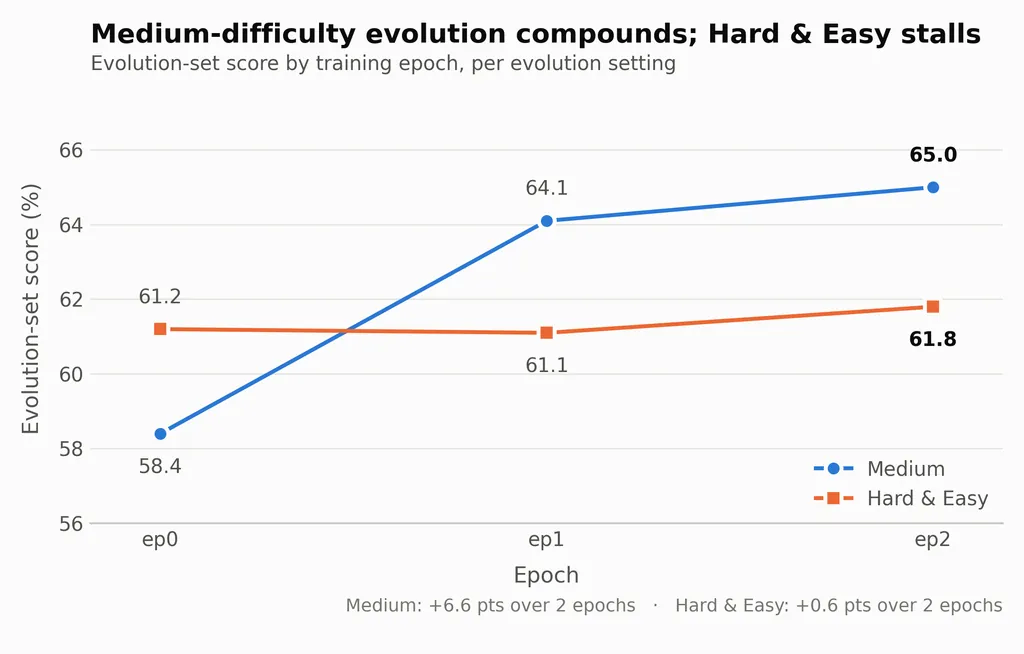
随着演化推进,两种分布产生明显不同的学习动态。在 medium-centered 设置下,演化集性能从 58.4% 提高到 65.0%,增加 6.6 个点;在 Hard & Easy 设置下只提高 0.6 个点。差异还延伸到演化集之外:medium-centered 演化后的 harness 在 SWE-Bench Verified 上达到 76.45 Acc,而 Hard & Easy 只有 74.25。
| 难度分布 | SWE-Bench Verified Acc |
|---|---|
| Medium-centered | 76.45 |
| Hard & Easy | 74.25 |
表 6。不同演化数据分布下得到的 harness 在 SWE-Bench Verified 上的性能。
这支持了 ModularRSI 的对比式动机:有用的演化经验应包含足够的成功与失败行为,以暴露两者之间有信息量且重复出现的差异。演化数据的构成决定了能从执行经验中抽取多少可泛化信号。
4. 深入 ModularRSI
迁移结果说明,执行轨迹里不只有任务专用解法,也暴露了塑造 agent 行为的机制中的重复缺陷。但这些缺陷很难抽取:终端轨迹又长又噪(例如 TACO [4]),失败往往由多个因素共同导致,单体 harness 又带来巨大的修改动作空间。ModularRSI 用四个设计原则应对:模块化搜索、对比证据、受限修改和验证门。
4.1 模块化演化:先拆分 harness,再改进
以前的 Harness RSI 方法通常要求 LLM 一次诊断并修改整个 harness 代码库。由于 harness 中包含许多相互作用机制,全代码库推理会产生很大的搜索空间,也难以定位执行失败的来源。ModularRSI 采用分治策略,把核心机制拆成五个功能模块:
- Agent Loop。控制迭代的“推理-行动-观察”过程和整体执行流。
- Observation Management。处理环境反馈,在过滤、压缩或重组噪声观察的同时保留任务相关信息。
- Tool Use。管理工具选择、调用、参数构造和执行。
- Context Management。维护和组织累积交互历史,包括动作、观察、中间发现和任务约束。
- Task Completion Detection。判断任务是否完成,或是否还需要进一步交互。
这一分解把整体 harness 优化变成局部演化问题。基于轨迹分析,每个被识别的缺陷都会分配到对应模块;后续修改也限制在该模块内的函数中,从而显著减少每步演化的代码上下文和搜索空间。
随着演化引入新函数,系统还通过函数合并和任务感知组合来管理不断扩大的函数空间。函数合并会整理功能重叠的实现;Task-Aware Function Composer 则根据任务描述和函数描述,在执行前选择少量任务相关函数。只有被选中的函数会暴露给 agent。轨迹收集和下游评测使用同一组合机制。
实现上,作者以 Terminus-2 作为初始 harness。它是 Harbor 内实现的终端 agent scaffold,并被按上述五个模块重组。
4.2 从对比轨迹反馈中学习
单条失败轨迹很少能自己说明失败原因。模型可能因为 schema 不清楚而调用无效工具,可能因为关键观察被截断而循环,也可能因为 harness 没有暴露“任务尚未完成”的证据而过早终止。
ModularRSI 因此对每个训练任务运行 $K$ 次,评估结果轨迹,并按结果分成三组:
- 正例组:所有轨迹都成功。即使是成功轨迹,也可能包含重复动作、不必要工具调用或低效交互,因此用来寻找提高效率和鲁棒性的机会。
- 对比组:既有成功也有失败。由于轨迹解决同一任务并在同一环境中执行,把不同结果的轨迹配对并比较执行过程,能提供关于哪些决策或 harness 行为导致成败的证据。
- 负例组:所有轨迹都失败。系统先搜索此前迭代中同一任务的成功轨迹,用它作为对比参照;如果没有,就直接分析失败执行中的重复循环、错误工具调用、糟糕错误处理或过早终止。
分析结果最后被转换成结构化发现。每条发现都识别相关 harness 函数,解释观察到的现象,并提出具体修改建议。
4.3 从重复证据到受限代码修改
分析完一个 batch 中所有任务的执行轨迹后,系统聚合发现,并据此指导 harness 修改。一个 Code-Modify Agent 按三条可靠性原则更新 harness:
第一,基于重复证据选择修改目标。LLM 生成的诊断和建议并不总是正确,验证每条建议又代价太高。系统会聚合 batch 内所有发现,并优先处理最频繁被判定有问题的函数。一个在多个任务和轨迹中反复牵涉的函数,更可能反映系统性弱点,而不是孤立失败。
第二,为每个函数维护演化历史。历史记录过去代码变更以及每次引入的功能。把它提供给 Code-Modify Agent,可以避免重复应用相同修改,或无意回退早期迭代中已验证有效的改进。
第三,施加显式修改范围限制。在更新代码写回 harness 前,系统明确哪些模块或函数可以修改。这能避免无关组件被意外更改,也降低局部改进破坏 harness 核心行为的风险。
这些机制共同让 harness 演化更有针对性、更稳定、更可控。
4.4 验证门
每个 batch 结束时,harness 已根据聚合轨迹发现被修改,但还要评估是否保留这些改动。演化中提出的修改不应无差别合并。每处修改必须通过一串验证门,检查程序正确性、可泛化性和运行时可靠性。
- 程序检查。检查语法、导入、协议合规性、接口契约和基本静态属性。任何违反要求的修改都会立即用记录的代码 diff 回滚。
- Diff 审查。合法修改会被审查,判断它是对 harness 的一般改进,还是只是利用当前 batch 的特定任务。Code-Modify Agent 会检查任务专用解法、常量或难以迁移的启发式。这类修改按过拟合处理并回滚。
- 执行验证。存活的修改在当前 batch 抽出的两个任务上执行。如果修改后的 harness 在任一任务出现运行时错误,整个修改都会回滚。
只有通过全部验证门的修改才会保留,并进入下一轮演化。
4.5 合并演化后的模块
独立演化每个模块后,ModularRSI 将所有通过验证的功能变体集成到统一模块库中。虽然它们在独立演化时都获得了局部改进,但孤立优化可能导致合并后出现职责重叠、状态冲突、接口不一致或行为假设不兼容。
为了处理这些问题,合并系统会在演化集上再做一轮协同适应。agent 分析合并系统的执行轨迹,并做模块间冲突检查,识别重复控制逻辑、不一致接口契约以及模块间负面交互。冲突通过合并冗余功能、澄清模块职责或修改模块间交互逻辑来解决。
所有协同调整仍必须通过程序检查、diff 审查和执行验证。只有不引入明显性能回退或运行时风险的修改才会保留。
5. 演化后的 harness 究竟学到了什么?
聚合 benchmark 分数能说明演化是否有效,但不能说明系统学到了什么。与模型权重更新相比,harness 修改异常可检查:每处保留改动都能追溯到执行证据、以代码形式审查,并关联到后续行为。论文利用这种可见性,研究 ModularRSI 是发现了可复用操作机制,还是只是编码了越来越精细的局部启发式。
5.1 从任务级失败到可复用机制
ModularRSI 的核心转换,是把一个具体失败——某个 agent、某个任务、轨迹中的某一点——变成希望改进未来多次执行的机制。一条失败命令不应变成被记住的替换命令,而应揭示更普遍的缺陷,例如错误恢复不足、进程状态丢失,或在终止前缺少充分验证。这个区别为“演化是在抽象经验,还是在复制经验”提供了定性检验。
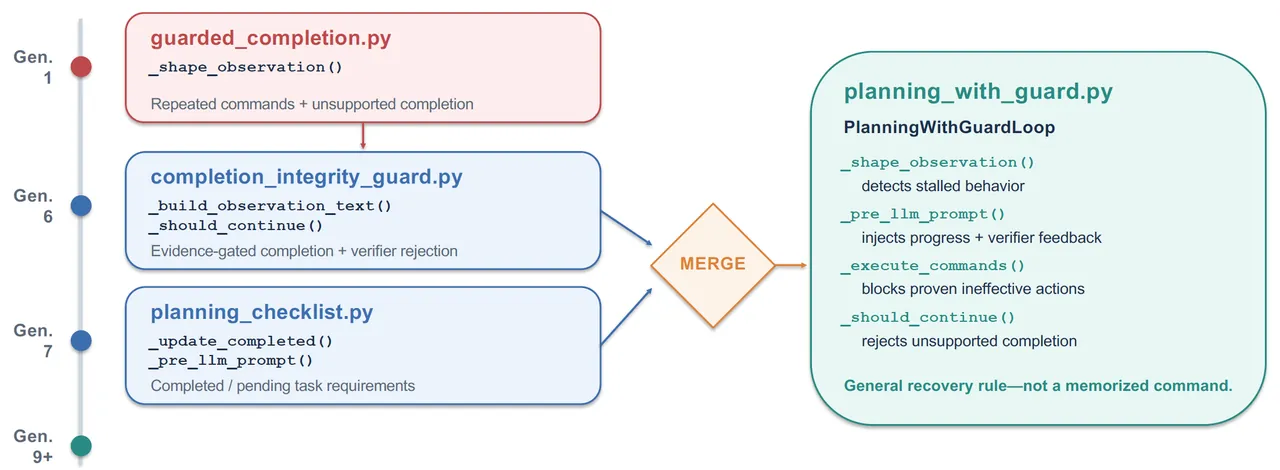
通过检查训练集中的成功和失败轨迹,ModularRSI 在 agent_loop 模块中找到一个重复问题。一次失败中,agent 连续 8 次运行同一条无效命令;随后反复声称任务完成,但 verifier 持续拒绝,最终耗尽执行预算。
ModularRSI 先创建了 guarded_completion。该变体会拒绝证据不足的完成声明,并检测重复命令。后来轨迹暴露出重复格式错误,于是创建了 parse_error_recovery,把上一次畸形输出展示给 agent,帮助它修正格式。
接着,ModularRSI 把完成检查和重复检测合并为 completion_integrity_guard。新的失败显示,agent 可以避开完全重复,但仍通过反复使用 ls、cat、grep 这类只读命令而毫无进展。因此模块被扩展为检测长时间探索却缺少编辑、构建或测试的情况。
随后,ModularRSI 创建 planning_checklist 来跟踪已完成和未完成要求,再把这种规划能力与既有恢复机制合并为 planning_with_guard。后续更新让该模块能使用 verifier 反馈、检测长期停滞,并识别即使命令不同但反复修改同一文件的模式。
每次新失败都暴露了前一个机制的局限。ModularRSI 的回应是改进或合并既有变体,而不是保存任务专用解法。训练集准确率跨三个 epoch 从 51.94% 到 52.50%,再到 54.44%,整体提升 2.50 个百分点。
5.2 为什么局部有用的改进可能互相冲突
模块演化最有信息量的结果之一是:局部改进不一定累加成更好的全局系统。每个模块是在特定周围 harness 中验证的,所以同时改动多个模块可能改变每处修改当初生效的条件。负面干扰因此不只是工程麻烦;它说明递归提升作用于一个耦合系统,组件会改变彼此的有效环境。
一个代表性冲突发生在演化后的 agent_loop 与 verification 模块之间。两者单独都有用:agent_loop 防止过早完成,verification 检查产出是否确实足够。但合并后出现了两个完成门。agent 可能通过其中一个门,却被另一个卡住,反复在“完成声明”和“验证尝试”之间循环,直到任务超时。
ModularRSI 从合并系统轨迹中检测到该冲突,并让 verification 成为任务完成的最终权威。它删除了 agent_loop 中重复的完成门,同时保留有用的恢复行为:验证失败时,把失败原因返回给 agent 以指导下一步。这个案例说明合并不是简单叠加。ModularRSI 必须决定共享责任归哪个模块,保留另一个模块的有用行为,并移除造成全局失败的交互。
5.3 harness 行为与性能的共同演化
为了研究 Harness RSI 是只记住或过拟合特定任务,还是学到对 harness 本身的一般改进,论文评估不同代际演化 harness 生成轨迹的行为质量。一个基于 LLM 的 judge 从五个维度综合评估:任务有效性、交互质量、推理过程可靠性、上下文与状态管理、效率与鲁棒性。论文在 Terminal-Bench 2.0 上比较不同演化代际的 LLM judge 分数与任务成功率。
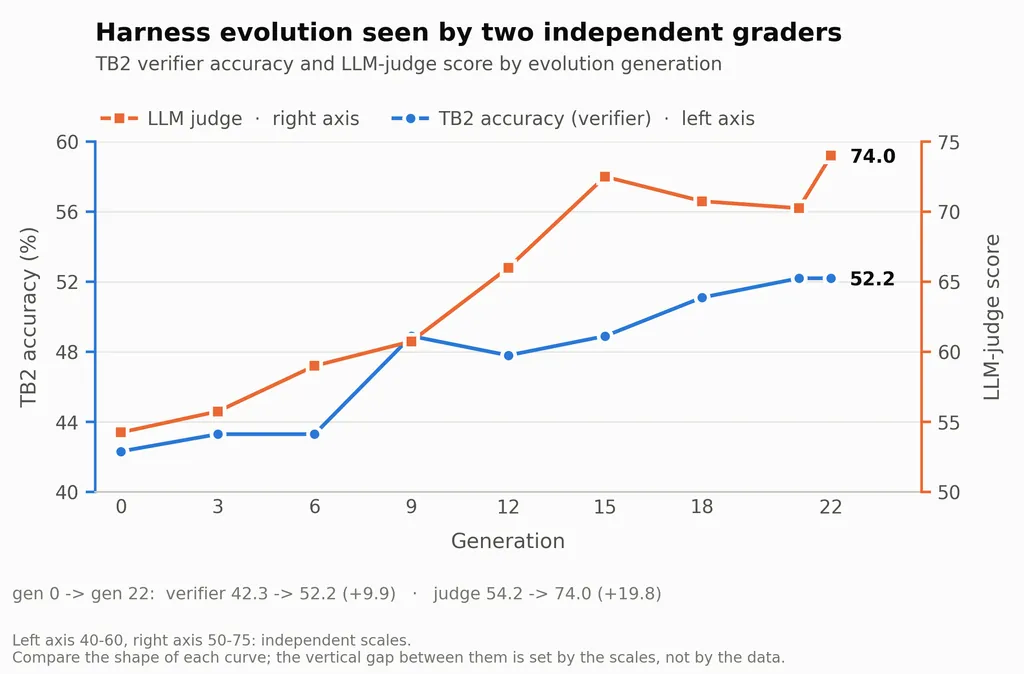
如图 7 所示,演化过程中 Acc 提升趋势与 LLM judge 分数变化高度一致。行为分数与任务准确率之间的对齐说明性能增益伴随着可测量的执行质量变化。这个证据补充了第 3 节的跨任务和跨领域评估,但不能替代它们。
6. 讨论
6.1 与 Gödel Machine 的对应
递归自我提升有一个经典理论参照:Jürgen Schmidhuber 的 Gödel machine。它是第一个完全自指的问题求解器,可以重写自身代码的任意部分,包括决定“重写什么”的那段例程;但它只有在证明重写会提高未来期望效用后才执行重写。这个名字并不含糊:它复用了 Kurt Gödel 1931 年让形式系统编码关于自身陈述的思想,而这正是 Harness RSI 想要的性质。因此,Gödel machine 是判断该设计是什么、以及它刻意放松了什么的最自然标尺。
对应关系可以放在一条轴上看:Gödel machine 是“确定性+证明”,Harness RSI 是概率性的。
- 当 Gödel 构造是确定性的,而这里对应物也是确定性的,对应为 Exact。
- 当 Gödel 侧靠证明得到保证,而这里由于 LLM 的概率性只能靠证据得到,对应为 Relaxed。
- 唯一 Gap 是这种切换的极端形式:公理假定了随机 oracle 不具备的确定性。
这里的 agent 仍是 $A=(M,H)$:冻结模型 $M$ 包裹在可编辑 harness $H$ 中,通过
$$H_t \rightarrow \tau_t \rightarrow F_t \rightarrow \Delta H_t \rightarrow H_{t+1}$$
演化。下表比较了 Gödel machine 与 Harness RSI 中的符号:
| Gödel machine(确定性) | Harness RSI(概率性) | 对应 |
|---|---|---|
| 运行 $p$ 的固定硬件 $F$ | 冻结基础模型 $M$(文本 oracle) | Exact |
| 可重写软件 $p$ | 可编辑 harness $H$ | Exact |
| 与环境交互的子策略 $e$ | $H$ 的五个执行模块(agent loop、tool use 等) | Exact |
| 环境 Env、输入 $x$、输出 $y$ | 任务环境:任务 + terminal/OS + 工具 | Exact |
| 证明搜索器,属于 $p$ | 诊断→修改循环 $\tau_t \rightarrow F_t \rightarrow \Delta H_t$,属于 $H$ | Exact |
| 机器状态 $s(t)$ | 执行轨迹 $\tau_t$ | Exact |
| 候选重写 switchprog | 提议修改 $\Delta H_t$ | Exact |
check() 提交 switch | $\Delta H_t$ 被保留进 $H_{t+1}$ | Exact |
| 标量效用 $u$(期望奖励) | 多维效用(acc、pass@k、steps、robustness) | Relaxed |
| 目标定理,已证明 | 验证门,已通过 | Relaxed |
| 全局最优性定理(无后悔证明) | 泛化判据(held-out 迁移) | Relaxed |
| 公理 $A$:随机性限制在环境($\mu\in M$) | 反转:环境确定性,模型 $M$ 随机 | Gap |
Exact 行几乎覆盖整个架构。它们能干净对应,是因为两侧都是确定性的:可编辑代码、其执行模块、外部环境、机器状态、候选重写和提交步骤,在终端 harness 中与图灵机中一样确定。其中两点赋予 Gödel machine 强大力量的性质,也被 Harness RSI 继承。第一是完整自指:证明搜索器不是特权外层,它位于 $p$ 中,自身可被重写,它的证明也可以修改它。ModularRSI 的诊断和修改机制同样位于它所编辑的模块化 harness 代码库内部;两个系统都没有不可修改的元层,这正是它们与 Hutter 的 HSEARCH、AIXI($t,l$) 这类硬编码元优化器的区别。第二是对自变更的接受测试:Gödel machine 只有在证明目标定理——“现在切换优于继续搜索”——后才提交重写;这带来 Schmidhuber 意义下的全局最优性,是逐决策无后悔性质,而不是渐近效率上限。
Relaxed 行体现了确定性对概率性的切换。它们其实是同一个动作的三个侧面:因为 $M$ 是随机 oracle,无法证明一次自我变更是最优的,只能收集证据说明它有帮助。于是证明变成实证验证——程序检查 → 防过拟合 diff 审查 → 执行验证;标量奖励变成可测量但难以坍缩成单一最优的多维效用;可证明无后悔变成实测泛化——向未见任务、领域和模型的迁移。因此 Harness RSI 不继承那些定理保证:变更可以是贪心的,可能局部有益却全局冲突。这正是 Darwin Gödel Machine 所做的让步:用经验选择替代 Schmidhuber 的证明搜索。所以与原版 Gödel machine 相比,DGM 才是这里构建的东西更近的亲属。
唯一的 Gap 行是同一切换最深层的形式:随机性所在位置被反转。Schmidhuber 把随机性限制在环境,即未知分布 $\mu\in M$,而硬件是确定性的;他随后指出,把随机性推进硬件——概率硬件——才是“最现实”的设定,那里“不存在确定的定理”。当前设定正是这个镜像:terminal 环境基本确定,而“硬件”、模型 $M$ 是随机的。一个忠实的 Gödel-harness 应当基于关于模型的有界概率公理推理,例如“这个 scaffold 以 ≥ $1-\delta$ 的概率产生可解析输出”;论文没有形式化这些公理,而是用对比式 $K$-rollout 分析作为经验估计器。这个 Gap 并不在理论之外,而恰恰是理论已经预见的前沿。
结论刻意不浪漫:Harness RSI 不是 Gödel machine,也不应这样宣传。从“确定性 vs 概率性”这一轴看,它保留了 Gödel machine 的架构,同时只要随机模型介入,就把保证从证明放松为证据。这是发生在 harness 粒度上的 Darwin-Gödel 动作;它也清晰区分了 RSI 的必要要素——自指和对自变更的接受测试——与概率 oracle 的代价——证明 → 验证,确定性 → 泛化证据。
6.2 对现代 AI 辅助软件开发的启发
ModularRSI 的演化循环是 AI 辅助软件开发的经典实例:agent 反复诊断、编辑、验证并合并真实代码库的变更。它的成功与失败为“如何让 agent 可靠地工作在代码库上”提供了实践启发。
第一,为 agent 编辑而组织代码库结构。如表 4 所示,联合演化所有模块收益更低,甚至让效率退化。这里改动之所以可控,是因为每次编辑都限制在声明范围内,并且每个函数有自己的变更历史。清晰的模块边界让 agent 能定位失败,也防止编辑扩散。
第二,合并后也要验证,而不是只在合并前验证。代码变更只在被测试的上下文中得到验证,而合并会改变这个上下文。第 5.2 节就是例子:两个模块各自通过验证,合并后却可能互相阻塞。当多个 agent 并行工作时,代码合并会更频繁,因此集成测试必须独立进行,不能相信“每部分都过了”。
第三,对 agent 写出的改动要审查泛化性,而不只是正确性。朝着通过测试努力的 agent 会走最短路径,而最短路径常常只对眼前的用例有效。论文因此只处理跨任务重复出现的失败,并审查每个 diff 中是否包含任务专用启发式。第 5.1 节展示了预期效果:每次失败都变成可复用机制,而不是一次性补丁。当更多改动来自 agent 时,审查应测试对更广使用场景的泛化,而不只是固定测试用例上的正确性。
6.3 Harness RSI 与 Model RSI 是互补的
改进 harness 不等于说模型学习不重要。现代 AI agent 可以看作基础模型与运行时 harness 的组合,最终性能来自内在模型能力与组织、暴露、部署这些能力的机制之间的交互。近期 agent 系统也表明,可靠行为不只取决于底层模型,还取决于规划、工具交互、上下文管理、记忆和环境反馈等外围组件 [5, 6]。
Model RSI 和 Harness RSI 针对不同的改进来源。Model RSI 通过额外训练、自生成监督或反馈驱动优化扩展底层模型的内在能力,改善知识、推理能力和内部表示。Harness RSI 关注如何引出和部署已有能力。近期研究越来越多地把 harness 层自我提升作为独立方向,包括自动 harness 合成 [7]、端到端 harness 优化 [1]、harness 与模型联合适配 [2],以及可组合或可演化的 harness 框架 [3, 8, 9]。其他工作还研究了上下文管理、运行时接口、执行策略和基于轨迹的 harness 修复等特定 agent 机制 [4, 10–13]。
近期工作进一步说明,这两个优化维度可以联合提升。SkillRL 在强化学习中递归共同演化外部技能库与 agent 策略;ARISE 则通过层级强化学习同时改进可复用技能和底层推理策略 [14, 15]。这些结果说明,harness 层结构可以提供快速适应的外部机制,而参数学习可以逐步强化并泛化支持有效交互的底层能力。
不过,Harness RSI 不能替代 Model RSI。更好的 harness 可以改善能力引出、交互效率和执行可靠性,但无法从根本上克服知识缺失、推理弱或内部表示不足导致的限制。反过来,如果能力没有被有效组织和利用,更强的模型在复杂环境中也可能失败。因此,Harness RSI 和 Model RSI 应视为互补的优化维度:Model RSI 扩展底层模型的能力前沿;Harness RSI 提高这些能力在真实环境中的利用、协调和可靠性。
6.4 局限与开放问题
- 模块间更有效的协调仍是开放挑战。需要进一步方法学工作来实现更高效的共同演化,例如每轮迭代更新所有模块,并让独立演化后的模块合并后取得更强性能。
- 实验对基础设施稳定性要求很高。为了加速评测并保持模型运行之间的一致性,作者通常并发执行许多任务和评测实验。高并发可能降低模型性能,因此报告结果可能低估演化 harness 的真实性能。未来若有足够算力,计划在专用部署设置下独立评测每个 harness。
- 对方法上限的探索仍然有限。后续方向包括使用更大的演化数据集、运行更多演化 epoch、使用更强的模型如 Claude Opus、合并不同领域或任务类型的数据,以及系统控制不同数据来源的比例。
7. 面向 Harness RSI 研究的开放实验场
Harness RSI 需要的不只是一个演化算法,还需要一个共享实验底座,让不同方法在不变更演化/评测边界的前提下可比。作者因此发布 ModularRSI,包括数据、模块化 harness 实现,用于复现实验和发展新的 harness 演化方法。
发布内容包括四个主要部分:
- 一个精选演化数据集。
- 一个模块化 agent harness。
- 一个端到端演化流水线。
- 一个面向泛化的评测协议。
参考文献
- Lee, Y., Nair, R., Zhang, Q., Lee, K., Khattab, O., & Finn, C. (2026). Meta-Harness: End-to-End Optimization of Model Harnesses. arXiv:2603.28052.
- Hebbar, P., Manawat, Y., Verboomen, S., Ivanova, A., Palanimalai, S., Bhatia, K., & Baskaran, V. (2026). SIA: Self Improving AI with Harness & Weight Updates. arXiv:2605.27276.
- Chen, T., Lu, S., Zhao, K., Meng, W., Teng, H., Li, T., Li, C., Liu, X., Liang, J., Zhang, Z., Xie, Y., Qu, H., Shao, K., & Luan, J. (2026). HarnessX: A Composable, Adaptive, and Evolvable Agent Harness Foundry. arXiv:2606.14249.
- Ren, J., Wu, S., Li, Y., et al. (2026). A self-evolving framework for efficient terminal agents via observational context compression. arXiv:2604.19572.
- Wang, Xingyao, et al. (2025). OpenHands: An Open Platform for AI Software Developers as Generalist Agents. ICLR 2025.
- Merrill, Mike, et al. (2026). Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces. ICLR 2026.
- Lou, Xinghua, et al. (2026). AutoHarness: Improving LLM Agents by Automatically Synthesizing a Code Harness. arXiv:2603.03329.
- Chen, Mingju, et al. (2026). HarnessForge: Joint Harness and Policy Evolution for Adaptive Agent Systems. arXiv:2606.01779.
- Du, Yuetian, et al. (2026). Living-Harness Is an Interactive-Agent Evolver. arXiv:2607.26598.
- Zhang, Hangfan, et al. (2026). Self-Harness: Harnesses That Improve Themselves. arXiv:2606.09498.
- Lin, Jiahang, et al. (2026). Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses. arXiv:2604.25850.
- Xu, Tianshi, Huifeng Wen, and Meng Li. (2026). Adapting the Interface, Not the Model: Runtime Harness Adaptation for Deterministic LLM Agents. arXiv:2605.22166.
- Chen, Mengzhuo, et al. (2026). From Failed Trajectories to Reliable LLM Agents: Diagnosing and Repairing Harness Flaws. arXiv:2606.06324.
- Xia, Peng, et al. (2026). SkillRL: Evolving Agents via Recursive Skill-Augmented Reinforcement Learning. arXiv:2602.08234.
- Li, Yu, et al. (2026). ARISE: Agent Reasoning with Intrinsic Skill Evolution in Hierarchical Reinforcement Learning. arXiv:2603.16060.
- Hu, Shengran, Cong Lu, and Jeff Clune. (2025). Automated Design of Agentic Systems. ICLR 2025.
- Wang, Y., Zhu, H., Hu, Z., et al. (2026). Rethinking the Evaluation of Harness Evolution for Agents. COLM 2026 Workshop on Lifelong Agents.
- Zhang, L., Zhou, R., Song, D., et al. (2026). HarnessCompass: Guiding Automatic Harness Evolution toward Generalizable and Effective Agent Harnesses. arXiv:2608.01918.
- Zhang, Y., Dai, Y., Tan, J., et al. (2026). DarwinX: Evolving Agent Harnesses Through Natural Selection. arXiv:2608.07545.
- Ren, Z., Chen, Y., Guo, D., et al. (2026). Self-Improvements in Modern Agentic Systems: A Survey. arXiv:2607.13104.
- Zhang, J., Hu, S., Lu, C., et al. (2026). Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents. ICLR 2026, 104223–104294.
- Pan, W., Liu, S., Lin, C. Y., et al. (2026). Evolving Agents in the Dark: Retrospective Harness Optimization via Self-Preference. arXiv:2606.05922.
- Zhang, J., Gu, Y., Ruan, J., et al. (2026). Harnessing Agentic Evolution. arXiv:2605.13821.
- Zhang, Q., Hu, C., Upasani, S., et al. (2026). Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models. ICLR 2026, 86069–86100.
- Agrawal, L. A., Tan, S., Soylu, D., et al. (2026). GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning. ICLR 2026, 8479–8565.
原文来源:Recursive Self-Improvement Bloghttps://recursive-self-improvement.notion.site/blog-1-modularrsi-toward-generalizable-harness-rsi