LoopWAM:从部署回放中闭环改进的通才机器人策略
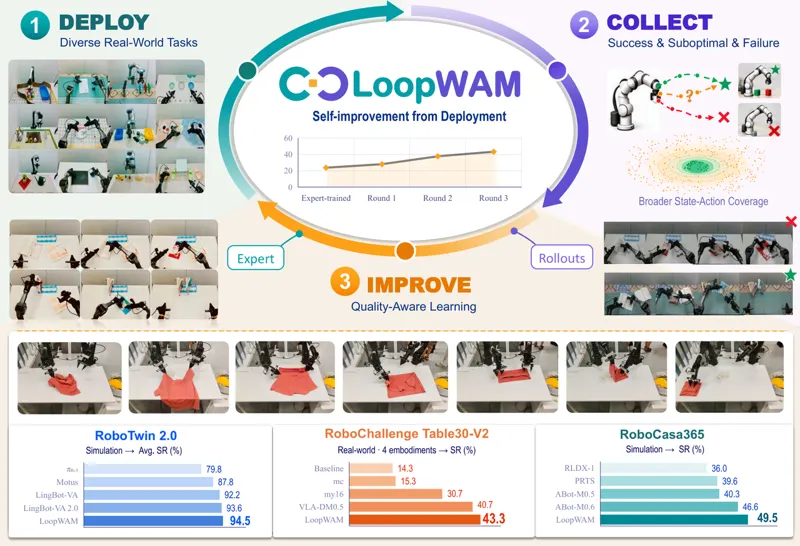
只堆专家示范,通才机器人策略并不会因为「上了真机」就变强:部署回放里既有成功,也有次优动作和彻底失败,逐个动作照抄会把坏行为一起学进去,而把失败样本直接丢掉,又丢掉了物理交互及其后果的证据。LoopWAM 是一个闭环的世界动作模型(world-action model),它直接从这份「全质量谱系」的回放里学习,回放既可以来自它自己,也可以来自别的已部署策略(X-VLA、π0.5)。方法上有三块互相咬合的设计:源相关噪声采样把行为学习与动作条件世界建模统一进同一个联合去噪目标——示范数据只对视频加噪、回放数据只对动作加噪,两条流在每一层的联合注意力里交互,学到的「后果」因此能直接参与动作生成;质量引导把质量分数写进指令后缀 Quality: q,部署时固定取最高档,使同一个模型既能被引导也能被评估;质量加权监督用 λ(q) 调节动作项的模仿强度(q=1,2 为 0.0,q=3 为 0.3,q=4 为 0.6,q=5 为 1.0),视频监督则在全质量段完整保留。模型由 Wan2.2-TI2V-5B 初始化,视频 DiT 30 层 3072 维、动作 DiT 30 层 1024 维,flow matching 训练。结果:RoboChallenge Table30-V2 上三轮「部署—采集—再训练」把成功率从 23.67% 拉到 43.33%(+19.7 个百分点),总分 36.10→56.80;RoboTwin 2.0 平均成功率 94.5%(用 LoopWAM、X-VLA、π0.5 三个策略共 22,500 条回放训练);RoboCasa365 总成功率 14.9%→49.5%,三项基准在对比方法中都是最好,且没有做额外的具身预训练。最难的叠衣服任务上,单任务后训练之后再跑两轮部署驱动改进,成功率从 13.20% 升到 55.56%。消融显示:完全不做质量引导只有 72.3%,粗粒度标注加上质量加权动作监督才到 94.5%。项目页 https://loop-wam.github.io/