让你的 Agent Harness 自我修复
可观测性只回答「发生了什么」,生产环境的真正成本在其后:为什么坏、怎么修、如何不再坏。本文给出四层自修复栈:Tracing、Ollie 诊断改码、回归锁定测试与 Agent 沙箱。
当 AI agent 在生产环境里出错时,可观测性工具会精确地告诉你它做了什么,却几乎不告诉你该怎么修。
你会拿到一条干净的 trace:每一次模型调用、每一个被触发的工具、每一步花了多久、消耗了多少 token。
你拿不到的是:它为什么坏、哪一处改动能修好它、以及任何保证下周不会再犯。
于是你逐 span 翻 trace,对出错原因形成一个猜测,手写一个 patch,然后祈祷它别把之前能跑的东西弄坏。
接着新模型发布,带来一批全新的失败模式,你又把这套手工循环从头跑一遍。
真正的瓶颈不是可观测性本身,而是 trace 落到你屏幕上之后必须发生的一切。
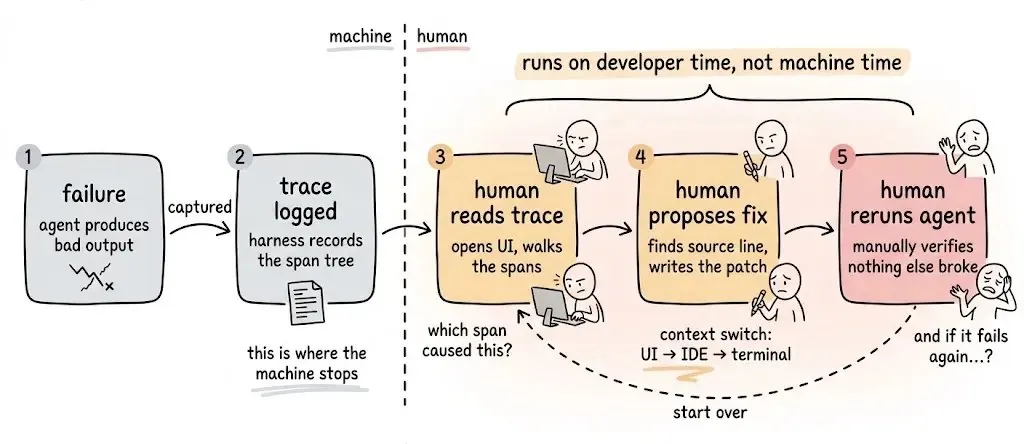
Cursor 最近分享了他们在 agent 外围 harness 上投入的工程量:包裹在裸模型之外的那一层 prompt、工具与检查。同一个模型配上更好的 harness,结果会好得多,而这项工作永远不会真正结束。
这正是所有可观测性平台把你留下的地方:它回答「发生了什么」,然后把「为什么发生」「该改什么」「如何不再坏」交还给你。
这个缺口就是今天大多数团队困在其中的循环。下面是它为何反复裂开,以及最终需要什么才能合上。
为什么现有可观测性在规模下失效
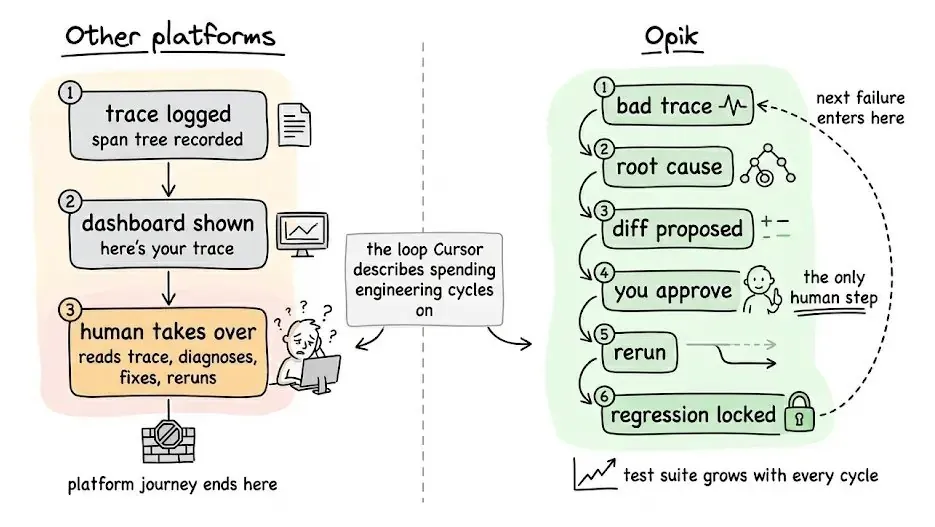
大多数 agent 可观测性平台交付一条 trace 然后就停了。
你得到 span 树、延迟数字、token 成本和一个 dashboard。你得不到的是:为什么失败、该修什么、以及任何它不会再坏的保证。
- 「发生了什么」 → 平台负责
- 「为什么发生」 → 手工
- 「这是修复方案」 → 手工
- 「这不会再坏」 → 手工
在 2023 年,这是一个合理的产品。对今天在生产环境跑 agent 的团队来说,它是错误的抽象。
问题会自我叠加:每一次模型升级引入新的失败模式,每一个新工具增加新的边界情况。harness 变复杂的速度,快过任何团队手工追踪与修复的速度。
下面是能做到这件事的那套栈。
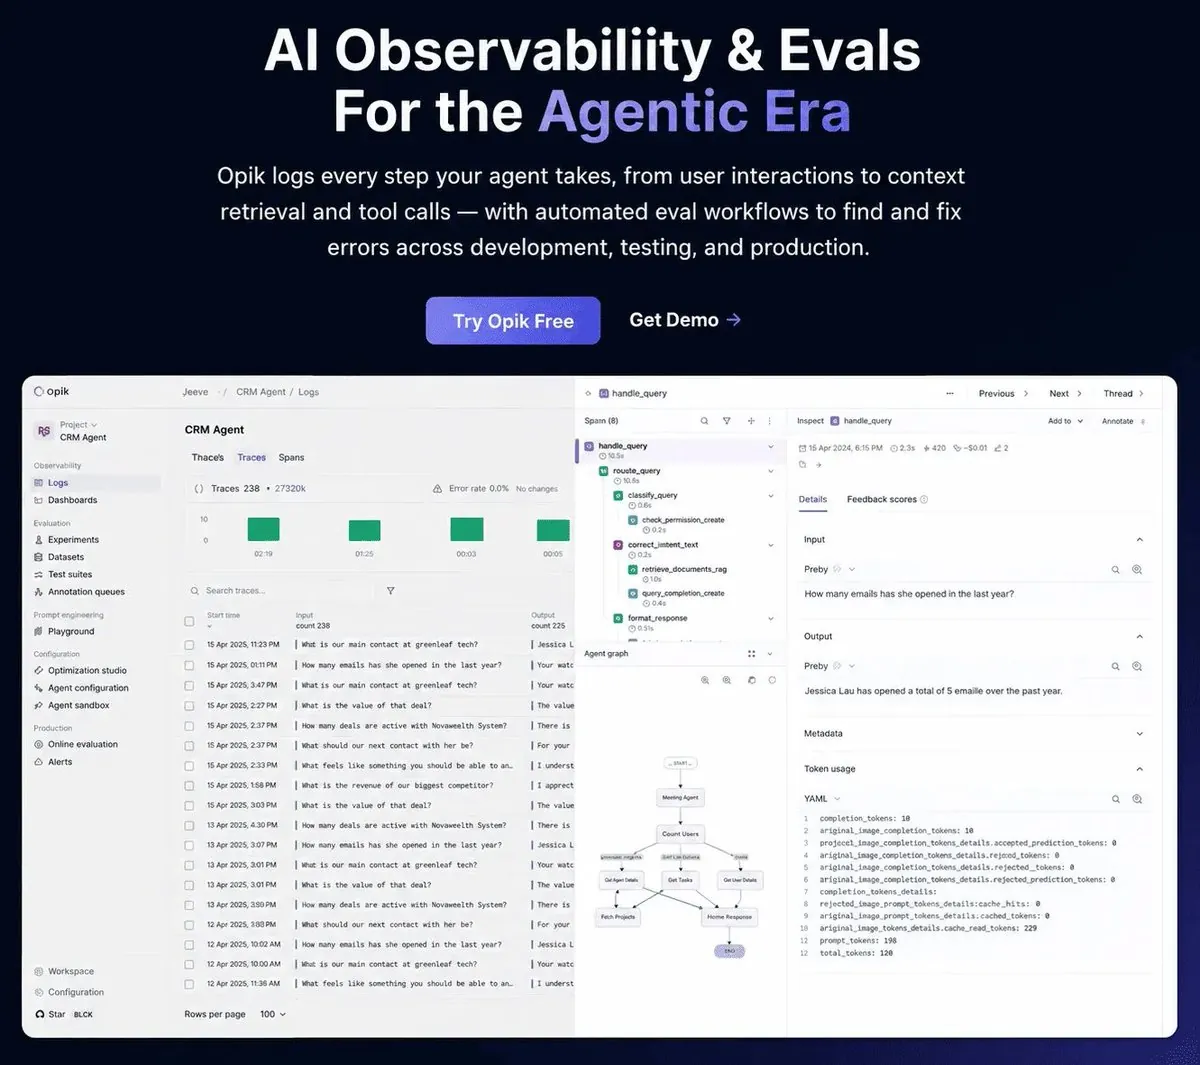
Opik:面向 agentic 时代的 AI 可观测性与评测
Opik 是一个开源的日志、调试与优化平台,面向 AI agent 与 LLM 应用。它围绕一个前提构建:这个循环应当被自动化,而不是靠人盯着。
四层栈
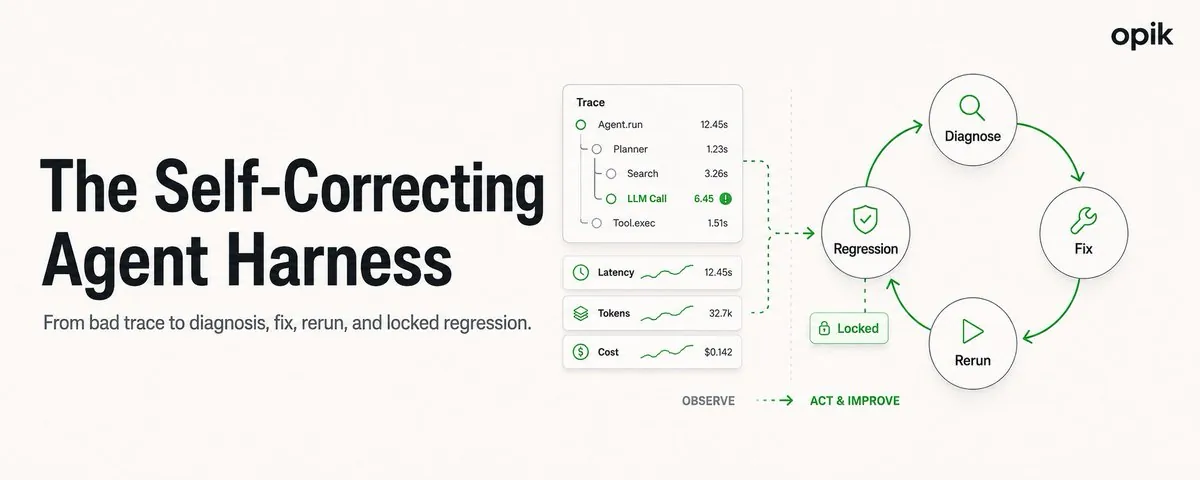
Opik 的架构是一条连通的工作流:
Trace → Ollie 诊断 → Ollie 提出修复 → 修复被应用并验证 → Test Suite 把失败锁成回归测试 → 回到 Trace。
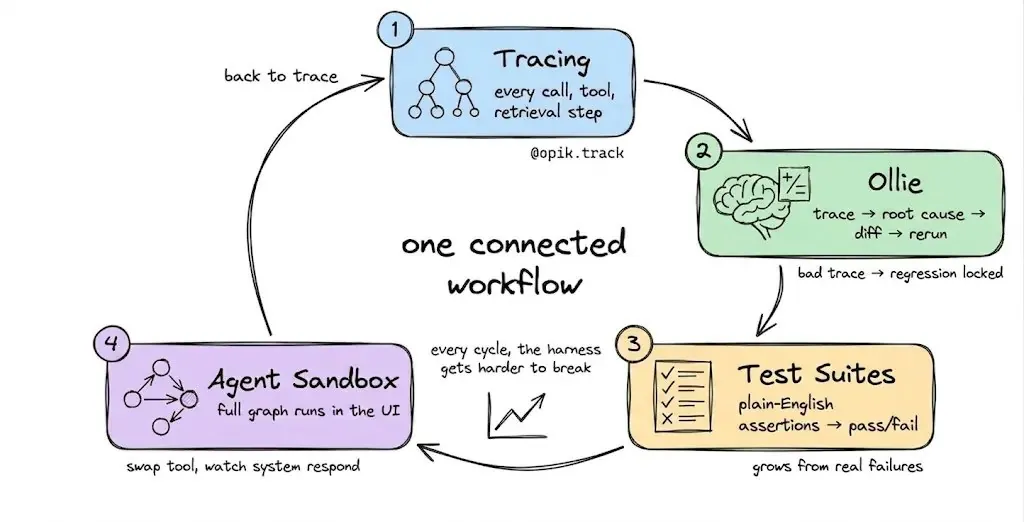
逐层来看。
第 1 层:Tracing
每一次 LLM 调用、工具调用与检索步骤,都用一个装饰器自动插桩。
import opik

@opik.track
def my_agent(query: str):
    # your agent logic here
    ...
开箱即用地支持 LangGraph、CrewAI 与 50+ 框架。每条 trace 都记录当时生效的 agent 配置,日后需要重跑失败输入时可以完整复现。
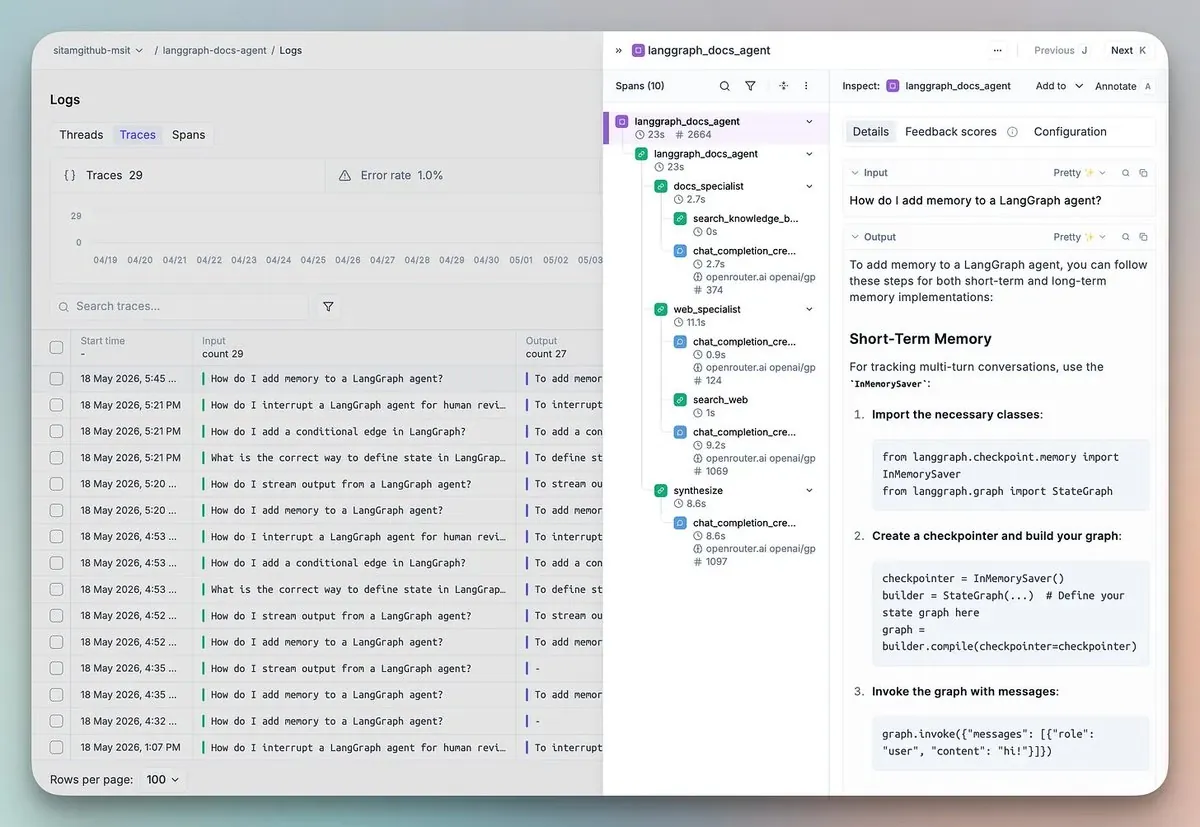
这给你完整的可见性。但可见性本身修不好任何东西,于是有了第 2 层。
第 2 层:Ollie
其他可观测性平台停在「这是你的 trace」。Opik 从 trace 走到修好的代码,靠的是 Ollie。
Ollie 是内置在 Opik 里的编码 agent:一个 agent,完整上下文。
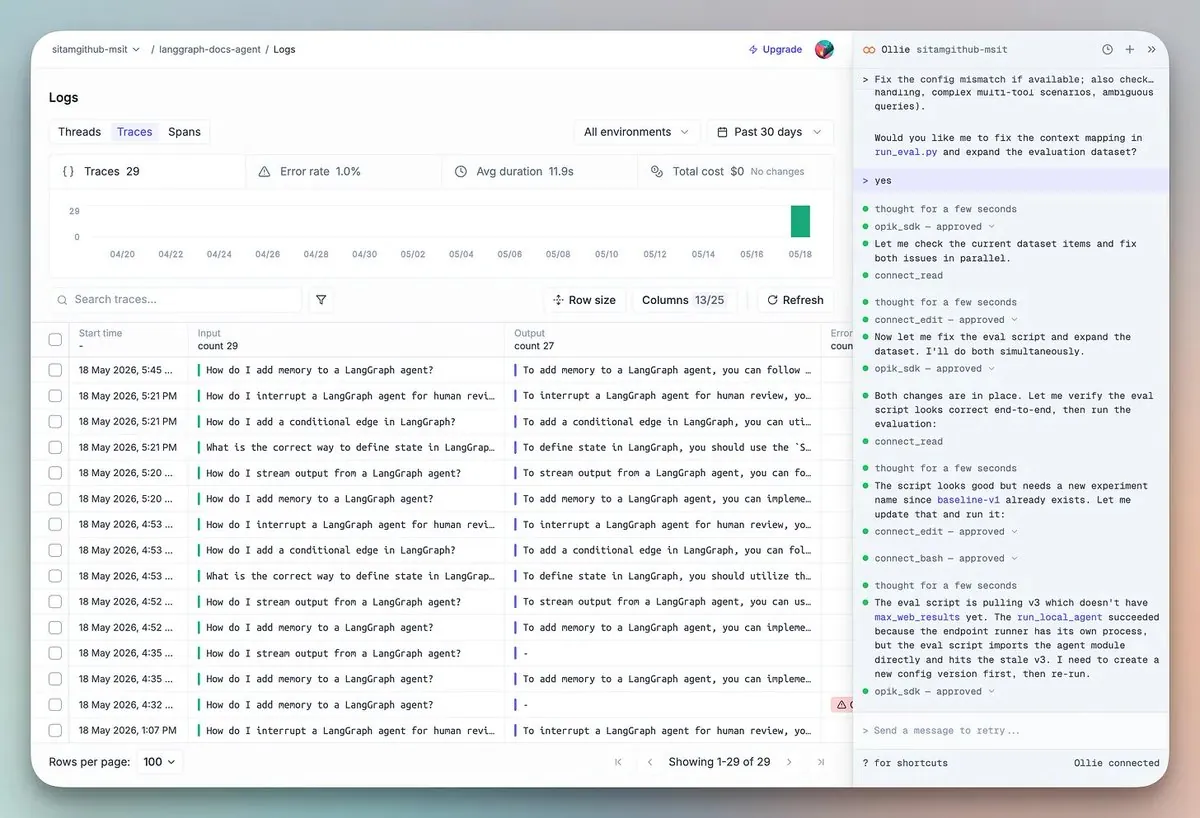
在不接触代码的情况下,Ollie 读 span 树、识别失败模式、解释跨每一次 LLM 调用的因果链。问它「为什么最终答案忽略了检索到的上下文?」它会走完整棵 span 树并给出根因。
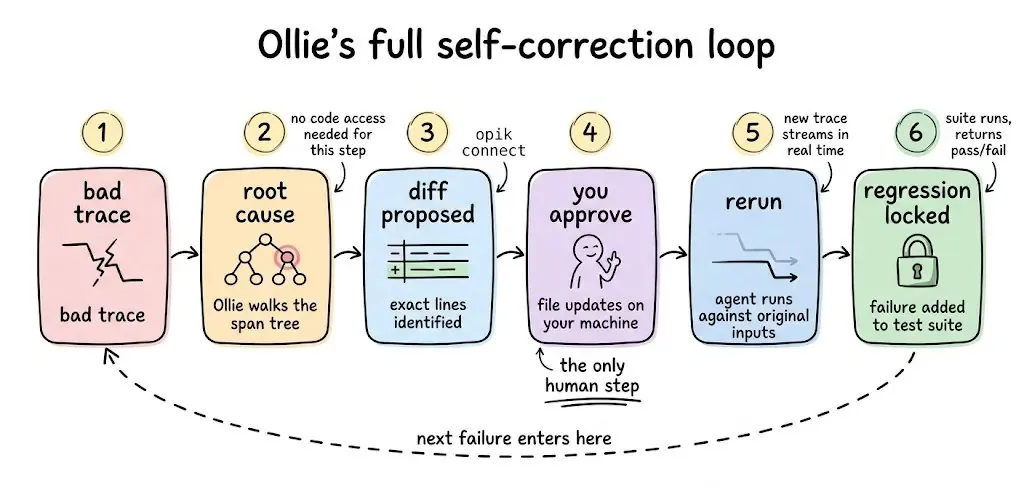
在项目根目录运行 opik connect,Ollie 升级为完整代码修复模式:
- 读你的源文件
- 定位真正负责的那几行
- 提出 diff;没有你的明确批准,任何东西都不会被改动
你批准之后,Ollie 用原始失败 trace 里的确切输入重跑你的 agent,流式给出新 trace 供并排对比,并把原始失败锁进测试集成为一个回归用例。
坏 trace → 根因 → diff → 批准 → 重跑 → 回归锁定。
第 3 层:Test Suites
大多数评测工作流是同一个形状:建一个带标签的数据集、定义一个数值指标、比较浮点数。这个模型适合研究者,不符合工程师思考质量的方式。
Opik 用 plain-English 断言替换它。
suite = opik.TestSuite("crm-agent-v2")
suite.add_assertion("The response must include specific deal details, not just a count")
suite.add_assertion("The response must never reveal unauthorized information")
suite.run_tests()
Opik 在底层把这些断言转成 LLM-as-a-judge 检查,每个测试用例给出干净的通过或失败。
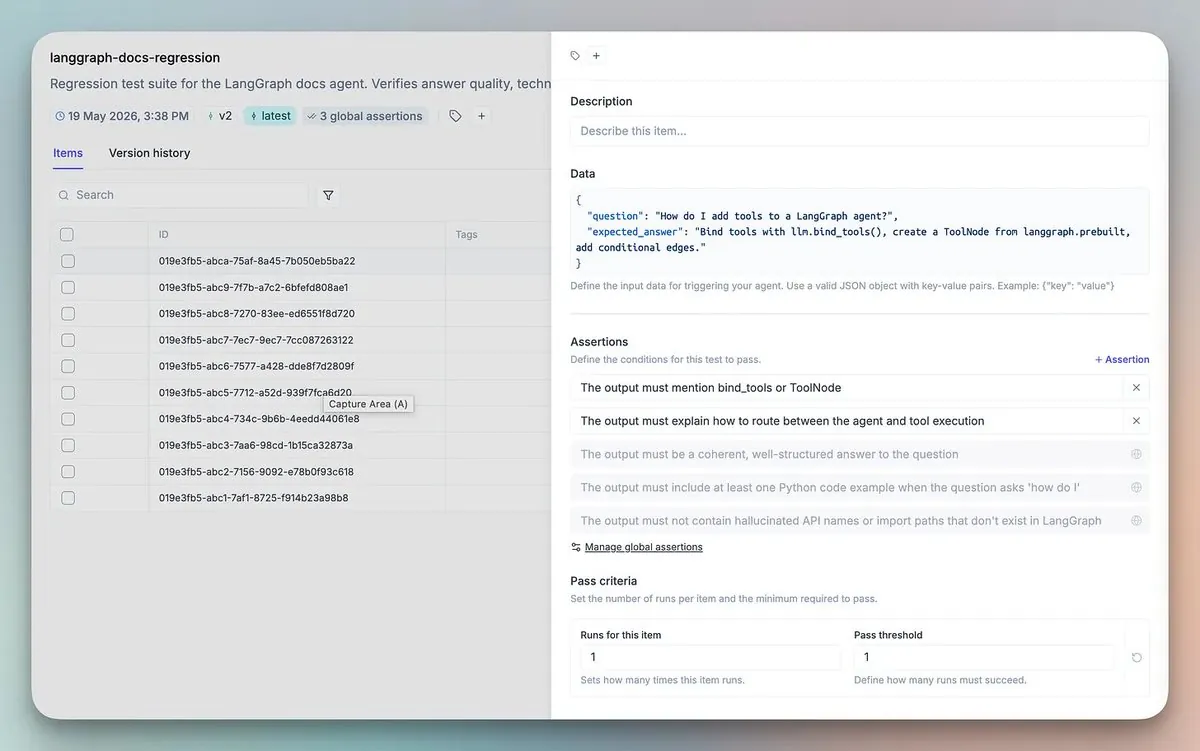
真正改变工作流的部分是:你调试过的每一条失败 trace 都会自动变成一个新的测试用例。测试集从真实的生产失败中长大,而不是某人事先写好的合成场景。
每一个循环,harness 都更难被弄坏。
但即使测试集在不断长大,你仍然需要一个安全的地方在上线前验证改动。这就是第 4 层的用途。
第 4 层:Agent sandbox
大多数 playground 是 prompt playground:改一个 system prompt,重跑一次 LLM 调用。这回答的是错误的问题。
生产环境的问题是:当我改这里时,整个 agent graph 会发生什么?
Opik 的 Agent Sandbox 在 UI 里端到端地运行完整插桩的 agent。改 prompt、换模型、加工具,然后观察整个系统在完整 span 树上的反应。每一次 sandbox 运行都会产出一条完整的 Opik trace。
非开发者的相关方——PM、领域专家、QA——可以安全地测试配置,而不碰 git。
实践中的飞轮
这些层不是独立的功能,它们是同一个循环。
用 @opik.track 插桩,声明一个 opik.Config。生产环境里某处失败了。Ollie 读 trace、读你的源码、提出修复。你批准。Ollie 在 Sandbox 里用原始失败输入重跑 agent。修复通过。存成一个新的 Blueprint。环境指针晋升到 staging。原始失败被锁成回归测试。
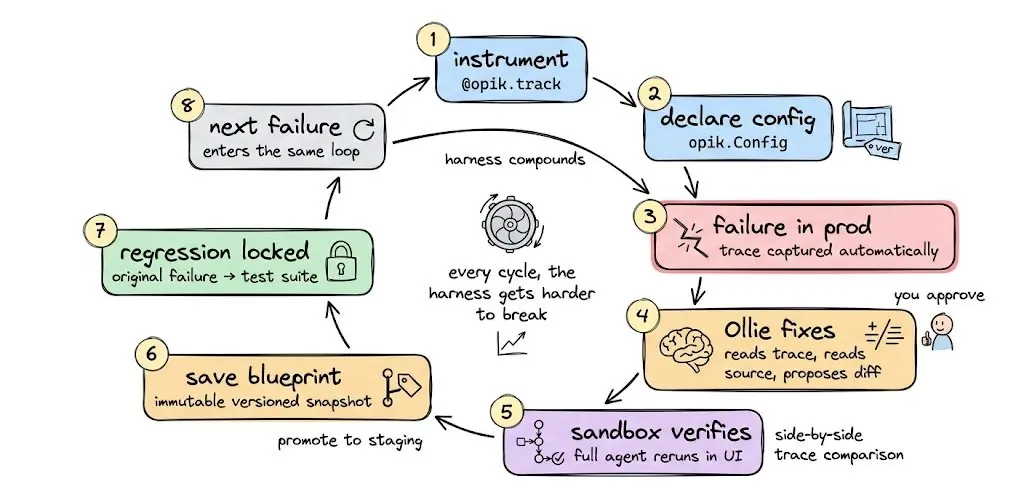
下一个失败进入同一个循环。
每一个循环,harness 都更难被弄坏。
合上循环
在 agent 还很简单的年代,止于 trace 的可观测性是说得通的。一旦它们进入生产,真正的工作是 trace 之后的一切——而那正是 Opik 替你跑、而不是留给你自己扛的部分。
整套栈都是开源的:Tracing、Ollie、Test Suites、Agent Sandbox、6 算法的 Agent Optimizer、50+ 框架集成,项目在 GitHub 上已超过 19.3K star。
三条命令即可自托管:
git clone https://github.com/comet-ml/opik
cd opik
./opik.sh
Cursor 描述的那条手工循环,正是 Opik 自己合上的那一条:从一条坏 trace,一直到一条被锁定的回归测试。
如果你在生产环境跑 agent,它值得一看。
Source: "Your Agent Harness Should Repair Itself" by Akshay Pachaar (@akshay_pachaar) on X, X Article, June 8, 2026. Figures reproduced from the original article.
原文来源:X @akshay_pachaarhttps://x.com/akshay_pachaar/status/2064051835636498924