OPEN SOURCE DEEP DIVE
Möbius:统一人体动作理解与生成的连续动作语言模型
Möbius 把文本理解、连续人体动作表示和整流流去噪放进同一多模态骨干,覆盖动作生成、描述、补全与语言编辑。论文、演示和 pipeline 已公开,但当前仓库仍禁止把代码状态理解为可运行实现。
项目状态:论文、演示和流程图已公开,代码仍在内部审查
Möbius 是香港科技大学、腾讯游戏 Motus 与麻省理工学院研究者联合提出的统一动作语言模型,目标是在同一套表示空间中处理人体动作理解、生成、补全与编辑。当前 GitHub 仓库提供论文引用、项目主页入口和一张完整的 pipeline 图,但 README 明确写着 “Code availability is currently under internal review.”。仓库快照中没有训练脚本、推理脚本、模型权重、数据预处理代码或许可证,因此现阶段不能把它当作可直接运行或复现的开源实现。
这不削弱论文的价值,但决定了正确的阅读方式:仓库目前是项目资料的公开入口,技术判断必须来自论文和项目页,而不是从仓库中并不存在的源码推断实现细节。下面的分析据此区分“论文已经验证的能力”和“仓库已经交付的能力”。
核心问题:理解与生成只是共享条件,还是共享整个生成过程
此前的统一动作语言模型通常让语言模型产生一个多模态条件表示,再交给外部扩散模型完成动作去噪。这样做虽然让理解与生成共享部分语义,但扩散过程仍位于另一个模块中,条件只负责说明“生成什么”,并不直接参与“动作如何一步步被构造”。另一类方法把动作离散成 token,用语言模型自回归生成,但量化会损失连续动作的细节,也让帧级编辑不够自然。
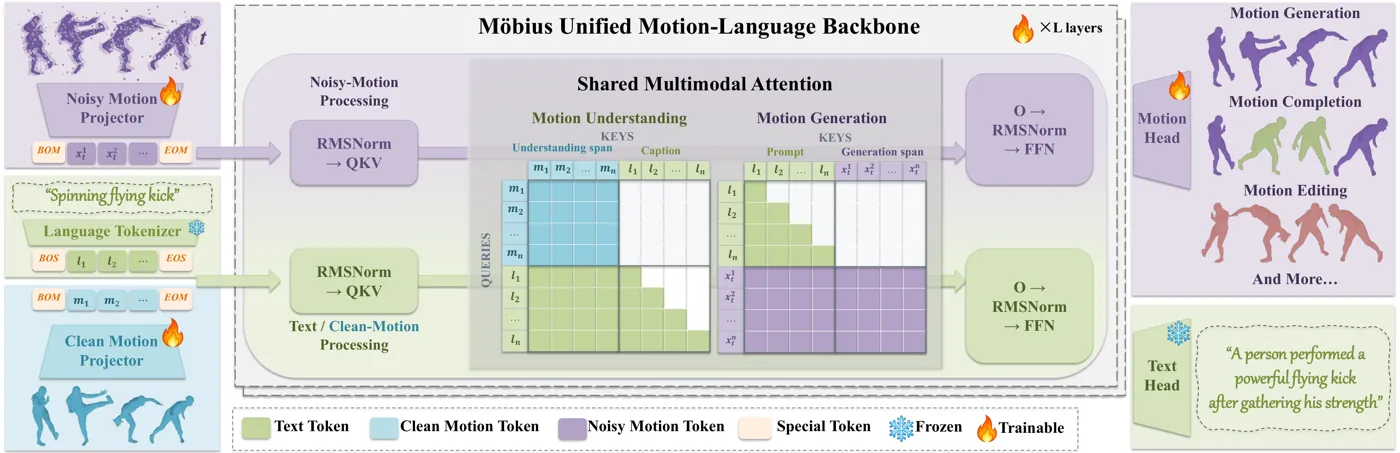
Möbius 的关键主张是把去噪本身搬进统一骨干。文本 token、干净动作 token 和带噪动作 token 在每一层共同参与注意力;带噪动作不是外部扩散器的输入,而是在同一多模态表示空间里逐轮恢复成干净动作。生成结果还可以重新作为干净动作进入理解侧,形成“生成后再理解、理解后再修改”的闭环。
连续帧级动作表示
模型不学习离散动作词表,也不依赖预训练动作 VAE。一个动作片段写成 X = [x1, ..., xT]^T ∈ R^(T×201),每一帧是一个 201 维向量,采样率为 30 FPS。201 维由骨盆平移 3 维、连续 6D 根节点朝向 6 维、局部身体旋转 126 维和根节点相对关节位置 66 维组成。动作序列两端使用 <BOM> 与 <EOM> 界定,使模型能够把动作片段和文本指令放进同一个序列。
训练集统计量用于逐维归一化,生成、补全和编辑过程中的去噪都在归一化空间内完成,最后再反归一化回 HY201 表示。干净动作和带噪动作共享同一数据接口,但分别经过理解侧和生成侧的投影器;动作头负责把隐藏表示解回连续动作。该设计直接保留每一帧的位置与旋转信息,也使“给定若干帧,补出其余帧”可以自然表达为同一生成目标下的不同观测掩码。
角色路由与共享注意力
架构借鉴 Mixture-of-Transformers。文本、边界符和干净动作被路由到理解参数,带噪目标动作被路由到生成参数;两路在 RMSNorm、QKV 投影和前馈层使用各自的参数,但注意力矩阵是共享的。这样既避免理解流和生成流完全混在一起,又允许语言语义、已观测动作和正在去噪的目标帧在每层交换信息。
注意力可见性按模态区分。同一动作序列中的帧可以双向查看,因此理解时每个帧都能利用完整上下文,生成时每个待去噪帧也能同时参考过去和未来。文本 token 保持预训练语言模型的因果注意力。生成目标固定放在整个序列末尾,并在去噪前指定长度,所以整段动作可以在每次采样中并行更新,而不是逐帧从左到右串行生成。
两阶段训练:先建立动作语义,再学习生成
第一阶段从 Qwen3 初始化,只训练动作投影器与理解路径完成动作描述。给定干净动作 X、文本指令 C 和答案 Y,使用标准自回归语言建模损失,让预训练语言模型把连续动作映射到已有的语言语义空间。这个阶段为后续生成提供了稳定的动作语义基础。
第二阶段从理解参数初始化生成参数,并冻结理解侧,只训练生成专家和接口层。训练目标采用整流流式端点预测:从高斯噪声 ε 和真实动作 X_gt 构造 X_t = (1 - t)ε + tX_gt,让生成路径在时间 t 下预测干净端点,并以均方误差监督。推理时使用 50 步 Euler 采样和 3.0 的文本分类器无指导。冻结理解侧是为了防止随机初始化的生成梯度破坏已经学到的动作语义与语言能力。
论文的消融结果支持这两个设计:角色路由优于按模态路由,帧级原始动作整体优于 VQ 或 VAE 潜在表示,理解到生成的课程训练也优于联合训练。需要注意,论文同时报告了任务覆盖更广但 T2M 指标略有回落的 20k 步多任务变体,说明“一个模型覆盖更多任务”和“在单一榜单上保持最高分”之间仍有权衡。
同一框架下的四类任务
文本到动作生成只提供文本提示,目标帧从噪声开始;动作到文本则把完整动作作为干净上下文,由文本头自回归输出描述。时间补全包括前缀预测、后缀回填、首尾插帧和关键帧填充,任务差异只体现在哪些帧被标为可见,不需要额外任务头。自然语言编辑则同时接收源动作、编辑指令和噪声目标段,在保留未编辑上下文的同时修改指定片段。
项目页展示了多轮创作示例:模型先生成动作,再延长动作、按指令改写中段,最后用自然语言描述结果。这个流程说明统一接口的价值不只是“一个模型跑四项任务”,而是动作生成结果可以继续成为理解输入,理解结果又能约束下一轮编辑。
基准结果应该怎样读
| HumanML3D 文本到动作 | R@1 ↑ | FID ↓ | MMDist ↓ |
|---|---|---|---|
| Möbius-0.6B,仅 HumanML3D | 0.8209 | 6.1291 | 13.9973 |
| Möbius-1.7B,加入约 1,700 小时动作数据 | 0.7968 | 10.6642 | 14.7441 |
0.6B 变体在 HumanML3D 训练组内同时取得最高的 R@1、最低的 FID 与 MMDist。1.7B 变体面对的是大规模训练组,R@1 略低但 FID 与 MMDist 仍领先同组基线。两行不是单纯的“参数变大所以全面更好”:它们的训练数据和比较组不同,必须按论文分组阅读。
| 动作描述 | R@1 ↑ | BLEU-1 ↑ | BERT ↑ |
|---|---|---|---|
| Möbius-0.6B | 0.6056 | 0.5664 | 0.4541 |
| Möbius-1.7B | 0.6152 | 0.5874 | 0.4657 |
动作描述任务上,0.6B 与 1.7B 都领先论文列出的统一基线。编辑变体在 MotionFix 上取得 FID 0.0955、R@1 0.4936,并优于“完全不编辑”的源动作参考,说明模型并非只保留原动作而忽略指令。时间补全中,0.6B 在预测、回填、插帧和关键帧填充上取得最低 MPJPE;1.7B 则在这些任务的 FID 上更低。二者分别偏向重建精度与分布质量,不能概括为一项指标全面领先。
另一个容易忽略的事实是命名尺度。论文称 Qwen3 主干为 0.6B 或 1.7B,但加入动作专家与接口后,架构表记录的总参数量分别约为 1.047B 和 3.148B。部署或显存估算应以总参数量为准,而不是只按模型名称里的主干规模计算。
与机器人研究的关系和边界
Möbius 研究的是人体动作的语言理解、动画生成和编辑,不是机器人关节控制。它没有把动作预测接到真实机器人的状态、接触、动力学或安全约束上,也没有在机器人执行任务上评测。对具身智能最直接的启发在数据层:同一套连续帧表示可以承载生成、描述、补全和语言编辑,为未来把人类动作、机器人轨迹与任务语言对齐提供了一种接口设计。把论文结果外推成“可直接驱动机器人”会越过证据边界。
对游戏动画、虚拟角色和视频制作,它的意义更直接:模型能在同一界面内生成动作、延长已有片段、按语义修改局部,并把结果转成可读描述。对机器人研究者,更值得继续观察的是帧级上下文如何表达局部编辑,以及统一生成接口能否迁移到带物理约束的机器人动作空间。
当前仓库能支持什么,不能支持什么
当前仓库可以支持三类工作:阅读作者公开的项目概述,下载高分辨率 pipeline 资料,引用论文并访问交互式演示。它不能支持环境安装、数据准备、模型训练、权重加载、基准复现或二次开发,因为对应文件和许可证都不在公开快照中。即使未来代码开放,1.7B 结果依赖约 1,700 小时内部动作语料,完整数值复现仍可能受数据授权限制。
仓库恢复公开实现后,首先应核对的数据包括:HY201 特征提取与归一化统计、可见帧掩码的任务构造、理解参数冻结范围、整流流采样器与分类器无指导设置,以及 MotionFix 与 HumanML3D 的评测转换。这些位置决定了论文描述能否对应到可执行行为。仅看到模型定义文件,还不足以证明训练流程与榜单结果可复现。
公开资料
- GitHub 项目入口:当前公开 README、pipeline 图和引用信息。
- 项目主页:交互式动作样例、方法概览和完整基准表。
- arXiv 论文:方法、消融、任务构造、推理参数和评测协议。
- 视频来源:本次入库关联的演示视频。