OPEN SOURCE DEEP DIVE
Caveman:让编码 agent 少说废话、少读垃圾的省 token 三件套
MIT 规则文件让 agent 少说废话(代码与报错永不缩写),Go 本地代理在请求发出前压缩日志/JSON/diff 且原件可取回,中间件把同样能力带进你的应用;JetBrains 86 任务 A/B 输出 −8.5% 质量持平,仓库 54 跑套件输入 −33.2%、18/18 校验通过。
账单按字算,那就让它少说话
token 是 AI 计费的最小单位,大约等于四分之三个词。你的 agent 每写一个 token 要付钱,每读一个 token 也要付钱;而大多数 agent 写起来像求职信,读起来像消防栓。Caveman 同时砍这两端:一份规则文件砍它说的,一个本地代理砍它读的,一层中间件把同样的能力带进你自己写的应用。项目始于 2026 年 4 月的一个周五玩笑,一周涨到 4000 star,收录时已过 10 万 star,附带一篇 Adobe 研究论文引用、一次 JetBrains 实验室测试和一条 ThePrimeagen 的反应视频。
README 开头的对照很直观:同一段 React 重渲染的诊断,普通 agent 用 69 个 token,Caveman agent 用 19 个——同样的诊断、同样的修复、同样的 useMemo,死掉的只有清嗓子的废话。纪律也写得很死:代码、命令、文件路径、精确报错信息永远不被 caveman 化;安全警告与「你确定吗」这类确认问句会整句回来,然后才恢复原始人语域。
三件套:一份规则、一个本地代理、一层中间件
skill 是最小入口:一份 MIT 规则文件,永久免费,适配 30+ agent(Claude Code、Codex、Gemini、Cursor、Windsurf、Cline、Copilot 等),npx skills add JuliusBrussee/caveman -g 一条命令装完。强度可调:/caveman lite|full|ultra,外加 wenyan-lite|wenyan-full|wenyan-ultra 三档文言文(因为真的有人提了 issue)。配套 /caveman-commit、/caveman-review 把语域带进提交信息与评审意见;/caveman-compress 把 CLAUDE.md 这类记忆文件平均压 46%,标题、代码、路径、URL 逐项校验完好,且保留备份可回滚;pixel mode 更进一步,把 skill 自身渲染成 PNG 页让模型当图读,1069 个估算 token 降到 415,省 61%。
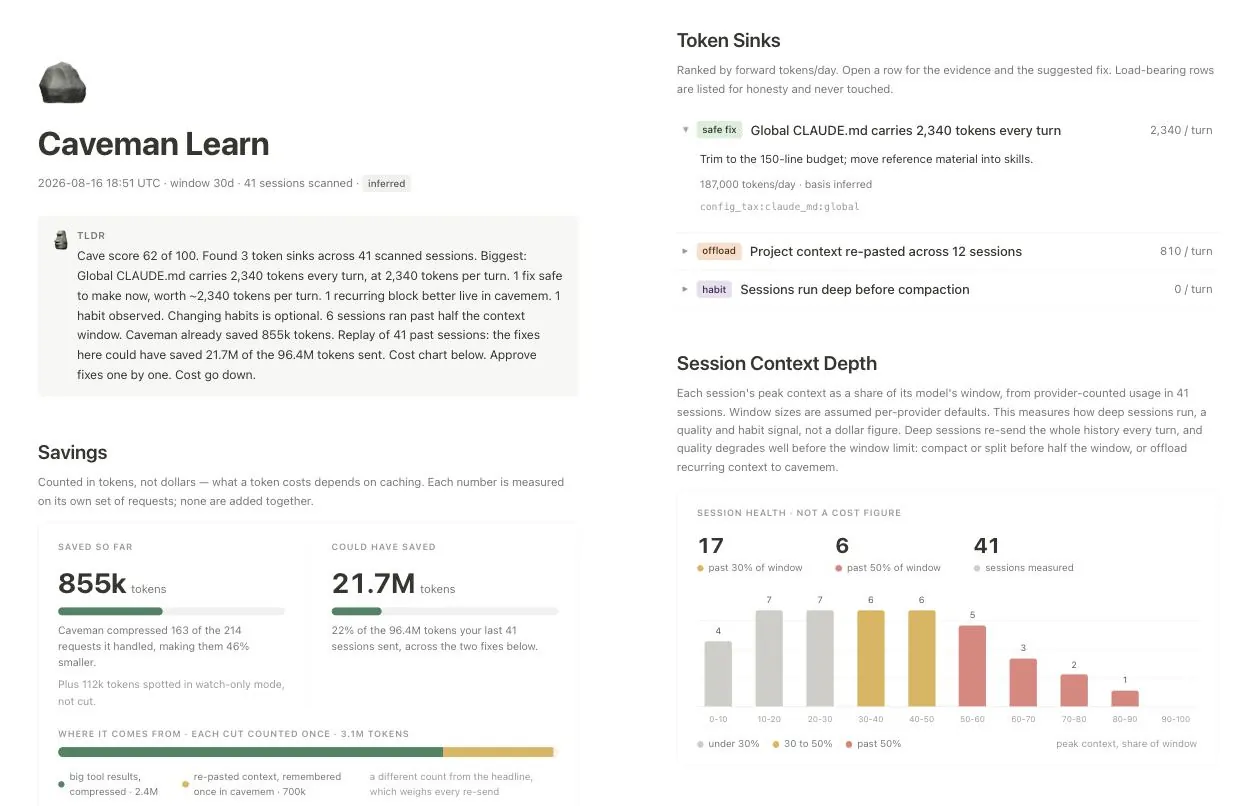
proxy 是重头戏:一个跑在本机、夹在 agent 与 AI provider 之间的 Go 代理(565 个 .go 文件、约 13.9 万行)。它在每次请求发出前压缩 agent 要读的东西:detect() 先把流入内容分成 json / log / code / diff / search / text 六类,各型有自己的保留规则,实测保留 70–95% 的节省空间;被压掉的每个字节都在本地 SQLite 里留有字节级原件和一个恢复句柄,agent 随时能把原文取回。contextwindow.Pack 用 BM25 加新近度加报错信号挑回相关原文,同时保住时间顺序。默认 wrap 会给 agent 五个 MCP 工具、Chrome 可用时的 browse 服务器、在 Claude/opencode/Gemini/Hermes/OpenClaw 上的命令输出压缩,以及新装 skill 的 pixel mode;Codex 因其运行时拒绝改写而跳过 shrink hook(openai/codex#18491)。wrap 支持 10 个 agent 且不需要改它们的配置文件,provider 透传包括 Claude Pro/Max 的登录态。learn 与 learn implement 会扫描历史会话找 token 汇并提议修复,量下来没省到就自动回滚;trial 做 A/B。
middleware(alpha)把同一套压缩搬进你自己的代码:TypeScript 侧支持 Vercel AI SDK、OpenAI、Anthropic、Google、LangChain、Strands、Mastra 与 MCP;Python 侧再加 LangGraph、LiteLLM、Agno、CrewAI、PydanticAI、AutoGen、LlamaIndex 与 FastAPI。工具结果在进模型之前被压缩,原件留在你的历史里,模型可以按需取回。
证据:三组数字,红的行留着红
Adobe Research 的 CAVEWOMAN 论文(arXiv 2606.24083)在 8 个模型、5 个数据集、5 个压缩档上测了这种语域:输出侧 caveman 风格把实付成本砍到 1.4–2.4 倍,最好情况 3 倍。同一篇论文还有另一半结论——把人类的提示压成 caveman 会让模型答得更长更差。所以 Caveman 从不改写你的提示,只改 agent 的嘴。
JetBrains 在 86 个真实编码任务上做了配对 A/B(Claude Code 2.1.200,只装 skill,2026 年 7 月,当时 proxy 还不存在):输出 token 少 8.5%,约合 10% 成本,质量无可测变化(符号检验 p=0.82)。他们的结论「agent 的账单主要在读不在写,任何说话风格都救不了」直接催生了 proxy。
仓库自己 pinned 的 54 跑 Claude Code 套件(每 case 三跑、provider 上报输入 token、每个答案对照精确 oracle 校验):输入 token 从 885,793 降到 591,673,−33.2%,18/18 答案校验通过,case 聚类 95% 区间 14.6%–48.5%。其中 Dashboard HTML 一行是 +9.9%,是红的,并且 README 明写「它会一直红下去」——该 case 没有可用的压缩变换,proxy 白付了自己的开销;维护者的原话是「我藏起红行的那天,就是你该停止相信绿行的那天」。同一套件里 Headroom 的 wrap 省 6.7% 且 18 个校验挂了 3 个。
仓库自带的 eval 快照补了写侧的账:10 个开发问题,对照已经是「Answer concisely.」的极简控制组,中位数仍再砍 50% 输出 token——只量长度不量正确性,README 也照实标注。三组数字合起来才是诚实的全貌:聊天式问答砍得多,agentic 编码会话(大头是 skill 不碰的代码与工具调用)砍高个位数百分比,质量持平。
读的这一端:129.8 倍与 21.9 万字符的税
browse 服务器量的是网页这一类读入:对一张 200 行表格问一个聚焦问题,Caveman 的聚焦抽取是 121 个 token,Playwright 的 ARIA 快照是 15,704 个,129.8 倍差距;小表单只省 2.3 倍,benchmark 文档照写不误。
subagent-tax 量的是另一种隐性读入:在一台真机上,一个 267k 字符的请求里有 219k 字符是工具 schema——每个子 agent 开工前都要把整套工具面重发一遍。这条命令的意义是让你在自己机器上量自己的税,而不是相信别人的数字。
同层对比:各碰哪一层,谁验过
README 的对比表只引用各家 README 在 2026-09-19 当天的原话,并标清谁在什么条件下验过。RTK 只碰 shell 命令输出(Read/Grep 工具调用绕过它),JetBrains 同实验室同方法在 425 个计费 trial 上测出低推理档中位成本 +7.6%(p=0.004);Headroom 碰工具输出、日志、文件与历史,有可逆缓存,但遥测默认开;context-mode 在沙箱里跑、只给可检索片段不给全文;pxpipe 把上下文重渲染成图片,自认有损且丢失是静默的。Caveman 的差异点在于:原件永远可取回(字节级、本地 SQLite、一个恢复句柄);CLI 的匿名计数默认开但 caveman telemetry off 一条命令关掉,skill 与 hooks 从不外联。
许可、遥测与什么时候别用
许可是组合拳:skill 与 CLI 是 MIT;proxy 运行时是 BSL-1.1,在 2030-06-21 或首公开发布四周年(取较早者)转为 Apache-2.0,第三方托管需要商业授权。遥测口径写在对比表里:CLI 匿名计数默认开、可关,skill 与 hooks 从不发送任何东西。
README 也给了「别用」清单:按请求计费而非按 token 计费的场景省不到钱;纯代码生成场景的输出几乎都是代码,而 skill 恰恰不碰代码。这种把适用边界写进营销页的做法,和保留红行是同一套价值观。
社区侧:Hacker News 榜首 904 分 366 评论、GitHub Trending 2026 年 7 月总榜第一、Trendshift 4 月日榜第一与 7 月 Go 仓库月榜第一、Product Hunt 日榜第八。The New Stack 那篇标题带着质疑的文章(「可能没省你想的那么多 token」)被 README 原样链接,配文只有一句:Fair headline. We link it anyway. 对一个靠「省 token」吃饭的项目,这种自我审计的姿态比任何单点数字都更值得抄。