OPEN SOURCE DEEP DIVE
OpenResearch:把编码智能体变成研究智能体的本地优先实验工作台
OpenResearch(orx)是 alphaXiv 开源的本地优先研究工作台:单个 Rust 二进制把 Claude Code、Codex、OpenCode、Cursor 变成能查文献、提假设、跑实验、沉淀产物的研究智能体。它以 git 实验树与固定运行契约为骨架,用修复/补位/晋升/停止四步自动研究循环驱动实验,运行日志与运行清单是唯一证据。本文基于 v0.2.3 源码精读与内置 nanochat 演示实测撰写。
编码智能体与研究智能体之间差了什么
Claude Code、Codex、OpenCode、Cursor 这一代编码智能体已经能可靠地读代码、改代码、跑测试,但把它们放进研究流程时会暴露一个结构性缺口:研究不是「把一个问题改对」,而是「在一串相互依赖的决策中积累可比证据」。一次实验改了什么、和哪一次比、结论依据哪一段日志,这些信息在普通会话里散落在聊天记录与 shell 历史中,等下一次实验开始时就已经丢了。OpenResearch(命令行工具叫 orx)正是冲着这个缺口来的:它是 alphaXiv 团队开源的本地优先研究工作台,用单个 Rust 二进制把上述编码智能体接管成研究智能体,覆盖文献综述、假设提出、实验执行与产物沉淀四个环节。仓库创建于 2026 年 6 月 7 日,本文撰写时最新版本为 v0.2.3(2026 年 9 月 16 日发布),约 3,500 star、232 fork,MIT 协议,曾登上 GitHub Trending 日榜第一。
它的定位可以概括为「本地优先」。项目、会话、实验、运行、日志、代码与产物全部落在本机数据目录与随进程的 SQLite 数据库中,orx up 在 127.0.0.1:4791 启动仪表盘;创建项目或启动运行都不会发布你的代码,openresearch.sh 账号只服务于组织、托管算力这类服务侧能力。数据目录还可以整体搬迁:启动时会对内部绝对路径引用做修复,搬完即用。
四条不可协商的规则
OpenResearch 把方法论直接写进随 CLI 分发的技能文档。「基本规则」一节开篇就声明:这四条不是风格偏好,违反任何一条都会静默地作废你的结果。第一条是冻结节点:一个节点一旦有运行给出了答案(包括根节点),即刻冻结且永久冻结,令人失望的结果也是结果;冻结之前它属于暂定状态,补依赖、修环境、让它跑起来都发生在它自己的分支上,要试新想法就分支出子节点改子节点。第二条是固定契约:运行命令与环境在所有节点上完全相同,子节点逐字继承父节点的运行命令,禁止用环境变量或带环境前缀的命令(例如 LR=3e-4 python ...)改变行为。第三条是改代码不改旋钮:超参数写进代码或配置文件,每个变体分支一个子节点,保证「同一条命令跑不同代码」,日志里的结果摘要才彼此可比。第四条是树向下长而不是向旁边长:一轮之内对同一决策小幅扇出若干选项,然后晋升该轮胜者、在胜者之上展开下一轮;「根节点挂一长排直接子节点却没有孙节点」是被文档点名的失败形态。
flowchart TD
  R["基线 baseline(已冻结)"] --> A["学习率 2e-5"]
  R --> B["学习率 3e-5(本轮胜者)"]
  B --> C["加宽 MLP"]
  B --> D["词表 8192"]
  D --> E["下一轮决策:继续在胜者之上分支"]
这张图就是文档所说的「堆叠灌木」:每一轮是一丛矮灌木(同一决策的并列选项),轮与轮之间靠晋升串成深度。平铺扇出会把算力摊成一次扫参,单链面条则浪费了对比信息,只有堆叠灌木让每个胜者都被下一轮继承。
自动研究循环:修复、补位、晋升、停止
在规则之上是驱动项目的自动研究循环。每一个完成的运行都是一个决策点,对应四个动作:修复,即运行没有给出答案时修好该节点分支并重跑同一个节点;补位,即结果平庸或不确定时启动队列中的下一个兄弟节点,让本轮继续推进;晋升,即结果明确胜出时该节点成为下一轮的父节点,下一批子节点从它分支而不是从基线分支,胜果因此被携带向前;停止,即目标达成或分支耗尽。循环的等待原语是 orx exp wait --project:一次完成返回一次,决策之后重新发起,不要指望一次等待阻塞到全部结束;每次醒来后用 orx runs 对账,处理所有新终止的运行,而不是只处理等待命令打印的那一行;当没有运行在飞时它立即返回 drained: no runs in flight,这就是退出条件。修复设有上限:同一节点连续两次运行都没给出答案就该停下来问人,同一个失败打到第二个节点上说明这是一个环境级问题。连续约三次失败或回退后停止,并把整棵树写成一份命名清晰的项目产物报告;每个跑过或改过实验的回合都要以一段实验摘要收尾,每个相关节点一行:测了什么、状态如何、头条结果是什么。
证据契约:只有运行日志算数
聊天中任何关于代码、文件、产物或测量结果的实质论断,都必须紧跟一个可点击引用:代码与文件事实用 <file path="relative/path.py" /> 标签(可带行号与实验分支),测量结果用 <run id="runId" /> 标签(可带一个简短标签如 +3.65pp),并且要求「在报告结果之前先读被引用运行的日志,状态本身不是证据」。日志读取走 orx logs,支持 --head、--bytes、--range 字节窗口,避免把整份日志塞进上下文。演示项目的证据包还附带 run-manifest.json:每个保留文件登记路径、字节数与 SHA-256,被有意省略的目录(数据集、评估语料、优化器状态,合计约 2 GB)也逐一记录,让后续分析能区分「确实产出过」与「本地仍然可得」。
| 演示运行指标 | 记录值 |
|---|---|
| 基线训练规模 | 5,000 步 / 81,920,000 token / 131.55 分钟(Apple Silicon MPS) |
| 基线验证 BPB | 1.1658(4,000 步 1.1878 → 4,500 步 1.1743 → 5,000 步 1.1658,终点仍在下降) |
| CORE 小规模评估 | OpenBookQA 0.2500、Winogrande 0.5625(中心化 0.125)、Wikidata 与 Operators 均 0.0000 |
| SFT 阶段 | 1,500 步 / 39.07 分钟,验证 BPB 由 1.0174 降到 0.7389 |
| 最终问答 | 提示「法国的首都是哪里」答出 Paris,随后进入数字重复循环 |
文献综述:主智能体亲自排序
orx discover 提供关键词与向量两种检索,后端接 alphaXiv、OpenAlex 与 bioRxiv;orx paper 按 arXiv 编号或 DOI 取单篇全文。技能文档里有两条硬规则:排序必须由主智能体亲自完成,不允许把「挑论文」委托给子任务;对候选工作打 1 到 10 的难度分,决定跟进轮数,低分不追、中分追一轮、高分追两轮引文链。学术论断必须挂来源链接,形如 alphaxiv.org/abs/<id>,而不是项目文件或运行标签。我在本机实测 orx discover keyword "humanoid whole-body control" --limit 2,返回的是真实的 alphaXiv 检索结果(例如全身控制方向的新工作,arXiv 2609.15213),并非缓存样例。
架构:一个 Rust 二进制加本地 SQLite
全部能力收敛在一个静态链接的 Rust 二进制 orx 中:musl 目标加 rustls 构建,不依赖系统 TLS 库;存储是 rusqlite 驱动的本地 SQLite;仪表盘由 axum 服务,前端资源经 rust-embed 打进二进制,默认监听 127.0.0.1:4791。界面是 React 19 加 Vite、TanStack Query、xyflow 实验树、xterm 终端与 KaTeX 公式,多语言文案由 paraglide 在编译期生成。智能体适配层按各家原生通道注入同一份系统提示,每个会话拿到项目仓库的独立 git worktree,互不干扰。
| 编码智能体 | 系统提示注入通道 | 会话工作区 |
|---|---|---|
| Claude Code | --append-system-prompt-file | 会话私有 git worktree |
| Codex | developerInstructions | 会话私有 git worktree |
| OpenCode | 配置文件中的 instructions 列表 | 会话私有 git worktree |
| Cursor | 项目规则文件 | 会话私有 git worktree |
执行后端覆盖本机、SSH(支持配置别名与自定义端口)、Slurm、Kubernetes、Ray、Hugging Face Jobs、Modal、Tinker 与托管 OpenResearch 算力;同一份提交快照无需发布仓库即可在远端运行,orx up --remote user@host 让浏览器留在笔记本、服务跑在 GPU 旁边。技能体系是 agent-skills/ 下的十二个模块(实验树、算力、证据、文献综述、绘图、论文、报告、git、创建、委托、实例、定制),orx install-skills 一键装进各智能体的技能目录;系统提示只保留每轮都需要的持久上下文,流程性知识按需加载。产物侧还有两条链路:Overleaf 实时同步(socket.io 推送、浏览器 cookie 导入、凭据以 AES-128-CBC 加 PBKDF2 加密存放)与本地 LaTeX 编译;绘图技能则明确写着「matplotlib 的默认输出不算可发表图」。
orx up                                  # 启动本地仪表盘,导入或创建项目
orx install-skills                      # 把技能装进编码智能体
orx projects                            # 列出本地项目
orx project view <projectId>            # 查看实验树,取实验 id
orx runs <projectId>                    # 列出运行,取运行 id
orx logs <runId> --bytes 20000          # 按字节窗口读日志
orx exp run <experimentId>              # 在指定节点启动运行
orx discover keyword "humanoid whole-body control"
orx paper 2609.15213                    # 取单篇全文
实测:内置演示跑通了什么
首次启动的引导流程提供一个 nanochat 演示项目:三个策展会话与三个实验节点(基线已完成,学习率加倍探针与词表 8192 探针待跑)。基线会话记录了一次真实的 Apple Silicon 端到端运行,聊天里逐条给出训练规模、验证 BPB、CORE 分数与 SFT 结果,每条论断后面都挂着运行引用或文件引用。
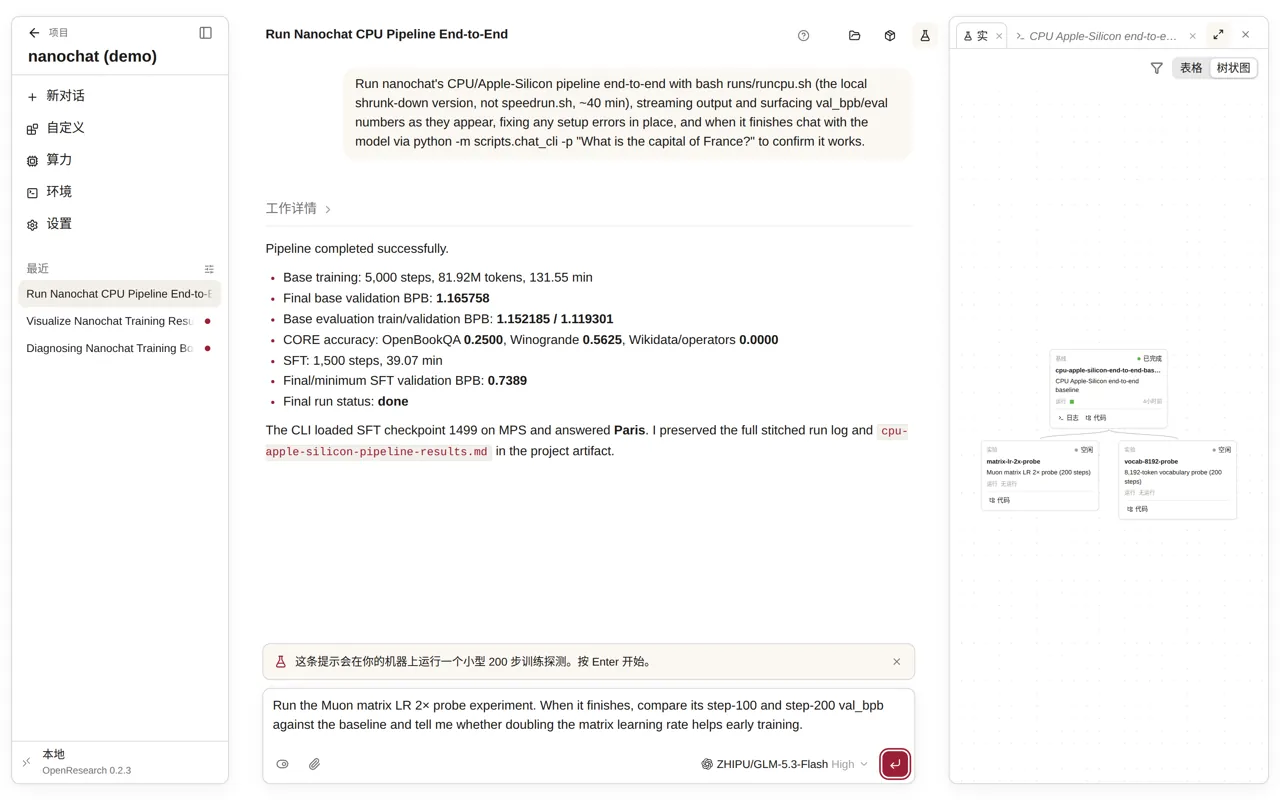
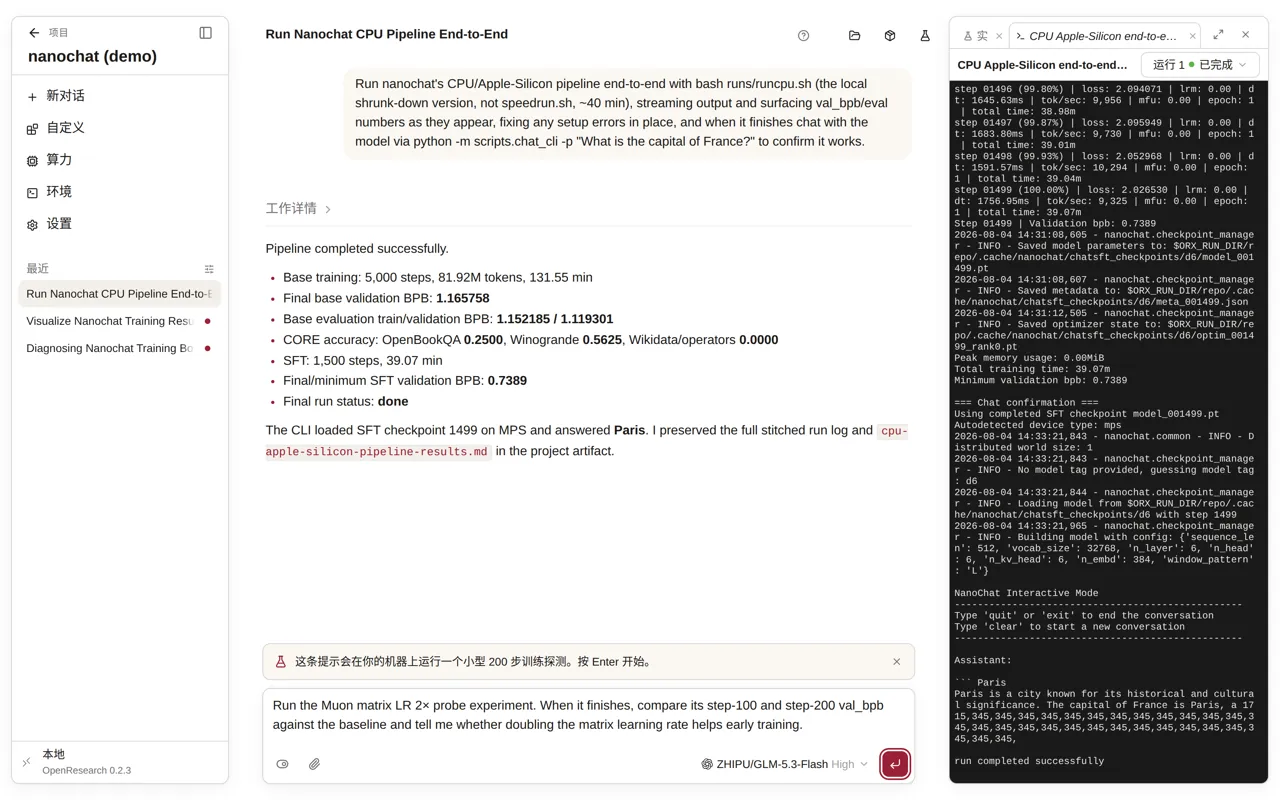
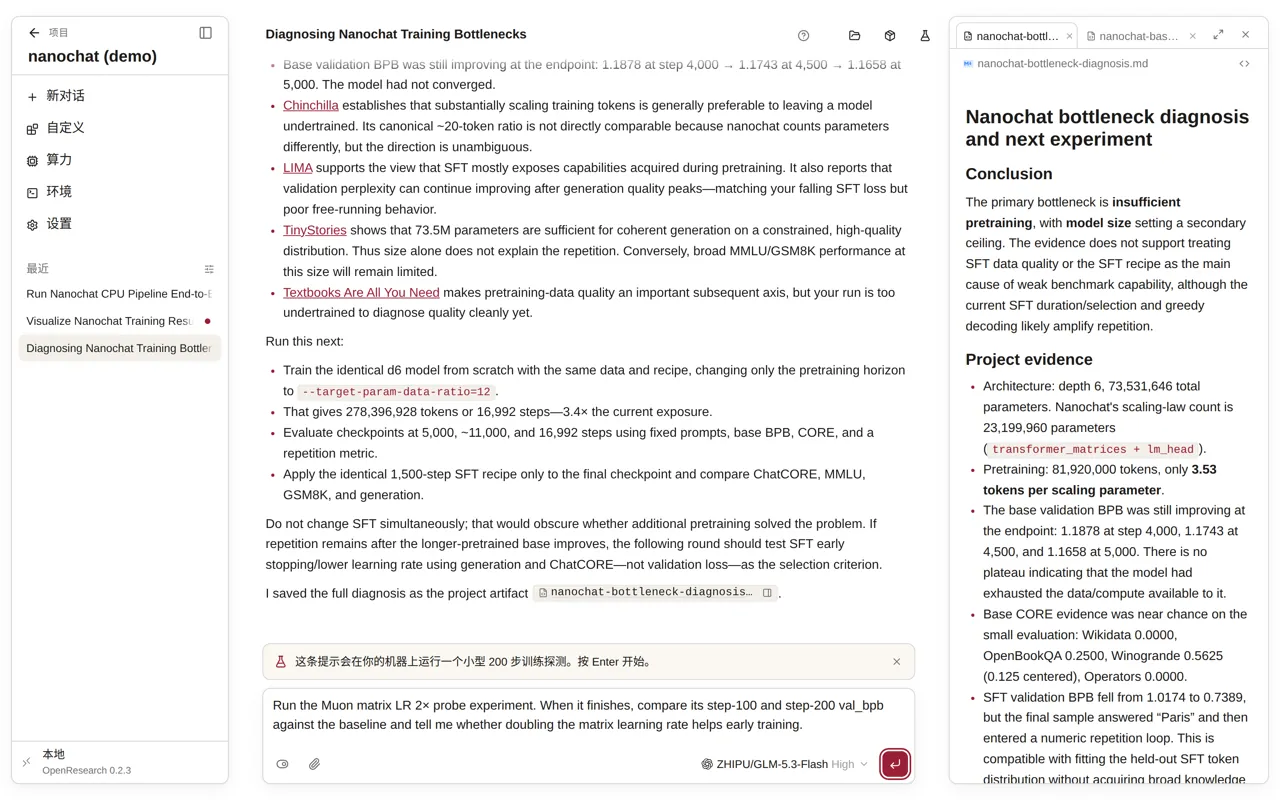
值得强调的是演示的诚实度:日志保留了 SFT 模型答对 Paris 后陷入「345, 345, 345…」重复循环的原文;瓶颈报告把 Wikidata 与 Operators 的 0.0000 原样列出,并引用 Chinchilla、LIMA、TinyStories、Textbooks Are All You Need 四篇文献解释「验证损失下降不等于生成能力获得」,最后给出的下一步是一个只动预训练 token 数的单因子消融。这正是证据契约希望研究智能体呈现的样子。
边界与风险
README 自己写明了最大的一处:orx up --remote 的远端服务只绑定回环地址、没有应用层鉴权,同一主机上的其他用户可以直接访问,多用户场景需要自行加隧道或反向代理。官方 release 构建会发送可关闭的粗粒度遥测,绑定随机安装 ID,不含代码、提示、文件内容、路径、仓库名与 token;源码与开发构建完全不发送,介意的话执行 orx telemetry off。存储是单机 SQLite,多人协作与多机共享不在当前模型内;Windows 支持仍是 beta 且依赖 Git for Windows。演示证据包有意省略了数 GB 的权重与数据,复现完整工作区需要重跑其运行脚本。
谁该用它
如果你已经在用编码智能体做机器学习或机器人学习方向的实验迭代,OpenResearch 的价值是把「实验可比性」从个人纪律变成工具约束:冻结节点杜绝事后修改基线,固定运行契约杜绝环境变量偷跑,堆叠灌木杜绝平铺扫参。对具身智能社区而言,它同样适配 sim2real 消融、策略超参逐轮下探这类工作流。前提是你愿意接受它的方法论强度:它不是一个更花哨的实验记录器,而是一套要求你先想清楚「这一轮到底在决策什么」的研究操作系统。