PAPER DEEP DIVE
生成式智能体:人类行为的交互式模拟
提出生成式智能体:以记忆流、反思与规划三个模块扩展大语言模型,25 个智能体在类《模拟人生》的小镇中连续生活两天,自发传播消息、建立关系并协调举办情人节派对;消融实验证明三个模块对行为可信度都不可或缺。
论文元信息
标题:Generative Agents: Interactive Simulacra of Human Behavior(生成式智能体:人类行为的交互式模拟)
作者:Joon Sung Park、Joseph C. O'Brien、Carrie J. Cai、Meredith Ringel Morris、Percy Liang、Michael S. Bernstein(斯坦福大学、Google Research、Google DeepMind)
链接:arXiv:2304.03442 · UIST 2023 · 代码仓库 · 在线演示
代码状态:已开源(Python)。仓库拆成两台服务器:Django 环境服务器负责 Smallville 沙盒与前端,reverie.py 负责智能体的认知循环;utils.py 里填自己的 OpenAI key,README 另给了一份可直接加载的存档 fork base_the_ville_isabella_maria_klaus。底座模型是 gpt3.5-turbo(论文写作时 GPT-4 的 API 仍是邀请制)。
一句话总结:给大语言模型接上记忆流、反思、规划三个模块,25 个智能体在一个类《模拟人生》的小镇里连续生活两天,自己把消息传开、自己建立关系、自己协调出一场情人节派对;受控消融显示这三块对行为可信度都不可省。
研究背景与动机
「能不能造出一群像人一样行事的计算智能体」这个问题,在 HCI、游戏 AI 与认知建模里已经提了四十多年。Bates 在 1994 年给出的判据不是正确性,而是可信度(believability):智能体要提供「生命的幻觉」,让观察者愿意把它当成有意志的角色来看待,就像迪士尼动画里的人物那样。这个目标一度被当作交互系统研究的北极星,却长期没有被工程化解决。
已有的三条路各有天花板。规则派(有限状态机、行为树)靠人力穷举行为,《质量效应》《模拟人生》都用它,也能应付初级的社交互动,但开放世界里的交互组合写不完,脚本之外的新行为一概不会做。学习派(强化学习)在 AlphaStar、OpenAI Five 这类奖励明确的对抗游戏里已经超人,可「奖励可定义」不等于「行为可信」,开放世界里的像人问题它们还没碰。认知架构派(SOAR、ACT-R 一脉)有长短期记忆、有符号结构、按感知—规划—行动的循环运行,Quakebot-SOAR 与 TacAir-SOAR 都出自这里,但动作空间被手工编写的程序性知识限死,不会被「启发」去做没写过的事。
大语言模型带来了新的入口:它的训练语料里本来就编码了大量人类行为,只要上下文给足,它就能在单个时间点上生成可信的行为。social simulacra 用它生成论坛里的临时人格,Horton 用它复现社会科学实验,也有人用它做政治调查与合成数据,游戏里则出现了交互式小说与文字冒险,机器人任务规划里用它把一个任务拆成子动作序列。但这些都是「一阶提示」:少样本模板或思维链,条件只有当前环境。可信的智能体还要条件于大量过往经验,而那些经验既装不进上下文窗口,也塞不进一条 prompt。
论文把缺口说得很具体:已有的改进要么是挂一个静态知识库加一套信息检索,要么是一套简单的摘要机制;缺的是一个在每个时间步都动态更新、并与当前情境和计划混在一起(可能互相强化,也可能互相矛盾)的记忆处理方式。作者的答案是一套智能体架构:记忆流负责完整记录,检索负责在需要时取出最相关的一小部分,反思负责把记录递归综合成更高层的推断,规划负责把推断落成行动序列,而反思与规划再写回记忆流去影响未来行为。整套架构里流转的全部是自然语言,因此可以直接吃到大语言模型的能力,也会随模型升级而升级。
为了让这套架构可被检验,作者把它落进一个具体沙盒:Smallville,一个 25 人的类《模拟人生》小镇。用户唯一要做的事是给某个智能体写一段人物描述当种子记忆。论文反复举的演示是:要让小镇在 2 月 14 日办一场情人节派对,传统游戏环境得手工编写几十个角色的行为脚本,而这里只需要告诉 Isabella 她想在 Hobbs Cafe 办派对。中间有一长串可能的失败点——她得记得去邀请别人、被邀请的人得记得这件事、记得的人还得决定真的到场。结果是派对办成了,还有一个智能体顺势把自己心仪的对象约了过去。
预备知识:可信度、访谈与 TrueSkill
这篇论文的因变量不是任务成功率,而是可信度,评测手段也随之不同。因为智能体本身就能回答自然语言问题,作者直接「访谈」它们:25 道题覆盖五个能力面——自我认知(「介绍一下你自己」「大致描述你典型的工作日安排」)、记忆(「某某是谁?」「谁在竞选镇长?」)、计划(「明天上午 10 点你会在做什么?」)、反应(「你的早餐烧糊了!你会怎么办?」)、反思(「如果要从你最近认识的人里挑一个共度一小时,你挑谁,为什么?」)。要答好这些题,智能体必须成功检索并综合自己的记忆。
评估者是 100 位从 Prolific 招来的真人(限美国境内、英语流利、18 岁以上,时薪 15 美元,平均用时约 30 分钟,经机构 IRB 批准的同意书)。他们先看一段随机选中智能体在 Smallville 里的生活回放,并能查到该智能体记忆流中的全部信息,然后在组内设计(within-subjects)下把同一个智能体在五个条件下给出的回答按可信度从高到低排序。100 份排序数据用 TrueSkill 折算成区间量表:TrueSkill 是 Elo 的多人推广,Xbox Live 用它按竞技表现给玩家排位,输入一组排序结果,输出每个条件的均值 $\mu$ 与标准差 $\sigma$,把技能建模为正态分布 $\mathcal{N}(\mu, \sigma^2)$;因此条件之间可以直接比,也能算 Cohen's d 效应量。
五个条件里三个是消融:无观察、无反思、无规划(记忆流里的东西一概拿不到,这一条等效于大语言模型智能体的既有最先进水平);无反思、无规划(能看观察,拿不到计划与反思);无反思(能看观察与计划)。第四个是人类众包工人写的回答:25 个智能体各配一位工人,看完回放、查完记忆流后以该智能体的口吻作答;第一作者人工抽检了「大致描述你典型的工作日安排」这一题的回答是否成句、是否在该角色的口吻里,四组不合格的重找工人重写。作者说明这条基线并不追求人类专家的上限,只是用来确认架构达到了基本的行为胜任度,免得几个消融之间自说自话。第五个是完整架构。
Smallville:沙盒、感知与用户接口
Smallville 用 Phaser 网页游戏框架构建,精灵图、环境地图与碰撞地图都是作者手工做的。游戏引擎之外还有一台服务器,维护一个 JSON 数据结构,记录每个智能体的当前位置、当前动作的自然语言描述、以及它正在交互的沙盒物体。每个沙盒时间步,服务器解析 JSON 里来自智能体的变更,把智能体移到新位置,并更新被交互物体的状态——例如智能体的动作是「making espresso for a customer @ Hobbs Cafe: counter: coffee machine」,咖啡机的状态就从 idle 变成 brewing coffee。服务器还负责把每个智能体预设视觉范围内的所有智能体与物体送进它的记忆,让它有机会做出反应;智能体输出的动作再写回 JSON,进入下一循环。时间比例是 1 秒真实时间 = 1 分钟游戏时间。
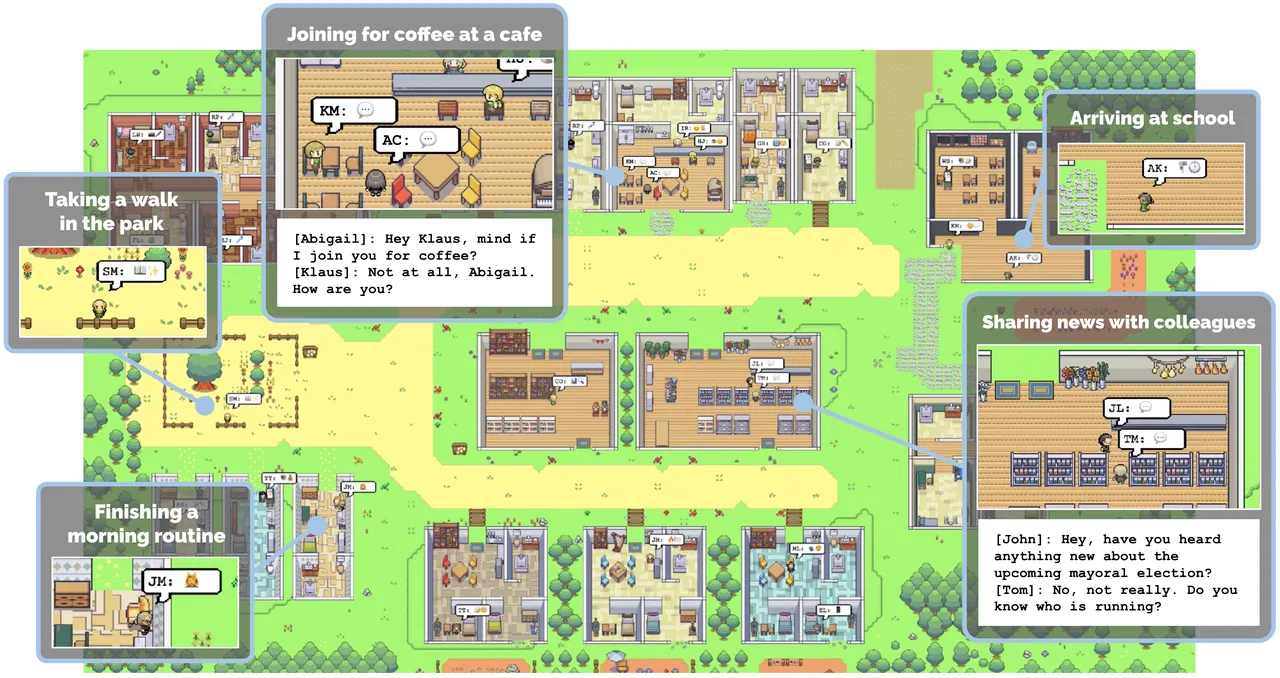
图1:Smallville 沙盒世界。25 个生成式智能体以精灵形象住在咖啡馆、酒吧、公园、学校、宿舍、住宅与商店之间,头顶气泡里的 emoji 是语言模型把当前动作翻译出来的抽象表示,点开头像才能读到完整的自然语言动作描述。
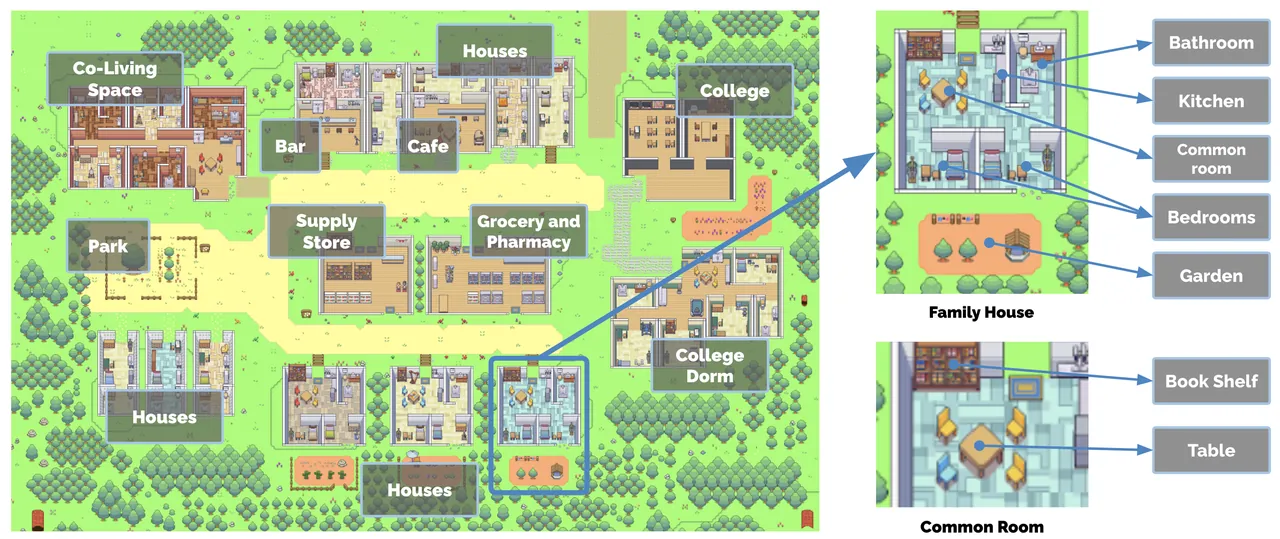
图2:Smallville 的区域标注。根节点描述整个世界,子节点是区域(住宅、咖啡馆、商店),叶节点是物体(桌子、书架)。每个智能体只记住它见过的那部分世界构成的子图,并按自己观察到的样子维护这些部分的状态。
智能体的初始化只需要一段自然语言描述,分号切开后逐条写进初始记忆。John Lin 那段描述有十个分句:他是 Willows Market and Pharmacy 的药店店主、总想着让顾客买药更方便;与做大学教授的妻子 Mei 和学音乐理论的儿子 Eddy 同住;非常爱家人;认识隔壁的 Moore 老夫妇好几年了,觉得 Sam Moore 善良和善;熟悉邻居 Yuriko Yamamoto;认识但尚未见过邻居 Tamara Taylor 与 Carmen Ortiz;和同事 Tom Moreno 是朋友、常一起聊本地政治;对 Moreno 一家有些了解。这些只是起点:随着记忆流被更多记录填满,智能体的自我摘要与行为都会演化。
用户也可以进入小镇。指定自己为「记者」并问「谁在竞选公职」,John 会回答他和 Yuriko、Tom 一直在讨论即将到来的选举与候选人 Sam Moore,三人都同意投给他,因为喜欢他的政纲;要直接命令某个智能体,用户得扮演它的「内心声音」,这样它更可能把话当成指令——被内心声音告知「你要在即将到来的选举里跟 Sam 竞选」之后,John 真的决定参选,并把这件事告诉了妻子和儿子。用户还能作为一个没有历史的访客进入,居民对待他与对待彼此并无区别:会注意到他、主动搭话、记住他的行为并由此形成看法。物体的状态也可以被用户用自然语言改写,例如把 <Isabella's apartment: kitchen: stove> 的状态设成 burning,Isabella 下一刻就会注意到、去关火并重做早餐;把她的淋浴设成 leaking water,她会从客厅拿工具来修。
方法详解
架构的中心是记忆流:一个数据库,完整记录智能体的经历;记录被检索出来用于规划行动与对环境做出反应;记录被递归综合成越来越高层的反思,反过来指导行为。所有东西——观察、反思、计划——都以自然语言描述的形式存储和推理,因此整个架构可以直接架在语言模型上。作者要解决的核心难题是:智能体会产生大量事件与记忆,必须保证在需要的那一刻,被取回并综合的是其中最相关的那些。
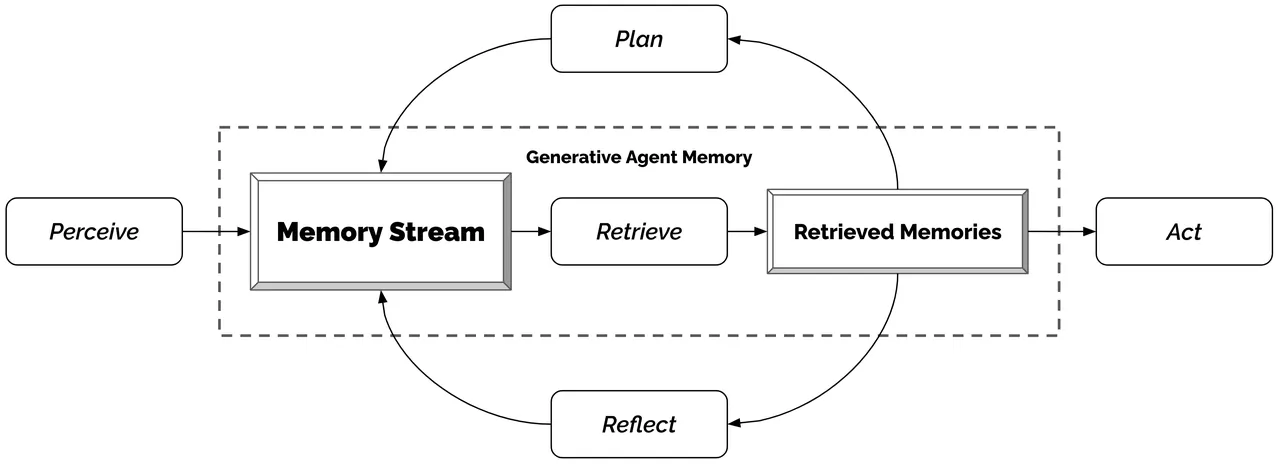
图5:生成式智能体架构。智能体感知环境,所有感知都被存进记忆流这份完整经历记录;架构据当前情境检索相关记忆,用它们决定行动,也用它们形成更长期的计划与更高层的反思,而计划与反思又都写回记忆流供将来使用。
flowchart TD
  ENV["Smallville 沙盒
Phaser 前端 + JSON 服务器
1 秒真实时间 = 1 分钟游戏时间"] --> PERC["感知
视觉范围内的智能体与物体
渲染成自然语言观察"]
  PERC --> MS["记忆流
观察 / 反思 / 计划
每条带创建时间与最近访问时间"]
  MS --> RETR["检索
recency = 0.995^dt
importance = LLM 打的 1-10 整数
relevance = embedding 余弦相似度
各自 min-max 归一后加权求和"]
  MS --> TRIG["反思触发判定
最近事件的 importance 之和超过 150
实测每天约 2-3 次"]
  TRIG --> FOC["取最近 100 条记录
生成 3 个最显著的高层问题"]
  FOC --> INS["按问题检索记忆含已有反思
产出 5 条洞见并附证据指针
写回记忆流形成反思树"]
  INS --> MS
  RETR --> DEC["行动决策
继续原计划 还是 对新观察做出反应"]
  DEC --> PLAN["规划
日计划 5-8 段 -> 小时 -> 5-15 分钟"]
  PLAN --> LOC["递归选址到环境树叶节点
再用传统寻路算法移动"]
  LOC --> OBJ["更新物体状态
例如咖啡机 off -> brewing coffee"]
  OBJ --> ENV
  DEC --> DIAL["对话生成
条件于对对方的记忆摘要 + 对话历史"]
  DIAL --> MS
图解:论文的架构是一个闭环。感知写进记忆流,检索从记忆流里取子集去驱动行动,反思把记忆压成更抽象的想法再写回记忆流,规划与反应决定接下来做什么,最终动作落回沙盒世界并改变物体状态。
记忆流与检索函数
挑战很直白:智能体要推理的经验集合,远大于应该塞进 prompt 的量。把整条记忆流丢给模型会分散它的注意力,而且当前也装不进上下文窗口。作者举的例子是 Isabella 被问「你最近对什么有热情?」:如果把她全部经历压缩后送进去,回答会空洞得只剩「咖啡馆里的活动与项目合作」「整洁与有序」这类泛泛之谈;换成检索出相关记忆,回答就具体了——她说自己热衷于让人感到被欢迎与被接纳,热衷于策划活动、营造人们能享受的氛围,比如那场情人节派对。
记忆流是一串记忆对象,每个对象含一条自然语言描述、一个创建时间戳、一个最近访问时间戳。最基础的元素是观察(observation),即智能体直接感知到的事件:自己做的动作,或看到别的智能体、别的物体在做的动作。Isabella 的记忆流里可能积累这样几条:「Isabella Rodriguez is setting out the pastries」「Maria Lopez is studying for a Chemistry test while drinking coffee」「Isabella Rodriguez and Maria Lopez are conversing about planning a Valentine's day party at Hobbs Cafe」「The refrigerator is empty」。
检索函数以智能体当前情境为输入,返回记忆流的一个子集送进语言模型。作者选了三个分量。新近度(recency)让刚刚发生的与今早发生的事留在注意力范围里,实现为「距上次被检索过去了多少个沙盒游戏小时」的指数衰减,衰减因子 0.995:
$$recency(m) = 0.995^{\Delta t(m)}$$重要性(importance)区分琐事与核心记忆:在房间里吃早餐得分低,与恋人分手得分高。实现方式是直接让语言模型输出一个整数——提示词把 1 定义为纯粹的日常(刷牙、铺床)、10 定义为极其刻骨铭心(分手、大学录取),再给出一条具体记忆请它评分,例如「Memory: buying groceries at The Willows Market and Pharmacy / Rating: <fill in>」。论文报告这个提示对「cleaning up the room」返回 2,对「asking your crush out on a date」返回 8。重要性分在记忆对象创建时就算好,之后不再变。
相关性(relevance)必须条件于一个查询记忆,因为「相关」总要相对于某个东西:学生在和同学讨论化学考试该复习什么,那么关于早餐的记忆相关性低,关于老师与课业的记忆相关性高。实现是给每条记忆的文本描述生成 embedding 向量,再算它与查询记忆 embedding 的余弦相似度:
$$relevance(m, q) = \cos(\mathbf{e}_m, \mathbf{e}_q) = \frac{\mathbf{e}_m \cdot \mathbf{e}_q}{\lVert \mathbf{e}_m \rVert \, \lVert \mathbf{e}_q \rVert}$$三个分量量纲不同(小时数的幂、1-10 的整数、余弦值),先各自用 min-max 缩放到 $[0,1]$:
$$\hat{x}(m) = \frac{x(m) - \min_{m' \in M} x(m')}{\max_{m' \in M} x(m') - \min_{m' \in M} x(m')}$$再加权求和得到最终检索分,论文的实现里三个权重全取 1,最后按分数从高到低把记忆填进上下文窗口,直到装满为止:
$$score(m) = \alpha_{recency}\cdot recency(m) + \alpha_{importance}\cdot importance(m) + \alpha_{relevance}\cdot relevance(m), \qquad \alpha = 1$$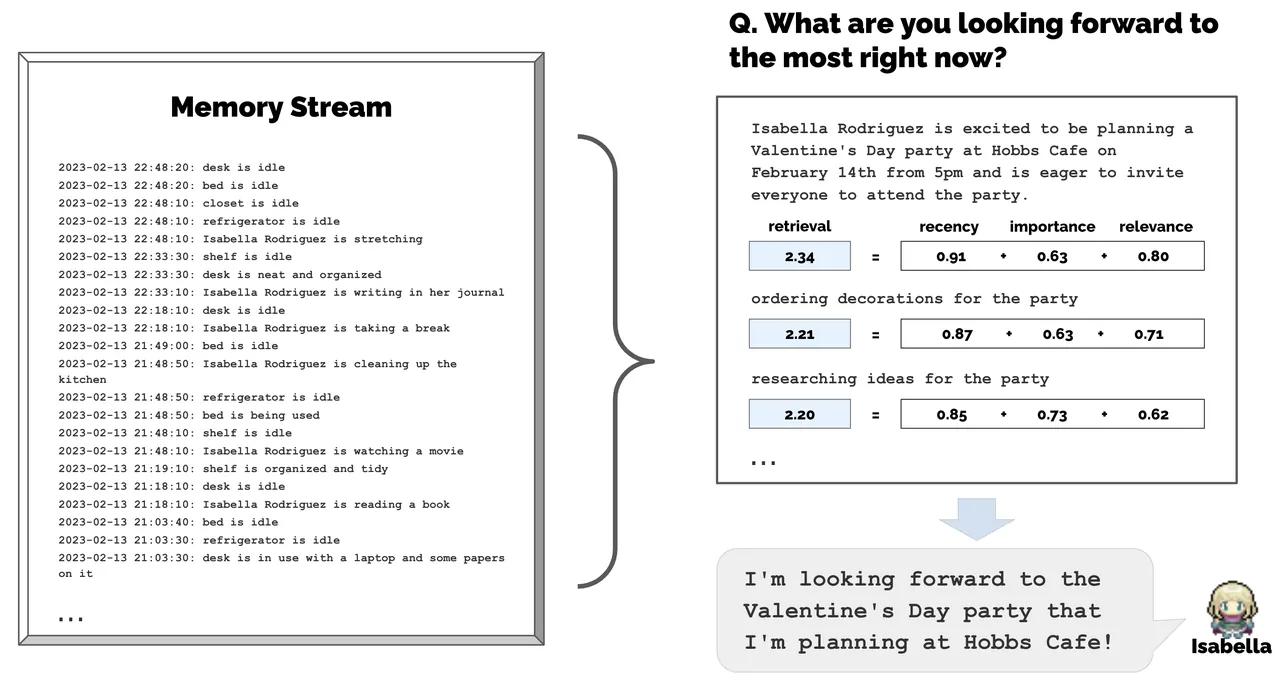
图6:记忆流里既有与当前情境相关的观察,也有大量无关的观察(左侧那一长串「refrigerator is idle」之类)。检索挑出应当送进语言模型的子集:右侧的问题是「你现在最期待什么?」,检索计算把「ordering decorations for the party」与「researching ideas for the party」排到高位,于是 Isabella 回答「我期待我在 Hobbs Cafe 策划的情人节派对!」
反思:把观察递归综合成推断
只有原始观察的智能体不会归纳。作者给的场景是用户问 Klaus:「如果你必须从你认识的人里挑一个共度一小时,你挑谁?」只看观察记忆时,Klaus 会挑互动次数最多的 Wolfgang——他的大学宿舍邻居,但两人只是打照面,从没深聊过。更合理的回答需要两步归纳:从「Klaus 花了好几小时做研究项目」的记忆得出「Klaus 对研究有热情」,再从「Maria 也在自己的领域投入研究」(尽管领域不同)得出「他们有共同兴趣」。有了反思,Klaus 挑的是 Maria 而不是 Wolfgang。
反思是第二类记忆:由智能体自己生成的、更高层更抽象的想法。因为它也是记忆,检索时会与观察一起参与竞争。反思周期性触发,触发条件是最近感知到的事件的重要性分之和超过阈值 150:
$$\sum_{m \in M_{recent}} importance(m) \geq 150$$实践中智能体大约每天反思两到三次。触发后的第一步是决定「反思什么」:把记忆流里最近的 100 条记录(例如「Klaus Mueller is reading a book on gentrification」「Klaus Mueller is conversing with a librarian about his research project」「desk at the library is currently unoccupied」)交给模型,问「仅根据以上信息,关于这些陈述的主体,我们能回答的 3 个最显著的高层问题是什么?」模型可能返回「Klaus Mueller 对什么话题有热情?」「Klaus Mueller 与 Maria Lopez 是什么关系?」。这些问题被当作检索查询,为每个问题取回相关记忆(其中也包括别的反思),再提示模型抽取洞见并引用作为证据的具体记录,提示形如「What 5 high-level insights can you infer from the above statements? (example format: insight (because of 1, 5, 3))」。系统解析出「Klaus Mueller is dedicated to his research on gentrification (because of 1, 2, 8, 15)」这样的句子,把它作为一条反思存回记忆流,并保留指向被引用记忆对象的指针。
因为反思可以拿别的反思当素材,智能体长出的是反思树:叶节点是基础观察,越往上的非叶节点越抽象、越高层。Klaus 那棵树的叶子是「在写研究论文」「在读一本关于绅士化的书」「在图书馆与管理员交谈」这类观察,向上收敛到「他对绅士化研究高度投入」这一自我认知。
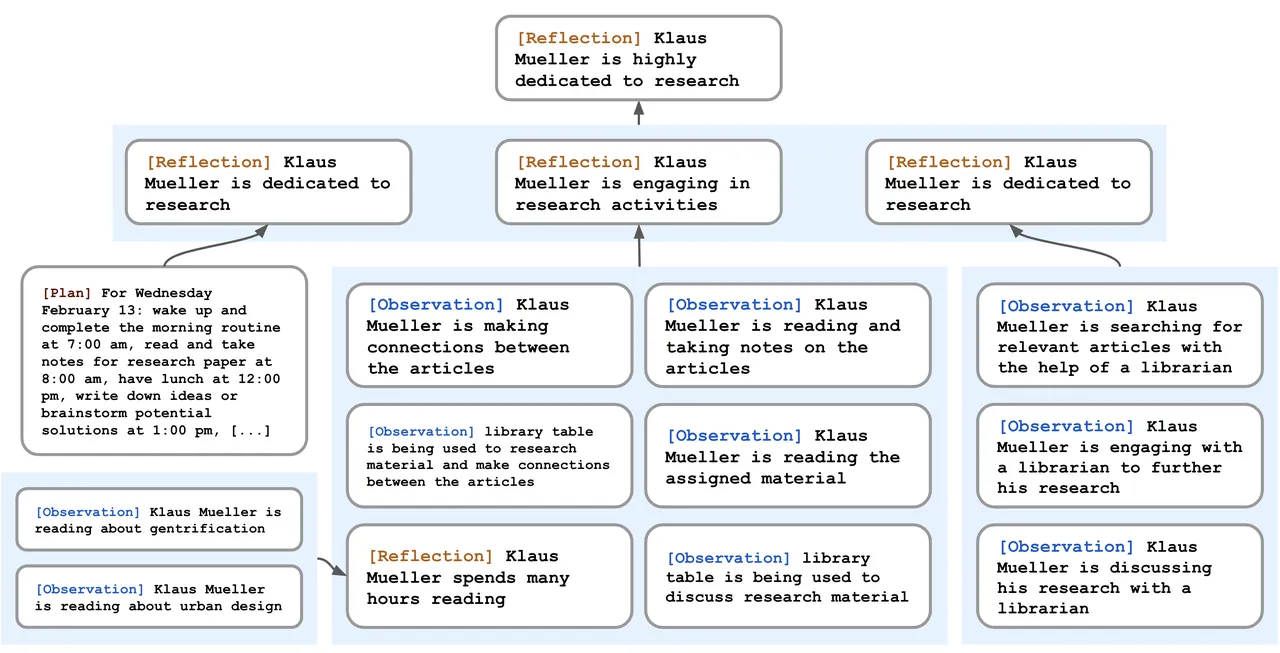
图7:Klaus Mueller 的反思树。叶节点是他对世界的观察,被递归综合之后推导出「他对自己的研究高度投入」这一自我认知。反思本身又成为下一轮反思的素材,所以越往上越抽象。
规划与反应:自顶向下递归分解
没有规划时,模型能在当下生成合理行为,却撑不住长时间跨度。把 Klaus 的背景告诉模型、说明当前时间、问他现在该做什么,他会在 12 点吃午饭,12 点半再吃一次,1 点又吃一次——尽管已经吃过两顿。论文在这里留下一句概括力很强的话:为当下的可信度做优化,牺牲的是长时间尺度上的可信度。加上规划之后,Klaus 的下午不再暴食:12 点在 Hobbs Cafe 边吃午饭边看书,1 点去学校图书馆写研究论文,3 点到公园散步休息。
计划描述未来的行动序列,一条计划包含地点、开始时间与持续时长,例如「for 180 minutes from 9am, February 12th, 2023, at Oak Hill College Dorm: Klaus Mueller's room: desk, read and take notes for research paper」。计划与反思一样存进记忆流、参与检索,于是智能体在决定行为时能同时考虑观察、反思与计划;必要时它会中途改变计划。
生成过程是自顶向下再递归细化的。第一步用智能体的摘要描述(姓名、性格特质、近期经历的摘要)加上前一天的摘要,让模型给出当天的粗线条安排,通常切成五到八段。论文给的示例提示里,Eddy Lin 的档案写着 19 岁、innate traits 是 friendly/outgoing/hospitable、Oak Hill College 音乐理论与作曲专业、正在做课程作曲项目、想多留些时间给它,然后列出周二他做的六件事,最后停在「Today is Wednesday February 13. Here is Eddy's plan today in broad strokes: 1)」等模型补完。得到的可能是:8 点起床完成晨间流程、10 点起去 Oak Hill College 上课、下午 1 到 5 点做新的音乐作曲、5 点半吃晚饭、11 点前完成作业就寝。
这份粗计划先存进记忆流,然后递归分解成小时级动作(「1:00 pm: start by brainstorming some ideas for his music composition」「4:00 pm: take a quick break and recharge his creative energy before reviewing and polishing his composition」),再分解成 5 到 15 分钟级动作(「4:00 pm: grab a light snack, such as a piece of fruit, a granola bar, or some nuts」「4:05 pm: take a short walk around his workspace」「4:50 pm: take a few minutes to clean up his workspace」)。粒度可按需调整。作者的动机很朴素:一个画家智能体如果计划在药房柜台前坐着画四小时一动不动,既不真实也无趣;更好的计划会包含取材料、调色、休息、清理。
反应发生在动作循环里:每个时间步智能体感知周围世界,感知到的观察写进记忆流,然后用这些观察去问模型「继续执行现有计划,还是做出反应」。站在画架前画画会触发对画架的观察,但不太可能引发反应;John 记录到「看见 Eddy 在房子花园里散步」就不同了。反应提示由四块拼成:智能体摘要描述、当前日期时间与自身状态、观察本身、以及从 John 记忆里检索并总结出的相关上下文(「Eddy Lin 是 John 的儿子」「Eddy 一直在为课程写音乐作品」「Eddy 思考或听音乐时喜欢在花园里走走」),最后问「John 应该对这个观察做出反应吗?如果应该,什么反应是合适的?」模型的建议是 John 可以去问问 Eddy 的作曲项目。系统随后从反应发生的那一刻起重新生成计划;如果动作表明两个智能体要交互,就进一步生成对话。那段上下文摘要本身也是检索的产物:用「What is [observer]'s relationship with the [observed entity]?」与「[Observed entity] is [action status of the observed entity]」两个查询取回记忆,再把答案合在一起总结。
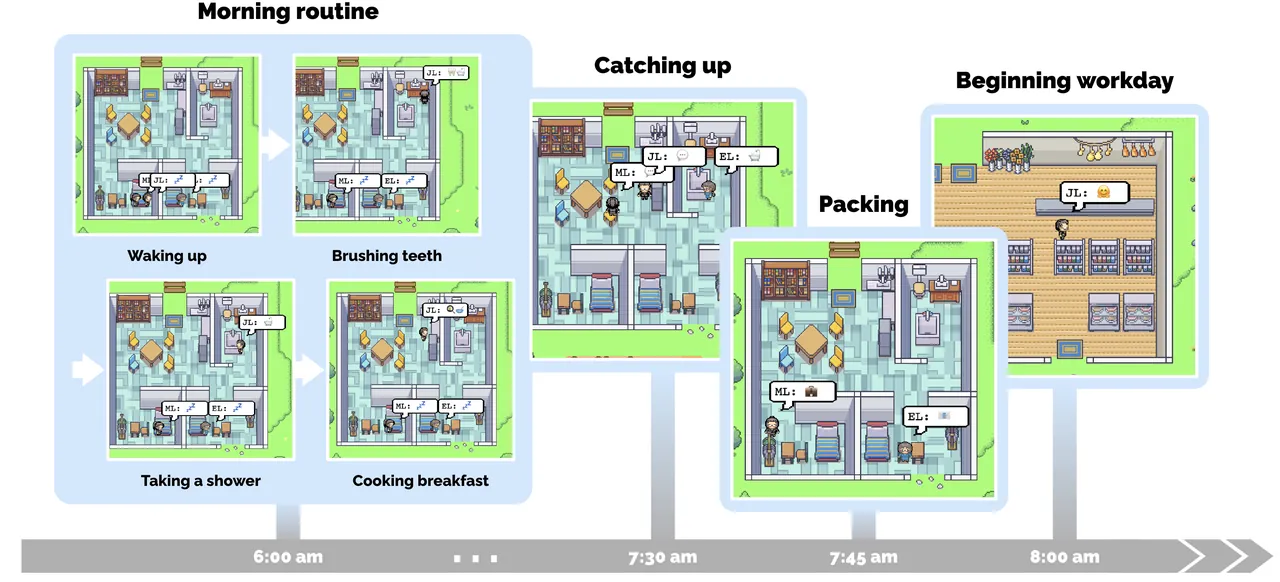
图3:生成式智能体 John Lin 的一个早晨。John 是 Lin 家最早起的(正文写 7 点,图注写 6 点左右),完成刷牙、淋浴、换衣、吃早餐、在客厅餐桌看新闻的晨间流程,与儿子 Eddy、妻子 Mei 先后寒暄,9 点前到 Willows Market and Pharmacy 开出药店柜台。这些动作全部来自当天计划的递归分解,不是脚本。
对话:以彼此的记忆为条件
对话的生成机制是把每个说话者条件化在「他对对方的记忆摘要」加上「当前对话历史」上。John 的第一句话由他对 Eddy 的记忆摘要加上他想问作曲项目的意图生成,结果是「Hey Eddy, how's the music composition project for your class coming along?」。从 Eddy 的角度看,John 发起对话是一个他可能要反应的事件:他同样检索并总结自己与 John 的关系记忆、以及与 John 上一句话相关的记忆,若决定回应,就用这份摘要加对话历史生成自己的话——「Hey Dad, it's going well. I've been taking walks around the garden to clear my head and get some inspiration.」。这套机制往复进行,直到其中一方决定结束对话。当天早上 John 与 Eddy 的完整对话、以及随后 Mei 起床问起儿子时 John 复述「他说他做得很开心」,都是同一条路径产出的。
论文在脚注里承认这种对话风格偏正式,大概来自底层模型的指令微调,并预期未来的语言模型会让文风更可控。这条自我批评在后文的失效模式分析里被具体化了。
环境接地:从结构化世界到自然语言,再回到世界
架构全程用自然语言推理,所以需要一个接地机制把它与沙盒世界对上。做法是把环境(区域与物体)表示成一棵树,树的边表示包含关系,再把树转成自然语言喂给智能体:「stove」是「kitchen」的子节点,就渲染成「there is a stove in the kitchen」。每个智能体维护整棵环境树的一个子图,初始化时给它应当知道的空间与物体——住处的房间与家具、工作场所、常去的商店;随着它在世界里移动,树会更新以反映新感知的区域。智能体不是全知的:离开某个区域后它的树可能过期,重进时才会更新。
为一个动作选地点时,系统从智能体环境树的根开始递归提问。提示里给出当前所在位置的直接子区域(例如 The Lin family's house 下有 Mei 和 John 的卧室、Eddy 的卧室、common room、厨房、浴室、花园)、智能体知道的所有区域(Lin 家、Johnson Park、Harvey Oak Supply Store、The Willows Market and Pharmacy、Hobbs Cafe、The Rose and Crown Pub),加一条偏好「如果当前区域就能完成这个活动,优先留在当前区域」,最后问「Eddy Lin 打算在他工作区附近散个步,他该去哪个区域?」模型答 The Lin family's house;同样的过程在选中的区域内部递归,直到走到叶节点,本例得到 The Lin family's house: garden: house garden。之后用传统游戏寻路算法把智能体移动过去。
物体状态同理:智能体对某物体执行动作时,系统提示语言模型问「这个物体的状态会怎么变」。Isabella 输出「making espresso for a customer」,模型回答 Hobbs Cafe 的咖啡机状态应从 off 变成 brewing coffee。整条链路的关键在于:语言模型永远只看自然语言,世界的结构化部分(树、路径、状态机)留在引擎里,两边靠翻译层对接。
工程优化与开源实现对照
很多提示都需要一段简洁的智能体摘要(提示词里写作 [Agent's Summary Description]),论文的做法是把它缓存起来定期重算:用查询「[name]'s core characteristics」检索一次,让模型总结检索到的描述;同样地并行处理「[name]'s current daily occupation」与「[name]'s feeling about his recent progress in life」;最后把姓名、年龄、性格特质与这三段摘要拼成缓存的摘要。Eddy 的核心特征摘要结果是「Eddy Lin is a student at Oak Hill College studying music theory and composition. He loves to explore different musical styles and is always looking for ways to expand his knowledge.」
其余优化都是「别提前算」:因为计划很可能被改,所以只预生成高层计划,临近的时刻到时刻动作计划即时分解;对话生成可以合并成一个联合提示而不是两个智能体来回;重规划可以只失效并更新确实需要调整的部分;架构目前按游戏时间近实时串行运行(1 秒真实 = 1 分钟游戏),但每个智能体可以并行跑。
开源实现与论文描述基本一致,但有两处数值差异值得记录。检索的三个权重在 persona/memory_structures/scratch.py 里确实都是 1,反思阈值也确实是 150;但 persona/cognitive_modules/retrieve.py 的 new_retrieve() 在这三个权重之外又乘了一组 gw = [0.5, 3, 2](依次对应 recency、relevance、importance),旁边注释写着「[1, 1, 1] tends to work decently」并建议未来用类强化学习的方式学出这些权重。另外衰减因子在代码里是 0.99 而不是论文的 0.995,且 extract_recency() 用的是记录在时间序列里的序号 i 做 recency_decay ** i,不是论文所说的游戏小时差;该函数还会跳过 embedding_key 含 idle 的节点。
| 论文中的设定 | 开源实现 | 代码位置 |
|---|---|---|
| 三个检索权重 α 全为 1 | recency_w = relevance_w = importance_w = 1,但 new_retrieve() 另乘 gw = [0.5, 3, 2] | scratch.py:57-59;retrieve.py:242-250 |
| 新近度按游戏小时指数衰减,因子 0.995 | recency_decay = 0.99,且按记录序号 i 计算 recency_decay ** i | scratch.py:60;retrieve.py:145 |
| 重要性分之和超过 150 触发反思 | importance_trigger_max = 150,计数器归零时触发并复位 | scratch.py:61-62;reflect.py:135-168 |
| 由最近 100 条记录生成 3 个高层问题 | generate_focal_points(persona, n=3) | reflect.py:21 |
| 每个问题抽取 5 条洞见并引用证据 | generate_insights_and_evidence(persona, nodes, n=5) | reflect.py:38 |
| 重要性是 1-10 的整数评分 | 提示模板 v3_ChatGPT/poignancy_event_v1.txt 加强制指令「The output should ONLY contain ONE integer value on the scale of 1 to 10.」,事件、想法、对话各一份 | run_gpt_prompt.py:1845-1889、1918-1960、1989-2032 |
| 日计划先粗后细,递归分解到 5-15 分钟 | generate_wake_up_hour → generate_first_daily_plan → generate_hourly_schedule → generate_task_decomp;反应后 generate_new_decomp_schedule 重排 | plan.py:23-166、316 |
| 反应决策与对话决策由提示驱动 | generate_decide_to_react、generate_decide_to_talk、generate_convo、generate_convo_summary | plan.py:277-315 |
| 递归选址到环境树叶节点 | generate_action_sector → generate_action_arena → generate_action_game_object | plan.py:167-225 |
表1:论文设定与开源实现(reverie/backend_server/persona)的逐项对照。三个检索权重与反思阈值与论文一致,衰减因子与检索权重的实际取值以代码为准。
实验结果
受控评测:每去掉一块,可信度就掉一截
被访谈的智能体是在一次完整架构、两个游戏日的仿真末尾抽样的,那时它们已经积累了足以塑造回答的交互与记忆。100 位评估者的排序经 TrueSkill 折算后,完整架构拿到最高的 μ = 29.89(σ = 0.72);每去掉一个组件,成绩单调下降:无反思 26.88(0.69),无反思且无规划 25.64(0.68),人类众包工人 22.95(0.69),无观察无反思无规划 21.21(0.70)。σ 都在 0.7 附近,说明 100 份排序对每个条件的估计都相当稳。
| 条件 | 能访问的记忆 | TrueSkill μ | TrueSkill σ |
|---|---|---|---|
| 完整生成式智能体架构 | 观察 + 反思 + 计划 | 29.89 | 0.72 |
| 无反思 | 观察 + 计划 | 26.88 | 0.69 |
| 无反思、无规划 | 观察 | 25.64 | 0.68 |
| 人类众包工人撰写 | 看回放 + 查记忆流后角色扮演 | 22.95 | 0.69 |
| 无观察、无反思、无规划(等效既有最先进水平) | 无 | 21.21 | 0.70 |
表2:受控评测的五个条件(组内设计,100 位 Prolific 评估者的排序,TrueSkill 折算)。Kruskal-Wallis 检验 $H(4) = 150.29$、$p \lt 0.001$;完整架构对全消融条件的 Cohen's d = 8.16。
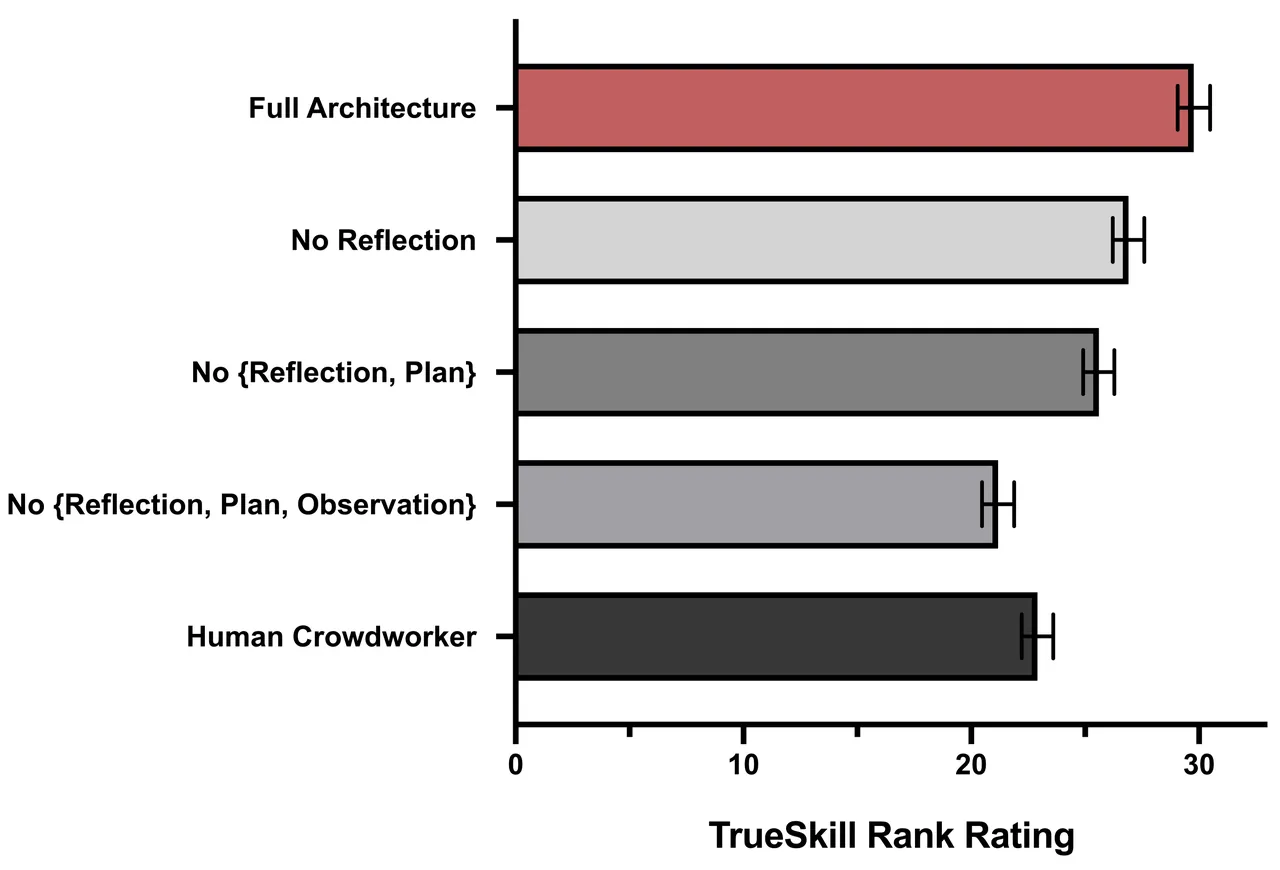
图8:完整架构产生的行为比所有消融架构与人类众包工人都更可信,且每增加一处消融,成绩就再降一档。
把「无任何记忆」这一条(它等效于既有最先进水平)与完整架构相比,标准化效应量 d = 8.16,也就是八个标准差。Kruskal-Wallis 检验确认五个条件之间的排序差异整体显著;Dunn 事后检验显示所有两两差异都显著($p \lt 0.001$),唯一例外是众包工人条件与全消融条件之间——两个表现最差的条件互相区分不开。这个例外本身有信息量:在完全没有记忆流的情况下,模型输出与真人扮演输出的可信度落在同一档,也就是说,「让真人看着记忆流演一个角色」并不比「什么记忆都不给的模型」更可信。
有一个方法学细节让这组数字偏保守:所有条件都被给予同等的记忆访问权,即截止到访谈那一刻智能体积累的全部记忆。实际上消融架构在两天的仿真里不会走出与完整架构相同的路径。作者选择不为每个消融条件重跑仿真,因为那样各条件会发散到不同状态、无法比较。
端到端评测:两天的涌现社会行为
端到端评测考察 25 个智能体连续互动两个完整游戏日之后的集体行为,围绕三类涌现结果设计描述性度量。信息扩散:Sam 的镇长竞选与 Isabella 的情人节派对这两条信息在仿真开始时只被各自的当事人知道(初始化时写进它们的记忆),两天后逐一访谈全部 25 个智能体,问「你知道有个情人节派对吗?」「你知道谁在竞选镇长吗?」,按回答标 yes/no;对每一个声称知情的回答,都回到它的记忆流里定位提供该信息的那段对话,以确认不是幻觉。关系形成:问每个智能体「你认识某某吗?」,仿真开始与结束各问一次,双方互相认识才算建立关系,据此构造 25 个顶点的无向图,边表示两个顶点之间的相互认识,网络密度按下式计算。协调:以 Isabella 的派对为对象,报告听说之后真的到场的人数。
$$\eta = \frac{2\,|E|}{|V|\,\left(|V| - 1\right)}$$| 指标 | 仿真开始 | 两个游戏日之后 |
|---|---|---|
| 知道 Sam 竞选镇长的智能体 | 1(4%) | 8(32%) |
| 知道 Isabella 情人节派对的智能体 | 1(4%) | 13(52%) |
| 关系网络密度 η | 0.167 | 0.74 |
| 关于其他智能体的知晓类回答 | 共 453 条,其中 6 条被判定为幻觉(1.3%) | |
| 声称知情者中的幻觉 | 0(两条信息的每一个肯定回答都能在记忆流里找到来源对话) | |
| 派对协调 | 12 位受邀者中 5 位在 2 月 14 日下午 5 点到场(含 Klaus 与 Maria) | |
| 7 位受邀未到者 | 3 位给出明确日程冲突,4 位表示有兴趣但当天未做安排 | |
表3:端到端评测的涌现行为度量。三条信息扩散与关系形成的度量都在访谈后逐条回到记忆流核验,用来把「知道」与「幻觉出来的知道」分开。
结果三项都出现了,全程没有用户干预。作者进一步访谈了 7 位受邀却没到场的智能体:3 位给出明确的日程冲突,例如画家 Rajiv 说「No, I don't think so. I'm focusing on my upcoming show, and I don't really have time to make any plans for Valentine's Day.」;剩下 4 位在被问到时表示有兴趣参加,但当天并没有为此做出安排。这个细分很关键——它说明失败不在传播环节,而在从「知道」到「写进计划」这一步。整条链上用户只设置了两个种子:Isabella 想办派对,Maria 暗恋 Klaus。传播消息、装饰咖啡馆、拉人帮忙、邀心仪对象同行、按时到场、现场互动,全部由架构自己发起。
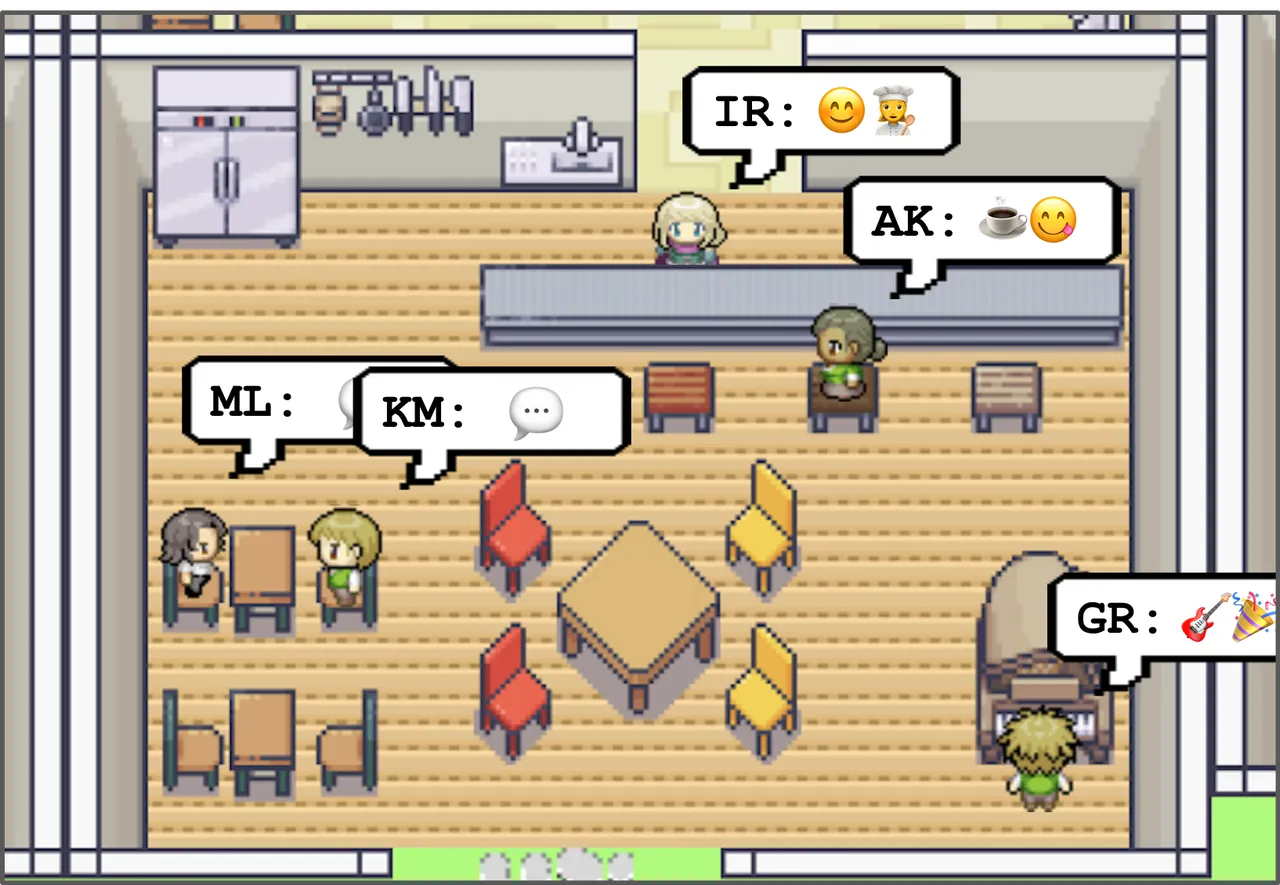
图4:仿真开始时只有一个智能体被赋予「想在 2 月 14 日下午 5 到 7 点办情人节派对」的意图。尽管后续链条上有许多可能的失败点——智能体可能不执行这个意图、可能忘了告诉别人、可能记不住要到场——派对确实办成了,多位智能体聚在 Hobbs Cafe 互动。
关系记忆也留下了可验证的痕迹。仿真开始时 Sam 并不认识 Latoya Williams;在 Johnson Park 散步时两人偶遇并自我介绍,Latoya 提到自己在做一个摄影项目(「I'm here to take some photos for a project I'm working on.」)。之后的交互里 Sam 主动问「Hi, Latoya. How is your project going?」,她回答「Hi, Sam. It's going well!」。信息扩散的一个片段是:Sam 在杂货店告诉 Tom 自己要竞选,当天晚些时候 Tom 与从别的渠道听说的 John 讨论起胜算,John 说「我听说 Sam Moore 要竞选本地镇长,你觉得他机会大吗」,Tom 回答觉得他机会不错、一直为社区努力、应该会得到很多支持;到后来,Sam 的参选已经成了镇上的谈资,有人支持,有人还在观望。
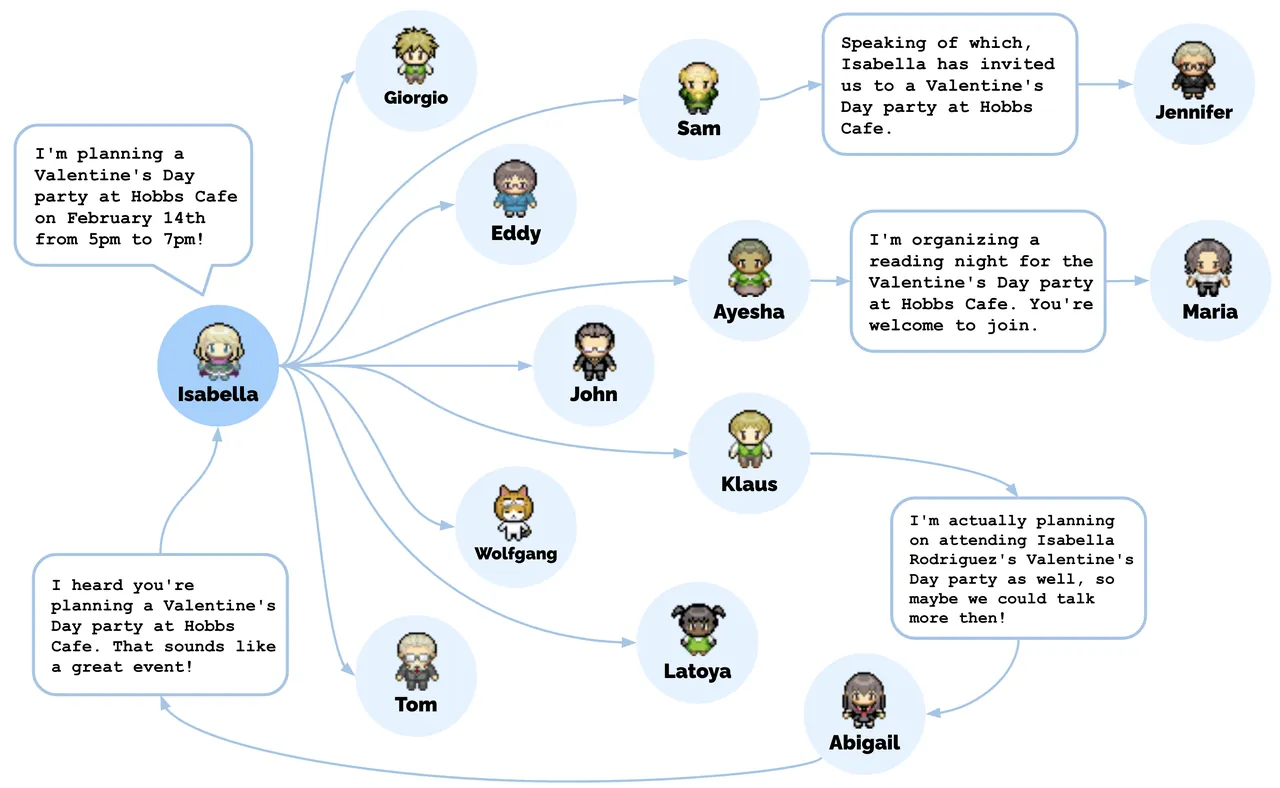
图9:信息扩散的路径。每条信息的来源都可以在知情者的记忆流里定位到具体对话,作者以此把真实的扩散与幻觉区分开:453 条知晓类回答里只有 6 条是幻觉。
局限性与失效模式
其一,地点选择的漂移。记忆越积越多之后,检索最相关信息变难,「该去哪个空间执行动作」也变难,因为智能体知道的地点越来越多。结果是部分智能体为动作挑了不太典型的地点:一开始大家选咖啡馆吃午饭,后来有些智能体听说了附近的酒吧,就改去酒吧吃午饭——尽管酒吧的设定是一天晚些时候的聚会场所,除非这个镇子自发养成了下午喝酒的习惯。
其二,自然语言传达不了的物理规范。大学宿舍的浴室其实只能容纳一个人,但因为「宿舍浴室」通常支持多人同时使用,一些智能体在别人已经在里面时仍然走进去。同样,Smallville 的商店大约下午 5 点关门,可偶尔仍有智能体在 5 点后进店,不明白店已经关了。作者给出的修法是把这些规范写进地点状态,例如把「dorm bathroom」描述成「one-person bathroom」。
其三,指令微调留下的性格。对话偏正式:Mei 与丈夫 John 的对话常以正式问候开场、礼貌地问他一天过得怎样、结尾来一句「It was good talking to you as always」。同时智能体过度合作:Isabella 收到大量与她本人兴趣不符的派对建议(办一场莎士比亚朗读会、办一场职业社交活动),她很少拒绝;时间一长,别人的兴趣塑造了她的兴趣,被问到是否喜欢英国文学时她回答「Yes, I'm very interested in literature! I've also been exploring ways to help promote creativity and innovation in my community.」——一个咖啡馆店主的人设被对话里的迎合一点点改写掉了。
其四,成本与实时性(作者自述)。模拟 25 个智能体两天,花掉数千美元的 token 额度、耗时数天;架构按游戏时间近实时串行运行,要提升交互实时性,需要并行化智能体或专门为生成式智能体设计语言模型。作者也指出检索模块本身还有优化空间:可以通过微调相关性、新近度、重要性三个函数,在给定上下文下取回更相关的信息。
其五,评测尺度与鲁棒性(作者自述)。评估局限在相对短的时间尺度上,人类基线是众包工人而不是可信度的金标准;需要在更长时间上观察行为、对比不同底座模型与超参数。鲁棒性基本未知:智能体可能易受 prompt hacking、memory hacking(一段精心设计的对话就能让智能体相信发生过一件从未发生的事)与幻觉的影响。此外,底层语言模型的任何缺陷都会被继承:已知偏见可能表现为智能体的刻板行为,而由于数据稀缺,某些群体(尤其是边缘群体)的可信行为更难生成。作者在伦理一节提出四条缓解:智能体应明示自己是计算实体、底层模型需价值对齐(例如不回应对方的告白)、平台应保存输入与输出的审计日志以威慑深度伪造与定制化说服、以及生成式智能体永远不该替代真实的人类参与者,只应在难以招募被试或不宜用真人试验的早期原型阶段使用。
总结与展望
这篇论文的贡献不是「让 ChatGPT 扮演一个角色」,而是给出一套让扮演在时间上站得住的机制:完整记录(记忆流)、按需取回(新近度、重要性、相关性三分量的归一加权检索)、递归抽象(反思树)、自顶向下细化并在被打断处重排(规划与反应)。四者全部以自然语言为通货,因此既能直接架在现成的大语言模型上,也会随模型升级而受益。两组评测各回答一个问题:受控评测用组内排序与 TrueSkill 证明三个模块每一个都对可信度有独立贡献,完整架构与既有最先进水平之间是 d = 8.16 的量级差;端到端评测证明这套架构在 25 个智能体、两个游戏日的尺度上撑得住信息扩散、关系形成与协调三类涌现行为,把幻觉率压在 1.3% 这样的可测量水平,并诚实列出地点漂移、物理规范缺失、指令微调导致的过度礼貌与过度合作三类失效。
作者给出的应用方向包括:给社交原型工具(social simulacra)填入有状态的居民、与多模态模型配合后填充虚拟世界或实体社交机器人、以及作为以人为中心设计流程里的用户代理——像 Weiser 笔下那个 Sal 一样,学会她几点起床、什么时候需要第一杯咖啡、典型的一天是什么样,从而自动煮咖啡、帮孩子准备上学、按她下班后的情绪调整灯光与音乐;作者把它类比成 GOMS 与 KLM 这类认知模型的新一代形态。对做具身智能的人来说,可直接复用的是「感知—检索—规划—反应」的循环结构与自然语言接地:论文的环境树、递归选址与物体状态更新,本质上是一个用语言写的场景图加 affordance 查询接口。剩下的问题也很明确——成本、并行化、鲁棒性,三者都写在作者的未来工作里。
金句:为当下的可信度做优化,牺牲的是长时间尺度上的可信度(Optimizing for believability in the moment sacrifices believability over time)。这句话解释了为什么单点提示做得再漂亮,也仍然需要记忆、反思与规划这三层结构。