PAPER DEEP DIVE
FreeOcc:免训练的具身开放词汇占据预测
现有占据预测依赖大规模体素标注且跨环境泛化极差,换到未见场景时逐类分数直接归零。FreeOcc 是第一个免训练的开放词汇占据预测框架:SLAM 骨干给位姿与稀疏几何,几何锚定高斯更新构造稠密 3DGS 地图(光线对齐各向异性初始化 s∥=γ·s⊥,高斯中心固定为 SLAM 点),视觉语言模型把开放词汇语义挂到高斯原语上,概率式高斯到占据投影产出可在线查询的体素占据场,全程没有任何可学习参数服务于占据任务。在 EmbodiedOcc-ScanNet 上单目 31.29/13.86、RGB-D 34.40/15.84 IoU/mIoU,超过自监督方法两倍以上;几何 IoU 对次优 DROID-Splat 提升 76.1%;论文同时提出 ReplicaOcc 基准,学习型基线在此集体塌到 0.00-0.01,FreeOcc 零样本迁移到 55.65/20.90,并以 25 FPS 在 RealSense D435i 真机流上在线运行。
论文元信息
标题:FreeOcc: Training-Free Embodied Open-Vocabulary Occupancy Prediction(FreeOcc:免训练的具身开放词汇占据预测)
作者:Zeyu Jiang、Changqing Zhou(共同一作)、Xingxing Zuo(MBZUAI)、Changhao Chen(香港科技大学广州分校,通讯作者)
链接:arXiv:2604.28115(https://arxiv.org/abs/2604.28115 ,RSS 2026);项目主页 https://the-masses.github.io/freeocc-web/
代码与数据状态:已开源。仓库 https://github.com/the-masses/FreeOcc 提供完整管线:src/gaussian_mapping.py 第 869-932 行实现光线对齐各向异性初始化(配置项 frame_gaussians_ray_aspect 即 elongation ratio $\gamma$,quat_from_z_to_dir_cam 把高斯局部 +Z 轴旋到视线方向),第 152 行 gaussians_to_occ() 与 src/gs2occ/localagg_prob/ 下的 CUDA 核实现概率式高斯到占据投影,第 1134 行 _init_ov_model() 加载默认开放词汇分割模型 Trident(SAM ViT-B 精修 + CLIP ViT-B/16 文本对齐 + DINO 视觉基础模型)。
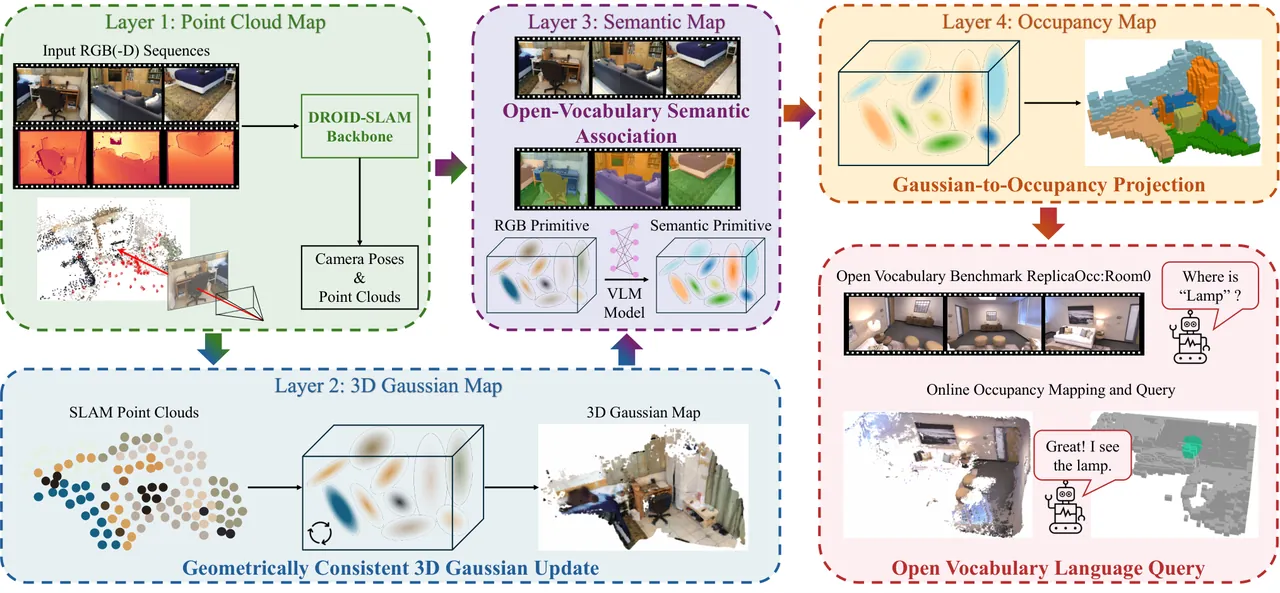
图1:FreeOcc 框架总览(论文 Figure 1)。第一层 SLAM 骨干估计位姿与稀疏几何;第二层几何一致高斯更新构造稠密 3DGS 地图;第三层把开放词汇语义关联到高斯原语;第四层概率式高斯到占据投影产出可在线查询的体素占据图。右侧示例中「window」与「chair」被正确定位,而真值标签(红框)把它们粗分为「wall」与「floor」。
一句话总结
FreeOcc 是第一个免训练的开放词汇占据预测框架:SLAM 位姿、几何锚定的 3D 高斯更新、视觉语言模型语义关联与概率式高斯到占据投影四层串联,不需要任何体素标注、位姿真值或学习阶段,在 EmbodiedOcc-ScanNet 上以单目 31.29/13.86、RGB-D 34.40/15.84 的 IoU/mIoU 超过自监督方法两倍以上,并在新基准 ReplicaOcc 上零样本碾压监督与自监督基线。
研究背景与动机
具身智能体要从自我中心观测构建环境理解,占据图是绕不开的表示:它把空间离散为空闲、占据与未知三类,给出显式几何边界,直接服务碰撞检查与运动规划,且天然支持增量更新。问题在于监督成本——全监督方法需要大规模三维重建后再做人工或半自动体素标注,而学到的模型往往只在训练分布内表现良好。
自监督路线减轻了标注负担,但仍假设训练与推理时相机位姿已知,且作为学习型方法同样会过拟合特定场景、视角与传感器配置。论文的实测把这一弱点量化得很残酷:把 GaussianOcc 与 GaussTR 换到未见过的 ReplicaOcc 上,逐类 mIoU 全部塌到 0.00-0.01,等于完全失效。
第二个动机来自 3DGS-SLAM 的几何歧义。Photo-SLAM、DROID-Splat 这类点基 SLAM 加高斯渲染的系统里,高斯表示与 SLAM 地图是解耦优化的:高斯参数主要为渲染一致性服务,SLAM 后端负责几何一致性。论文用一阶矩论证说明这种解耦的代价——体渲染沿每条像素射线只约束颜色与深度的一阶矩,多个不同的深度-权重配置可以产生完全相同的观测,因此渲染损失的最小值不是孤立点而是参数空间中的近流形,无约束的高斯更新会逐步侵蚀 SLAM 提供的几何一致性。
FreeOcc 的回答是彻底放弃学习阶段:用四层增量管线把 SLAM 几何、连续高斯表示与视觉语言语义串联起来,让占据预测变成纯推理过程。这一选择同时解决了监督成本与跨域泛化两个问题,代价是把性能上限绑定到 SLAM 与 VLM 组件的质量上——论文对此有清醒认识,并在消融中逐一定价。
预备知识
任务定义为具身语义占据预测:给定 RGB 观测流 $\mathcal{I}_{1:T}$,在线估计全局三维语义占据场 $\mathcal{O}_{T}\in\mathbb{R}^{X\times Y\times Z\times C}$,其中 $(X,Y,Z)$ 为场景体积分辨率、$C$ 为语义类别数,每个体素同时编码几何占据与语义证据。与从单帧 RGB 推断占据的场景补全方法不同,具身设定要求智能体在主动探索中增量构建全局一致的语义占据图。
场景表示为语言嵌入高斯原语集合 $G_{i}=(\bm{\mu}_{i},\mathbf{s}_{i},\mathbf{r}_{i},o_{i},\mathbf{c}_{i},\mathbf{f}_{i})$:三维均值、各向异性尺度、旋转、不透明度、颜色与语言对齐的开放词汇特征。给定内参 $K_{1:T}$ 与全局一致位姿 $\mathcal{T}_{1:T}$,可微渲染算子 $F$ 产出渲染图与深度图 $(\hat{I}_{t},\hat{D}_{t})=F(\mathcal{G},K_{t},\mathcal{T}_{t})$,典型 3DGS 建图求解
$$\min_{\theta}\;\sum_{t=1}^{T}\Big(\big\|\hat{I}_{t}-I_{t}\big\|_{2}^{2}+\beta\,\big\|\hat{D}_{t}-D_{t}\big\|_{2}^{2}\Big)$$歧义论证沿单条像素射线 $\mathbf{u}$ 展开:在体 alpha 合成下 $\hat{I}(\mathbf{u})=\sum_{k}w_{k}\mathbf{c}_{k}$、$\hat{D}(\mathbf{u})=\sum_{k}w_{k}z_{k}$,合成权重 $w_{k}\geq 0$ 依赖射线与参数,而该式只约束一阶矩——多组不同的 $(w_{k},z_{k})$ 配置给出相同的 $(\hat{I},\hat{D})$。线性化后存在非零扰动 $\delta\theta$ 使 $J\,\delta\theta=0$,故解集是近流形而非孤立点。这是全文方法设计的出发点:必须用几何先验把解从流形上拉回来。
评测协议上,EmbodiedOcc-ScanNet 沿用 EmbodiedOcc 的全局场景 IoU 与逐类 mIoU;由于 Occ-ScanNet 每场景只截 100 帧、不满足 SLAM 的序列要求,对应场景改用原始 ScanNet 的单目或 RGB-D 序列作为 SLAM 输入。SLAM 重建与真值坐标系之间用 Sim(3) 或 SE(3) 变换对齐:以相机中心为对应点,Umeyama 闭式解求 $\min_{s,\mathbf{R},\mathbf{t}}\sum_{i}\lVert\mathbf{c}_{i}^{\mathrm{gt}}-(s\mathbf{R}\mathbf{c}_{i}^{\mathrm{slam}}+\mathbf{t})\rVert_{2}^{2}$,再一致地作用于高斯均值 $\mathbf{x}^{\prime}=s\mathbf{R}\mathbf{x}+\mathbf{t}$、尺度 $\bm{\sigma}^{\prime}=s\bm{\sigma}$ 与朝向 $\mathbf{R}_{g}^{\prime}=\mathbf{R}\mathbf{R}_{g}$。这一步只消除全局规范自由度,不影响重建本身的质量。
方法详解
4.1 第一层:SLAM 骨干与全局一致几何
FreeOcc 对 SLAM 系统保持接口开放,论文选用 DROID-SLAM:它在长时窗上联合优化,产出全局一致的相机位姿 $\mathcal{T}_{1:T}$ 与累积三维点集 $\mathcal{P}_{1:T}=\{\mathbf{p}_{i}\in\mathbb{R}^{3}\}_{i=1}^{N_{T}}$,且其光流网络训练不依赖 SfM 管线的显式三维监督。与 MASt3R-SLAM、VGGT-SLAM 等前馈式模型基 SLAM 相比,DROID-SLAM 的全局一致性对长时程建图的漂移抑制更关键——后续所有模块都在这一统一坐标系中工作。
4.2 第二层:几何锚定高斯更新与光线对齐初始化
针对解耦优化的歧义,论文提出几何一致高斯更新策略,包含两个组件。其一是光线对齐各向异性初始化:对帧 $t$ 的像素 $\mathbf{u}$,由内参 $K_{t}$ 算归一化视线方向 $\mathbf{d}_{t,\mathbf{u}}$,定义局部旋转 $R_{t,\mathbf{u}}$ 使其 +Z 轴对齐视线,初始化尺度为
$$\mathbf{s}_{t,\mathbf{u}}=(s_{\perp},\,s_{\perp},\,s_{\parallel}),\qquad s_{\parallel}=\gamma\,s_{\perp}$$即每个高斯被建模为沿传感器射线拉长的薄椭球,$\gamma$ 为用户控制的拉长比(仓库配置 frame_gaussians_ray_aspect,建议 3-10)。这一先验直接压缩了沿射线方向的歧义自由度。其二是几何锚定更新:高斯中心固定为 SLAM 点 $\mathcal{P}_{t}$,优化问题变为带约束形式
中心不再参与优化,渲染损失只能调整尺度、旋转、不透明度与颜色,几何一致性由 SLAM 后端独家负责。两个组件合称 GAGU(几何锚定高斯更新)与 G-ini(几何感知初始化),消融显示它们是全文最大的单项增益来源。
4.3 第三层:开放词汇语义关联
语义侧不承诺固定标签空间:用预训练开放词汇分割模型对每帧提取逐像素语言对齐嵌入 $\mathbf{z}_{t}(\mathbf{u})\in\mathbb{R}^{D}$,默认实现为 Trident(SAM ViT-B 做掩码精修、CLIP ViT-B/16 提供文本对齐、DINO 作为视觉基础模型)。逐像素嵌入经 SLAM 深度提升到三维,每个提升点找到当前高斯地图中几何锚定的对应高斯并把语言特征挂载上去,形成语言嵌入高斯(LE-Gaussian)。查询时任意文本提示经 CLIP 文本编码器得到嵌入,与高斯特征做相似度即可定位,无需体素级监督。
4.4 第四层:概率式高斯到占据投影
投影范式沿用 GaussianFormer-2,但语义聚合从闭集类别概率改为语言嵌入特征。对查询位置 $\mathbf{x}$,检索邻近 LE-高斯 $\mathcal{H}(\mathbf{x})=\{G_{k}\}_{k=1}^{P(\mathbf{x})}$,由 $\bm{\Sigma}_{k}=R(\mathbf{r}_{k})\,\mathrm{diag}(\mathbf{s}_{k}^{2})\,R(\mathbf{r}_{k})^{\top}$ 诱导协方差,每个邻居贡献空间支持
$$\alpha_{k}(\mathbf{x})=\exp\!\left(-\frac{1}{2}(\mathbf{x}-\bm{\mu}_{k})^{\top}\bm{\Sigma}_{k}^{-1}(\mathbf{x}-\bm{\mu}_{k})\right)$$并以概率排除律合成占据概率,避免邻居高斯的支持被简单相加而过度膨胀:
$$\alpha(\mathbf{x})=1-\prod_{G_{k}\in\mathcal{H}(\mathbf{x})}\big(1-\alpha_{k}(\mathbf{x})\big)$$语义传播在局部高斯混合模型下做后验责任归因,混合权重取不透明度 $\pi_{k}=o_{k}$:
$$p(G_{k}\mid\mathbf{x})=\frac{p(\mathbf{x}\mid G_{k})\,\pi_{k}}{\sum_{G_{j}\in\mathcal{H}(\mathbf{x})}p(\mathbf{x}\mid G_{j})\,\pi_{j}},\quad p(\mathbf{x}\mid G_{k})=\mathcal{N}(\mathbf{x};\bm{\mu}_{k},\bm{\Sigma}_{k})$$再以期望传播语言特征并归一化:$\mathbf{f}(\mathbf{x})=\sum_{k}p(G_{k}\mid\mathbf{x})\mathbf{f}_{k}$,$\hat{\mathbf{f}}(\mathbf{x})=\mathbf{f}(\mathbf{x})/\|\mathbf{f}(\mathbf{x})\|_{2}$。给定查询类别集 $\mathcal{C}$,文本嵌入归一化后 $\hat{\mathbf{t}}_{c}=\mathbf{t}_{c}/\|\mathbf{t}_{c}\|_{2}$,体素-文本相似度 $s(\mathbf{x},c)=\hat{\mathbf{f}}(\mathbf{x})^{\top}\hat{\mathbf{t}}_{c}$ 即开放词汇语义得分;输出为占据概率 $\alpha(\mathbf{x})$ 与 $s(\mathbf{x},c)$,语义只对占据体素报告。仓库中这一步由 gaussians_to_occ() 与 localagg_prob CUDA 核实现,保证 25 FPS 量级的在线速率。
flowchart TB
  subgraph L1["第一层 SLAM 骨干"]
    A[单目或 RGB-D 图像流] --> B[DROID-SLAM
全局一致位姿 + 稀疏点云]
  end
  subgraph L2["第二层 几何一致 3DGS"]
    B --> C[光线对齐各向异性初始化
s 平行 = gamma 乘 s 垂直]
    C --> D[几何锚定更新
高斯中心固定为 SLAM 点]
  end
  subgraph L3["第三层 开放词汇语义"]
    E[Trident 逐像素语言嵌入
SAM + CLIP + DINO] --> F[深度提升到三维
挂载到锚定高斯 = LE-Gaussian]
    D --> F
  end
  subgraph L4["第四层 概率式投影"]
    F --> G[邻域高斯空间支持 alpha_k
概率排除律合成占据]
    G --> H[后验责任 pi_k = 不透明度
期望传播语言特征]
    H --> I[CLIP 文本相似度
在线开放词汇查询]
  end
流程图:依据第四、五节重建的四层增量管线。层间只传递位姿、点、高斯与特征四类对象,全部流式更新,无离线优化。
实验结果
主结果在 EmbodiedOcc-ScanNet 上(表1)。自监督基线 GaussianOcc 与 GaussTR 即便拿到真值位姿也只有 10.17/4.34 与 15.63/4.95;FreeOcc 单目 31.29/13.86、RGB-D 34.40/15.84,全部指标超过两倍以上,且没有任何任务特定训练。全监督方法(RoboOcc 53.3/44.05)仍领先,但论文指出两点评价口径问题:EmbodiedOcc-ScanNet 把大量物体类别合并为「objects」「furniture」等粗标签,对未在该分类法上训练过的开放词汇模型天然不利;真值标签本身也可能偏离视觉证据——图1 右侧的窗户被标成墙、椅子被标成地板,预测更符合真实观察反而扣分。
| 方法 | 监督 | IoU | floor | wall | chair | sofa | mIoU |
|---|---|---|---|---|---|---|---|
| EmbodiedOcc++ | 体素标注 | 52.2 | 27.9 | 43.9 | 49.0 | 59.2 | 43.60 |
| RoboOcc | 体素标注 | 53.3 | 21.94 | 44.57 | 51.28 | 63.09 | 44.05 |
| GaussianOcc | 位姿 | 10.17 | 3.81 | 2.53 | 3.84 | 9.90 | 4.34 |
| GaussTR | 位姿 | 15.63 | 1.20 | 4.29 | 4.52 | 10.95 | 4.95 |
| FreeOcc(单目) | 无 | 31.29 | 3.16 | 16.14 | 19.66 | 23.43 | 13.86 |
| FreeOcc(RGB-D) | 无 | 34.40 | 6.56 | 21.69 | 21.02 | 23.61 | 15.84 |
表1:EmbodiedOcc-ScanNet 主结果节选(论文 Table II),IoU 与逐类 mIoU 均为百分比。FreeOcc 两档输入均不需要任何标注或位姿真值。
零样本泛化在新基准 ReplicaOcc 上检验(表2)。ReplicaOcc 取自 NICE-SLAM 发布的 Replica 序列,0.08 米体素、每场景 44 个语义类别、8 个场景、纯测试集;mIoU 按与 EmbodiedOcc-ScanNet 共享的 8 类报告。学习型方法在此全面崩溃:EmbodiedOcc 逐类全部 0.00-0.01,GaussianOcc 全零,GaussTR 仅 wall 类 0.10;FreeOcc 单目 46.81/16.93、RGB-D 55.65/20.90。论文把崩溃归因于两类域差:Replica 与 ScanNet 的外观与几何差异,以及学习型模型对训练集相机内参与度量尺度的过拟合。
| 方法 | 监督 | IoU | ceiling | wall | chair | sofa | table | mIoU |
|---|---|---|---|---|---|---|---|---|
| EmbodiedOcc | 体素标注 | 22.91 | 0.00 | 0.00 | 0.00 | 0.01 | 0.01 | 0.00 |
| GaussianOcc | 位姿 | 8.71 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| GaussTR | 位姿 | 15.01 | 0.00 | 0.10 | 0.00 | 0.00 | 0.00 | 0.01 |
| FreeOcc(单目) | 无 | 46.81 | 19.38 | 38.23 | 15.11 | 25.07 | 16.46 | 16.93 |
| FreeOcc(RGB-D) | 无 | 55.65 | 17.80 | 44.33 | 20.76 | 34.90 | 24.48 | 20.90 |
表2:ReplicaOcc 零样本泛化(论文 Table III)。学习型基线逐类分数塌缩到近零,FreeOcc 无需任何适配直接迁移。
几何一致性对照(表3)把 FreeOcc 的高斯更新策略与六个 3DGS-SLAM 系统放在同一把尺子下:所有方法的高斯地图经相同对齐流程与相同占据转换后比较几何 IoU。单目档 FreeOcc 平均 39.34,对次优 DROID-Splat 22.34 提升 76.1%;RGB-D 档 45.24 对 29.37 提升 54.0%。组件消融(表4)进一步拆分:去掉 GAGU 与 G-ini 后单目仅 19.88/10.53 且帧率跌到 10.7;只加 GAGU 升到 31.20/12.06、帧率回升 2.5 倍;再补 G-ini 到 39.05/15.40 而帧率几乎不降。锚定更新同时改善精度与效率,因为它把中心变量移出优化、减少了迭代自由度。
| 消融设置 | 单目 IoU/mIoU/FPS | RGB-D IoU/mIoU/FPS |
|---|---|---|
| 无 GAGU、无 G-ini | 19.88 / 10.53 / 10.7 | 27.98 / 11.20 / 8.8 |
| 仅 GAGU | 31.20 / 12.06 / 26.8 | 40.18 / 16.03 / 25.0 |
| GAGU + G-ini(完整) | 39.05 / 15.40 / 25.3 | 45.03 / 18.37 / 24.6 |
表3:组件消融(论文 Table V),ReplicaOcc 与 EmbodiedOcc-ScanNet 平均。GAGU 为几何锚定高斯更新,G-ini 为几何感知初始化。
差距分析(论文 Table VII)诚实地标出剩余空间:RGB-D 档把估计位姿换成真值位姿,IoU 从 34.40 升到 45.06、mIoU 从 15.84 升到 21.34;把开放词汇语义换成闭集分割(DVEFormer 40 类手工映射到 11 类)则 mIoU 升到 20.42 而 IoU 不变;两者叠加到 45.03/27.39。结论是性能差距主要来自位姿对齐与语义类别指派,而非占据几何本身。SLAM 骨干可替换性(论文 Table VI)同样清楚:MASt3R-SLAM 33.80/15.66、VGGT-SLAM 33.09/15.90 且后者 45.2 FPS,均优于默认 DROID-SLAM 的 31.29/13.86/25.3;而把语义模块换成 SEEM 或 DINOv2 时 IoU 基本不变、mIoU 跌到 8.35/8.18,说明几何侧稳定、语义侧敏感。开放词汇验证(论文 Table VIII)按类别频率排序报告 top-K mIoU:top-10 为 31.06,扩到 top-20/30/40 依次 23.02/16.57/12.01,衰减符合低频类别对应小物体与部分观测的预期。
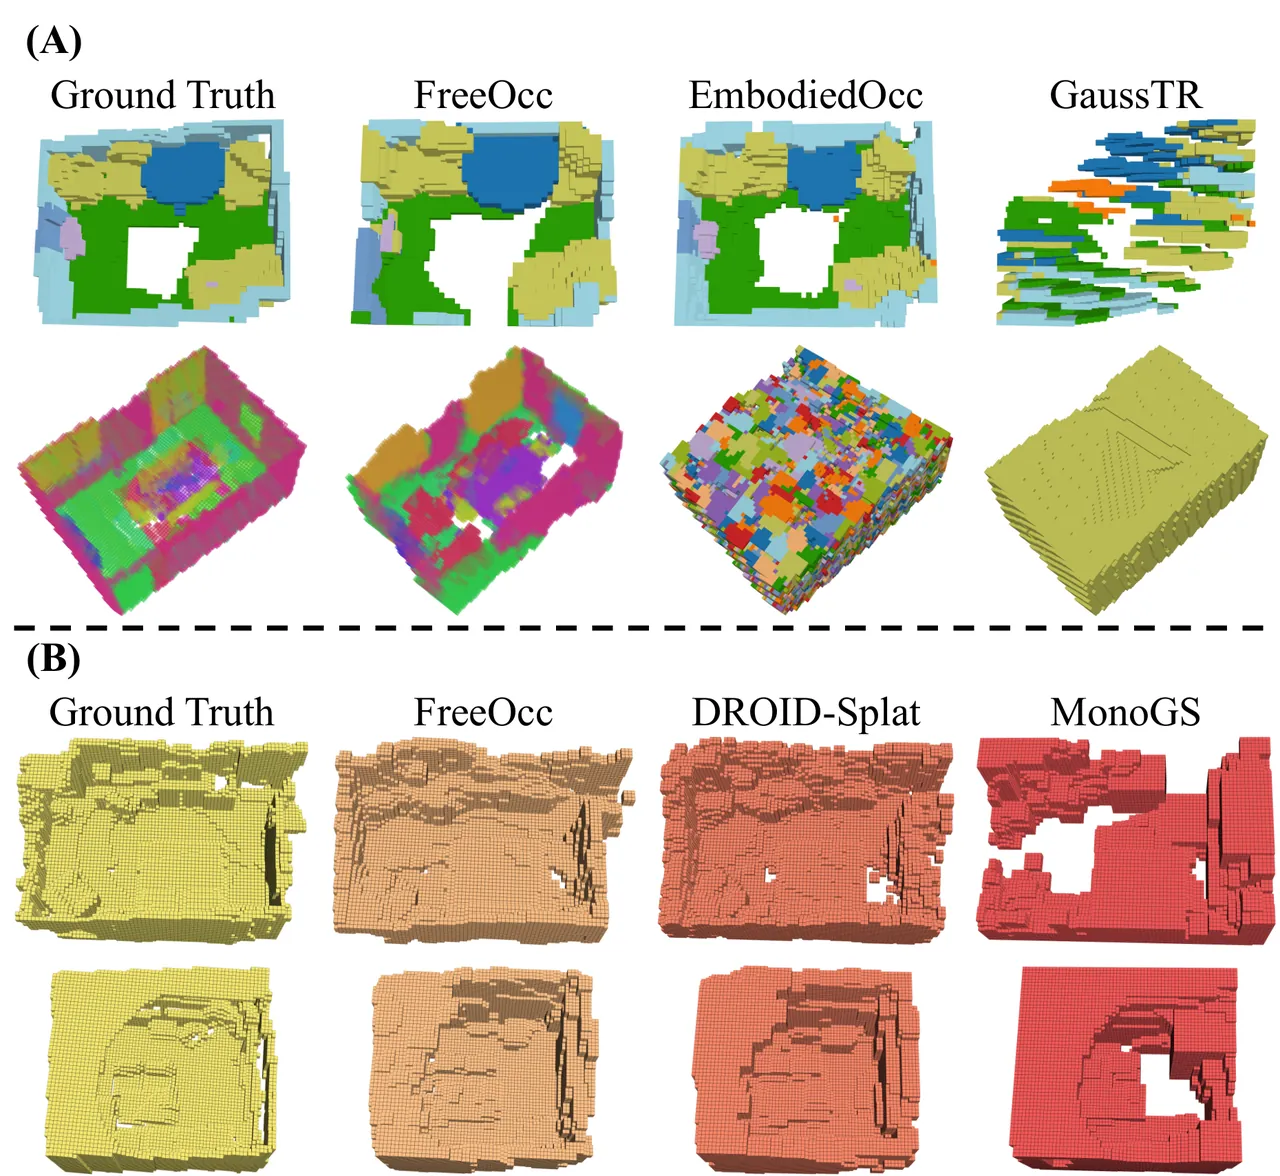
图2:定性占据预测对比(论文 Figure 2)。(A) 与学习型方法在 scene0470 与 room2 上的对比,基线在 ReplicaOcc 上产出残缺或近空地图;(B) 与几何精度最高的两个 3DGS-SLAM 方法在 scene0006 与 office0 上的对比,锚定更新在物体边界与细结构处更完整一致。
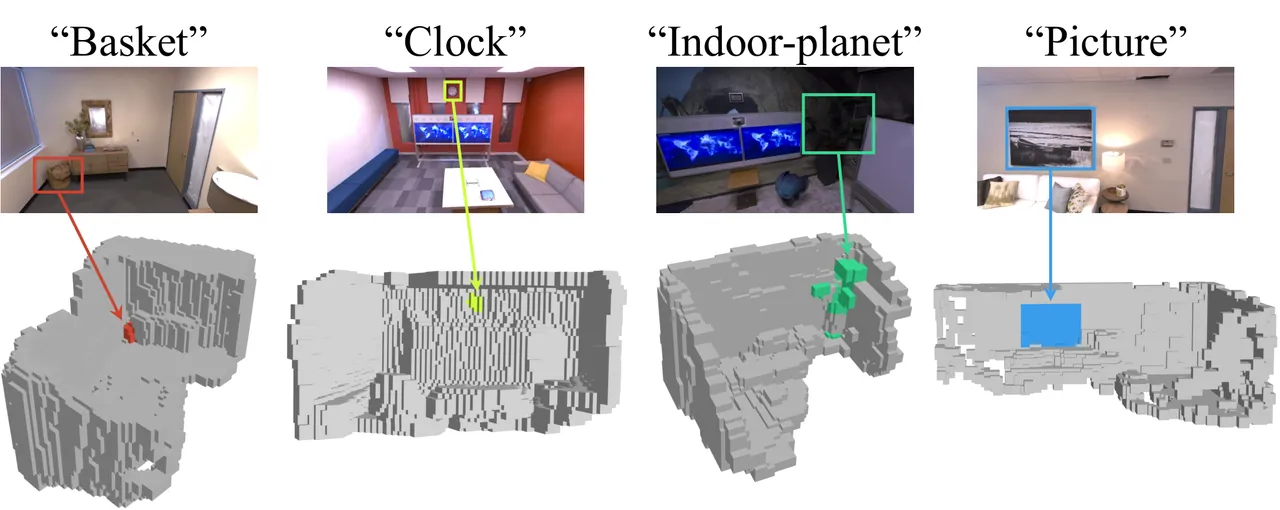
图3:ReplicaOcc 开放词汇查询(论文 Figure 3)。对「basket」「clock」等小物体、「indoor plant」等低光照类别与「picture」等语义模糊类别,FreeOcc 直接从占据地图中定位检索目标。
真机部署用 Intel RealSense D435i 以 1920×1080 同步采集 RGB 与深度(深度因子 $10^{-3}$),语义线索由 Qwen3-VL 对每帧生成可见物体类别并跨帧聚合为场景级词汇空间,全流程跑在 i9-14900KF 加单张 RTX 5090 上,采集开头做短预热等待自动曝光收敛。红黄双杯实验(图4)展示细粒度能力:两个视觉相似物体按开放词汇文本查询被正确区分定位;论文同时坦承 0.08 米标准体素对桌面小物体过粗,杯子实验要把体素边长降到 0.005 米才得到好结果,自适应动态分辨率被点名为有前途的方向。
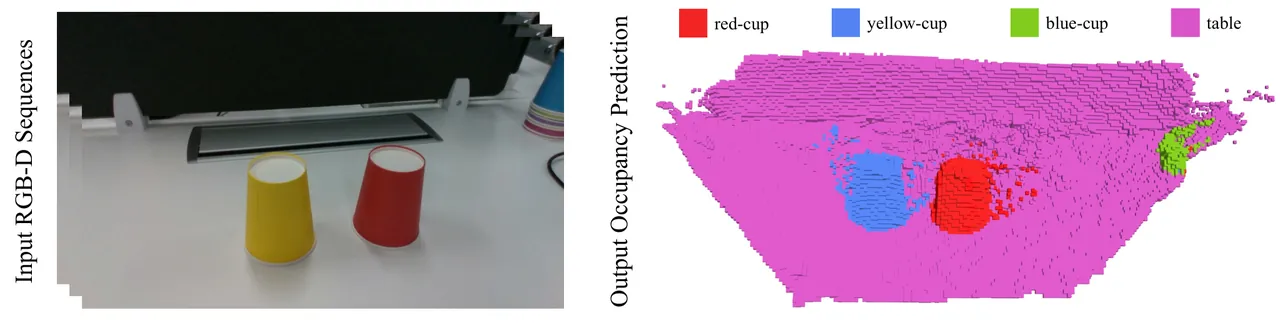
图4:真机红黄双杯实验(论文 Figure 4)。FreeOcc 按文本查询正确定位并区分视觉相似物体;该实验也暴露 0.08 米体素对小物体的分辨率不足。
局限性
作者自述两条。其一,占据地图质量本质上绑定 SLAM 骨干的鲁棒性:累积漂移或不完美的数据关联会侵蚀长期几何与语义一致性;把占据表示导出的几何与语义线索直接作为优化目标加入 SLAM 因子图是作者指明的改进方向。其二,当前 VLM 的语义预测存在时间不一致,尤其在高共视的连续帧之间,这种不一致会作为噪声进入高斯原语的语义关联;置信度感知特征过滤或时间一致性约束留作未来工作。
我们的独立判断补充三点。其一,ReplicaOcc 只有 8 个场景且来自合成感较强的 Replica 渲染序列,作为「跨域泛化」证据的多样性有限;学习型基线在该基准上全零的表现虽然震撼,但部分源于内参与尺度偏移这一可工程修复的因素,论文未尝试对基线做尺度重标定后再比较,因此「学习型方法无法泛化」的结论强度略高于实验设计所能支撑的。其二,mIoU 的绝对值仍远低于全监督方法(15.84 对 44.05),且差距分析显示闭集语义单独一项就能把 mIoU 抬到 20.42——开放词汇的代价被量化得很清楚,但论文标题级的「开放词汇」能力在固定分类法基准上必然吃亏,两种口径的结论不应混读。其三,25 FPS 的在线速率建立在单张 RTX 5090 与 Trident 逐帧推理之上,语义模块是主要瓶颈(VGGT-SLAM 变体几何侧能到 45.2 FPS);在算力受限的移动平台上,四层管线的实时性尚未验证。
总结与展望
FreeOcc 的价值在于把占据预测从「监督换精度」的轨道上摘下来:四层管线里没有任何可学习参数服务于占据任务本身,SLAM 给位姿、锚定更新给几何、VLM 给语义、概率投影给体素,每一层都可以独立替换且替换收益被消融逐一定价。它在 EmbodiedOcc-ScanNet 上两倍于自监督方法、在 ReplicaOcc 上让学习型基线集体归零,证明「免训练」不是性能妥协而是泛化红利。
开放问题集中在三处:SLAM 漂移与占据反馈的闭环(作者已给出因子图方向)、VLM 时间一致性的语义滤波、以及 0.08 米体素对小物体的分辨率墙(自适应动态分辨率)。若这三点被解决,免训练占据预测有望成为具身智能体的默认感知底座——不需要为每个新环境重训模型,插上相机就能开始理解空间。
金句
当占据预测不再需要任何一个标注体素,泛化就不再是需要学习的能力,而是管线本身自带的属性。