PAPER DEEP DIVE
SERF:面向长时程移动操作的时空环境与机器人特征图
SERF 把环境物体和机器人表面统一表示为共享隐空间中的神经点,并在线更新其空间位置。环境点通过实例级刚体配准跟随桌子、椅子等物体移动,机器人点通过正运动学跟随基座、机械臂和末端执行器变化;共享解码器把局部神经点特征还原为 DINOv3 视觉特征。策略再通过三个基座半径、左右末端执行器、机器人本体、环境本体和全局八个分支提取地图 token,与图像、本体状态和语言任务共同条件化 VLA。论文在 BEHAVIOR-1K 三个长时程移动操作任务上把平均进度从 PI0.5 微调的 44.0% 提升到 58.7%,并在机载标签与位姿估计、物体掉落恢复和未访问区域实验中报告增益。
一句话总结
SERF 把环境物体与机器人表面的神经点放进共享隐空间,持续用视觉观测、物体刚体配准和正运动学更新,再把八个局部或全局地图 token 送进视觉语言动作模型,使移动操作策略在长时程任务中少走回程路、更能承受场景变化,并在物体掉落后恢复任务。
1. 研究动机:图像历史看见了变化,却没有直接给出空间状态
长时程移动操作不是把一段短抓取动作重复很多次。机器人必须先走到柜子边、打开柜门、找到目标、把物体搬过房间,再处理任务过程中被自己移动过的椅子和容器。几十秒前的同一张桌子,现在可能已经被推开;刚刚放下的物体,也可能从视野里消失。此时策略真正需要的不是更多像素,而是一个能回答“物体现在在哪、机器人身体占用了哪块空间、我已经完成到哪一步”的状态。
仅使用当前图像或图像历史有明显缺口。单帧图像缺少被遮挡物体和已离开视野的区域;多帧图像虽然提供了时间线索,却仍要求策略从二维投影中自行恢复三维位置、尺度与遮挡关系。历史图像还会把无关的背景外观带入上下文,增加视觉主干的计算量,却不能保证物体在机器人坐标系中的位置被一致地保存下来。
传统地图也不是直接答案。占据栅格适合导航,却主要记录哪里可通行;点云能保留几何,却通常不包含任务所需的语义特征,也难以让视觉语言模型直接理解。语义地图可以给物体贴标签,但标签是离散的,难以表达“这个桌面属于哪个实例”“机器人左臂当前离什么物体最近”“全局布局与局部交互区域如何同时进入策略”这类连续关系。
SERF 的出发点是改变地图的接口。地图不再只是给规划器查询的几何结构,而是策略模型读取的状态表示。环境点和机器人点处在同一个特征空间,使用同一个解码器;查询任意三维位置时,地图返回一个与视觉基础模型对齐的稠密特征。这样,机器人本体不再是外部状态向量,环境也不再是背景点云,两者成为同一种可查询、可组合的时空状态。
2. 问题设定与核心表示
论文把任务写成移动操作策略的条件生成问题。在第 $\tau$ 个时刻,策略接收地图 $m_\tau$、当前观测 $o_\tau$、机器人本体状态 $s_\tau$ 以及语言任务特征 $e_\ell$,输出动作块 $a_\tau$。策略参数为 $\phi$,模仿学习目标是最大化演示动作在给定上述条件下的似然:
$$\mathcal{L}_{bc}(\phi)=-\mathbb{E}_{\mathcal{T}}[\log\pi_{\phi}(a_{\tau}\mid m_{\tau},o_{\tau},s_{\tau},e_{\ell})].$$这个式子看起来像普通的行为克隆,关键差别全在 $m_\tau$。它不是固定输入,而是随着机器人在线移动、环境物体被操纵、机械臂关节变化而更新。若地图只取第一帧,策略仍然只能做开环记忆;若地图只保留几何,视觉语言模型仍要自己补语义。SERF 要同时解决时间更新和表示对齐。
环境点集合记作 $\mathcal{P}^{e}_{\tau}$,机器人表面点集合记作 $\mathcal{P}^{r}_{\tau}$,两者合并成第 $\tau$ 时刻的神经点集合:
$$\mathcal{P}_{\tau}=\mathcal{P}^{e}_{\tau}\cup\mathcal{P}^{r}_{\tau}.$$每个神经点不仅保存三维坐标 $p_i$,还保存一个固定维度的隐特征 $f_i$。本文使用 64 维特征。执行过程中特征和实例标签保持不变,位置则根据环境运动和机器人构型变化。查询一个位置时,系统先在邻域中做距离加权插值,再通过共享解码器还原成 1280 维 DINOv3 图像块特征。
为什么要让机器人表面点也进入地图?移动操作里,机器人自己的身体会占用空间、遮挡物体,并决定机械臂与环境的相对位置。只把关节角当作一个独立向量输入,策略必须自己学习“当前姿态对应哪些笛卡尔空间占用”;把机器人表面点放进地图后,局部查询可以直接包含机器人本体与环境物体之间的空间关系。
3. 地图如何形成:视觉反投影、实例跟踪与共享隐特征
环境地图的初始点来自 RGB-D 观测。论文使用 480×480 的 RGB 输入,DINOv3 产生 30×30 的图像块网格;深度反投影把这些图像块提升到三维空间,得到带视觉特征的场景点。实例标签则来自论文实验中的仿真真值或部署替换实验里的 SAM3。每个点同时携带世界坐标、64 维可学习隐特征和实例编号。
地图训练不是只做坐标重建,而是学习一个能对齐 DINOv3 特征的共享编码。给定第 $\tau$ 个时间窗口中的查询点 $x$ 与目标视觉特征 $y$,地图解码器参数 $\Theta$ 通过下面的损失学习:
$$\mathcal{L}_{map}(\Theta)=\mathbb{E}_{\tau,(x,y)\sim\mathcal{D}_{\tau}}[\mathcal{L}(m_{\tau}(x;\Theta),y)].$$其中 $m_{\tau}(x;\Theta)$ 是地图在查询点输出的特征。这个目标把地图从“几何容器”变成“可查询的视觉特征场”。训练完成后,环境点和机器人点共享同一个解码器,机器人表面点也能输出与视觉基础模型同一空间的描述。
为了让环境点和机器人点真正落在共同坐标系,SERF 在局部邻域上做核加权。对查询点 $x$,选择与它最近的 $K$ 个神经点 $\mathcal{N}(x,\mathcal{P}_{\tau})$,权重由距离经 softmax 归一化:
$$F(x;\mathcal{P}_{\tau})=\sum_{i\in\mathcal{N}(x,\mathcal{P}_{\tau})}w_i f_i,\qquad w_i=\mathrm{softmax}(-\|x-p_{i,\tau}\|/\sigma).$$这里的 $K$ 为 6,温度 $\sigma$ 为 0.05。距离越近的点特征权重越大;但 softmax 不是硬性最近邻,因此局部点云略有稀疏或噪声时,输出仍能平滑过渡。随后把插值特征送入共享残差多层感知机:
$$m_{\tau}(x;\Theta)=D_{\theta}(F(x;\mathcal{P}_{\tau})).$$这条路径有一个重要含义:策略不需要从零散点坐标里猜环境语义。查询点先聚合周围神经点的 64 维特征,再一次性还原为 1280 维视觉嵌入。环境与机器人使用相同的 $F$ 和 $D_\theta$,本体点才可能被策略当作与桌角、柜门同一尺度的空间实体。
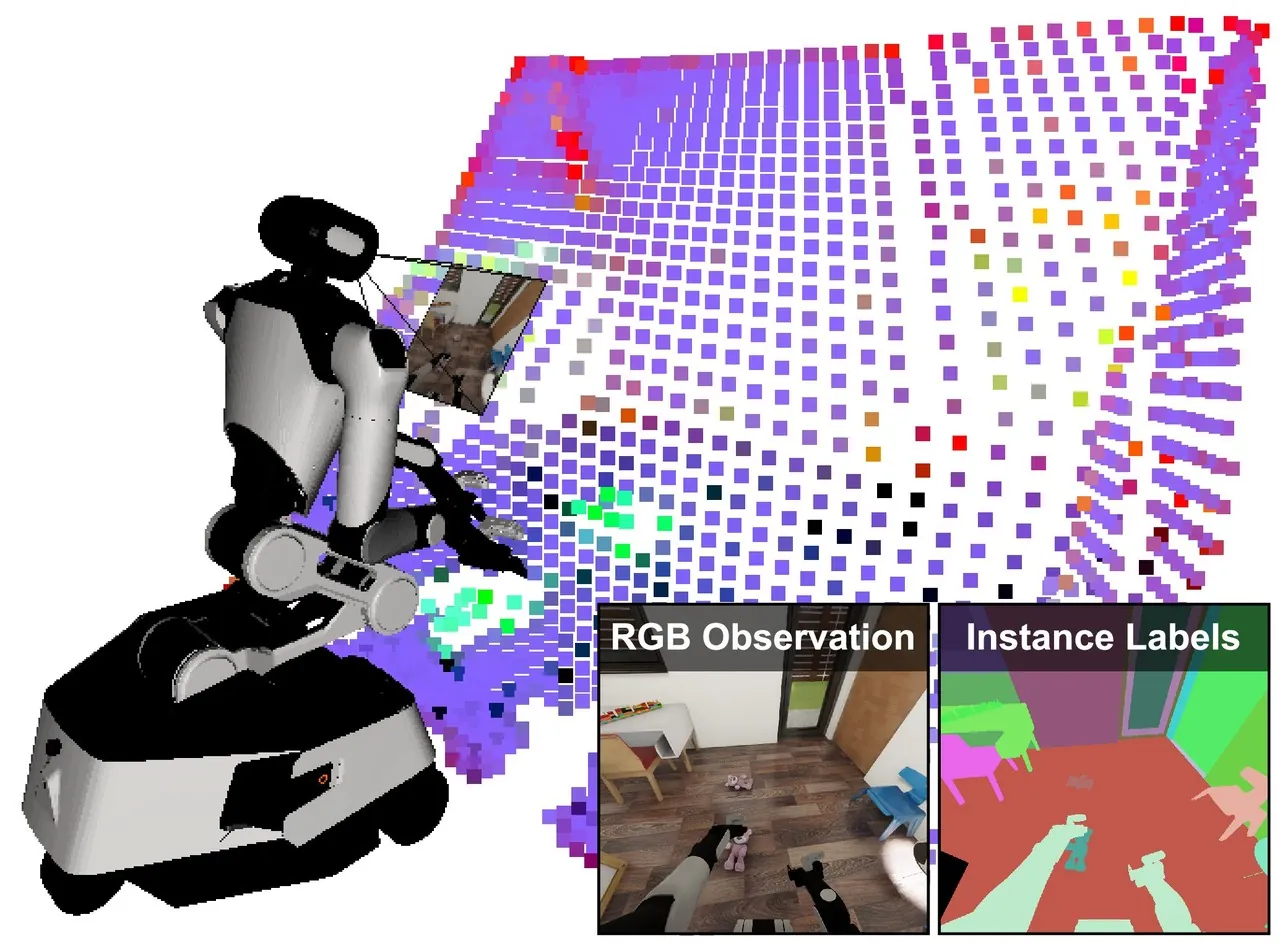
图 1:论文第二图。左侧 RGB 观测通过深度反投影进入地图,右侧显示实例分割标签与三维神经点。环境物体不是只保存颜色,而是保存可解码为视觉特征的空间点。
4. 环境点更新:先估计物体刚体变化,再原子提交
如果每一帧都重新建图,地图会被不断重复的点和不稳定的视觉特征污染,也难以保留物体身份。SERF 因此把环境更新建立在实例级刚体跟踪上。对实例 $k$ 在相邻时间的前后点对应,估计旋转 $\hat R$ 与平移 $\hat t$:
$$(\hat R,\hat t)=\arg\min_{R\in SO(3),t}\sum_k\left\|q^{\tau}_k-(Rq^{\tau-1}_k+t)\right\|^2.$$估计采用 FGR 做粗配准,再用稠密观测点云进行 ICP 精配准。得到变换后,属于该实例的环境神经点整体更新:
$$p^{e}_{i,\tau}=\hat R\,p^{e}_{i,\tau-1}+\hat t.$$这个操作只改变几何位置,不重新采样视觉特征,也不改变实例标签。于是“杯子还是同一个杯子”“椅子已经从餐桌左侧移到右侧”这些身份信息能跨时间保留。对长时程任务,这比每帧重新分割和重新赋特征更稳定,也更节省特征主干计算。
实现中,跟踪模块会用可见性与置信度过滤对应点;当平移量低于 0.015 米时判为静止,避免微小数值抖动触发地图重写;当配准失败或变换偏离过大时,重置阈值设为 0.20 米。成功更新时先删除旧体素哈希,再写入新坐标和中心点,最后同步实例质心。这个“先校验、后提交”的顺序避免了半更新状态。
# SERF-mapping/tracking/utils/tracking_ops.py:768-793
T_reg[:3, :3] = R
T_reg[:3, 3] = t_vec

center_tgt_pred = R @ center_src + t_vec
if np.linalg.norm(center_tgt_pred - center_src) < cfg.stationary_threshold:
    return "stationary"

new_pts = current_pts @ R_f.T + t_f
neural_points.remove_points_from_hash(Y_idx)
neural_points.map_points[Y_idx] = new_pts
new_grid_coords = torch.floor(new_pts / neural_points.voxel_size).to(torch.int64)
neural_points._hash_table_insert(new_grid_coords, Y_idx)
代码对应关系很直接:论文中的 $(\hat R,\hat t)$ 与 $p^e_{i,\tau}$ 更新都落在 register_instance_for_frame 的公共提交路径里。体素大小为 0.02 米,接受更新的质心误差阈值为 0.02 米。消融和失败分析说明,这套更新的假设边界也很清楚:它擅长桌椅、鞋、容器等刚体,不直接处理可变形物体或多关节物体。
5. 机器人点更新:正运动学让“身体”成为地图的一部分
机器人表面点采用与机器人拓扑绑定的固定点集,不通过场景配准移动。每个表面点 $u_j$ 属于某个连杆 $l_j$,其世界坐标由当前本体状态 $s_\tau$ 下的正运动学决定:
$$p^{r}_{j,\tau}=R_{l_j}(s_{\tau})u_j+t_{l_j}(s_{\tau}).$$相邻构型下,表面点集合的拓扑和特征索引保持不变,变化的是由连杆变换产生的坐标。这一点与动态环境点不同:桌子被推动后,点特征仍跟着原物体;机器人手臂转动时,每个表面点仍对应固定身体部位,因此查询“左夹爪附近的场景特征”时不会因为点索引重排而失去语义。
机器人基座在世界坐标系中的位姿由本体感知提供;机械臂与夹爪的位姿由正运动学计算。论文把机器人中心向上偏移 0.8 米作为三个局部球查询的中心,使查询覆盖基座与躯干附近的空间;左右末端执行器各自使用 0.5 米半径的球查询。这样的设计让 tokenizer 能区分“机器人周围”“左手附近”“右手附近”以及“纯环境区域”。
正运动学只解决位置,不解决视觉特征。机器人表面点的 64 维特征是学习的,并与环境点一起通过共享解码器。训练时,环境点、机器人点和解码器在同一个优化目标下更新;推理时,位置随本体状态变化,特征在当前 episode 内固定。这里体现的是时空分工:空间位置在线变化,语义特征无需每帧重算。
6. 共享解码器为什么能减少表示割裂
如果环境和机器人各用一套编码器,策略会看到两套不相干的特征分布。SERF 选择让二者共享邻域插值和残差解码器,视觉特征、机器人表面特征都输出到同一个 1280 维空间。对策略来说,靠近机器人夹爪的环境点与机器人表面点可以被直接比较,局部关系不需要额外做跨模态对齐。
代码中,环境点地图与机器人点地图由同一个训练入口构建,解码器输入维度为 64,输出维度与 DINOv3 特征一致,隐藏层使用残差块。实例类别和机器人身体部位的身份约束通过额外的对比损失加入,类别间权重为 0.02,实例内权重为 0.01,避免把所有点压成不可区分的平均特征。
这种共享不是把所有点完全混在一起。每个点仍有实例编号、环境或机器人来源,以及三维位置;共享的是查询附近的局部特征融合方式和输出解码器。这样既能保留“这是左臂还是杯子”的离散身份,又让策略在同一几何空间里读取连续特征。
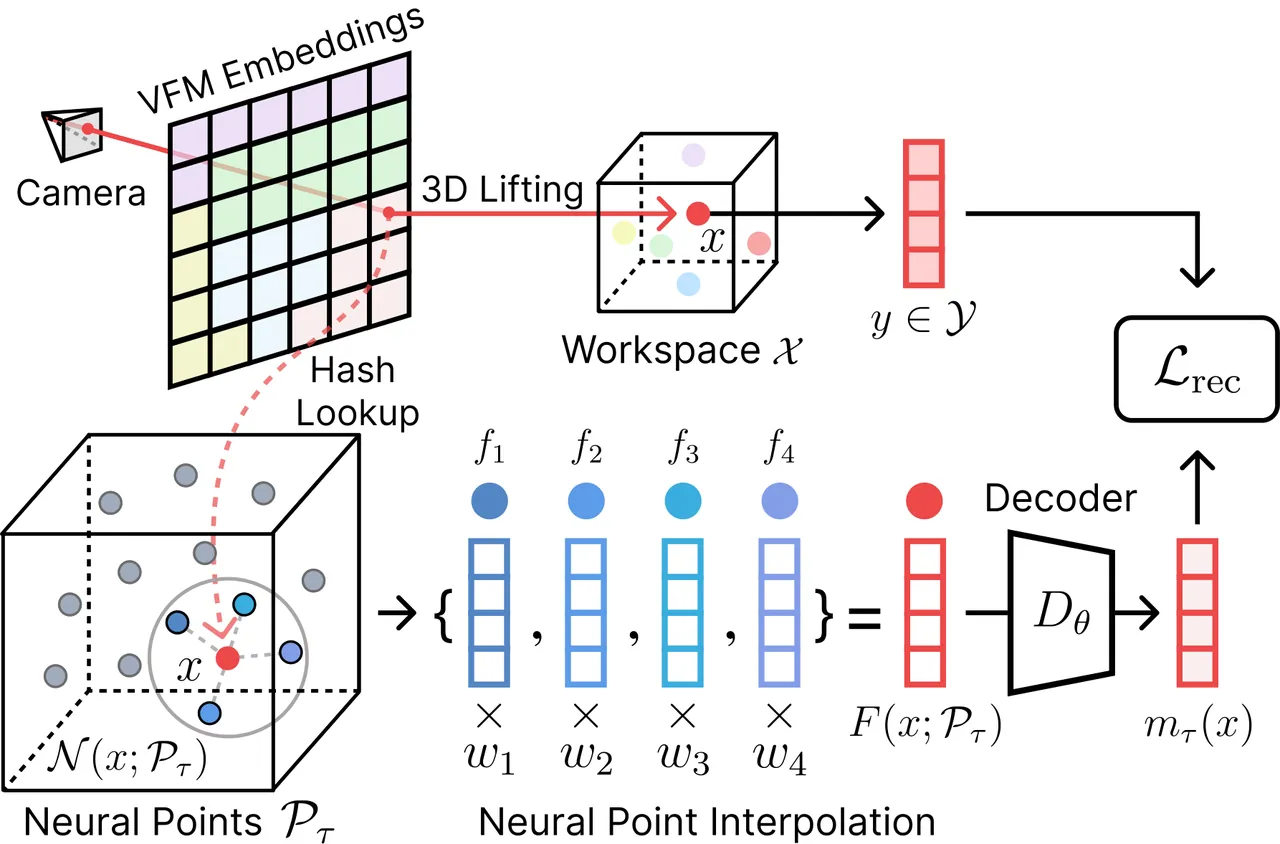
图 2:论文第三图。视觉嵌入经反投影形成神经点;查询 $x$ 对邻域特征做 softmax 加权,再由共享解码器得到 $m_\tau(x)$。该图是理解环境点与机器人点为何能进入同一策略状态的核心。
7. 地图 tokenizer:八个 token 分别回答不同空间问题
把整张地图直接送进视觉语言模型不可行。25,000 个点会产生极长序列,且大部分点与当前动作无关。SERF 先用一个共享的两级 Point Transformer 主干把点降到 256 维,再用八个并行分支做局部或全局查询。主干每级有两个 Transformer 块,下采样步长为 4,邻域数为 16;每个分支有 256 维宽度、步长 1,并通过注意力池化生成 2048 维 token。
八个分支不是随意切块,而是对应八种任务相关视角:以机器人中心为球心、半径分别为 1 米、2 米和 4 米的三个局部区域;左右末端执行器各自 0.5 米半径的两个区域;仅机器人点;仅环境点;以及覆盖全部点的全局分支。每个 token 的回答不同:近处关注抓取接触,2 米和 4 米关注移动与物体关系,末端执行器分支关注左右手操作,纯机器人分支关注自遮挡和身体占用,环境分支关注场景布局,全局分支保留长距离任务上下文。
# SERF-VLA/src/serf_b1k/models/point_transformer_local.py:467-491
for i, radius_world in enumerate(self.robot_center_radii):
    norm_radius = radius_world / pc_norm_scale
    mask = robot_sq_dist <= (norm_radius ** 2)
    tokens.append(self.robot_branches[i](stage2_xyz, stage2_feat, mask))

if self.use_robot_points:
    tokens.append(self.global_branch(stage2_xyz, stage2_feat))

for ee_pos, branch in [
    (left_ee_norm, self.left_ee_branch),
    (right_ee_norm, self.right_ee_branch),
]:
    sq_dist = jnp.sum((stage2_xyz - ee_pos[:, None, :]) ** 2, axis=-1)
    mask = sq_dist <= (self.ee_radius / pc_norm_scale) ** 2
    tokens.append(branch(stage2_xyz, stage2_feat, mask))
一个容易忽略的细节是:tokenizer 去掉绝对坐标,只保留相对位置编码。环境布局会随机器人和物体移动而变化,绝对世界坐标在不同地图归一化和不同场景配置下不稳定;相对邻域关系更接近视觉主干学到的局部模式。分支查询中心使用归一化空间中的机器人中心与末端位置,避免大型场景的绝对尺度主导注意力。
八个 token 最终被拼到视觉语言模型的前缀中作为非自回归状态 token。它们不是替代图像,而是补充图像无法直接表达的持久空间状态。图像提供当前视角和语义外观,地图 token 提供已经累积、并与机器人身体对齐的空间关系。二者共同条件化动作专家。
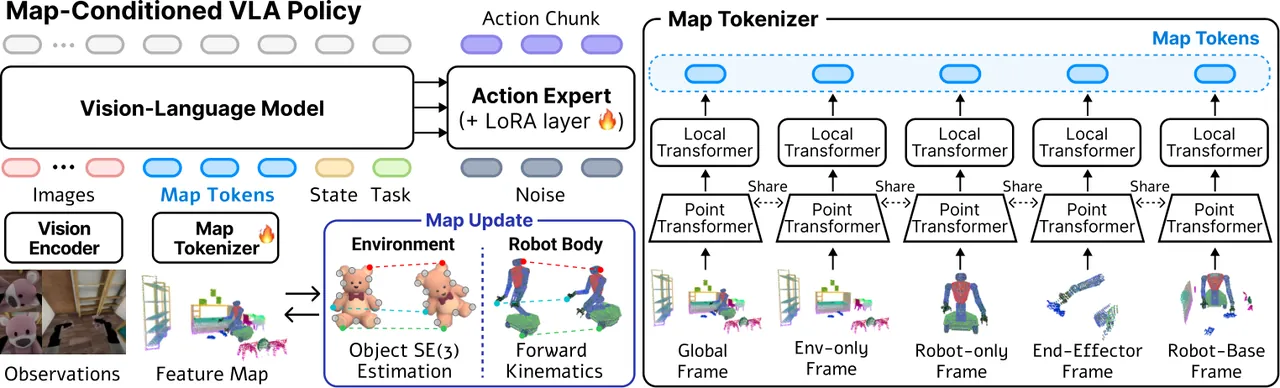
图 3:论文第四图。右侧是八个查询分支,左侧是地图条件 VLA 的输入与输出。图中可见地图 token、图像、任务、状态和噪声动作如何进入动作专家。
8. 进入 VLA:冻结视觉主干,训练 LoRA 动作专家
SERF 的策略建立在 PI0.5 与 BEHAVIOR-1K 的 OpenPI 实现上。视觉语言模型和视觉编码器保持冻结,动作专家使用 LoRA 适配。这样做的原因不是单纯节省参数,而是保留已有视觉语义和语言理解能力,把有限训练预算集中在“如何读取地图 token 并生成连续动作”上。
进入动作专家的条件可以概括为一个拼接表示:
$$h_{\tau}=\mathrm{Concat}(E(o_{\tau}),e_m,e_s,e_{\ell}),$$其中 $E(o_\tau)$ 是当前观测编码,$e_m$ 是地图 token,$e_s$ 是本体状态,$e_\ell$ 是任务语言嵌入。动作专家在训练时使用 flow matching。给定演示动作 $A_\tau$ 和噪声 $\epsilon$,构造插值动作及目标速度:
$$A_{\tau}^{\alpha}=\alpha A_{\tau}+(1-\alpha)\epsilon,\qquad u_{\tau}=A_{\tau}-\epsilon,$$ $$\mathcal{L}_{action}=\mathbb{E}\left\|v_{\psi}(A_{\tau}^{\alpha},h_{\tau},\alpha)-u_{\tau}\right\|_2^2.$$代码中每个动作块采样 15 个 flow 样本,时间 $\alpha$ 从 Beta(1.5, 1) 采样并截断到 (0.001, 0.999)。动作维度为 32,动作时域为 30;推理时做 20 次欧拉积分,执行前 26 个动作,再通过三次插值转成 20 个控制量。训练每个任务 20,000 步,批量大小为 16,峰值学习率为 $2.5\times10^{-6}$。
动作损失只回传到动作专家和地图接口路径,视觉语言模型的知识通过 stop-gradient 隔离。这个设计让地图 token 可以适配动作生成,却不会反向破坏冻结的视觉语义表示。对于没有大规模机器人数据的团队,这种“冻结主干加轻量动作侧适配”比端到端重训完整 VLA 更现实。
flowchart LR
    RGB["RGB-D observation"] --> LIFT["Back-project patches"]
    LIFT --> EP["Environment neural points"]
    INST["Instance tracking"] --> RIGID["Rigid SE3 update"]
    RIGID --> EP
    STATE["Proprioceptive state"] --> FK["Forward kinematics"]
    FK --> RP["Robot surface points"]
    EP --> UNION["Shared 64-D point features"]
    RP --> UNION
    UNION --> DEC["Shared residual decoder"]
    DEC --> FEAT["1280-D DINOv3 features"]
    FEAT --> PT["Two-stage Point Transformer"]
    PT --> BR["8 query branches"]
    BR --> TOK["8 map tokens"]
    IMG["Current image"] --> VLM["Frozen VLM"]
    LANG["Language task"] --> VLM
    TOK --> VLM
    VLM --> EXPERT["LoRA action expert"]
    EXPERT --> ACT["30-step action chunk"]
9. 实验设置:三个长时程家庭任务
论文在 BEHAVIOR-1K 上评估三个长时程移动操作任务。每个任务包含 200 条演示、20 个评估配置,场景覆盖厨房、餐厅、客厅等连续房间。任务 21、22、26 的工作空间分别达到 4.4×3.0 米、5.5×9.0 米和 7.6×8.8 米,最大执行步数分别为 38,372、15,384 和 52,120。任务 26 的步数上限尤其大,单次任务可能持续数分钟,因此回程、重复寻找和物体遗忘都会直接拉低完成进度。
| 任务 | 工作空间 | 最大步数 | 每个任务的演示数 | 评估配置数 |
|---|---|---|---|---|
| 任务 21 | 4.4 × 3.0 米 | 38,372 | 200 | 20 |
| 任务 22 | 5.5 × 9.0 米 | 15,384 | 200 | 20 |
| 任务 26 | 7.6 × 8.8 米 | 52,120 | 200 | 20 |
这些数字说明论文没有只做“桌子上抓一个杯子”的短程验证。任务需要在房间之间移动,涉及柜门、桌椅、容器和多个子目标。评价指标是任务进度百分比,报告均值和标准差;标准差较大也说明不同初始布局下的表现差异仍然明显。
10. 主结果:平均进度从 44.0% 提升到 58.7%
最直接的比较是同一 BEHAVIOR-1K 训练和评估条件下的 PI0.5 微调基线与 SERF。下表复现论文主结果。每个单元格是任务进度百分比,误差为标准差。
| 方法 | 任务 21 | 任务 22 | 任务 26 | 三任务平均 |
|---|---|---|---|---|
| PI0.5 预训练 | 42.9 ± 19.7 | 43.0 ± 23.5 | 44.1 ± 22.4 | 43.3 |
| PI0.5 微调 | 40.7 ± 18.8 | 43.0 ± 19.3 | 48.4 ± 21.1 | 44.0 |
| SBP | 57.9 ± 17.8 | 52.5 ± 24.1 | 51.6 ± 11.7 | 54.0 |
| SERF 仅环境 | 57.9 ± 15.3 | 59.0 ± 20.5 | 49.4 ± 13.4 | 55.4 |
| SERF 完整 | 63.5 ± 16.7 | 60.1 ± 19.1 | 52.5 ± 13.8 | 58.7 |
完整 SERF 在三个任务上分别比 PI0.5 微调高 22.8、17.1 和 4.1 个百分点。任务 21 和 22 的提升最大,任务 26 的绝对提升较小,但仍高于 SBP 与环境单模态版本。平均进度从 44.0% 提升到 58.7%,增加 14.7 个百分点。
仅环境点的版本也有 55.4% 平均进度,说明持续更新的环境特征本身有贡献;但加入机器人表面点后,任务 21 再提升 5.6 个百分点,任务 22 再提升 1.1 个百分点。任务 26 上环境版本略高于完整版本,提示在最大场景里,机器人本体 token 可能引入了部分与全局导航无关的局部信息;论文没有把它解释成稳定优势,而是呈现了任务差异。
SBP 在任务 21 与 SERF 仅环境版本持平,但平均成绩低于完整 SERF。它代表已有空间表示基线,说明“用空间信息”不是 SERF 独有的收益;SERF 的增量来自环境与机器人共享特征、以及多尺度分支将地图转成策略可直接读取的 token。
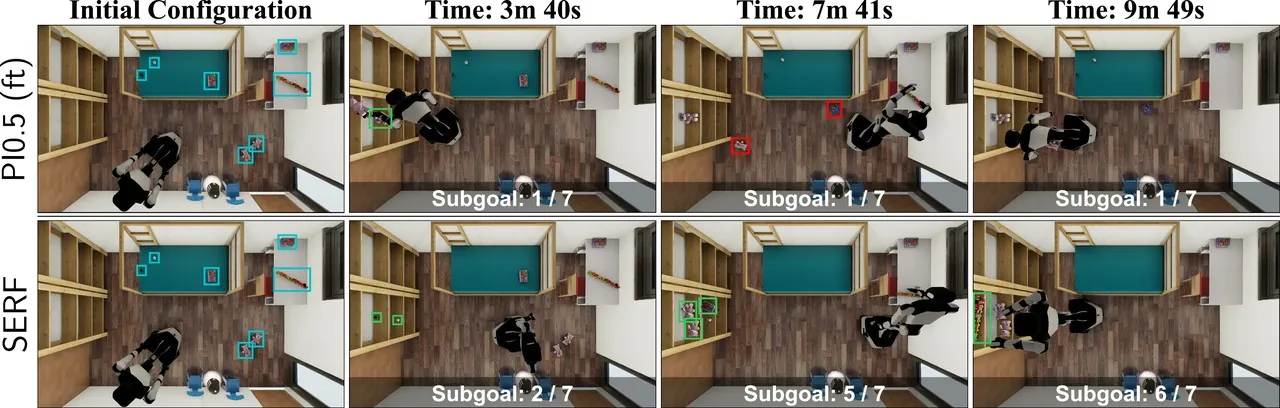
图 4:论文第五图。上方为 PI0.5 微调,下方为 SERF。中间列显示 SERF 更早到达 5/7 子目标,右列在 9 分 49 秒已完成 8/7,而基线仍停在 6/7。进度更快不仅来自局部抓取成功率,也来自更直接的房间间移动。
11. 机载估计替换:没有仿真真值还能不能用
完整 SERF 的 60.1% 使用仿真提供的实例标签和基座位姿。这会引起一个很实际的问题:部署到真实机器人时,这两类信息通常不会直接可得。论文因此做了“机载估计”实验:用 SAM3 生成实例标签,用 ORB-SLAM3 估计机器人轨迹,保持地图与策略其余部分不变。
| 任务 22 输入条件 | 任务进度 | 相对 PI0.5 微调 |
|---|---|---|
| PI0.5 微调 | 43.0 ± 19.3 | 基线 |
| SERF + SAM3 标签 + ORB-SLAM3 位姿 | 54.8 ± 22.9 | +11.8 |
| SERF + 真值标签 + 真值位姿 | 60.1 ± 19.1 | +17.1 |
ORB-SLAM3 在该任务上的轨迹误差为 2.42 厘米和 0.34 度。替换后进度下降 5.3 个百分点,但仍比图像基线高 11.8 个百分点。这个结果比“真值条件下领先”更能说明方法的部署潜力,因为它保留了分割误差、轨迹漂移和尺度误差。
它同时暴露了剩余风险。实例跟踪依赖 SAM3 的标签稳定性;基座漂移会污染环境点坐标;地图一旦用错误位姿更新,后续查询会在错误空间位置聚合特征。SERF 没有在真实机器人上闭环验证,因此这些误差在实验室外可能被光照、反光、动态人和深度缺失放大。
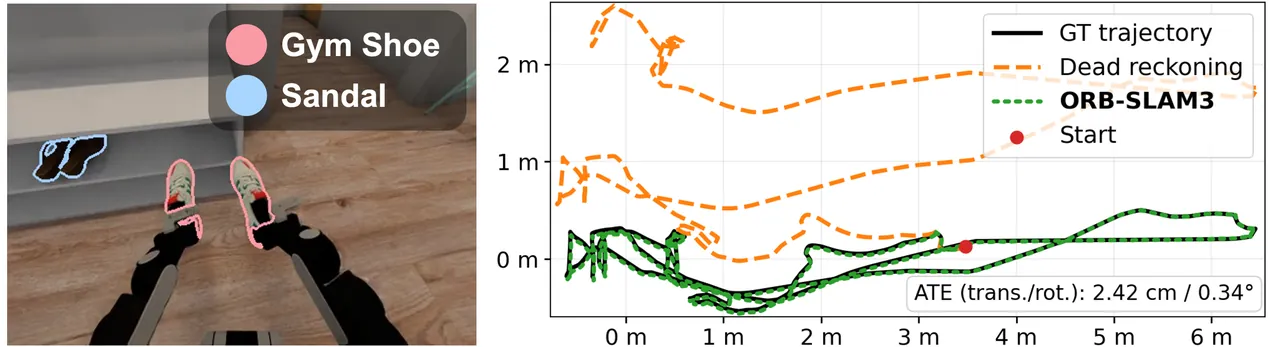
图 5:论文第七图。左侧展示 SAM3 生成的实例标签,右侧比较 ORB-SLAM3 与真值轨迹。机载估计不是把仿真特权信息直接搬到真实环境,而是明确测量替换后的性能损失。
12. 消融:八组 token 中,末端执行器与机器人本体最关键
为了确认收益不是“任意地图 token”带来的,论文在任务 22 上逐个移除分支。结果见下表。完整 SERF 为 60.1%;移除机器人基座、末端执行器、机器人本体、环境本体或全局分支后,进度分别降到 56.5%、54.0%、54.0%、58.5% 和 55.1%。
| 移除的 token 组 | 剩余查询视角 | 任务 22 进度 | 相对完整模型 |
|---|---|---|---|
| 机器人基座三尺度 | 7 组 | 56.5 ± 21.7 | -3.6 |
| 左右末端执行器 | 7 组 | 54.0 ± 21.5 | -6.1 |
| 仅机器人 | 7 组 | 54.0 ± 22.2 | -6.1 |
| 仅环境 | 7 组 | 58.5 ± 20.9 | -1.6 |
| 全局 | 7 组 | 55.1 ± 20.6 | -5.0 |
| 不完整,保留全部八组 | 8 组 | 60.1 ± 19.1 | 0.0 |
移除环境分支只损失 1.6 个百分点,看起来不显眼,但这是“环境本体”分支,不是所有环境点。环境信息仍通过基座、末端和全局查询大量存在,因此不能据此得出环境表示不重要的结论。相反,移除末端或机器人本体 token 损失最大,说明策略特别依赖机器人身体与操作器附近的空间关系。
最难的问题是:这些收益能否仅靠多帧图像获得?论文比较了 PI0.5 图像历史基线。在三个任务上,图像历史分别为 50.0%、49.5% 和 48.1%,完整 SERF 为 63.5%、60.1% 和 52.5%。图像历史确实比单帧 PI0.5 好,但仍低于地图条件策略,说明收益不只是“多给几十帧”。
13. 失败恢复与未访问区域:地图提供了回找能力
长时程任务的一个关键失败模式是物体掉落。图像模型可能只看到空桌面,不知道物体刚才落在哪里;地图则保留了物体被移动前及掉落后的空间位置。论文测试了 20 次物体掉落恢复,SERF 恢复成功率为 95%,平均恢复时间 20.5 秒。这个结果不能证明系统能处理所有物理扰动,但说明地图状态确实可被策略用于重新定位目标。
在未访问区域上,环境地图还表现出外推能力。对比无地图方法,SERF 在未访问区域的任务进度从 28.0% 提升到 51.0%。这一提升与神经点插值有关:邻域查询不是只能读取直接观测过的点,而是在连续空间中根据周围特征估计未知位置;不过这种估计仍然依赖已有规划和 DEMO 覆盖,不能等同于完整的场景重建。
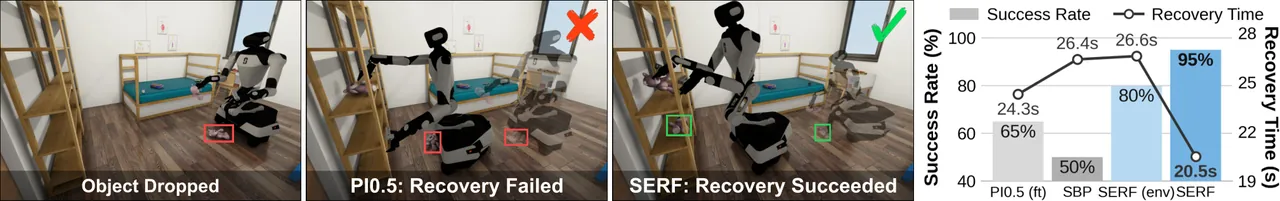
图 6:论文第六图。物体掉落后,PI0.5 无法恢复,SERF 在不同配置中重新找到物体并完成任务。右侧为 20 次恢复实验的成功率和平均恢复时间。
14. 代码对应:论文中的对象与仓库中的实现
SERF 代码分成两个仓库。映射仓库负责环境神经点、机器人表面采样、共享解码器和实例刚体跟踪;策略仓库负责把地图点转换为八组 token,并接入 PI0.5 的 VLA。论文公式与源码的对应关系并不是只停留在类名,而是能落到具体的张量操作和更新提交路径。
映射侧的关键文件是 mapping/train_neural_points_env_and_robot.py。它在同一个训练循环里创建环境点地图和 RobotNeuralPointMap,把解码器参数、环境点参数和机器人点参数放进同一优化器。这与论文“共享解码器”不是隐喻,而是实际共享同一个 $D_\theta$。
策略侧的关键文件是 src/serf_b1k/models/pi_serf_behavior.py 与 point_transformer_local.py。前者从完整本体状态计算正运动学,再把 25,000 个点及机器人中心、左右末端位置送入 tokenizer;后者按三个基座半径、一个全局分支、两个末端分支、一个机器人分支和一个环境分支生成 token。
机器人正运动学实现位于 robot_fk_jax.py,它把关节状态映射到基座、左右末端和机器人点位置。训练配置位于 training/config.py,论文中的 30 步动作时域、32 维动作、20,000 步、批量 16、15 个 flow 样本和 $2.5\times10^{-6}$ 峰值学习率都可以在配置中找到。图像与地图特征的训练、实例跟踪和策略训练相对独立,这也是仓库拆成两个项目的原因。
15. 局限:结果强,但离真实世界还有距离
作者明确承认,完整结果依赖预先学到的地图特征、仿真提供的实例标签和基座位姿。即使补充了 SAM3 与 ORB-SLAM3 的替换实验,也不能等同于真实机器人长期运行;仿真中的深度噪声、物体物理属性和相机标定通常比真实环境稳定。
第二项作者自述限制是只有刚体更新。环境点通过每个实例的 $SE(3)$ 变换移动,因此能处理桌子、椅子、鞋子等刚体,却无法直接表达开门时铰链连杆的连续变化,也无法表达布料、袋子和软容器的形变。对于这些问题,可能需要关节物体分解、非刚体形变场或柔性体表示。
第三项限制是地图没有多时间窗口,也没有预测未来状态。它记录当前和历史累积结果,但策略不能直接查询“如果我把椅子再推 20 厘米,地图会怎样”。因此它更像状态记忆而不是世界模型。第四项限制是 token 子集由人工固定,而不是根据任务自适应选择;不同任务是否需要全部八个分支、每个半径是否合适,目前没有自动学习方法。
从独立角度看,还有三个现实问题。第一,DINOv3、CoTracker、SAM3、ORB-SLAM3 与 25,000 点 Transformer 同时运行的算力开销不低,论文主要报告任务效果,没有给出端到端延迟和机载功耗。第二,跟踪失败会污染地图索引,且错误可能被后续查询持续放大;原子提交能防止半状态,但不能自动纠正长期错误。第三,评估集中于三个 BEHAVIOR-1K 任务,跨房屋、跨机器人和真实环境的泛化仍需验证。
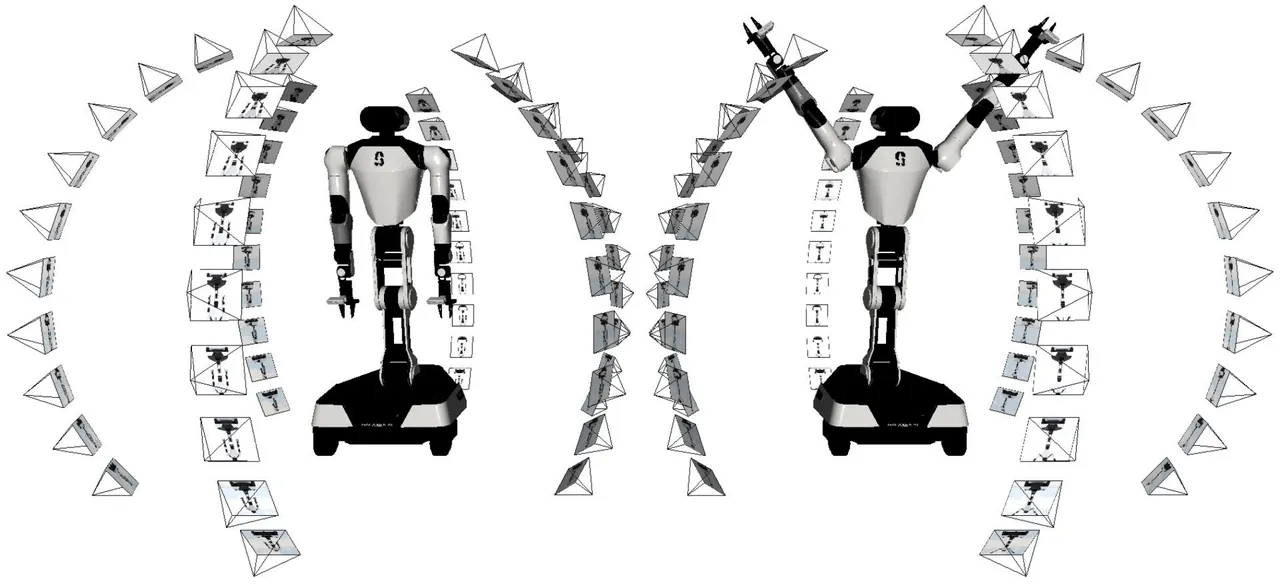
图 7:论文第八图。不同机器人构型下的表面重建样本。固定拓扑表面点与正运动学共同决定机器人身体在地图中的位置,但表面采样本身不处理柔性形变。
16. 讨论:它对移动操作系统的真正启发
SERF 最重要的启发不是“地图越大越好”,而是把地图做成策略可消费的中间状态。传统 SLAM 与 VLA 之间往往缺少一个稳定的语义接口:SLAM 输出几何,VLA 需要视觉语义,二者靠额外提示或临时编码拼接。SERF 用共享隐特征和固定查询接口把两侧接起来,使地图既能被局部更新,又能以少量 token 进入动作模型。
第二个启发是机器人身体必须显式进入空间状态。许多视觉导航策略把机器人当成一个点,忽略机械臂、躯干和夹爪的占用;而移动操作需要判断“我能否从这张桌子旁通过”“左手现在在柜门后面还是前面”。将机器人表面点与环境点放在同一张地图里,比额外给策略一个关节向量更接近物理问题的结构。
第三个启发是长时程任务需要可更新的记忆,但记忆不一定要以自然语言或全量历史帧保存。八个 token 的压缩比很高,却保留了多尺度空间关系。代价是 token 的查询半径和分支类型由设计者决定,未来若能让任务语言动态选择查询区域,地图接口会更接近任务条件化的世界状态。
从工程落地看,最值得继续推进的是把跟踪置信度、地图不确定性和策略决策绑在一起。当前系统知道实例是否静止、质心误差是否可接受,却没有把这些不确定性直接送入动作风险判断。如果机器人能够识别“这张椅子的地图最近更新过且跟踪置信度低”,就可以选择重新观察或绕行,而不是把错误位置当成可靠事实。
17. 结论
SERF 把环境物体与机器人身体统一成共享神经点地图,环境点由实例刚体跟踪更新,机器人点由正运动学更新,随后通过共享解码器输出 DINOv3 特征,并由八组多尺度 tokenizer 送入 VLA。它在 BEHAVIOR-1K 上把三任务平均进度从 44.0% 提升到 58.7%,在机载估计替换、token 消融、图像历史比较和物体掉落恢复中都给出了有信息量的结果。
这篇论文的价值不在于宣布长时程机器人已经被解决。它更像是在图像与动作之间补上了一层可更新的空间状态,并证明这层状态能被策略实际使用。下一步要回答的是:如何让地图知道自己的不确定性,如何处理非刚体和真实世界跟踪误差,如何把多尺度查询从人工设计变成任务驱动的表示。