PAPER DEEP DIVE
ASPIRE:面向机器人智能体的技能发现
通过多模态执行轨迹诊断机器人程序失败,用进化搜索修复候选程序,并将验证过的修复沉淀为可跨任务、跨平台复用的技能库。
一、研究背景:机器人失败并不是一条“任务未完成”日志
机器人程序同时依赖感知、定位、抓取、运动规划和长时序协调。一次失败回放通常只给出最终的任务成败,却无法直接说明问题出在物体没有被看见、目标位置有偏差、抓取候选不可达、规划器撞上安全缓冲区,还是后续恢复步骤覆盖了前面的正确动作。对软件代理而言,这种粗粒度反馈不足以形成可靠的因果诊断。
代码即策略把机器人行为暴露成可读、可编辑的 Python 程序,使语言模型能够像软件工程代理一样检查、修补和重新执行策略。然而,已有机器人编码代理往往只提供场景级摘要或固定观测通道。观测太少会隐藏真正出错的图元调用,观测太多又会把大量无关视频帧塞进上下文,反而减弱失败归因。
另一个缺口是经验不会累积。任务完成后,本轮发现的抓取修正、接近方向或运动原语通常被丢进历史记录,下一个任务仍从相同起点开始。ASPIRE 将这个问题表述为持续学习:不仅要在单次任务中修复程序,还要把已验证的修复压缩成可检索、可迁移的上下文技能。
论文借用人类机器人工程师的工作方式:回放执行、检查感知输出与轨迹、定位子系统故障、修改代码,再把可复用的恢复策略内化为经验。区别在于,ASPIRE 让语言模型自动提出“应该看哪一段轨迹”和“应该怎样改写程序”,并用执行器验证假设,而不是依赖人工逐帧排查。
因此,这项工作关心的不是某一个固定任务上的端到端策略,而是机器人编程能力能否随任务数量增长。系统希望越往后遇到相似失败时,越少重复试错;在新任务上,不仅复用完整程序,还能复用关于失败模式、适用条件和修复方案的局部知识。
二、问题形式化:程序、执行与轨迹构成搜索状态
设一个机器人任务为 $\tau$,候选控制程序为 $P$,调试种子集合与留出评估集合分别为 $S_{\mathrm{dbg}}$ 和 $S_{\mathrm{eval}}$。执行引擎并不是只返回一个成功率,而是对程序在给定种子上的运行给出评分和完整轨迹包:
$$ \operatorname{Execute}(P,S)=(r,Z) $$其中 $r$ 是用于比较候选程序的执行得分,$Z$ 包含每次公开工具调用的输入摘要、输出摘要、状态码、耗时、帧标识以及必要的图像证据。这个定义很关键:ASPIRE 搜索的是可执行程序 $P$,选择依据则来自真实运行得到的 $(r,Z)$,而不是语言模型对代码的静态自信度。
初始历史从一条基线程序开始。系统先执行 $P^0$,再把程序、得分和轨迹组成搜索集合:
$$ \mathcal{H}\leftarrow\{(P^0,r^0,Z^0)\} $$每轮由编码代理根据任务描述、历史中表现最好的候选、当前技能库和残余失败轨迹提出 $K$ 个修复程序。论文算法可以概括为:
$$ \{P_i^k\}_{k=1}^{K}\leftarrow\operatorname{ProposeRepairs}(M,\tau,\operatorname{Top3}(\mathcal{H}),\mathcal{L},\mathcal{H}) $$这里的 $M$ 是驱动编码代理的模型,$\mathcal{L}$ 是已验证技能库,$i$ 表示进化轮次。Top3 并非简单保留三条聊天记录,而是保留当前最有解释价值的程序及其执行证据。执行所有候选后,系统选择本轮得分最高的个体:
$$ k^\star=\arg\max_k r_i^k $$只有当新个体严格优于当前最优程序时,才替换全局候选;一旦达到调试阈值 $\theta$,或者用尽 $T$ 轮预算,搜索就停止。最终程序仍需在未参与搜索的 $S_{\mathrm{eval}}$ 上评估一次:
$$ (r_{\mathrm{eval}},\cdot)\leftarrow\operatorname{Execute}(P^\star,S_{\mathrm{eval}}) $$这一分离避免了把调试集上的过拟合误写成泛化能力。论文说明搜索完成后才从调试历史中提取已验证模式,最终程序只在留出集执行一次。相比“每个评估种子重新生成一次代码”的基线,这是更严格的计算口径。
三、方法:从细粒度轨迹到持续增长的技能库
1. 执行引擎把任务级反馈拆成图元级证据
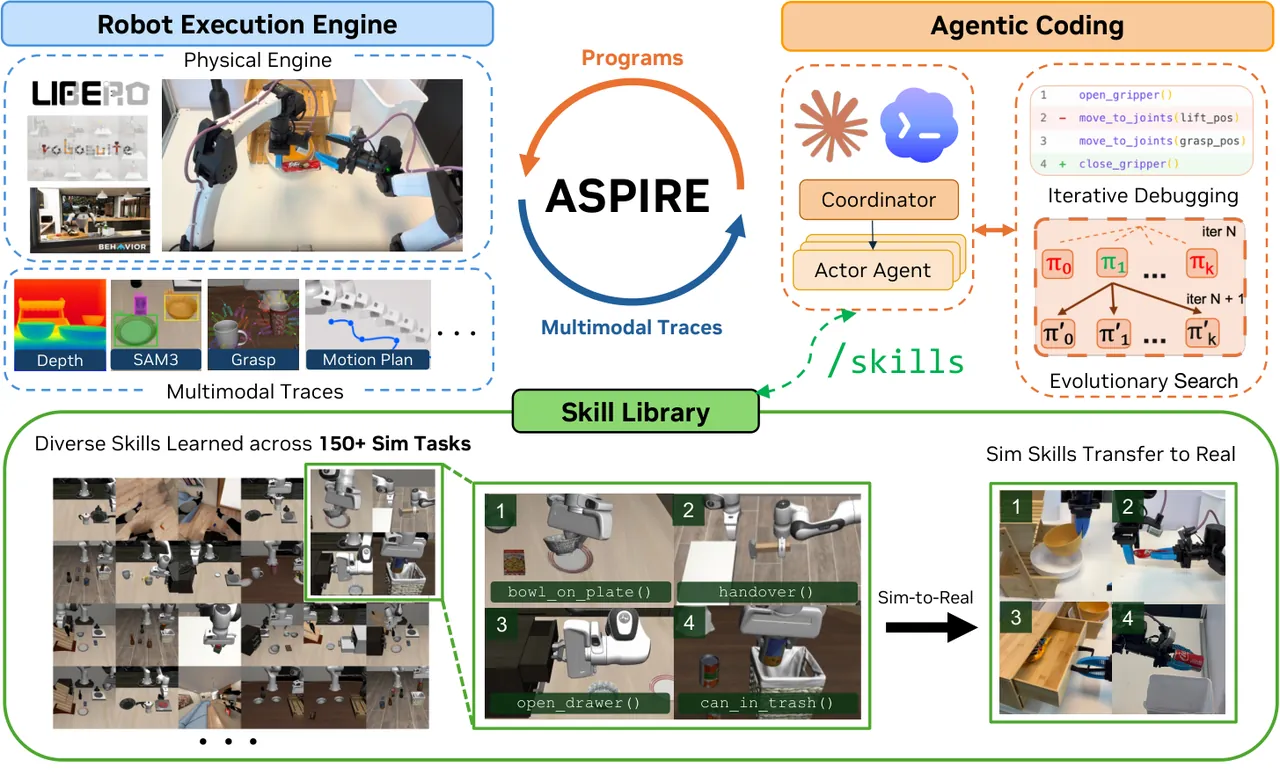
对每一次感知、规划、抓取和控制调用,执行引擎记录 API 名称、输入、输出、返回状态以及可用的多模态证据,例如 RGB 关键帧、感知覆盖层、抓取候选、物体位姿与规划结果。它不会把所有连续视频直接交给代理,而是在关键调用前后保存帧,让代理能从失败返回码反向定位需要检查的调用。
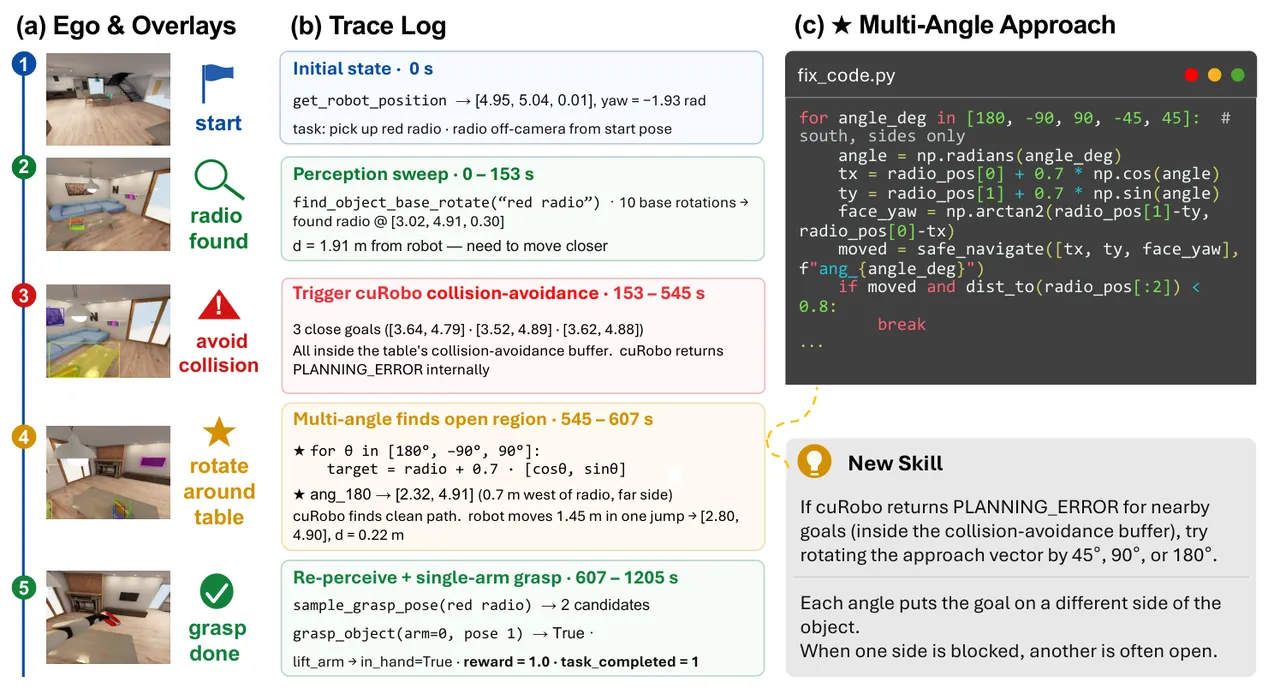
BEHAVIOR-1K 的“拿收音机”案例说明了这种归因能力。感知已经返回收音机位姿,但多次导航调用都给出规划错误。轨迹进一步显示,目标点离桌边不到约 20 厘米,落入碰撞避让缓冲区。代理因此没有修改识别提示词,而是加入多角度接近例程,从可达侧面重新感知并完成抓取。
2. 技能不是完整程序,而是带触发条件的修复知识
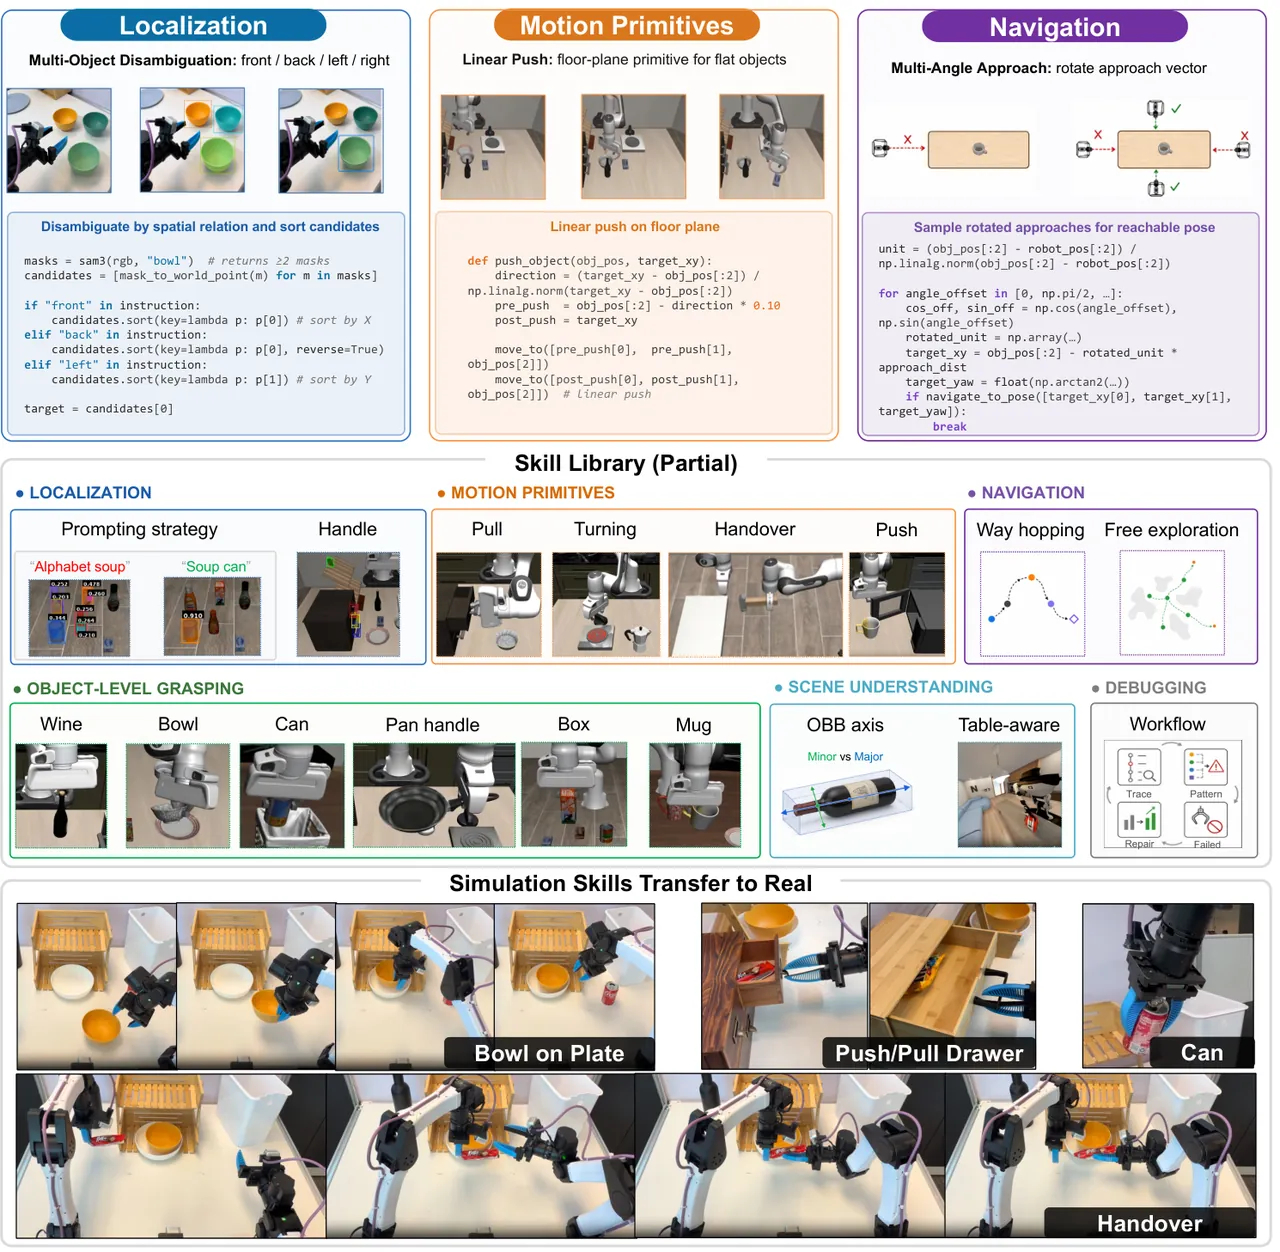
技能库保存的是定位启发式、感知提示、抓取约束、导航恢复策略、运动原语、场景理解例程和调试流程等异质知识。论文没有预先规定这些类别,而是从成功修复中归纳。每条技能包含失败特征、何时适用的守卫条件、修复策略,必要时附一小段代码草图。
“多角度接近”就是典型条目:当规划错误反复出现在障碍边界附近,并且采样目标落入碰撞缓冲时,代理应在重试感知和抓取前围绕物体采样其他接近方向。它复用的是一个可解释的局部模式,不是把当时那张桌子或那台机器人硬编码进完整程序。
3. 独立验证器决定技能能否进入共享库
任务代理先提交结构化发现,包括失败模式、已验证修复和候选的迁移模式。随后一个新的验证代理只拿到这条候选技能,在源任务的一部分种子上独立复现。协调器还检查技能是否遵守公开 API 策略,只有真正可复现且可迁移的条目才被提升进技能库。
这种准入机制把“语言上听起来合理”与“执行上能够成立”分开。技能库共享的是经过压缩和验证的经验,而非所有代理的完整聊天历史与原始回放。这样既降低上下文负担,也减少某个代理把偶然成功错误泛化为通用规则的风险。
4. 进化搜索跳出局部修复循环
单纯的迭代调试容易陷入局部最优:代理不断修改同一条失败路线,却没有尝试完全不同的策略。ASPIRE 每轮并行提出 $K$ 个可执行候选,并把上一轮的失败轨迹作为下一代条件。候选之间不是文字变体,而是可以被执行器实际运行和打分的程序。
这个设计同时保留了搜索的多样性和执行的可靠性。表现最好的程序提供可继续修补的基础,残余失败模式则提示哪些方向还没有解决。程序本身成为遗传单位,执行轨迹成为适应度证据,验证后的局部修复再进入技能库。
5. 协调器安排课程,并把新技能回灌给早期任务
协调器根据当前技能库选择下一个任务,可以填补能力空缺、检验已有技能能否用于新场景,也可以沿着近期发现继续安排同组任务。由于任务是顺序执行的,早期任务只能使用很小的技能库,低分不一定说明任务本身困难。
因此,完整库形成后,协调器允许对早期低分任务单独重跑一次。这一步产生“回向迁移”:技能虽然是在后续任务中学到的,却能够反过来修补更早写出的程序。论文在 Claude Opus 5 的 LIBERO-Pro Long 运行中,将总体成功率从 74.6% 提高到 82.2%,净增 7.6 个百分点。
flowchart TB
    C[Coordinator selects task] --> A[Actor writes program]
    A --> E[Execution engine runs debug seeds]
    E --> T[Per primitive traces]
    T --> D[Diagnose failure]
    D --> R[Patch executable program]
    R --> V{Threshold reached}
    V -->|no| S[Evolutionary candidates]
    S --> E
    V -->|yes| Q[Evaluate held out seeds]
    Q --> Z[Fresh verifier reproduces repair]
    Z -->|pass| L[Shared skill library]
    L --> C
    L --> H[Rerun weak earlier tasks]
四、代码落地:限制、证据与成功判定是三套不同契约
公开仓库将方法落实为受控的代码即策略执行框架。第一个关键点是生成程序不能直接访问任意 Python 能力。执行器先做抽象语法树检查,再从工具注册表构造只包含公开工具命名空间的执行环境:
# src/cap_harness/runtime.py
tree = ast.parse(code, mode="exec")
_ProgramValidator().visit(tree)
compiled = compile(tree, "<generated-program>", "exec")

for spec in self._registry.all_specs(public_only=True):
    ...
验证器禁止私有名称和属性、类定义、异步语法、全局与非局部变量、上下文管理器以及除 math 之外的导入;运行环境还会过滤 ground_truth、reward、模拟器状态和特权观测等敏感键。这使语言模型只能在公开机器人 API 内编程,评测真值不能通过数据读取泄漏给策略。
第二个关键点是轨迹证据采用分层记录。工具调用会创建 span,保存输入和输出;运动类工具在调用前后额外保存关键帧;每条记录还会经过凭据字段与令牌文本脱敏后原子写入磁盘:
# src/cap_harness/runtime.py
with self._recorder.span(
    name, category="program",
    inputs={"args": args, "kwargs": kwargs},
) as span:
    result = self._invoke_tool(name, function, args, kwargs)
    span.output(result, ok=ok)
if motion:
    self._recorder.keyframe(f"before-{name}")
    self._recorder.keyframe(f"after-{name}")
对应实现位于 src/cap_harness/artifacts.py。它记录观测、动作、时间归因、视频、终止原因和最终结局,同时用模式匹配清理 authorization、token、password 等敏感字段。因此“多模态轨迹”不是把全部原始状态倾倒给模型,而是一组可追溯、可裁剪、可脱敏的执行证据。
第三,程序执行成功与任务成功是两个独立字段。仓库的 run.py 分开记录 program_ok 和 task_success,测试也明确要求:程序报告自身失败时,不能抹掉环境已经判定成功的任务结果。这防止代理在自我报告中掩盖真实行为,也提醒读者不要把“代码没抛异常”误当成“机器人完成了任务”。
五、实验设置与主要结果
主实验使用 Claude Opus 4.6 与 1M 上下文运行,覆盖 LIBERO-Pro、Robosuite 和 BEHAVIOR-1K。三个环境共用感知、几何和运动规划 API。LIBERO-Pro 每个任务在 51 至 65 号种子上学习,在 1 至 50 号留出种子上评估;Robosuite 在 101 至 125 号种子上学习,在 1 至 100 号种子上评估;BEHAVIOR-1K 则在 26 至 35 号种子上学习,在 1 至 25 号种子上评估。
| 方法 | 物体扰动 | 目标扰动 | 空间扰动 | 总体 |
|---|---|---|---|---|
| OpenVLA | 0% | 0% | 0% | 0% |
| π0.5 | 17% | 1% | 20% | 13% |
| CaP-Agent0 | 22% | 18% | 12% | 18% |
| ASPIRE / Opus 4.6 | 98% | 95% | 51% | 72% |
| ASPIRE / Opus 4.6(任务改写) | 95% | 45% | 60% | 67% |
表 5 的关键不是“总体从 18% 升到 72%”这一个数,而是扰动类型之间的差异。物体和空间位置变化下,ASPIRE 分别达到 98% 与 51%;任务指令被改写后,目标类任务下降到 45%,说明系统虽然能调用真实施行轨迹修复,但语言重述仍会破坏部分技能检索与任务对齐。
Robosuite 更接近接触丰富操作。ASPIRE 总体为 81%,高于 CaP-Agent0 的 68%。优势主要集中在协同操作:双臂交接从 20% 提升到 92%,螺母装配从 0% 提升到 9%。但双臂抬举从 74% 降到 71%,说明执行轨迹并不自动保证每个任务更好,新增修复也可能改变原本有效的动作选择。
| Robosuite 任务 | CaP-Agent0 | ASPIRE |
|---|---|---|
| 双臂交接 | 20% | 92% |
| 双臂抬举 | 74% | 71% |
| 螺母装配 | 0% | 9% |
| 七任务平均 | 68% | 81% |
BEHAVIOR-1K 把导航与任务完成分开评价,避免“走到附近”被混同为“真的拿到了物体”。在收音机任务上,人工程序的导航和任务成功率分别为 88% 与 36%,CaP-Agent0 为 80% 与 56%,ASPIRE 则达到 100% 与 88%。这条长时序任务的提升来自前文的多角度接近技能,也体现了图 2 中轨迹归因的实际价值。
| BEHAVIOR-1K | 人工导航 / 任务 | CaP 导航 / 任务 | ASPIRE 导航 / 任务 |
|---|---|---|---|
| 拿汽水罐 | 80% / 72% | 84% / 72% | 92% / 88% |
| 拿收音机 | 88% / 36% | 80% / 56% | 100% / 88% |
六、技能库真的积累了吗:零样本迁移与回向迁移
论文在 LIBERO-90 的不同任务数量上建立四个技能库快照 $N\in\{0,25,50,90\}$,然后把它们直接用于未参与调试的 LIBERO-Pro Long 任务。$N=0$ 相当于空库,$N=90$ 使用完整源任务经验。评估时不再更新技能库,也不针对留出任务重试。
结果呈单调增长:空库总体为 4.7%,25 个任务时为 13.7%,50 个任务时为 21.5%,90 个任务时为 30.5%。附录给出的位置扰动轴为 22.6%,任务改写轴为 38.3%;正文按整数显示为 23% 与 38%,摘要把总体写成 31%。本文保留附录精确值,并注明舍入差异。
| 技能库规模 | 位置扰动 | 任务扰动 | 总体 |
|---|---|---|---|
| N=0 | 0.0% | 9.4% | 4.7% |
| N=25 | 5.6% | 21.8% | 13.7% |
| N=50 | 13.8% | 29.2% | 21.5% |
| N=90 | 22.6% | 38.3% | 30.5% |
这组结果比主基准更直接地检验“经验复利”假设。随着源任务增多,技能库覆盖的定位、抓取、导航和恢复模式更广,性能持续上升。但 30.5% 也说明零样本长任务远未解决;逐任务表中有明显反向波动,例如部分任务在更大库上反而下降,这与技能过期、冗余或不匹配有关。
回向迁移实验进一步表明,学习顺序会影响结果。五个早期低分任务在完整库形成后被重跑,其中四个提升,一个保持为零。最大的两个提升分别来自碗进抽屉和瓶子进抽屉,成功率增加 52 与 72 个百分点。完整一套 20 个任务的成功数从 746/1000 增加到 822/1000。
七、消融:密集轨迹比额外搜索更关键,但两者解决的问题不同
移除执行引擎后,LIBERO-Pro 平均成功率只有 14%;加入图元级轨迹与闭环验证后提升到 62%;再加入进化搜索后达到 72%。这说明大多数可修复失败需要的是足够具体的执行证据,而不是单纯增加语言模型采样次数。
进化搜索仍有不可替代的作用。它最擅长处理“局部修改已经走到尽头”的任务。例如在 Claude Opus 5 上,把杯子放进微波炉的任务从 0% 提高到 42%;在 GPT-6 Astra 上,把碗放进顶层抽屉从 82% 提高到 98%。强模型的常规迭代成功率更高,因此搜索对平均分的增量缩小,但对残余难例仍有关键贡献。
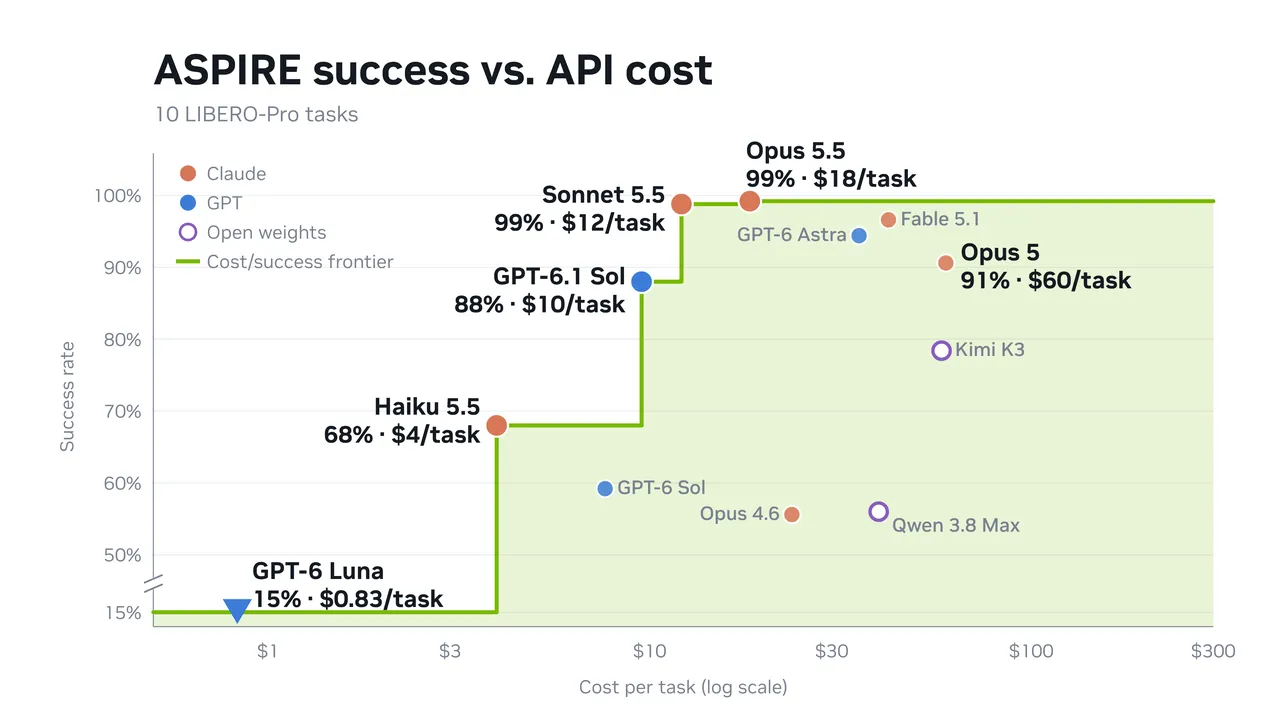
模型消融覆盖十二个模型。在目标位置扰动任务上,GPT-6 Luna 为 15%,Claude Opus 4.6 为 56%,Kimi K3 为 78%,Opus 5.5 与 Sonnet 5.5 达到 99%。成本前沿上的 Sonnet 5.5 为 98.8% 成功率、每任务约 12 美元;Opus 5.5 为 99.2%、约 18 美元;Opus 5 为 91%、约 60 美元。ASPIRE 的能力上限明显受基础模型影响。
八、跨平台与真实机器人:技能是指导,不是直接部署
真实机器人实验使用不同的双臂 YAM 平台、感知栈和控制 API。系统没有把仿真策略权重直接搬到设备,而是把仿真中学到的“拿汽水罐”“碗放到盘子”“推拉抽屉”技能作为上下文指导,真实机器人编码代理仍需通过自己的执行轨迹完成适配和调试。
| 真实任务 | 无技能总词元 | 有技能总词元 | 无技能成功率 | 有技能成功率 |
|---|---|---|---|---|
| 碗放到盘子 | 8.65M | 5.11M | 20/20 | 20/20 |
| 拿起汽水罐 | 61.94M | 6.58M | 13/20 | 19/20 |
| 打开或推拉抽屉 | 334.92M | 81.67M | 0/20 | 11/20 |
这组数字更像“编程成本”而非传统策略迁移指标。碗任务本身已接近饱和,技能主要减少词元消耗;汽水罐任务在词元减少近一个数量级的同时成功率升至 95%;抽屉任务原本用尽较小编码预算仍无法生成成功程序,有技能后达到 55%。不过 token 下降不能自动解释为找到了更优物理策略,其中可能包含更快的失败定位和更短的调试路径。
在线真实机器人案例让 GPT-6 Astra 连续三次尝试魔方。第一次运行 50 分 54 秒仍未解开;后两次分别用 39 分和 77 分 10 秒完成。三次记录的面转动次数为 3、5、25,折算每次转动时间依次为 1018 秒、468 秒和 185 秒,词元消耗从每次 11.27M 降到 2.01M,估算成本从 16.85 美元降到 2.89 美元。
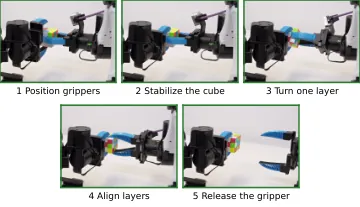
必须注意,这三次运行并不是同一难度下稳定收敛的统计实验。第二、三次总时长并非单调下降,完成次数也不同;真正改善的是按完成转动摊销的时间、词元与成本。作者把它解释为文本技能积累降低了重复探索,但样本量很小,不能替代多随机种子、多物体状态的大规模评测。
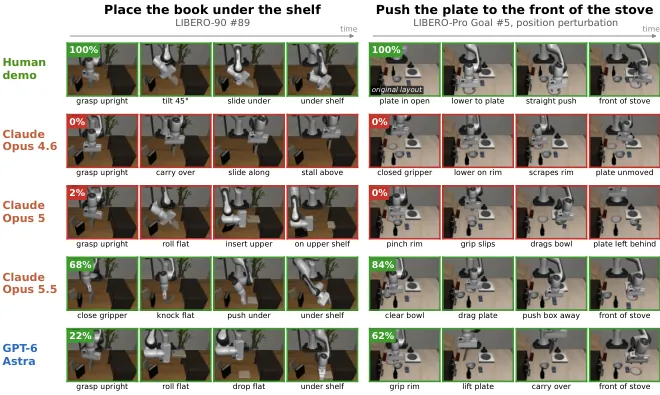
策略差异案例揭示了强模型为何更有效。面对书架下方过低的缝隙,较弱模型坚持夹着竖立书本移动,最终卡住;Opus 5.5 选择先把书撞倒再推入,Astra 则滚平后释放再推。面对被碗和盒子遮挡的盘子,强模型会先清理障碍或把盘子抬高绕过,而弱模型仍沿用默认抓取搬运方式。
九、局限与风险:哪些结论还不能外推
第一项局限由作者明确承认:系统还不是完全自主的真实世界终身学习者。魔方案例仍由人工提供初始任务指导、打乱魔方、在两次运行之间重置场景;真实环境的成功检测、安全重置、持续监控与标定维护也尚未闭合。
第二项局限是对基础模型的强依赖。弱模型即使拥有一致的 API、种子和执行协议,仍可能提出错误的修复假设或过早停止。论文最好的结果依赖专有前沿模型,开源权重的 Kimi K3 在代表性目标任务上为 78%,差距明显。
第三项限制来自预定义工具 API。统一 API 让技能可读、可验证和可迁移,也规定了代理能够表达的行为边界。若任务需要 API 之外的触觉、接触控制或专用交互能力,代理只能低效近似,或者等待人类扩展工具。
第四项限制是技能库治理。技能仅在准入时由新验证器复现一次,随着库增长并没有持续复验、去重和按任务重排。在零样本逐任务结果中已经出现技能库扩大反而伤害某些任务的情况。检索到过期或错误适用的技能,可能比没有技能更糟。
第五项限制是计算开销。每个任务需要多次模型调用、仿真或真实回放,进化搜索还会成倍增加候选。论文报告的最大运行达到数十亿总词元和数千美元量级,不能直接等同于低成本部署系统。技能的长期复用有望摊薄成本,但仍需要更便宜的推理和更有效的搜索。
从评测角度看,还应警惕把同一模型的多次改进当成独立方法增益。不同模型、技能库状态、进化搜索开关和重跑策略交织在一起,作者用成本前沿、逐任务表和消融尽量拆解,但真实机器人样本、长任务覆盖和跨平台数量仍然有限。
十、结论:机器人编程代理的“经验层”
ASPIRE 最主要的贡献不是某个单一分数,而是把机器人编码代理的执行反馈、程序搜索和技能记忆连接成闭环。执行引擎提供足够细的失败证据;进化搜索避免代理困在一条修补路径;技能库把局部成功转成可检索的上下文知识;课程与回灌让后学到的技能反哺早期任务。
实验显示这条路线在短时操作、接触丰富操作和长时家务任务上都能超过固定流水线与逐回合重写基线,且技能库大小与零样本长任务成功率之间存在单调关系。与此同时,任务改写下的下降、真实机器人仍需人工重置、强模型依赖和技能老化说明系统仍处在早期阶段。
对后续研究更有价值的启示是:持续学习不一定只能在模型权重中发生。对于代码即策略系统,经过执行验证的失败归因、适用条件和修复片段本身就能形成可审计的经验层。真正需要解决的下一层问题,是技能如何持续复验、组合、淘汰,并安全扩展到开放的真实世界。