PAPER DEEP DIVE
TurboT2VA:分数正则化一致性蒸馏加速 19B 视频音频联合生成,四步采样 20.1×、H20 上全栈 54.67×
联合文生视频+音频模型推理开销巨大。TurboT2VA 针对 19B 联合视频音频模型提出蒸馏+推理框架:逐模态归一化解决模态不均衡优化,渐进式课程(离散一致性预热→连续一致性精炼→联合一致性-分布匹配)先建立稳定多样轨迹再做分布级精炼。LTX-2 上四步蒸馏将 512×768 生成延迟 50.52s→2.51s(20.1×),画质/音质/多样性/音画同步保持;架构感知推理栈(guard W8A8+融合算子、padded-text 压缩、模态感知稀疏注意力)在 1024×1792 高分辨率下单张 H20 318.74s→5.83s(54.67×)。
一、问题背景:联合音视频生成的推理成本之痛
文本到视频+音频(Text-to-Video-Audio,T2VA)联合生成最近取得了实质进展,代表性系统如 LTX-2 能在统一架构下同时产出视觉画面与语义相关、时间对齐的声音。然而这类模型依赖多步扩散(diffusion)或流(flow)采样,推理成本高昂:本文的教师模型是一个 19B 参数的联合音视频模型,由 14B 视频骨干与 5B 音频骨干构成,在标准评测分辨率 512×768 下单样本平均推理时间约 50.52 秒;在高分辨率部署设置 1024×1792 下更是达到 318.74 秒每样本。这个量级的延迟直接限制了真实场景部署。
值得区分的是另一条路线:级联式(cascaded)流程先文生视频再由视频生成音频(或反向),虽然部分缓解了「无声视频」的问题,但顺序建模两个模态容易引入语义不匹配、节奏不一致与时间错位。联合生成则把视觉与声学内容放在统一过程中建模,代价是两个模态都要走完长的扩散/流轨迹——这正是蒸馏需要解决的问题。
总体而言,「把多步 T2VA 教师蒸馏成少步学生」是落地部署的关键,但把 T2I/T2V 的加速方法直接搬到 T2VA 会撞上三堵墙:
- C1 模态不均衡:视频与音频在尺度与时间分辨率上差异巨大,朴素的联合损失会导致优化被视频主导,损害音频质量与音画同步。
- C2 连续时间轨迹学习的稳定性:sCM 虽提供了摆脱有限步近似的更忠实监督,但其通过雅可比-向量积(JVP)估计轨迹切向的方式,在放大到 19B 联合模型时数值上极其脆弱——尤其对音频,微小的轨迹误差就可能扰动声学演化与音画同步。
- C3 质量-多样性权衡:一致性学习提升多样性,分布匹配提升真实感但降低多样性;在 T2VA 中如何兼顾二者始终没有解决。
二、前置知识:为什么是「连续时间」一致性 + 分布匹配
扩散/流模型的加速方法大体分两类,各有取舍:
一致性蒸馏族。 dCM 在离散化的噪声层级之间施加一致性约束,依赖在预设时间步网格上做数值 PF-ODE 更新;这种有限步构造会引入离散化误差,并且需要精心调度时间步网格。sCM 则取连续时间极限,直接跟随教师轨迹的局部切向,避免了有限步目标近似,提供更忠实的监督,并在不同离散化设置下都被证明优于离散时间一致性。对有联合时间对应要求的 T2VA 而言,这种忠实的连续轨迹监督尤其有吸引力——视觉运动、声学演化和二者的时间对应必须被同时保住。代价是 sCM 需要 JVP 估计轨迹切向,训练更吃数值稳定性。
分布匹配蒸馏族。 DMD 及其改进版 DMD2 通过分数层面的差异对齐学生与教师的分布,能以一步或极少步达到很强的合成质量,但可能表现出去模式化(mode-seeking)行为、降低样本多样性。对 T2VA 来说这个权衡格外重要,因为这里的「多样性」同时覆盖视觉外观、运动轨迹、节奏模式、声音事件与音画对应关系。
本文的出发点正是:这两族优势互补——一致性学习保住生成轨迹与样本多样性,分布匹配通过对齐教师分布提升感知质量。rCM(score-regularized continuous-time consistency)已经尝试把二者结合以改善质量-多样性权衡,但把它扩展到大规模联合 T2VA 生成此前基本未被探索。TurboT2VA 就是补上这一环。
三、联合跨模态蒸馏:共享轨迹,而不是两个独立分支
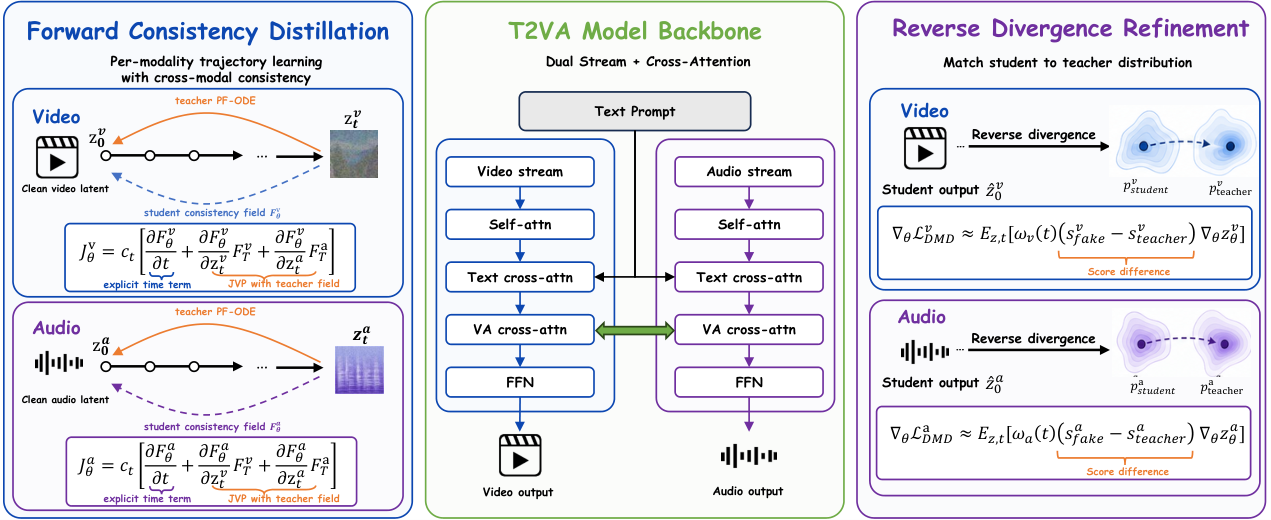
TurboT2VA 把分数正则化一致性蒸馏从纯视频生成适配到统一的文生视频音频生成。关键选择是:不把视频与音频当作两条独立分支蒸馏,而是在配对的视频-音频 latent 上建模。设 $M=\{v,a\}$ 为模态集合,给定文本条件 $c$,干净样本表示为 $z_0=(z_0^v, z_0^a)$。采样一个共享的基础时间步 $t$,构造噪声 latent:
$$z_t^m = \cos(t)\, z_0^m + \sin(t)\, \epsilon^m,\qquad m \in M$$其中 $\epsilon^v$ 与 $\epsilon^a$ 独立采样,而时间步与文本条件是共享的。因此视频与音频是沿着同一条生成轨迹被蒸馏,而不是两条互不相关的去噪路径。学生一次前向同时预测两个模态:
$$(\hat z_{0,\theta}^v,\, \hat z_{0,\theta}^a) = G_\theta(z_t^v,\, z_t^a,\, t,\, c)$$虽然损失按模态分别计算,前向计算图是共享的:同一个 T2VA Transformer 接收配对 latent、共享条件与时间步嵌入。于是视频与音频的蒸馏梯度经由同一个跨模态 Transformer 反向传播,与对齐相关的交互被隐式优化。这是「联合蒸馏」与「两个模态损失简单相加」最本质的分野。
3.1 联合连续时间一致性(joint sCM)
对每个模态,教师与学生的干净预测被转换成 TrigFlow 场:
$$F_q^m = \frac{\cos(t)\, z_t^m - \hat z_{0,q}^m}{\sin(t)},\qquad q \in \{T, \theta\}$$其中 $F_T^m$ 定义教师轨迹,$F_\theta^m$ 是待优化的学生场。sCM 进一步要求沿配对教师方向计算学生场的联合 JVP:
$$J_\theta^m = c_t\left(\frac{\partial F_\theta^m}{\partial t} + \frac{\partial F_\theta^m}{\partial z_t^v}F_T^v + \frac{\partial F_\theta^m}{\partial z_t^a}F_T^a\right),\qquad c_t = \cos(t)\sin(t)$$由于这个 JVP 穿过同一个跨模态模型,视频的切向方向依赖音频 token,音频的切向方向也依赖视频 token。这正是联合 T2VA 蒸馏与独立模态损失的关键差异。sCM 方向定义为:
$$g_{\text{sCM}}^m = -\beta\frac{\cos(t)}{\sqrt{1-\gamma^2\sin^2(t)}}\big(\mathrm{sg}(F_\theta^m)-F_T^m\big) - \gamma\cos(t)\sin(t)z_t^m - J_\theta^m$$其中 $\beta$ 是一致性增强因子,$\gamma$ 是切向预热比例,$\mathrm{sg}(\cdot)$ 表示停止梯度。为了做到模态均衡,一致性方向对每个模态分别做 L2 归一化:
$$\bar g_{\text{sCM}}^m = \frac{g_{\text{sCM}}^m}{\lVert g_{\text{sCM}}^m\rVert_2 + \epsilon_{\text{sCM}}}$$范数按样本、在该模态所有 latent 元素上计算。定义 sCM 残差 $r_{\text{sCM}}^m = F_\theta^m - \mathrm{sg}(F_\theta^m) - \bar g_{\text{sCM}}^m$,联合损失为模态加权和:
$$\mathcal{L}_{\text{sCM}}^{\text{joint}} = \sum_{m\in M} w_m \lVert r_{\text{sCM}}^m\rVert_2^2$$这个目标把教师的配对视频-音频轨迹转移到少步学生上,同时保住视觉运动、声学演化、节奏结构与时间对应。
四、联合分布匹配:在稳定轨迹上再加一层质量锚
sCM 保住了教师轨迹,但少步生成仍可能损失感知质量,因此在学生学到稳定联合轨迹之后引入 DMD。给定学生生成的 on-policy 配对样本 $\hat z_0=(\hat z_0^v,\hat z_0^a)$,扰动到 $\hat z_t$,计算各模态的预测差异:
$$g_{\text{DMD}}^m = \hat z_{0,\text{fake}}^m(\hat z_t,t,c) - \hat z_{0,T}^m(\hat z_t,t,c)$$其中 $\hat z_{0,T}$ 是教师预测,$\hat z_{0,\text{fake}}$ 由在「学生生成样本」上训练的 fake-score 网络给出,而非生成器自身。在这种参数化下,该预测差异等价于分数差异;实践中教师预测用无分类器引导(CFG)计算,视频与音频可以使用不同的引导尺度。
与 sCM 不同,DMD 使用残差尺度归一化而不是 L2 归一化。对每个模态计算 $c_{\text{DMD}}^m = \frac{1}{N_m}\sum_{i\in m}|\hat z_{0,i}^m - \hat z_{0,T,i}^m|$,其中 $N_m$ 是该模态的 latent 元素数,归一化梯度为 $\bar g_{\text{DMD}}^m = g_{\text{DMD}}^m/(c_{\text{DMD}}^m+\epsilon_{\text{DMD}})$。DMD 残差 $\Delta_{\text{DMD}}^m = \hat z_0^m - \mathrm{sg}(\hat z_0^m - \bar g_{\text{DMD}}^m)$,并在 latent 元素上求和归约:
$$\mathcal{L}_{\text{DMD}}^{\text{joint}} = \sum_{m\in M} w_m \sum_{i \in m}\left(\Delta_{\text{DMD},i}^m\right)^2$$这种「求和而非求均」的归约保住了整个配对视频-音频 latent 上累积的分布匹配信号,使 DMD 在联合 sCM+DMD 优化中能提供足够强的教师分布锚;整体尺度仍由模态级梯度归一化、模态权重与外层系数 $\lambda_{\text{DMD}}$ 控制。重要的是,与「对视频和音频分别独立施加 DMD」不同,这一项来自同一学生在同一条件与同一时间步生成的配对样本,因此 DMD 在提升最终样本真实感的同时不会破坏联合 sCM 学到的跨模态结构。
4.1 模态均衡的联合优化
直接联合目标可能被单一模态主导,因为视频与音频 latent 的维度、时间分辨率与学习速度都不同。TurboT2VA 对两个目标都做模态级均衡,但用不同的归一化器:sCM 用 L2 方向归一化,DMD 用教师残差尺度归一化;再把归一化后的模态损失按权重 $w_m$ 组合。这种均衡只在损失层面施加,学生仍然作为单一统一 T2VA 生成器训练。当 sCM 与 DMD 一起优化时,两个目标复用同一 batch、同一文本条件与同一配对视频-音频 latent。最终联合目标:
$$\mathcal{L}_{\text{stage3}} = \lambda_{\text{sCM}}\mathcal{L}_{\text{sCM}}^{\text{joint}} + \lambda_{\text{DMD}}\mathcal{L}_{\text{DMD}}^{\text{joint}}$$sCM 项保住配对教师轨迹,在少步采样下支撑多样性与音画同步;DMD 项通过匹配教师分布改善最终样本质量;外层系数 $\lambda_{\text{sCM}}$ 与 $\lambda_{\text{DMD}}$ 控制轨迹一致性与分布级锚定之间的平衡。
4.2 LTX-2 的 TrigFlow 适配
LTX-2 骨干原本遵循 rectified-flow 的速度参数化,而 sCM 使用 TrigFlow 参数化。作者引入一个包装层,把 TrigFlow 的 latent 与时间步映射到 LTX-2 的 rectified-flow 接口:
$$z_{rf} = \frac{z_{trig}}{\cos(t)+\sin(t)},\qquad t_{rf} = \frac{\sin(t)}{\cos(t)+\sin(t)}$$该包装层让视频与音频预测暴露在统一的时间步接口下,并支持 JVP 穿过时间步嵌入、视频-音频 tokenization、位置嵌入与跨模态 Transformer。作者没有修改 LTX-2 骨干本身,而是调整训练接口,使联合 sCM 与 DMD 目标能在同一学生模型内施加到两个模态上。
五、三阶段渐进课程:先学轨迹,再提质量
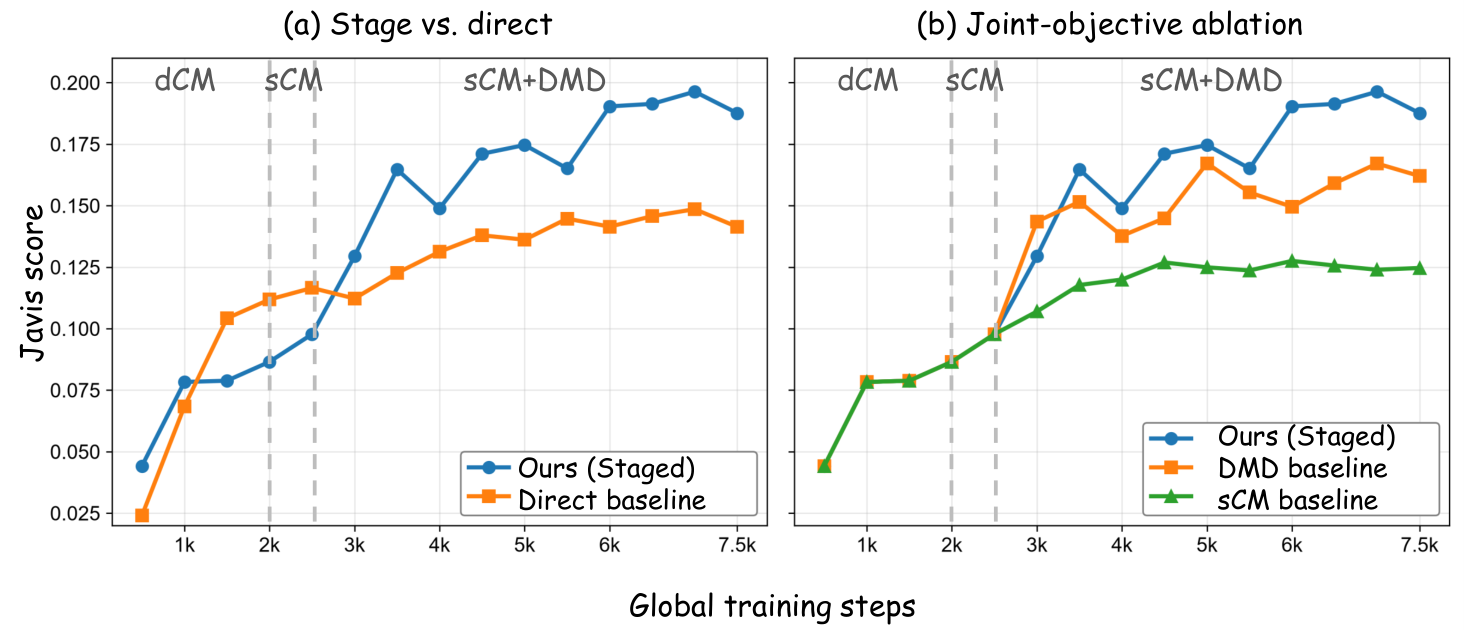
虽然直接做 sCM+DMD 训练是可行的,但作者发现轨迹学习与分布匹配的先后顺序会显著影响最终的质量-多样性权衡。他们先做了优化路径的实证比较:从基座初始化直接训练 sCM+DMD 是可行且能到达合理质量的,说明联合优化本身并不不稳定;但如论文图 7(a) 所示,分阶段路线在进入最后阶段后反超直接联合训练,并在共同的 7,500 步终点保持 Javis 分数优势。目标消融也显示:sCM 单独更好保住轨迹多样性与时间结构,但最终样本质量偏弱;DMD 强调感知质量却牺牲多样性;而把联合 sCM+DMD 推迟到 dCM 预热与 sCM 精炼之后引入,才能在视觉质量、音频保真、样本多样性与音画同步之间取得最强整体平衡。
为什么直接 sCM+DMD 次优? 原因在于两个目标角色不同却被过早耦合。sCM 把教师的生成轨迹转移给学生并鼓励跨噪声层级的一致性,有助于保住时间动态、运动演化、音频事件与跨模态对应;DMD 提供分布级锚点,通过匹配教师分布改善最终样本真实感。当 DMD 引入过早,分布级精炼可能鼓励学生在还未学到足够宽的轨迹先验前就去匹配「像教师的样本」——这不一定导致训练失败,但会削弱继承自教师轨迹的多样性。对 T2VA 而言影响尤其大,因为多样性不只体现在视觉外观,还体现在运动轨迹、节奏模式、声音事件与音画对应上。因此分阶段课程先建立多样且稳定的轨迹先验,再引入 DMD 提升感知质量。
三阶段课程把蒸馏分解为($\mathrm{Train}(\theta,L)$ 表示从参数 $\theta$ 出发按目标 $L$ 继续优化):
$$\theta_1 = \mathrm{Train}(\theta_0, \mathcal{L}_{\text{dCM}}),\quad \theta_2 = \mathrm{Train}(\theta_1, \mathcal{L}_{\text{sCM}}),\quad \theta_3 = \mathrm{Train}(\theta_2, \lambda_{\text{sCM}}\mathcal{L}_{\text{sCM}} + \lambda_{\text{DMD}}\mathcal{L}_{\text{DMD}})$$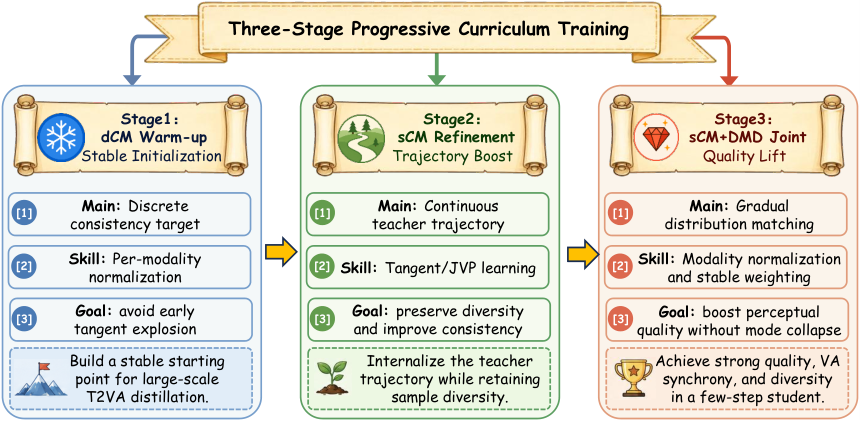
| 阶段 | 目标 | 核心机制 | 目的 |
|---|---|---|---|
| Stage 1:dCM 预热(2K 步) | 离散时间一致性 | 不需要连续时间切向估计,逐模态归一化 | 避免早期切向爆炸,为大规模 T2VA 蒸馏建立稳定起点(作为优化脚手架而非最终目标) |
| Stage 2:sCM 精炼(0.5K 步) | 连续教师轨迹 | 切向/JVP 学习 | 把学生从粗粒度离散热一致性升级到连续轨迹学习,忠实转移教师局部轨迹方向、保住多样性 |
| Stage 3:sCM+DMD 联合(4.5K 步) | 轨迹 + 分布 | 模态归一化与稳定加权、渐进分布匹配 | 在不模式崩塌的前提下提升感知质量,最终取得强质量、音画同步与多样性 |
这个提法强调:课程改变的是优化路径,而不是最终模型架构。dCM 由于不需要连续时间切向估计,数值上稳定得多,但它有限步的一致性目标仍受离散化误差影响、只是对连续教师轨迹的近似,所以只作脚手架用。预热赋予学生基本去噪能力、稳定的时间步条件与粗粒度的联合去噪先验;随后 sCM 取连续极限,绕过 dCM 的有限步目标近似,更忠实地转移教师局部轨迹方向;最后在轨迹覆盖足够后引入 DMD 做分布级精炼。
六、架构感知加速:压缩「每一步」的成本
少步蒸馏只减少 Transformer 评估的次数,并不减少每次评估的成本。在高分辨率下,每步成本成为主导——联合音视频 Transformer 包含长的模态特定 token 序列、异构的注意力路径与大尺寸前馈投影。直接把视频专用的推理栈套上去并不安全,因为异构注意力路径在序列长度、掩码与矩阵形状上各不相同。作者在 TurboDiffusion 的高效原语基础上,为 LTX-2 专门定制了一套架构感知推理栈,蒸馏完成后应用、无需重新训练学生,包含四个部分。
6.1 模态感知稀疏注意力调度
联合 Transformer 包含四条语义不同的注意力路径:视频自注意力、音频自注意力、双向视频-音频交互、掩码文本交叉注意力。对所有路径施加相同的近似会改变条件行为或违反稀疏核的前提假设。调度器按架构角色识别模块,只对未掩码的视频与音频自注意力路径应用 SageSLA;双向跨模态注意力与掩码文本交叉注意力保持稠密,从而保住显式的音画交换与文本条件。对选中的路径,适配器把原生 sequence-major 的 Q/K/V 张量转换成 SageSLA 需要的布局;查询相关的 block map 在层 $\ell$ 保留比例 $\rho_\ell$ 的 key 块,支持单一全局比例或逐层调度。在 H20 路径上,Q/K 量化为 INT8,value 聚合使用 FP8。为避免短音频序列上的退化行为,运行时比例取 $\tilde\rho_\ell=\max(\rho_\ell, 1/N_{blk})$,保证至少保留一个 key 块;结果再恢复成原联合 Transformer 布局。高分辨率配置对所有层使用 $\rho_\ell=0.3$,把近似集中在占据主要计算量的长自注意力序列上,而不假设视频与音频序列等长。
6.2 形状感知的 post-scale W8A8 线性算子
注意力稀疏化之后,前馈网络与注意力投影仍是大头。它们的矩阵形状在视频、音频与跨模态分支间各不相同,而逐块(blockwise)量化策略会在归约维度上反复应用 scale。作者改用 post-scale W8A8 算子:静态的逐输出通道权重量化 + 动态的逐行激活量化。对激活行 $x_i$ 与输出通道权重行 $w_j$:
$$\hat x_i = \mathrm{clip}(\mathrm{round}(x_i/s_i^x), -127, 127),\qquad \hat w_j = \mathrm{clip}(\mathrm{round}(w_j/s_j^w), -127, 127)$$ $$y_{ij} = s_i^x s_j^w \sum_k \hat x_{ik}\hat w_{jk} + b_j$$其中 $s_i^x=\max(\lVert x_i\rVert_\infty,\epsilon)/127$,$s_j^w=\max(\lVert w_j\rVert_\infty,\epsilon)/127$,$\epsilon=10^{-4}$。TileLang 核在整个归约维度 $K$ 上用 INT32 累加 INT8 乘积,然后在 epilogue 中一次性应用两个 scale 与偏置——避免用 tile 局部的重新缩放把归约切碎。当前的优化路径要求 CUDA BF16 输入且展平后的矩阵维度 $M,K,N$ 能被 128 整除;不支持的 dtype 或形状回退到保留 BF16 权重副本的原生 BF16 线性计算。此外,当 Q/K/V 投影共享同一输入时会做拼接,跨注意力中的 K/V 投影也拼接,减少冗余的激活量化与核启动。这种形状感知策略优先考虑安全覆盖,而不是强行把每个异构分支都塞进同一个量化核。
6.3 融合多模态 Transformer 操作
在注意力与线性算子被加速之后,访存受限的元素级操作在每步去噪中仍占不小比例。联合 Transformer 反复把归一化与模态/时间步相关的调制组合起来,随后做门控残差更新。作者替换了模块级的 RMSNorm 与 LayerNorm,并融合了重复出现的功能模式:调制式 RMS 归一化、自适应 scale-shift 调制、门控残差更新、输出调制与 split rotary 嵌入。每个融合核都带有 dtype、连续性、形状与掩码 guard;不支持的布局回退执行原实现。作者还消除了文本条件路径中的冗余计算:在 batch-size-one 推理时,共享文本掩码标出有效的 prompt token,视频与音频的条件嵌入被压缩到同一有效 token 集合,并在交叉注意力前移除 padding 掩码。与语义层面的 prompt 截断不同,这种变换只移除填充位置、不改动任何有效 token;batch 更大时该优化被禁用,因为不同 prompt 未必共享同一有效 token 模式。
6.4 默认推理配置
高分辨率 batch-one 推理下:对视频与音频自注意力应用 SageSLA($\rho_\ell=0.3$)、用 TileLang post-scale 后端量化所有兼容的生成器线性层、启用融合归一化与调制核、压缩填充文本上下文。在 1024×1792、121 帧设置下,视频 latent 形状为 $[1,16,128,32,56]$,对应 28,672 个视频自注意力 token。作者提醒:稀疏注意力是近似方法,当分辨率或 prompt 分布改变时应重新验证保留比例。
七、实验设置
训练配置。TurboT2VA 在 8 张 H20 GPU 上训练,训练集为 100K 条 512×768 分辨率、121 帧的文本-视频-音频样本,per-GPU batch size 为 1、有效 batch size 为 8。主 4 步学生遵循三阶段课程:2K 步 dCM 预热、0.5K 步 sCM 精炼、4.5K 步联合 sCM+DMD,合计 7K 优化步。主联合阶段使用 AdamW,学习率 $2\times10^{-5}$,$\beta_1=0.0$,$\beta_2=0.999$,权重衰减 0.01,sCM 与 DMD 权重相等;教师预测的视频与音频引导尺度分别为 3.0 与 5.0。训练使用 BF16 混合精度、梯度检查点与 FSDP,在 8 张 H20 上约 21 小时(不含评测与 checkpoint 扫描开销)。
标准分辨率评测协议。主学生对比、消融、训练曲线与采样步数分析都在同一 200-prompt 划分、512×768、121 帧下评测;多样性评测用同样 200 个 prompt、每 prompt 以不同随机种子生成 8 个样本。运行时间按每生成样本的平均纯推理时间计,排除模型加载与评测开销。指标包括 JavisBench(感知质量、文本语义一致性、视频-音频语义一致性、音画对齐)、VBench(视频保真)、TTA-Bench(音频质量)、MS-CLAP(文音对齐)与 ImageBind 余弦距离(多样性)。
高分辨率部署协议。在单张 NVIDIA H20、batch size 1、1024×1792、121 帧下单独剖析架构感知推理栈。除非特别说明,延迟指 generator-only 时间,排除 checkpoint 加载、解码、视频音频混合与磁盘 I/O;表 V 报告分组件延迟,系统对比中各阶段均为累计。两个分辨率档位互补:标准分辨率支撑全面的模型级对比与消融,高分辨率则更严苛地暴露大规模 Transformer 的计算瓶颈与架构感知加速的收益。
八、主要结果
8.1 生成质量(JavisBench,512×768)
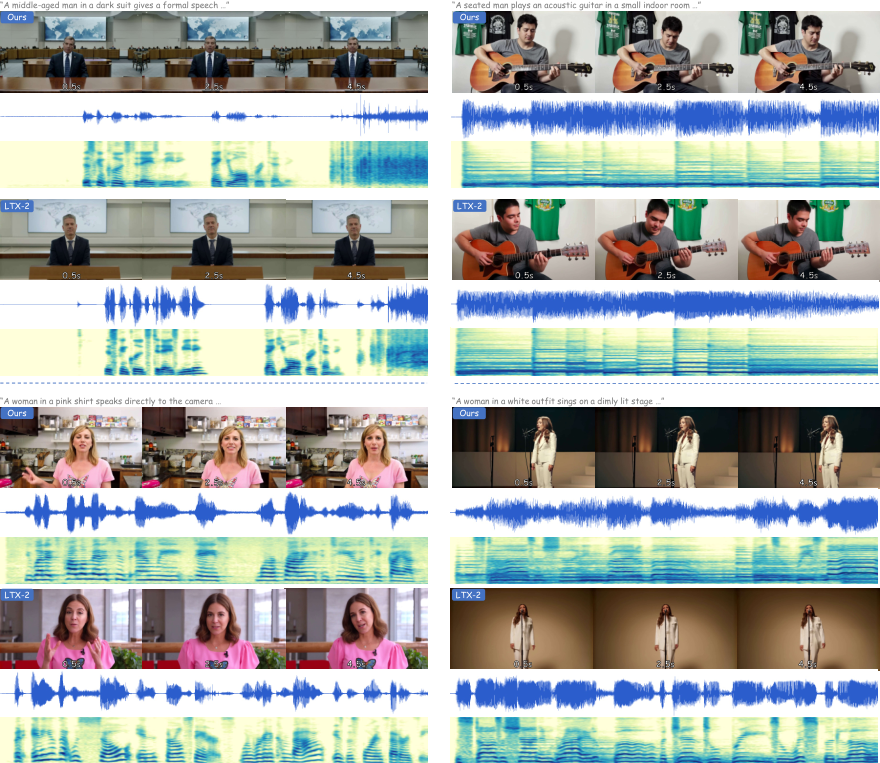
TurboT2VA 在推理效率与生成质量之间取得了很好的平衡。相比原始 40 步教师,TurboT2VA 把生成过程蒸馏为 4 步学生,在 512×768 下把平均推理时间从 50.52s 降到 2.51s,达到 20.1× 加速。尽管步数被激进压缩,TurboT2VA 在 JavisBench 上保持了与教师相当的总体生成质量,并在若干音视频质量与同步指标上取得更好的表现(Visual 2.389 vs 教师 1.968;Desync 0.388 vs 0.617)。与级联式、开源与闭源 T2VA 基线相比,TurboT2VA 在生成质量上有竞争力,同时比大多数多步系统快得多。
| 模型 | 规模 | 时间 (s) ↓ | Visual ↑ | Audio ↑ | Javis ↑ | Desync ↓ |
|---|---|---|---|---|---|---|
| Kling v3(闭源) | – | – | 3.478 | 5.499 | 0.210 | 0.907 |
| Sora 2(闭源) | – | – | 2.836 | 4.802 | 0.217 | 0.414 |
| Veo 3(闭源) | – | – | 4.221 | 5.534 | 0.326 | 0.336 |
| JavisDiT(开源) | 3.1B | 49.73 | 1.488 | 4.405 | 0.183 | 0.848 |
| OVI(开源) | 11B | 76.79 | 2.145 | 5.024 | 0.206 | 0.638 |
| DaVinci-MagiHuman(开源) | 15B | 6.70 | 0.854 | 5.245 | 0.181 | 0.730 |
| 教师(40 步) | 19B | 50.52 | 1.968 | 4.902 | 0.195 | 0.617 |
| TurboT2VA(4 步) | 19B | 2.51 | 2.389 | 4.486 | 0.1963 | 0.388 |
8.2 视频与音频保真度
视频保真(VBench):4 步学生在美学质量与成像质量上优于教师(美学 0.5519 vs 0.5286、成像 0.6520 vs 0.5884),运动平滑度(0.9911 vs 0.9919)、主体一致性(0.9614 vs 0.9592)与教师基本持平,时间闪烁略降(0.9773 vs 0.9844)但依然很强。
| 模型 | Aes. ↑ | Img. ↑ | Mot. ↑ | Subj. ↑ | Temp. ↑ |
|---|---|---|---|---|---|
| 教师(40 步) | 0.5286 | 0.5884 | 0.9919 | 0.9592 | 0.9844 |
| TurboT2VA(4 步) | 0.5519 | 0.6520 | 0.9911 | 0.9614 | 0.9773 |
音频保真(TTA-Bench + MS-CLAP):学生在内容可用性(6.334 vs 6.307)、制作质量(6.584 vs 6.577)上略优于教师,内容享受度(4.612 vs 4.765)、复杂度(2.964 vs 3.275)、音频美学均值(5.115 vs 5.231)与 MS-CLAP 文音相似度(0.347 vs 0.353)略低但都保持可比水平——说明蒸馏框架在把采样步数压到 4 步的同时,有效保住了音频生成能力。
| 模型 | Enjoy. ↑ | Useful. ↑ | Complex. ↑ | Prod. Qual. ↑ | Aes. Mean ↑ | MS-CLAP ↑ |
|---|---|---|---|---|---|---|
| 教师(40 步) | 4.765 | 6.307 | 3.275 | 6.577 | 5.231 | 0.353 |
| TurboT2VA(4 步) | 4.612 | 6.334 | 2.964 | 6.584 | 5.115 | 0.347 |
8.3 多样性评测
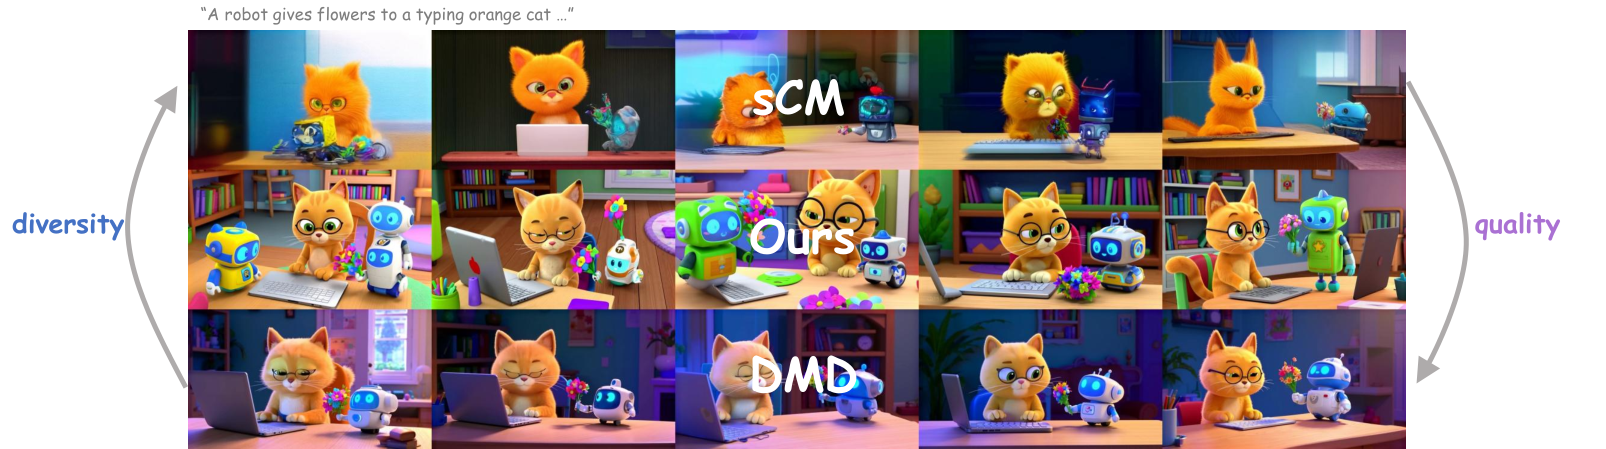
在固定文本条件下、每 prompt 用不同随机种子生成 8 个样本,视频与音频用固定的预训练 ImageBind 编码器编码,只计算同一 prompt 内样本的两两嵌入距离:每 prompt 有 $\binom{8}{2}=28$ 对,200 个 prompt 下每个模态共 5,600 对,最终多样性分数为 prompt 内平均距离。由于多样性本身不等于生成质量,作者在同一张表里报告 Javis 分数以呈现质量-多样性权衡。结果是:DMD-only 质量有竞争力(Javis 0.1812)但多样性最低(V-A 平均 0.2691);sCM-only 多样性最强(0.4032)但质量显著更低(0.1131);分阶段 sCM+DMD 取得更有利的平衡(Javis 0.1963,多样性 0.3259)。
| 模型 | Javis ↑ | 视频多样性 ↑ | 音频多样性 ↑ | V-A 平均多样性 ↑ |
|---|---|---|---|---|
| sCM-only | 0.1131 | 0.3026 | 0.5037 | 0.4032 |
| DMD-only | 0.1812 | 0.1821 | 0.3561 | 0.2691 |
| Ours(分阶段) | 0.1963 | 0.2322 | 0.4197 | 0.3259 |
论文图 5 给出受控的定性对照:三个变体接收同一 prompt 并用同一组随机种子采样。sCM-only 大幅改变主体与布局,但输出较难可靠保住请求的「猫-机器人交互」;DMD-only 产出精致的画面,但反复收敛到相似的居中构图;分阶段版本既保住了请求的交互,又保持了跨种子的可见变化(角色外观、机器人设计、场景布局)。这与表 IV 的多样性趋势一致。
8.4 高分辨率推理加速
在单张 NVIDIA H20、1024×1792、121 帧、batch size 1 下评测完整推理栈(各阶段累计、generator-only):稠密 40 步教师每样本需 318.74s;应用 W8A8 线性算子与融合操作降到 233.34s;在同样的算子栈下把教师轨迹换成 4 步 TurboT2VA 学生后降到 12.16s(相对稠密教师 26.20×);最后使用 $\rho=0.3$ 的模态感知 SageSLA 加填充文本压缩,延迟降到 5.83s,实现 54.67× 的整体 generator 加速。作为参照,未优化的 4 步学生在该分辨率下需 16.50s,因此架构感知栈在步数削减之外还额外贡献了 2.83×——证明模型级蒸馏与逐步推理优化是互补的。
| 配置(累计) | 延迟 (s) ↓ | 加速比 ↑ |
|---|---|---|
| 稠密 40 步教师 | 318.74 | 1.00× |
| + W8A8 线性算子 + 融合算子 | 233.34 | 1.37× |
| + 4 步 TurboT2VA 学生 | 12.16 | 26.20× |
| + SageSLA($\rho=0.3$) + 填充文本压缩 | 5.83 | 54.67× |
为分离各组件的贡献,作者进一步报告了分组件的高分辨率延迟(均基于同一 4 步学生,仅启用的推理组件不同):融合操作与 W8A8 各自把稠密 4 步生成器延迟从 16.50s 降到 13.77s 与 14.73s(1.20× 与 1.12×),两者结合进一步降到 12.16s(1.36×);稀疏注意力提供最大的单组件增益(单独启用即到 6.24s,2.65×);完整栈在 $\rho=0.3$ 下降到 5.83s(2.83×)。这些 generator-only 测量隔离了各推理组件的贡献。
作者还刻画了不同 SageSLA 保留比例 $\rho$ 下的速度-质量前沿(同一 4 步学生、评测 prompt、采样调度与随机种子):把 $\rho$ 从 0.5 降到 0.2,生成器延迟从 6.44s 降到 5.57s(对照稠密 4 步的 16.50s),而 Javis、AVH、CAVP、IB-AV 在所有保留比例下都接近高分辨率稠密参考。他们选择 $\rho=0.3$ 作为默认配置,因为它在延迟与跨模态对齐之间提供了更强的平衡——取得最佳 CAVP 分数(0.7985)以及比 $\rho=0.2$ 更低的失同步误差(0.4085 vs 0.4145);更激进的 $\rho=0.2$ 进一步降低延迟(5.57s),同时保持可比的整体音视频质量。
| 配置 | 生成 (s) ↓ | Javis ↑ | AVH ↑ | Desync ↓ | CAVP ↑ | IB-AV ↑ |
|---|---|---|---|---|---|---|
| 稠密 | 16.50 | 0.1948 | 0.2330 | 0.4275 | 0.7964 | 0.2370 |
| Full, $\rho=0.5$ | 6.44 | 0.1939 | 0.2287 | 0.3990 | 0.7974 | 0.2375 |
| Full, $\rho=0.4$ | 6.13 | 0.1901 | 0.2247 | 0.4080 | 0.7974 | 0.2345 |
| Full, $\rho=0.3$(默认) | 5.83 | 0.1914 | 0.2269 | 0.4085 | 0.7985 | 0.2348 |
| Full, $\rho=0.2$ | 5.57 | 0.1948 | 0.2305 | 0.4145 | 0.7971 | 0.2380 |
九、消融与采样步数
渐进预热的必要性。直接从基座优化 sCM 与 DMD 是可训练的,但拿不到最好的质量-多样性权衡:没有 dCM 预热与 sCM 精炼,学生会在还没获得足够结构化的少步生成轨迹前就同时接收轨迹级与分布级监督。相比之下,dCM 预热提供粗去噪初始化,sCM 精炼在引入 DMD 前进一步把学生对齐到连续教师轨迹。如论文图 7(a),分阶段课程在联合阶段开始后反超直接 sCM+DMD,并在 7,500 全局步内保持明显优势。
联合 sCM+DMD 的作用。在相同的 dCM+sCM 前缀下比较终点目标(图 7(b)):DMD 精炼在共享前缀之后提升很快,但趋于平台且低于联合目标;sCM-only 稳定却 Javis 分数明显更低;分阶段 sCM+DMD 达到最强的后期训练质量,在第 7,000 步峰值 0.1963,并在共同的 7,500 步终点保持领先。结合表 IV 的多样性结果,这些曲线说明联合一致性与分布匹配提供了更强的质量-多样性平衡(作者也说明这并不意味需要做细粒度的目标比例扫描)。
采样步数消融。生成质量总体随采样步数增加而提升:1 步推理的 Javis 仅 0.0663、Desync 0.6220;2 步达到合理水平(Javis 0.1576、Desync 0.3780);4 步在大多数指标上进一步提升(Javis 0.1963、Desync 0.3880),Visual 2.3892、Motion 0.8493、Audio 4.4860、CAVP 0.8033、IB-AV 0.2290 均为最佳。这给出了一个清晰的部署选择:2 步用于更极致的延迟,4 步用于质量优先。
| 步数 | Visual ↑ | Motion ↑ | Audio ↑ | CAVP ↑ | IB-AV ↑ | Javis ↑ | Desync ↓ |
|---|---|---|---|---|---|---|---|
| 1 | 2.0576 | 0.6680 | 4.0746 | 0.7955 | 0.0959 | 0.0663 | 0.6220 |
| 2 | 2.2328 | 0.7269 | 4.3416 | 0.7959 | 0.1915 | 0.1576 | 0.3780 |
| 4 | 2.3892 | 0.8493 | 4.4860 | 0.8033 | 0.2290 | 0.1963 | 0.3880 |
十、结论与意义
TurboT2VA 把分数正则化一致性蒸馏扩展到 19B 参数的联合音视频模型,处理了少步 T2VA 生成中的模态不均衡与质量-多样性权衡:模态均衡的目标在耦合的视频-音频骨干上保持端到端优化,渐进式 dCM→sCM→sCM+DMD 课程逐步引入轨迹级一致性与分布匹配监督——dCM 建立稳定的粗去噪初始化,sCM 学习连续教师轨迹,最后引入分布级监督。
在 JavisBench、VBench 以及模态特定的保真度与多样性基准上的实验表明,得到的 4 步学生在 512×768 下把生成器延迟从 50.52s 降到 2.51s(20.1×),同时保住有竞争力的视觉质量、音频保真、跨模态一致性与样本多样性。除采样步数削减之外,TurboT2VA 还引入由守卫式 W8A8 线性算子、融合多模态 Transformer 操作、填充文本压缩与模态感知稀疏注意力构成的架构感知推理栈(跨模态与文本条件注意力路径保持稠密),在 1024×1792 下单张 NVIDIA H20 把生成器延迟从 318.74s 降到 5.83s,达到 54.67× 的 generator-only 加速。
更一般地看,这些结果说明少步蒸馏与架构感知系统优化相结合,对大规模联合音视频生成模型的高效部署很有潜力:模型级与系统级改进同时减少 Transformer 评估次数和每次评估的计算成本,又保住了同步多模态生成所需的统一结构。对于关心「生成式世界模型/音视频基础模型能否真正落地」的读者,这篇工作给出了一个很有代表性的工程范式:蒸馏决定「跑几步」,推理栈决定「每步多贵」,二者正交、必须一起优化。代码与生成演示见 github.com/thu-ml/TurboDiffusion/tree/main/turbot2va。
参考资料
- Y. HaCohen et al., "LTX-2: Efficient joint audio-visual foundation model," arXiv:2601.03233, 2026.(教师模型)
- Y. Song, P. Dhariwal, M. Chen, I. Sutskever, "Consistency models," arXiv:2303.01469, 2023.(一致性模型)
- C. Lu, Y. Song, "Simplifying, stabilizing and scaling continuous-time consistency models," ICLR 2025.(sCM)
- T. Yin et al., "One-step diffusion with distribution matching distillation," CVPR 2024;"Improved distribution matching distillation for fast image synthesis," NeurIPS 2024.(DMD / DMD2)
- K. Zheng et al., "Large scale diffusion distillation via score-regularized continuous-time consistency," ICLR 2026.(rCM)
- J. Zhang et al., "TurboDiffusion: Accelerating video diffusion models by 100-200 times," arXiv:2512.16093, 2025.(高效推理原语)
- J. Zhang et al., "SageAttention: Accurate 8-bit attention for plug-and-play inference acceleration," ICLR 2025;"SLA: Beyond sparsity in diffusion transformers via fine-tunable sparse-linear attention," ICLR 2026.(稀疏注意力)
- Z. Huang et al., "VBench: Comprehensive benchmark suite for video generative models," CVPR 2024.(视频保真)
- H. Wang et al., "TTA-Bench: A comprehensive benchmark for evaluating text-to-audio models," AAAI 2026.(音频质量)
- B. Elizalde et al., "CLAP: Learning audio concepts from natural language supervision," ICASSP 2023.(文音对齐)
- R. Girdhar et al., "ImageBind: One embedding space to bind them all," CVPR 2023.(多样性度量)
- K. Liu et al., "JavisDiT: Joint audio-video diffusion transformer with hierarchical spatio-temporal prior synchronization," ICLR 2026.(JavisBench 评测)
原文:TurboT2VA: Fast Large-Scale Text-to-Video-Audio Generation via Score-Regularized Consistency Distillation(Xiaoda Yang, Yuxiang Liu 等,浙江大学 / 清华大学 / 天津大学 / 青岛大学 / 中国科学技术大学 / 腾讯 / 新加坡国立大学,arXiv:2608.24674v3)。本页为基于原文 PDF 全文精读整理的中文深度解读。