PAPER DEEP DIVE
ScientistTwo:用自主 AI 开拓人类知识前沿
Google Cloud AI Research 推出 ScientistTwo,一个全自动多智能体科研框架:人只给一个科学问题,AI 独立完成定位人类 SOTA 局限、提出新假设、实现代码、子集到全量实验、消融分析、模拟同行评审与 rebuttal 补实验的完整科研闭环,产出可发表论文与可复现代码库。在 ICLR/ICML/NeurIPS 录用的 107 篇论文上,改进 86 篇(80.4%),相对人类 SOTA 平均提升 25.2%;ScholarPeer 评分 7.5、接收率 91.9%,留出的 Stanford Agentic Reviewer 上 72.1% 达标(此前所有自主科研 agent 为 0%)。
一句话总结
ScientistTwo 是一个全自动多智能体科研框架:人只给一个科学问题,它自己找人类 SOTA 的局限、提新假设、写代码跑实验、做消融分析、模拟同行评审与 rebuttal 补实验,最后交出可发表的论文和完整可复现代码库。在 ICLR / ICML / NeurIPS 已录用的 107 篇人类论文上做测试,它改进了其中 86 篇(成功率 80.4%),相对人类 SOTA 平均提升 25.2%;生成的论文在 ScholarPeer 上拿下 7.5 分 / 91.9% 接收率,在留出的 Stanford Agentic Reviewer 上 72.1% 达标——而此前所有自主科研 agent 在这个留出评审器上的接收率全是 0%。
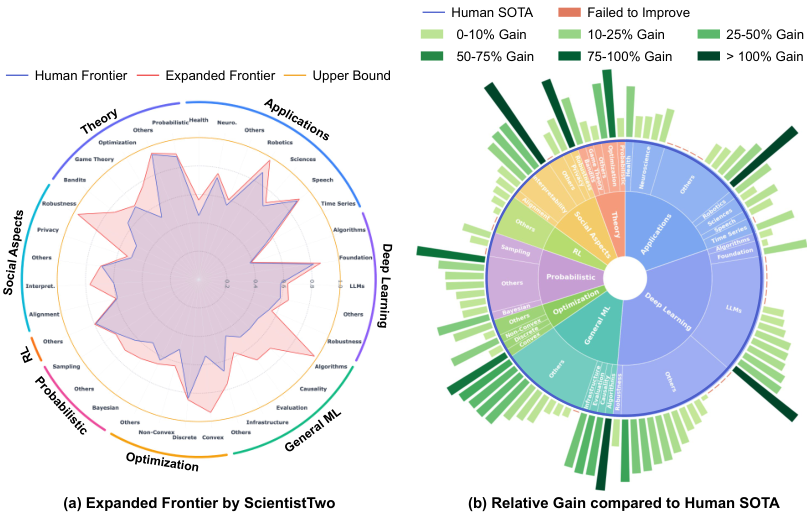
图 1:ScientistTwo 在 LLM、机器人、神经科学、语音、鲁棒性、强化学习、博弈论、隐私、优化、时间序列等多个研究领域推进人类知识前沿,产出的论文与代码库持续超越人类 SOTA 基线。
研究背景:从「辅助工具」到「自主科研」的鸿沟
科学发现的本质,是识别现有知识的边界并踏入无人区。随着基础模型的飞速进步,AI 正从被动的对话助手转变为科学进程的积极参与者。这一范式的最高野心是纯问题驱动的自主发现:人类研究者只需提出一个科学挑战,AI 自主地在人类知识版图中导航、诊断理论与经验瓶颈、提出新假设,并端到端地执行整个研究生命周期。
尽管自主科研 agent 已有不少进展,但自动化辅助系统与严谨的经验科学标准之间仍存在巨大鸿沟。现有系统主要聚焦于在孤立基准上优化单一标量指标,缺乏处理复杂科学问题所需的多维推理能力。更关键的是,它们缺少人类科学家那种「基于证据持续迭代」的闭环经验严谨性:既无法系统性地做消融实验来隔离因果机制,也无法参与动态的同行评审过程——而后者恰恰是验证想法、通过针对性补充实验回应方法论批评的核心环节。
为了对抗这些根本性挑战,ScientistTwo 提出了一个专家级的自主多智能体框架。它的验证方式堪称硬核:直接拿顶会已录用的人类竞争性强研究作为起点,要求 AI 独立发现超越既有 SOTA 的有意义的进展,同时证明这个自主发现过程是可测量、可复现、透明的。
方法:六个阶段的智能体协作生态
图 3:ScientistTwo 总览。利用先前的实验、消融研究与评审反馈生成并验证新想法,在多个数据集与指标上交叉验证,并模拟同行评审把草稿迭代打磨成可发表论文。
形式化地,给定科学问题 $\mathcal{G}$,框架产出论文 $\mathcal{P}^{+}$ 与可复现代码库 $\mathcal{C}^{+}$:
$$(\mathcal{P}^{+},\ \mathcal{C}^{+}) = \mathcal{A}(\mathcal{G}), \quad \text{其中} \quad \mathcal{A} = \{\mathcal{A}_1, \mathcal{A}_2, \dots, \mathcal{A}_{N_a}\}$$
这里 $\mathcal{A}$ 由 $N_a$ 个各司其职的专用智能体构成,覆盖局限提取、想法生成、代码修改、经验验证等不同阶段。整个流水线的每一阶段都遵循同一个抽象模式——生成候选 → 评审 → 接受或精炼(Listing 1 的伪代码):
图 4:各阶段的 Python 风格伪代码。每个阶段由 critic 智能体评估候选产物,接受则返回、拒绝则丢弃,否则依据反馈在最大轮数内迭代精炼。
阶段 1:生成新颖种子想法(定位局限)
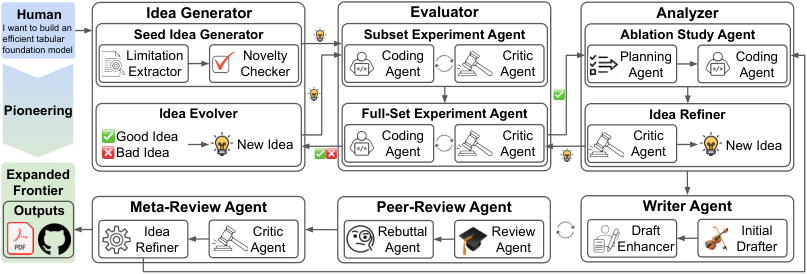
图 5:生成新颖种子想法。ScientistTwo 从识别人类 SOTA 的局限开始研究。
找局限。Limitation Extractor 从 $\mathcal{G}$ 中抽取一组局限,Limitation Verifier 验证这组局限是否足以指导对 $\mathcal{G}$ 的新颖改进。若认为不足,抽取器继续补齐缺失的局限或弱点并扩充集合——这个验证循环一直重复到 Verifier 确认所有可操作的局限都被彻底抽取,或达到最大迭代次数。
生成种子。先生成一个专门针对已识别局限的初始想法 $h_0$ 并用 Novelty Checker 计算新颖性分数。然后从候选集 $\mathcal{H}_0 = \{h_0\}$ 出发,由 Idea Generator 迭代扩充出差异化的高新颖性想法,直到收齐 $N_{\text{seed}}$ 个候选。最终按新颖性分数 $\{s_i\}_{i=0}^{N_{\text{seed}}-1}$ 降序排列,保证 $s_i \ge s_j$ whenever $i < j$——让最原创的想法优先被实现。
阶段 2:评估想法(子集到全集的漏斗)
为平衡计算效率,ScientistTwo 采用子集优先策略:先用 Baseline Coding Agent 在基准子集上复现 $\mathcal{G}$ 的主要实验,得到基线结果 $E_{\text{base}}$ 与可复现子集代码库 $C_{\text{base}}$;再由 Subset Coding Agent 通过修改 $C_{\text{base}}$ 实现候选想法 $h$,产出日志 $E^{\text{sub}}_h$。Subset Critic Agent 比较二者并给出三态判定 $d_h$ 与反馈 $r_h$:
- Bad:性能显著劣于基线,$h$ 被丢弃;
- Good:持续优于基线,批准扩容到全集验证;
- Engineer:有潜力但需调超参或改代码——由 Subset Engineering Agent 依策略 $r_h$ 精炼,循环直到 $d_h \in \{\text{Good}, \text{Bad}\}$ 或用尽 $N_{\text{eng}}$ 预算。若预算耗尽仍未达到 Good,则判为 Bad 剪枝——这模拟了真实科研中「无望方向在有限优化后被放弃」的实践。
通过验证的想法由 Full-Set Coding Agent 适配到完整基准,经 Full-Set Critic 与 Engineer 做最终验证。整个想法实验流水线被抽象为统一的高层接口 $\mathcal{A}_{\text{Coder}}$:
$$h,\ E^h,\ C^h,\ d_h,\ r_h = \mathcal{A}_{\text{Coder}}(\mathcal{G},\ h)$$
阶段 3:精炼想法(用执行轨迹做进化)
在初始轮次 $k=0$,执行 $\mathcal{H}_0$ 中前 $N_0$ 个种子想法得到执行轨迹集合 $\mathcal{R}_0$。对 $k \ge 1$ 的精炼轮,聚合全部历史轨迹 $\mathcal{R}_{<k}$ 由 Idea Evolver 生成 $N_k$ 个进化想法——它同时分析成功结果($d_h=\text{Good}$)与失败诊断日志($d_h=\text{Bad}$)来提出精炼假设。
探索与利用的平衡是关键设计:只依赖 Evolver 有把优化困在早期种子想法局部最优的风险,因此 ScientistTwo 用 $\mathcal{H}_0$ 中按新颖性降序取出的 $N_e$ 个未评估种子补充进化集,总候选池为 $\mathcal{I}_k \cup \mathcal{H}^{(k)}_0$。形式化地,第 $k$ 轮的执行为:
$$\mathcal{R}_k = \Big\{ (h, E^h, C^h, d_h, r_h) \ \big|\ (h, E^h, C^h, d_h, r_h) = \mathcal{A}_{\text{Coder}}(\mathcal{G}, h),\ h \in \mathcal{H}_k \Big\}$$
进化循环迭代直到收集到 $S$ 个成功想法或达到最大精炼轮数 $K$,终止条件为 $\sum_{i=0}^{k}\sum_{h \in \mathcal{H}_i} \mathbb{I}(d_h = \text{Good}) \ge S$。若到第 $K$ 轮仍是零成功,整个流程终止。最终由 Selector Agent 在所有全量验证通过的想法中挑出最优候选:
$$h_{\text{best}},\ E_{\text{best}},\ C_{\text{best}} = \mathcal{A}_{\text{Selector}}\Big(\mathcal{G},\ \big\{(h, E^h, C^h)\ \big|\ d_h = \text{Good}\big\}\Big)$$
阶段 4:消融研究(隔离增益来源并反哺想法)
Ablation Planner 自动为 $h_{\text{best}}$ 制定 $N_p$ 个可执行消融计划 $\{p_1, \dots, p_{N_p}\}$,Ablation Coding Agent 逐个修改 $C_{\text{best}}$ 执行,得到消融结果 $\mathcal{E}_{\text{abl}} = \{c_1, \dots, c_{N_p}\}$。
这里有个很「人类」的设计:消融不只是报告,而是反哺想法精炼。Ablation Critic 检查组件分解是否干净,输出 $d_{\text{abl}} \in \{\text{Good}, \text{Refine}\}$。若 Refine,则 Full-Set Engineering Agent 依批评 $r_{\text{abl}}$ 产出精炼假设 $h_{\text{new}}$。因为结构精炼并不保证性能提升,ScientistTwo 会用 Result Comparison Agent 严格验证 $\mathcal{E}_{\text{new}}$ 是否真的优于 $\mathcal{E}_{\text{best}}$——只有当严格更优时才更新核心状态 $(h_{\text{best}}, E_{\text{best}}, C_{\text{best}}) \leftarrow (h_{\text{new}}, E_{\text{new}}, C_{\text{new}})$,且一旦更新就重跑消融规划。该循环最多迭代 $N_{\text{abl}}$ 次。
阶段 5:撰写稿件(模拟同行评审与 rebuttal)
Initial Drafter(整合 PaperOrchestra)把 $h_{\text{best}}$、主基准结果 $E_{\text{best}}$、消融研究 $\mathcal{E}_{\text{abl}}$ 综合成会议格式的完整稿件 $\mathcal{P}_{\text{new}}$。随后进入模拟评审:Peer-Reviewer Agent(ScholarPeer)给出优缺点、针对性问题与 1–10 的 ICLR 评分 $s_{\text{review}}$。
若评分低于接收阈值(如 8),启动自动化 rebuttal:Rebuttal Planner 分析评审意见制定 $N_t$ 个补充实验任务 $\{t_1,\dots,t_{N_t}\}$,Rebuttal Coding Agent 基于 $C_{\text{best}}$ 实现并执行,产出补充结果 $\mathcal{E}_{\text{reb}}$;Paper Enhancer 把评审与补充发现整合回稿件,修订论点、更新实验表格与图片。该评审-rebuttal 循环重复直到 $s_{\text{new}} \ge 8$ 或用尽 $N_{\text{peer}}$ 预算。
阶段 6:元评审(终审与评审驱动的再精炼)
Meta-Review Agent 评估修订稿 $\mathcal{P}_{\text{new}}$ 与评审意见 $\mathcal{R}_{\text{new}}$,输出 $d_{\text{meta}} \in \{\text{Accept}, \text{Refine}\}$。若 Accept,导出终稿 $\mathcal{P}^{+} \leftarrow \mathcal{P}_{\text{new}}$ 与 $\mathcal{C}^{+} \leftarrow C_{\text{best}}$。
若 Refine——意味着元评审者识别出关键的算法或经验缺陷——则进入深度想法精炼:Full-Set Engineering Agent 依元批评 $r_{\text{meta}}$ 更新 $h_{\text{best}}$。同样地,只有当 Result Comparison Agent 验证 $\mathcal{E}_{\text{new}}$ 严格优于 $\mathcal{E}_{\text{best}}$ 时才更新核心状态;由于基础想法变了,下游的消融规划、消融执行、稿件重写与模拟评审全部重跑。反之则丢弃精炼、沿用此前最优输出。该元精炼循环最多 $N_{\text{meta}}$ 次。
实验结果
与自主科研 agent 的对比
| 框架 | # 论文 | ScholarPeer 均分 | 接收率 | Stanford 均分 | 接收率 |
|---|---|---|---|---|---|
| AI-Researcher | 7 | 1.0 ± 0.0 | 0.0 | 2.4 ± 0.6 | 0.0 |
| CycleResearcher | 6 | 1.0 ± 0.0 | 0.0 | 2.8 ± 1.0 | 0.0 |
| AI Scientist-v2 | 3 | 2.0 ± 1.0 | 0.0 | 2.5 ± 0.2 | 0.0 |
| AutoResearchClaw | 4 | 2.5 ± 1.0 | 0.0 | 3.7 ± 0.5 | 0.0 |
| Zochi | 2 | 3.0 ± 0.0 | 0.0 | 2.9 ± 0.6 | 0.0 |
| DeepScientist | 3 | 3.0 ± 0.0 | 0.0 | 4.1 ± 0.6 | 0.0 |
| ScientistOne | 21 | 3.8 ± 1.2 | 14.3 | 4.1 ± 0.7 | 0.0 |
| ScientistTwo | 86 | 7.5 ± 1.3 | 91.9 | 5.7 ± 0.6 | 72.1 |
最值得注意的是 Stanford Agentic Reviewer 这一列——它是开发与评估双方都未见过的留出评估器,此前所有基线的接收率一律为 0%,ScientistTwo 是唯一让 72.1% 的生成论文达到高接收标准的系统。定性对比上,ScientistOne 只产出 4 图 2 表(单一指标、孤立基准、基线有限),而 ScientistTwo 产出 9 图 12 表(含附录),跨多数据集多指标评估,基线对比充分。
与人类论文及 AI 生成论文的对比
| 来源 | # 论文 | ScholarPeer 均分 | 接收率 | Stanford 均分 | 接收率 |
|---|---|---|---|---|---|
| Agent4Science 2025 已录用† | 4 | 3.0 ± 0.0 | 0.0 | 3.8 ± 0.4 | 0.0 |
| ICLR 2026 已录用 | 5 | 6.8 ± 1.6 | 60.0 | 5.2 ± 0.7 | 60.0 |
| NeurIPS 2025 已录用 | 38 | 6.2 ± 1.9 | 65.8 | 5.5 ± 0.7 | 76.3 |
| ICML 2026 Spotlight | 64 | 6.9 ± 1.5 | 79.7 | 6.1 ± 0.5 | 96.9 |
| ScientistTwo(整体) | 86/107 | 7.5 ± 1.3 | 91.9 | 5.7 ± 0.6 | 72.1 |
†为 AI 生成论文。ScientistTwo 以对应会议的人类录用论文为输入,生成的论文在 ScholarPeer 上整体 7.5 分、91.9% 接收率,超过了 ICLR 2026(6.8/60.0%)与 NeurIPS 2025(6.2/65.8%)人类录用论文的水平;在留出的 Stanford 评审器上也达到 5.7 分,与人类论文同档(ICLR 5.2、NeurIPS 5.5)。
与 AutoSOTA 的对比也值得一提:AutoSOTA 在 105 篇上中位数提升 2.7%、平均 7.5%,ScientistTwo 在 86 篇上中位数 7.7%、平均 25.2%。作者把这个优势归因于范式差异——ScientistTwo 提出全新的方法论创新来克服基线局限,而 AutoSOTA 主要靠在既有超参与执行空间内搜索。附录对 5 篇 ICLR 论文的逐一检查支持了这一解释:AutoSOTA 的改动无一引入新算法组件,全是至多几行的配置级编辑。
消融研究
| 变体 | 评审轮次 | Rebuttal Agent | ScholarPeer 均分 | 接收率 | Stanford 均分 | 接收率 |
|---|---|---|---|---|---|---|
| ScientistOne | – | – | 3.8 ± 1.2 | 14.3 | 4.1 ± 0.7 | 0.0 |
| ScientistTwo(变体) | 0 | ✗ | 5.2 ± 2.2 | 46.9 | 5.6 ± 0.5 | 49.0 |
| ScientistTwo | 1 | ✓ | 6.9 ± 1.6 | 79.6 | 5.8 ± 0.6 | 73.5 |
| ScientistTwo | 2 | ✓ | 7.6 ± 1.0 | 93.9 | 5.7 ± 0.6 | 69.4 |
三个读数:其一,即便不做 rebuttal、只用 0 轮评审,ScientistTwo 初稿质量也显著超过 ScientistOne(46.9% vs 14.3% 接收率),说明前面的自主研究循环(整体基准推理、想法精炼、消融驱动假设优化)本身就非常有效;其二,评审-rebuttal 闭环把 ScholarPeer 分数从 5.2 推到 7.6,接收率从 46.9% 推到 93.9%;其三,重要的泛化发现是——虽然 ScientistTwo 用的是 ScholarPeer 的评审来打磨,但纳入评审反馈同时提升了留出评估器 Stanford Agentic Reviewer 的接收率(49.0% → 73.5%),说明这套评审模拟框架并非对单一评审器过拟合。
另一组消融考察想法进化:相对增益随迭代精炼稳步上升,但提升幅度在早期轮次最显著;同时被 Selector 选中的最优想法多数出现在早期——说明初始种子想法本身已经成型且具竞争力,而当种子想法收益边际或失败时,Idea Evolver 借助执行轨迹把它们进化成更强的假设(后期轮次中被选中的进化想法占比明显上升)。
评审驱动的想法精炼消融以 Kwon et al. (2026) 为输入,在 TOFU(forget10 split, Llama-3.2-1B-Instruct)上的机器遗忘表现:人类方法 Overall 0.705,ScientistTwo 变体(无元评审精炼)0.897,完整版(含元评审精炼)0.916,记忆/效用/隐私各项同步提升。完整性审计(Integrity Audit)显示:只有完整的精炼 agent 配置能在 49/49 篇上做到分数可验证、0 条规范违规、0 条幻觉引用,且论文方法与代码实现 49/49 对齐——缺少任一环节都会在这四项上出现漏洞。
意义与局限
(人类专家给定)"] --> B["① 局限提取 + 新颖性种子想法
Limitation Extractor / Verifier
Novelty Checker / Idea Generator"] B --> C["② 子集→全集漏斗评估
Baseline Coder → Subset Coder/Critic/Engineer
→ Full-Set Coder/Critic/Engineer"] C --> D["③ 想法进化 + 探索利用平衡
Idea Evolver + 未评估种子
→ Selector 选最优"] D --> E["④ 消融研究
Ablation Planner/Coder/Critic
增益来源隔离 + 反哺精炼"] E --> F["⑤ 稿件撰写 + 模拟评审 rebuttal
Initial Drafter → Peer Reviewer
→ Rebuttal Planner/Coder → Enhancer"] F --> G["⑥ 元评审终审
Meta-Reviewer: Accept / Refine"] G -->|Refine| D G -->|Accept| H["终稿 P+ + 可复现代码库 C+"]
ScientistTwo 的意义在于把「自主科研」的验收标准从「跑通流水线」抬高到「在留出评审器上达到顶会接收标准、且产出可复现代码库」。它的设计有几个可迁移的工程要点:子集优先的算力分配(先在代表性切片上快速过滤,再给有希望的想法投喂全量算力);把失败轨迹当作进化信号(Evolver 同时读成功与失败日志);严格更优才更新状态(Result Comparison Agent 守门,避免反馈循环里的性能回退被当成改进);以及评审反馈的双重用途(既提升稿件分数,也驱动算法层面的再精炼)。
局限方面,论文以实验与消融为主展开,从设计上可以看到几点边界:系统依赖 ScholarPeer 作为评审信号之一,虽然留出评估器实验证明了泛化性,但评审器本身的偏好仍会传导进优化目标;107 个科学问题全部来自机器学习顶会,向自然科学(湿实验、真实世界交互)的迁移尚未验证;错误处理与预算控制($N_{\text{eng}}$、$N_{\text{abl}}$、$N_{\text{peer}}$、$N_{\text{meta}}$ 等上限)保证流程可终止,但也意味着在难题上可能因预算耗尽而错过需要更长探索周期的方案。