PAPER DEEP DIVE
SoL-Pi:高效智能体执行框架的递归自主研究
SoL-Pi 将智能体执行框架改进转化为规模化自主研究,筛选出四项可复用效率机制,在性能接近基线时将令牌流量降低 44.7% 至 49.0%。
论文信息:Haozhe Liu、Tian Ye、Sensen Gao、Qihang Cao、Yitong Li、Mingchen Zhuge、Duomin Wang、Ruihua Zhang、Ping Luo、Jiawang Bian、Lei Zhu、Ligeng Zhu、Enze Xie、Song Han。论文于 2026 年 9 月 17 日发布,arXiv 地址为 https://arxiv.org/abs/2609.20519,代码仓库为 NVlabs/SoL-Pi,项目页为 nvlabs.github.io/SoL-Pi。
一句话总结:SoL-Pi 把“让智能体执行框架更省令牌”改造成一个规模化自主研究问题,在数百个可执行环境中进行独立搜索、能力门控与效率门控,最终得到动作融合、在线上下文压缩、观测打包和证据保留式归约四项可以组合、可以跨模型迁移的机制。
研究背景与动机
编码智能体正在从“给定局部上下文,补全一段代码”转向“在较少监督下长时间运行”。一次任务不再只有一次模型预测,而是包含连续推理、文件修改、命令执行、错误读取、再次修改和最终验证。随着轨迹变长,输入、缓存读取、缓存写入和输出四类令牌都会累积。模型推理成本只是问题的一部分,真正放大成本的是执行框架如何在模型和环境之间来回传递状态。
现有效率研究通常从模型和基础设施入手,例如更快的注意力内核、推理服务优化、量化或选择更便宜的模型。SoL-Pi 选择的是一条正交路线:底层模型保持不变,只改变智能体执行框架。执行框架决定工具如何暴露、上下文如何组织、工具输出如何回传、子任务如何压缩、何时委派读取。它不训练模型,却可以直接改变长任务的令牌轨迹。
问题在于,手工优化执行框架非常困难。工具调用、上下文管理、验证、委派、恢复和终止逻辑彼此耦合。一个局部看似有效的改动,可能把成本推迟到后续步骤,也可能破坏模型获取关键证据的路径。研究者需要反复阅读很长的执行记录,定位重复开销,再把观察结果翻译为代码修改。这种流程不仅昂贵,而且难以扩展到大量环境和模型后端。
论文借鉴递归自我改进的思路,让一个研究智能体观察另一个智能体在基础执行框架上的运行轨迹,自动提出候选机制,并在准备好的环境中实验。这里的关键不是让模型直接改写自己的参数,而是让研究循环改写模型外部的执行框架。模型仍然是独立资产,执行框架成为可搜索、可验证、可组合的系统层产物。
自动搜索很容易陷入两个陷阱。第一个陷阱是只在一个环境里有效,换到未见任务便失效。第二个陷阱是验证集结果反馈回搜索过程,导致候选方案逐渐针对测试任务打补丁。SoL-Pi 用广度和深度同时处理这两个问题:广度增加假设覆盖面,深度对少量方向反复实现和审查;同时冻结评估边界,让最终验证结果永远不能回流到搜索。
从假设池到四项保留机制
搜索从 152 个候选方向开始,覆盖上下文、进度、工具、委派、提示与策略、改进与评估六个提案家族。提案家族表示假设来自哪一种观察,不限制最终改动落在哪个系统层。例如 ObservationPack 的灵感来自上下文假设,最终却修改了工具观测进入模型上下文时的投影边界。
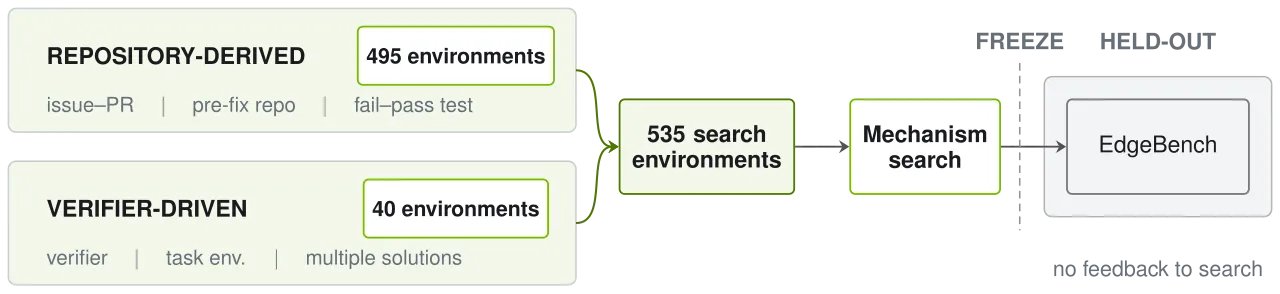
搜索引擎使用 535 个可执行环境。其中 495 个来自 GitHub issue 与 pull request 配对。每个环境保存修复前仓库、离线依赖和隐藏回归测试;只有“打补丁前测试失败、打补丁后测试通过”的任务才会被保留。另外 40 个任务先构造可执行验证器,再围绕验证器生成环境,使同一问题允许多条正确解决路径。
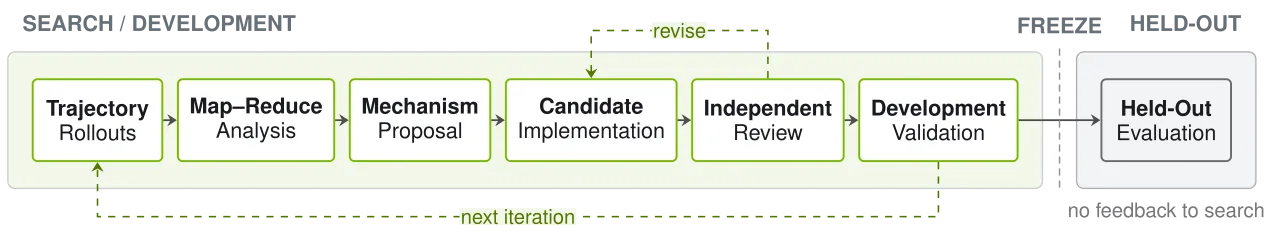
每条搜索线独立运行,采用一个简化自主研究循环:提出假设、实现候选、运行固定实验、检查结果,然后保留、修改或丢弃。实现者经过基于 Ralph Loop 的迭代,把候选推进到明确的完成标准;独立审查者检查后再进入开发评估。搜索线之间互不共享可变编排代码,失败不会污染其他候选。
每个候选必须服从固定的能力容忍度和效率指标。论文没有让优化智能体自行改变验收标准,而是预先冻结指标与容忍度,再按顺序检查候选。这样,候选不能通过修改评分规则来“获胜”。
令基础执行框架的聚合任务得分为 $S_0$,候选得分为 $S_c$,允许得能力下降幅度为 $\tau_c$,基础令牌成本为 $C_0$,候选成本为 $C_c$。候选至少要满足:
$$ \operatorname{CapabilityPass}(c)=\left(S_c \ge S_0-\tau_c\right) $$
$$ \operatorname{EfficiencyPass}(c)=\left(C_c < C_0\right) $$
只有两个门都通过的候选才进入非支配筛选。这里的“更高效”不是一个模糊目标,而是一个预先声明的成本或令牌指标。最终搜索得到四项互补机制,它们分别处理动作执行、上下文管理、观测存储和委派阅读。
flowchart LR
    A[Base Harness Trajectories] --> B[Oracle Analysis]
    B --> C[Broad Idea Pool]
    C --> D[Isolated Search Lineages]
    D --> E[Implement Candidate]
    E --> F[Independent Review]
    F --> G[Capability Gate]
    G --> H[Efficiency Gate]
    H --> I[Nondominated Candidates]
    I --> J[Integrate Four Mechanisms]
    J --> K[Freeze Harness]
    K --> L[EdgeBench Held_out]
    L -. results never return .-> K
图 1:SoL-Pi 的规模化自主研究与冻结评估路径。图源:论文 Figure 1。
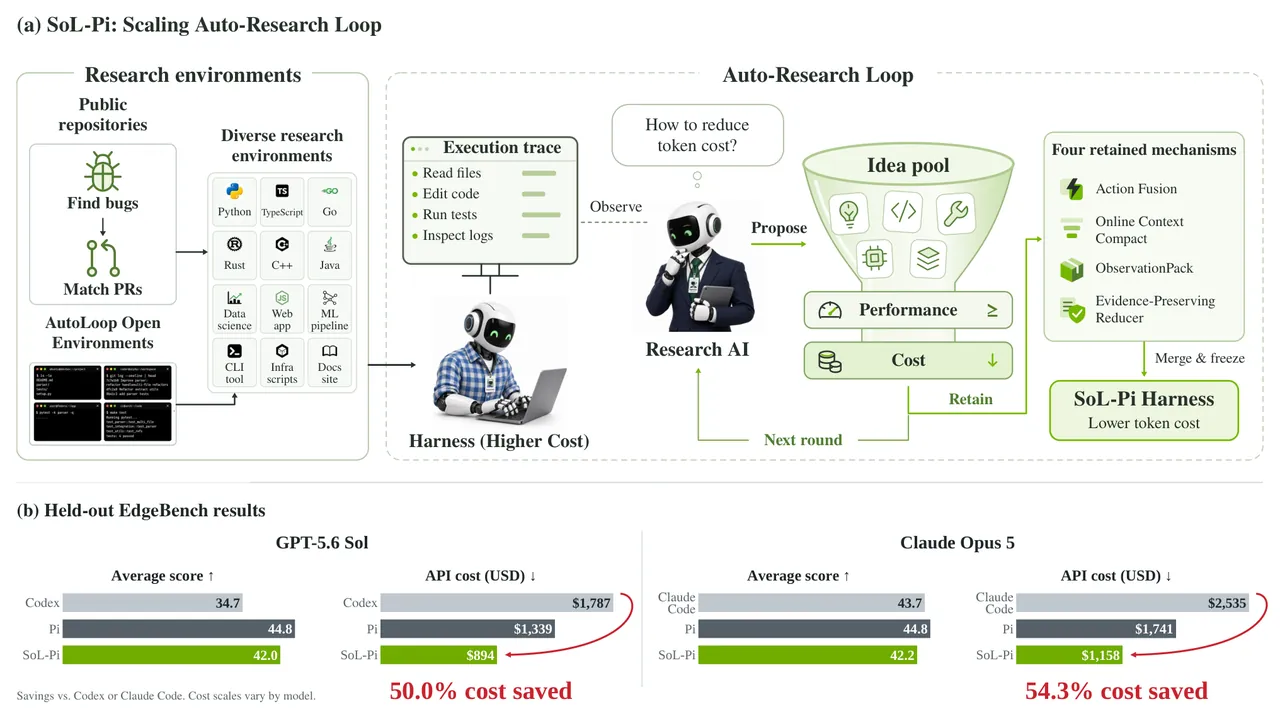
图 2:开发反馈与留出评估被严格隔离,搜索产生的候选只有在冻结后才能进入最终测试。图源:论文 Figure 2。
搜索环境为何分成两类
仓库派生环境提供真实软件变更信号。它把 issue 与修复前仓库配对,使用被接受的补丁和变更历史作为参考轨迹,但不向智能体暴露 pull request 和回归测试。这类环境的验证条件明确,适合发现与真实开发过程有关的重复动作和上下文开销。
验证器驱动环境提供更宽的解空间。系统先生成可执行成功判据,再构造任务环境,因此候选不必模仿某一条参考补丁,可以走不同路径达到相同可验证结果。40 个合成任务主要采用 Terminal-Bench 2 风格的验证器接口,使搜索不至于只学习 GitHub 历史中的模式。
两类环境都只用于机制发现。EdgeBench 不参与候选开发。51 个公开任务中,11 个只用于冻结候选的单向接收测试,剩余 40 个用于泛化评估。论文明确写道,留出评估失败只会拒绝候选,不会触发新的针对性优化。
图 3:仓库派生环境和验证器环境共同支持机制搜索,EdgeBench 始终隔离在搜索边界之外。图源:论文 Figure 3。
四项机制分别消除了哪类重复
Action Fusion:把“修改后验证”压成一个模型回合
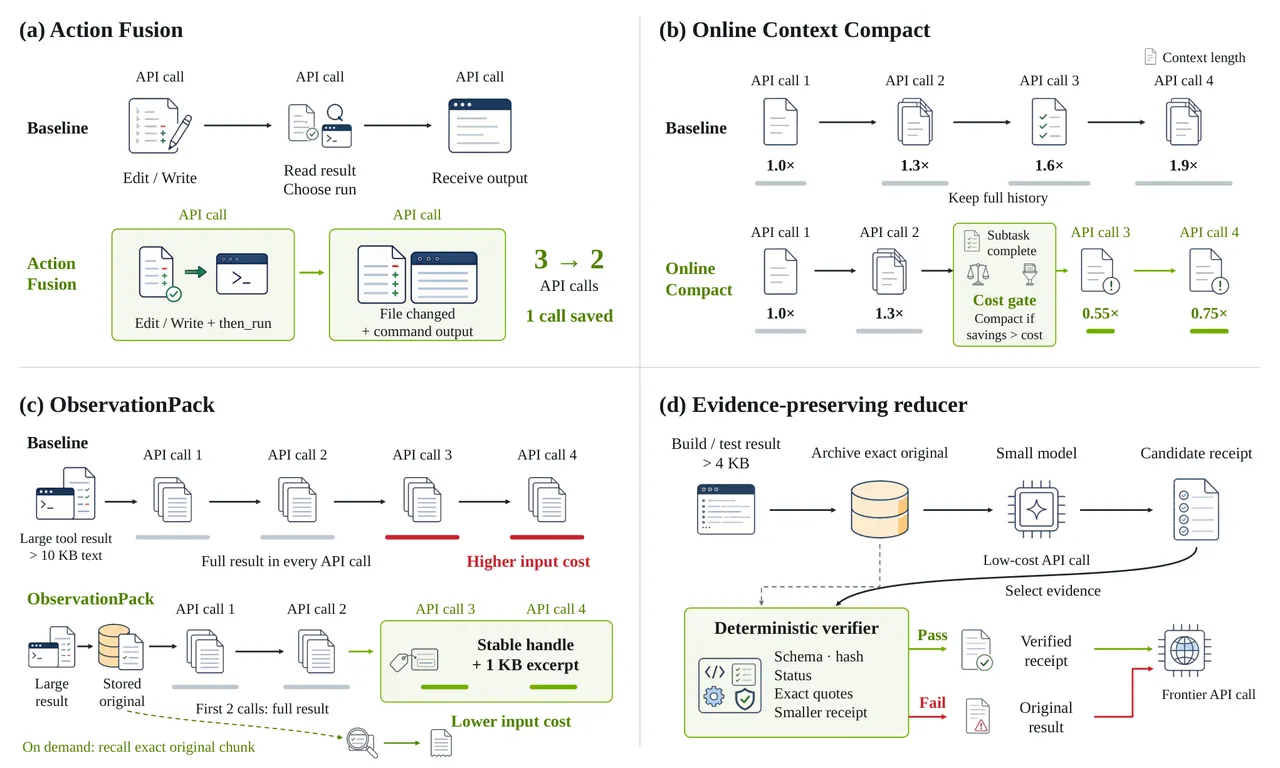
基础智能体经常先调用 edit 或 write,再在下一回合调用 shell 执行测试、构建或启动命令。两次工具调用之间本来需要一次模型决策,但命令在许多情况下是确定性的。Action Fusion 将文件修改工具扩展为可以同时接收 then_run 参数:修改成功后立即执行指定命令,并把修改结果和命令结果合并成一个观测返回。
机制只消除固定的中间模型回合,并不跳过验证。如果修改失败,后续命令不会运行;如果修改后的文件在命令启动前发生变化,实现会用 SHA-256 再次核对文件内容并取消命令,避免并发写入导致“验证的是另一个版本”。需要先观察修改结果再决定命令的场景仍保持两次调用。
在理想触发条件下,论文的执行链分析估计该机制可以降低约 11.5% 的令牌。最终单机制评估中,它在 EdgeBench / GPT-5.6 Sol 上把总令牌从 2.1538 B 降到 1.8968 B,平均分从 44.833 提高到 46.664;在 Opus 5 上,它是得分最高的单机制配置,把平均分从 44.756 提高到 50.482。
Online Context Compact:在子任务边界判断压缩是否划算
上下文压缩并非越早越好。压缩会缩短后续输入,但会改写提示缓存前缀,带来新的缓存写入成本。Online Context Compact 把 plan-step 完成事件作为候选压缩点。它观察已完成的计划边界之间平均消耗了多少次模型请求,再乘以剩余计划步骤数,估计未来请求数量。
如果上下文增长速度已知,系统还会用当前窗口剩余空间除以平均上下文增量,得到窗口保护上界。最终 horizon 估计取两者较小值:
$$ \widehat H=\min\left(1+\left\lfloor \bar r\,N_{\mathrm{rem}}\,s \right\rfloor,\left\lfloor\frac{W-x}{\Delta x}\right\rfloor\right) $$
其中 $\bar r$ 是每个计划边界消耗的请求数均值,$N_{\mathrm{rem}}$ 是剩余步骤,$s$ 是请求尺度,$W$ 是上下文窗口,$x$ 是当前上下文令牌数,$\Delta x$ 是平均增量。这个公式把“还剩多少步”和“窗口还能容纳多少请求”合并成一个保守未来长度。
压缩收益来自归档令牌与摘要令牌之差 $A-M$。改写缓存前缀的额外成本由当前写入规模 $W_c$ 和缓存写读价格比 $R$ 决定。令增量缓存成本比为 $R-1$,则回本所需请求数为:
$$ B=\frac{W_c(R-1)}{A-M} $$
只有在 $B\le\widehat H$ 时,首次压缩才可能通过经济门。后续压缩还要满足 $1.5B\le\widehat H$,并把之前压缩尚未回收的成本计入负债。若上下文逼近窗口上限且压缩确实能缩短上下文,则窗口保护优先于经济门。
ObservationPack:第一次保留原文,第三次开始只给句柄和摘录
长工具输出会被后续多次请求重复携带,即使其中大部分内容已经不再影响下一步决策。ObservationPack 对超过 10 KiB 的纯文本工具结果建立本地归档。前两次 provider 请求仍发送完整内容,从第三次开始,将原始结果替换为稳定句柄、原始字节数、行数、令牌估计以及首尾完整行摘录。
投影规则可以写成:
$$ x_i'=\begin{cases}x_i,&q_i<2\\ \operatorname{Pack}(x_i),&q_i\ge2\end{cases} $$
其中 $q_i$ 是结果 $x_i$ 之前已经进入 provider 请求的次数。Pack 不修改会话历史,只在上下文投影层替换消息副本,因此原始会话、恢复和原生压缩之后仍可工作。模型需要细节时调用 obs_recall,以字节偏移分页获取原始内容,每次上限约 16 KiB、400 行。
该机制修复的是“信息仍可访问,但不必在每个请求里重复付费”的问题。它在 GPT-5.6 Sol 单机制测试中取得最高平均分 47.208,同时把总令牌降到 2.0224 B;在 Opus 5 上把总令牌从 2.3697 B 降到 1.4418 B。
Evidence-Preserving Reducer:允许摘要,但不允许无法验证的摘要
构建和测试日志通常很长,真正改变下一步决策的只有少量失败行。Evidence-Preserving Reducer 只处理至少 4 KiB、来自预定义诊断命令的工具结果。它先保存原始日志,再请求较低成本模型提取证据,形成紧凑 receipt。文件读取和搜索结果不进入该路径。
模型输出不能直接被信任。确定性验证器检查 schema、来源 SHA-256、退出状态、引文是否逐字节存在于归档、引文长度和 receipt 大小。形式化地,只有满足下列条件的引文才会被接受:
$$ \forall e\in E_{\mathrm{receipt}},\quad e_{\mathrm{quote}}\in \operatorname{bytes}(o_{\mathrm{archive}})\land h(e_{\mathrm{quote}})=h_{\mathrm{claimed}} $$
如果验证失败、疑似出现凭据、模型调用失败,或 receipt 没有比原文更小,系统回退到完整日志。失败日志如果包含失败信号,receipt 还必须保留 fatal 或 failure 证据。该机制不允许辅助模型诊断修复或决定通过与否,主智能体继续负责判断、修改和重跑。
执行顺序也很关键:Reducer 先处理工具结果,ObservationPack 再执行上下文投影。ObservationPack 发现 reducer receipt 前缀后会跳过该结果,避免把已经验证过的证据再次替换成普通首尾摘录。
图 4:四项机制分别位于动作执行、上下文压缩、观测处理和委派阅读路径,并保留明确的回退边界。图源:论文 Figure 4。
开源代码如何对应论文机制
公开仓库以 Pi 的独立扩展实现四项机制,不修改 Pi 源码。核心代码分开放在 action-fusion、online-context-compact、observation-pack 和 evidence-preserving-reducer 四组目录中。配置默认全部关闭,用户明确启用后机制才会参与运行。
Action Fusion 的论文描述与源码可以逐行对应。注册代码继承 Pi 原生 edit 和 write 工具,再扩展 then_run 字段;执行函数先完成修改,再调用完整性与并发检查,最后运行命令并返回组合观测:
// src/sol-pi/extensions/action-fusion/index.ts
const editParameters = Type.Object({
  ...editTemplate.parameters.properties,
  then_run: createThenRunSchema(EDIT_THEN_RUN_DESCRIPTION),
});

async execute(toolCallId, input, signal, onUpdate, ctx) {
  const { then_run, ...editInput } = input;
  return executeMutationThenRun({
    absolutePath: resolveToolPath(ctx.cwd, input.path),
    thenRun: then_run,
    mutate: () => baseEdit(ctx.cwd).execute(
      toolCallId, editInput, signal, onUpdate, ctx
    ),
  });
}
文件队列代码进一步把同一路径的融合操作串行化,并在命令运行前比较修改后和命令前两个文件哈希。这说明论文中的“编辑后运行”不是简化的流程拼接,而是尝试维护文件状态一致性。
Online Context Compact 的代码更直接地展示了经济门。实现从已完成计划边界的请求数估计未来 horizon,计算压缩收益、缓存改写增量成本和回本请求数,再决定 economic、window_protection 或 defer:
// src/sol-pi/extensions/online-context-compact/economics.ts
const savingTokens = input.archiveTokens - input.memoTokens;
const incrementalCacheCostRatio =
  input.cacheWriteReadRatio === null
    ? null
    : Math.max(0, input.cacheWriteReadRatio - 1);
const breakevenRequests =
  savingTokens > 0 && incrementalCacheCostRatio !== null
    ? (input.writeTokens * incrementalCacheCostRatio) / savingTokens
    : null;

const windowProtection =
  input.contextTokens >= input.contextWindowTokens - windowReserveTokens;
const economic =
  breakevenRequests <= horizon.expectedRemainingRequests;
Reducer 的实现同样能验证论文的核心主张。它先归档原文,再让配置模型生成 JSON receipt,逐项检查 source hash 和引文包含关系;如果 receipt 不小于原文,也直接回退。
// src/sol-pi/extensions/evidence-preserving-reducer/receipt.ts
if (
  parsed.schema !== REDUCER_RECEIPT_SCHEMA ||
  parsed.source_sha256 !== archive.hash ||
  parsed.status !== expectedStatus ||
  !body.includes(quote)
) return { ok: false, reason: "schema-mismatch" };

if (receiptBytes >= archive.bytes) {
  return undefined; // keep the original result
}
仓库中 ObservationPack 的实现将阈值定义为 10 KiB、完整发送次数定义为 2、摘录预算定义为 1 KiB,并注册 obs_recall 分页读取工具。四个机制的代码常量、回退条件和论文描述一致,说明论文并非只给出高层概念而缺少可复现实现。
实验结果与成本变化
论文首先在 EdgeBench 的 51 个公开任务上比较 Codex、Pi、SoL-Pi 效率配置和 SoL-Pi 性能配置。实验价格为 2026 年 8 月 17 日的 API 价格。效率配置固定组合四项机制,性能配置则为每个模型选择平均分最高的单机制。
| 配置 | 总令牌(B) | 成本(美元) | 平均分 | 成本/分 |
|---|---|---|---|---|
| Codex / GPT-5.6 Sol | 3.0537 | 1,787 | 34.738 | 1.0086 |
| Pi / GPT-5.6 Sol | 2.1538 | 1,339 | 44.833 | 0.5855 |
| SoL-Pi 效率 / GPT-5.6 Sol | 1.0990 | 894 | 42.003 | 0.4174 |
| SoL-Pi 性能 / GPT-5.6 Sol | 2.0224 | 1,271 | 47.208 | 0.5280 |
| Pi / Opus 5 | 2.3697 | 1,741 | 44.756 | 0.7625 |
| SoL-Pi 效率 / Opus 5 | 1.3101 | 1,158 | 42.224 | 0.5376 |
| SoL-Pi 性能 / Opus 5 | 2.1016 | 1,605 | 50.482 | 0.6235 |
在 GPT-5.6 Sol 上,效率配置对 Pi 保留 93.7% 的平均分,却把总令牌从 2.1538 B 降到 1.0990 B,下降 49.0%,成本下降 33.2%。性能配置则把平均分从 44.833 提高到 47.208,同时将总令牌降低 6.1%、成本/分降低 9.8%。这说明同一个搜索过程可以产出两种不同操作点,而不是只优化一个固定目标。
跨后端迁移是论文最强的系统层证据之一。SoL-Pi 只在 GPT-5.6 Sol 轨迹上搜索,随后直接用于 Opus 5,不重新搜索也不适配。Opus 5 上效率配置保留 Pi 平均分的 94.3%,总令牌下降 44.7%,API 成本下降 33.5%。不过机制在 Opus 上触发率和触发强度更低,说明跨后端迁移存在,但触发分布并未完全一致。
在 63 个 CPU-only Terminal-Bench 4 任务中,Codex 和 Pi 各解决 18 项,SoL-Pi 解决 15 项;但 SoL-Pi 的总成本为 211.12 美元,比 Pi 的 286.45 美元低 26.3%,每题解决成本从 15.91 美元降到 14.07 美元。这个结果不支持“所有能力指标都提高”的结论,而是说明效率配置在部分困难任务上牺牲了完成率,换取了更低总成本。
| 执行框架 | Terminal-Bench 4 解决数/63 | 总成本 | 每题成本 | IMO 2026 通过数/6 | IMO 总成本 |
|---|---|---|---|---|---|
| Codex | 18 | $272.35 | $15.13 | 5 | $114.47 |
| Pi | 18 | $286.45 | $15.91 | 3 | $75.95 |
| SoL-Pi | 15 | $211.12 | $14.07 | 3 | $62.69 |
在 IMO 2026 上,三种执行框架都使用 GPT-5.6 Sol 的 xhigh 设置,并要求答案经过 Lean 4 验证。Codex、Pi 和 SoL-Pi 分别通过 5、3、3 题。SoL-Pi 的通过数与 Pi 持平,但总成本从 75.95 美元降到 62.69 美元,每通过一题的成本从 25.32 美元降到 20.90 美元,仍高于 Codex 的 22.89 美元。这个细节表明效率优化并不自动等同于能力提升,成本优势也需要和目标质量一起判断。
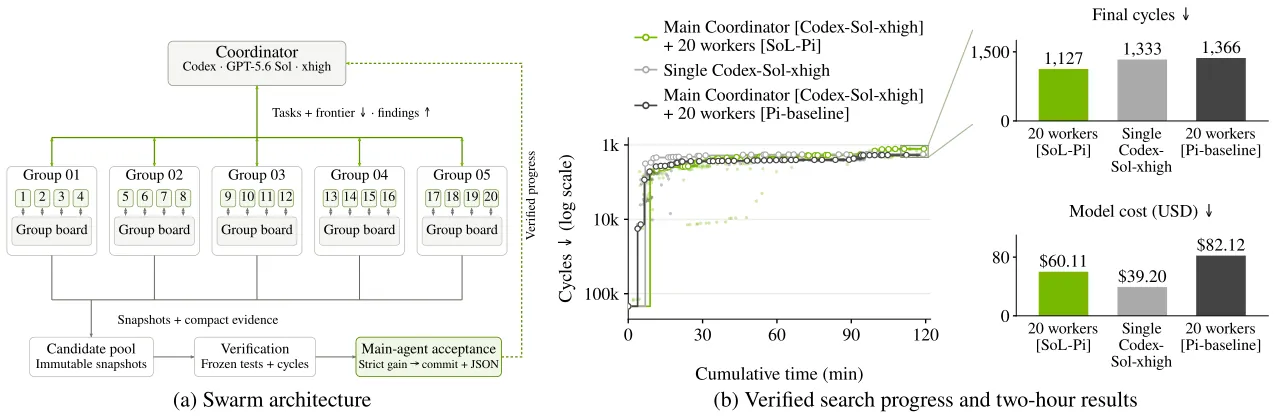
图 5:多智能体内核优化实验中,20 个 SoL-Pi worker 在两小时预算内达到 1,127 cycles,成本 60.11 美元,低于 Pi baseline swarm 的 82.12 美元。图源:论文 Figure 5。
单机制消融与组合效应
论文用 add-one 实验检查每一项机制的独立贡献。每个候选都只向 Pi 基础框架加入一个机制,再与完整四机制栈比较。四种机制在两个后端上都降低了总令牌,说明它们各自处理的重复来源确实存在。
在 GPT-5.6 Sol 上,ObservationPack 的单机制平均分最高,达到 47.208;Online Context Compact 取得最低单机制成本 935 美元;Action Fusion 将总令牌降到 1.8968 B;Evidence-Preserving Reducer 将总令牌降到 1.9375 B。完整栈不是按单项最优分数简单拼合,而是以最低总成本和最低令牌为目标,得分为 42.003。
在 Opus 5 上,Action Fusion 的单机制平均分最高,达到 50.482;ObservationPack 把总令牌降到 1.4418 B。组合后的四机制栈把总令牌进一步降到 1.3101 B,显示机制之间存在互补性。论文同时提醒,比较使用的是各配置自己的触发任务子集,因此不能把增益差异严格解释为因果交互效应。
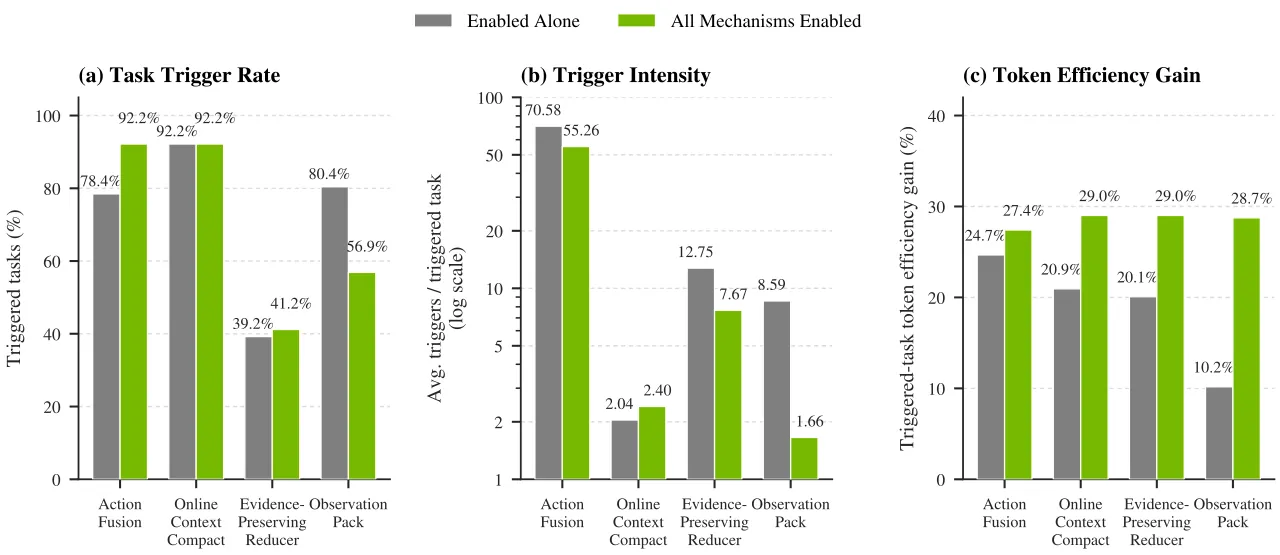
机制组合还改变了触发模式。完整栈中的 ObservationPack 更少触发,论文推测这与 Evidence-Preserving Reducer 在观测密集轨迹上的重叠有关。也就是说,四个机制不是四个独立优化器的简单相加,而是在同一个执行框架中对不同上下文路径进行竞争和覆盖。
图 6:四项机制在 GPT-5.6 Sol 与 Opus 5 上的任务触发率、触发强度和令牌效率增益存在后端差异。图源:论文 Figure 6。
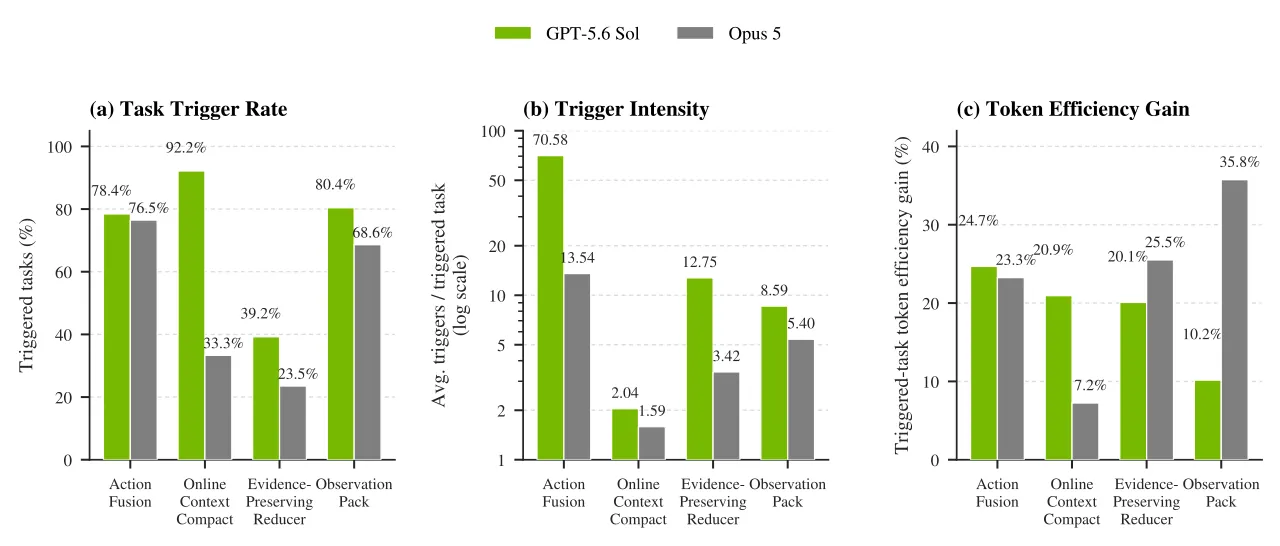
图 7:独立机制与完整栈的触发和效率增益对比;完整栈中每项机制的效率增益都高于其单机制配置。图源:论文 Figure 7。
Action Fusion 是如何被保留下来的
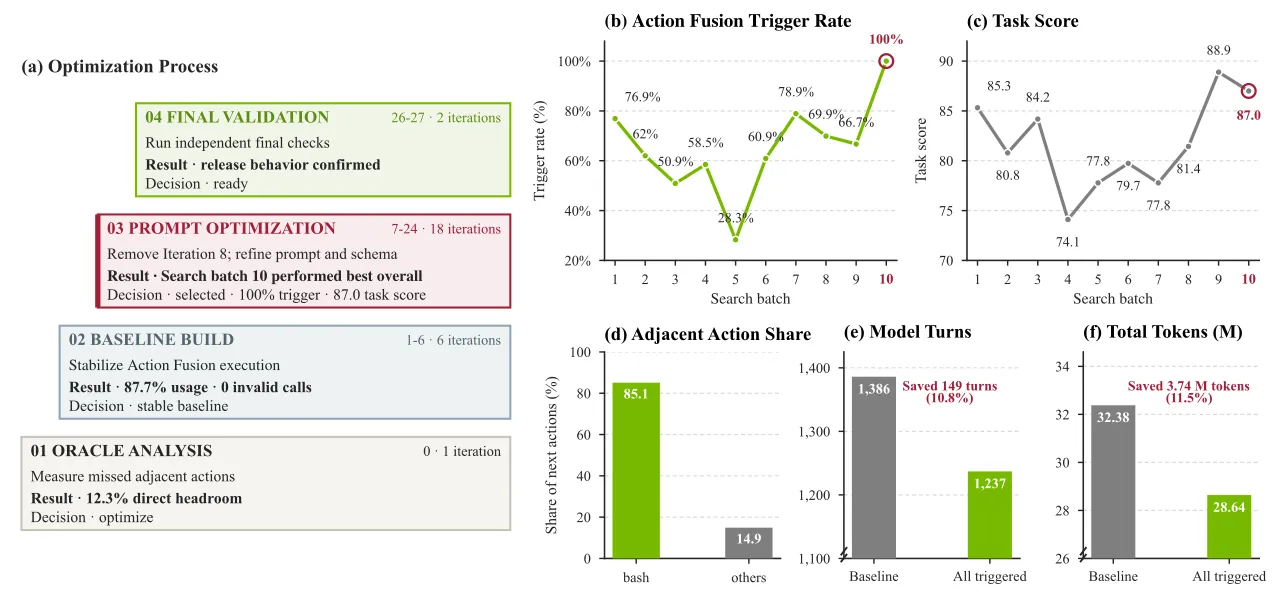
论文用 Action Fusion 展示一条候选如何从观察到保留。记录中的搜索线经历 27 次迭代,分为 oracle analysis、baseline construction、prompt 与 tool-schema optimization、final held-out validation 四阶段。其中第三阶段包含 18 次提示优化探索,最终有十个保留步骤。
Oracle Analysis 发现大量相邻动作是“编辑后立即执行命令”,并在完全触发假设下估计可减少 11.5% 令牌。这个观察触发专门搜索线。最初只改提示时,模型触发该行为并不稳定;实现者随后把融合动作直接加入工具 schema,使模型可以显式传入 then_run。稳定接口建立后,再同时优化触发率和任务分数。
这个案例说明,自动研究不只是搜索“提示词”或“模型参数”。当候选机制需要稳定接口时,搜索系统会修改工具 schema,并引入机制特定中间指标来指导优化。最终配置冻结后才进入留出验证,验证结果没有回流去修补具体任务。
图 8:Action Fusion 的 27 次迭代、四个开发阶段和最终留出验证。图源:论文 Figure 8。
指标口径为何必须同时看令牌和绩效
论文把记录令牌流量拆为输入、缓存读取、缓存写入和输出四部分:
$$ T=T_{\mathrm{input}}+T_{\mathrm{cacheRead}}+T_{\mathrm{cacheWrite}}+T_{\mathrm{output}} $$
这个分解很重要,因为压缩上下文可能减少缓存读取,却增加缓存写入。GPT-5.6 Sol 上,完整栈把缓存读取从 2.1326 B 降到 1.0605 B,同时把缓存写入从 0.0141 B 提高到 0.0316 B。缓存写入增加并没有抵消收益,总模型成本仍从 1,339 美元降到 894 美元。
论文还使用 API 成本除以聚合得分的令牌效率指标:
$$ E=\frac{C}{S} $$
这里 $C$ 是任务总成本,$S$ 是聚合得分。SoL-Pi 效率配置在 GPT-5.6 Sol 上是 0.4174 美元/分,在 Opus 5 上是 0.5376 美元/分。所有单机制配置在两个后端上都比 Pi 基线的成本/分更低。
这一指标也暴露了效率优化的边界。如果只看令牌,忽略得分,系统可以通过提前终止或少做验证来制造虚假节省。论文的能力门要求候选先保持任务得分在容忍度内,再比较效率。完整栈在 EdgeBench 上保留了 Pi 的 93.7% 到 94.3% 平均分,而不是声称超过所有基线。
局限性与未解决问题
第一项限制是搜索成本。论文承认完整自主研究循环计算代价高,无法在当前预算下系统比较多组搜索宽度和深度,因此不能据此建立缩放律。152 个方向、535 个环境、超过 3,000 次运行和 60,000 次智能体-环境交互只是搜索规模描述,不是“增加规模一定线性增益”的证明。
第二项限制是搜索后端单一。执行框架完全由 GPT-5.6 Sol 轨迹驱动,迁移到 Opus 5 后虽然仍降低成本,但触发率和强度下降。论文提出多后端训练和验证,希望在不破坏质量的前提下提高触发鲁棒性。当前实验支持初步跨模型迁移,但不能证明所有模型都会得到相同收益。
第三项限制是能力与成本之间存在操作点选择。Terminal-Bench 4 上,SoL-Pi 解决 15 项,低于 Codex 和 Pi 的 18 项;效率提升伴随着部分任务完成率下降。论文因此区分效率配置和性能配置,而不是把单一结果包装成全面超越。
第四项限制来自评测语料。核心结果是 EdgeBench、Terminal-Bench 4、IMO 2026 和一个内核优化任务,主要覆盖代码、终端和算法工程。机制本身位于通用智能体执行框架中,但论文没有证明它们在需要实时感知、工具反馈延迟、物理安全和多模态观测的机器人任务上也保持同样收益。
第五项限制是 Evidence-Preserving Reducer 的外部模型调用。长诊断日志会被发送给配置的低成本模型,尽管引文经过逐字节验证,数据仍需离开本地。仓库默认关闭所有机制,正是要求部署方在启用前审核配置、凭据策略和隐私边界。
结论与可复用价值
SoL-Pi 的核心贡献不是某一个单独技巧,而是把执行框架优化变成了可扩展、可回退、可验证的搜索系统。它先用 152 个假设覆盖多个系统层,再把少量方向分别推进;候选只有在保持能力容忍度并改善效率时才被保留;最终框架在冻结后才接受未见基准测试。结果是四项机制能够在 GPT-5.6 Sol 和 Opus 5 上复制主要效率收益。
从系统设计角度看,四项机制提供了可操作的工程模板。Action Fusion 展示如何消除确定性中间回合;Online Context Compact 展示如何把缓存改写成本纳入上下文管理;ObservationPack 展示如何在保留原文可检索性的同时减少投影重复;Evidence-Preserving Reducer 展示如何委派阅读而不把最终判断交给摘要模型。四者都不是简单截断,而是带有可验证边界和失败回退。
对长时运行的智能体系统而言,这项工作的主要启示是:模型层的成本优化不会自动解决执行层的重复劳动。真正可迁移的改进通常需要同时考虑动作结构、上下文生命周期、观测存储和证据完整性。SoL-Pi 给出的初步证据是,规模化自主研究可以稳定找到这类系统级机制,但搜索规模、后端覆盖和真实部署边界仍需要后续验证。
效率不是少做工作,而是让同一份工作不再被重复传递、重复读取和重复证明。