PAPER DEEP DIVE
L3G-World:潜在三维高斯记忆实时世界生成
L3G-World 以潜空间三维高斯记忆保存场景:新区域新增、旧区域残差修正,直接渲染为扩散模型潜变量,兼顾长时一致性与实时性,H100 达 9.02 FPS。
论文元信息
论文:Real-Time Infinite World Generation with Latent 3D Gaussian Memory
作者:Jinhyeok Choi、JoungBin Lee、Jongmin Lee、Minkyeong Jeon、Jiyoung Kim、Kaeun Han、Yoonjin Yoon、Seungryong Kim。
机构:KAIST AI、Ewha Womans University、KAIST Urban AI Institute。
链接:arXiv:2610.40614;项目页;官方仓库。
代码状态:截至本文核验时,官方仓库只包含说明文档、许可、通知和一张项目图。L3G-Mem 代码与权重、L3G-Gen 代码与权重、L3G-World 推理代码以及 Fast 模型权重的发布清单均未勾选。因此,本文不声称已经复现实验,也不声称检查过实现细节;下列分析完全来自论文全文、项目页和仓库公开说明。
一句话总结
L3G-World 把长期场景记忆改写为可自适应增补和修正的潜在三维高斯集合,并让视频扩散模型直接读取高斯中存储的 VAE 特征,从而绕开逐块“渲染 RGB 再重新编码”的昂贵路径。
研究背景:长视频为什么不等于长期一致的世界
单图生成视频已经能产生令人信服的短片段,但“世界模型”面对的约束更严格:镜头离开初始视角以后,系统必须记住墙后、桌椅背面和道路转角;当镜头沿原路返回时,同一位置还不能突然换成另一套纹理。若每生成一个片段都只依赖最近若干帧,模型会逐渐遗忘早期观察,误差也随自回归步数累积。
现有路线大致分为两类。第一类把历史帧或注意力键值缓存作为时间上下文,让当前片段直接访问过去。它保留的是二维观测,表达能力直观,代价却随帧数线性增长;论文的相关工作表把这种成本概括为随生成帧数 $T$ 增加,最终可能显存耗尽。
第二类把历史观测放进显式三维记忆。点云或三维高斯能提供空间锚点,因此镜头回到旧位置时更容易找回原来的几何。但已有实现通常在每帧上密集生成图元,重复经过同一面墙也会继续堆积新点;记忆大小逐渐跟随视频长度,而不是跟随真正探索过的空间范围。另一种思路是优化式三维重建,表示更紧凑,却在每个片段做迭代优化,难以满足实时交互。
论文指出的第二层瓶颈常被忽略:即使已有紧凑三维表示,扩散模型仍工作在 VAE 潜空间。传统流程要从三维表示渲染 RGB,再交给 VAE 编码得到条件潜变量。两次表示转换都消耗时间,而且渲染误差还会被编码器放大。L3G-World 的出发点因而不是单纯“换一个更小的点云”,而是同时重做记忆的增长方式和生成器读取记忆的接口。
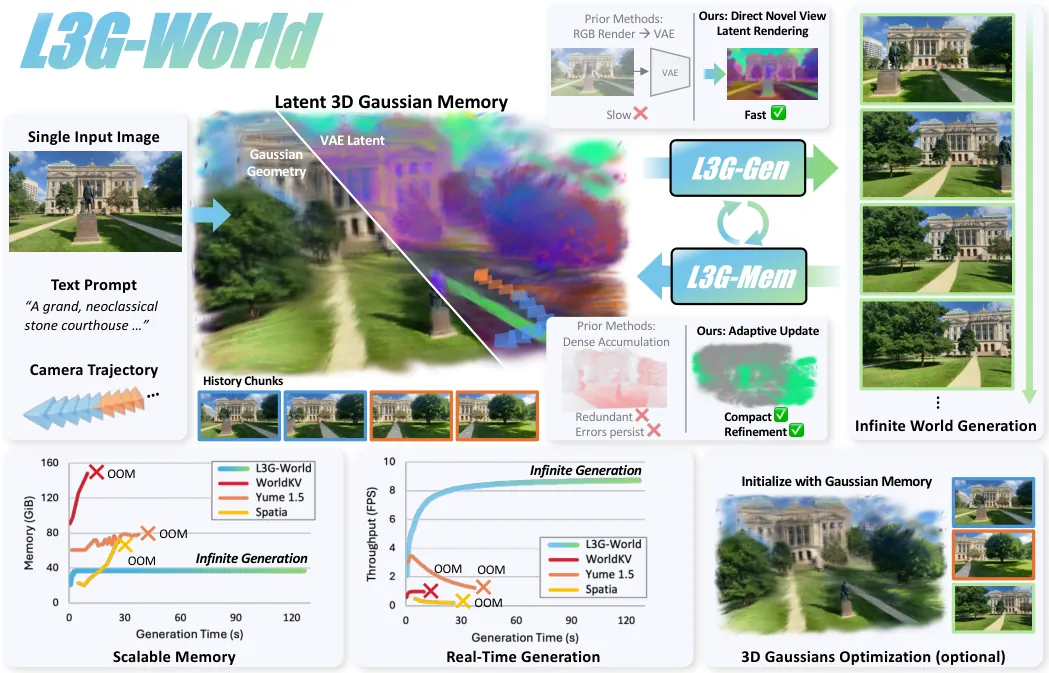
图 1:论文 teaser。系统从单张图像出发,在以相机轨迹表示的运动过程中持续生成新视角,并把探索结果写回持久三维记忆。
这套设计面向机器人仿真的吸引力在于“空间持久性”。机器人改变观察位置后,环境不能因为进入了新一轮视频推理就被重新想象。L3G-Mem 试图把已经观察到的内容锚定在世界坐标里;L3G-Gen 则用这些锚点在目标相机位置产生的潜特征约束下一段视频。两者组成一个闭环,而不是两个各自漂亮却无法互操作的大模型。
预备知识:三维高斯与潜空间扩散
三维高斯用中心、协方差、颜色、透明度和视角相关外观描述空间中的一个椭球。其协方差由尺度 $s$ 与旋转四元数 $q$ 构成:
$$\Sigma=R(q)\operatorname{diag}(s^2)R(q)^T$$
这行公式表达的是“把轴对齐的椭球先缩放,再旋转到世界坐标”。渲染时,高斯按深度排序并做透明度合成。和离散体素相比,高斯能表达连续表面;和神经辐射场相比,它通常更容易并行光栅化。
视频扩散模型则在 VAE 潜空间中做去噪。一个生成块包含多帧、多个通道和较低的空间分辨率,但模型仍要同时满足文本、相机和视觉一致性。L3G-World 的关键拓展是给每个高斯再附加 16 维 VAE 特征,使它不仅能渲染 RGB,也能以完全相同的几何和透明度合成规则渲染潜特征。
论文以 Cosmos-Predict2.5-2B 的扩散 Transformer 为视频生成基础,采用 LoRA 微调;相机条件由 UCPE 与 RayRoPE 支撑。几何侧采用 Depth Anything 3 作为骨干,并借鉴 ZipSplat 的 token 化与局部更新思路。训练使用四张 A100,记忆更新器的批量为 8,世界模型批量为 16。
方法详解
1. 记忆不是视频缓存,而是可更新的高斯 token 集合
第 $k$ 个自回归窗口处理完以后,记忆写成
$$\mathcal{M}_{k}=\{(\mathrm{G}_{j},\mathrm{T}_{j})\}_{j=1}^{N_{k}}=\{\mathbf{G}_{k},\mathbf{T}_{k}\}$$
其中 $\mathrm{G}_{j}$ 是第 $j$ 组高斯参数,$\mathrm{T}_{j}$ 是对应的记忆 token,$N_k$ 是当前 token 数。更新关系为
$$\mathcal{M}_{k}=\operatorname{Update}(\mathcal{M}_{k-1},\mathcal{W}_{k})$$
这里的窗口 $\mathcal{W}_k$ 同时包含图像、相机和 VAE 潜变量。记忆大小由 $N_k$ 决定,但论文的设计目标是不再因为“又生成了九帧”就无条件增加 $N_k$。只有新观察到的空间需要新图元,旧区域则更新已有图元。这是它声称记忆随场景范围而非视频长度增长的根本原因。
2. 先发现“没记住的地方”,再决定在哪里长出新高斯
系统把旧记忆从当前相机位置渲染出来,与真实或刚生成的新窗口比较。像素透明度低,说明该处没有被已有高斯覆盖;RGB 误差大,说明虽然覆盖了,但颜色或几何重建不可靠。掩码写为
$$\mathbf{S}_{k}(p)=\mathbb{1}(E_{k}(p)>\tau_E \lor A_{k}(p)<\tau_\alpha)$$
训练默认 $\tau_E=0.05$、$\tau_\alpha=0.25$。随后只在掩码内保留几何特征,并用 K-means 初始化有限数量的 spawning query。若对全图特征聚类,墙和地面会被重复采样,冗余图元越积越多;把候选限制在缺失区域,等于把新容量预算花在真正扩展世界边界的位置。
3. 旧高斯也要改,而不是只追加
L3G-Mem 从旧记忆中检索当前相机可见的高斯及其 token。一个高斯是否进入细化流,由其在屏幕上的深度和局部透明度共同决定:
$$d_n\leq\hat{D}(u)+\tau_d$$
其中 $\hat D(u)$ 是当前表面深度,$\tau_d=0.05$。局部透明度阈值取 $1/255$。检索后,细化头不只预测颜色残差,还预测中心、尺度、旋转、透明度和 VAE 特征残差,并用可学习门控控制修改强度。这样,当下一段视频揭露了前一阶段被遮挡或推断错误的结构时,旧记忆有机会被纠正。
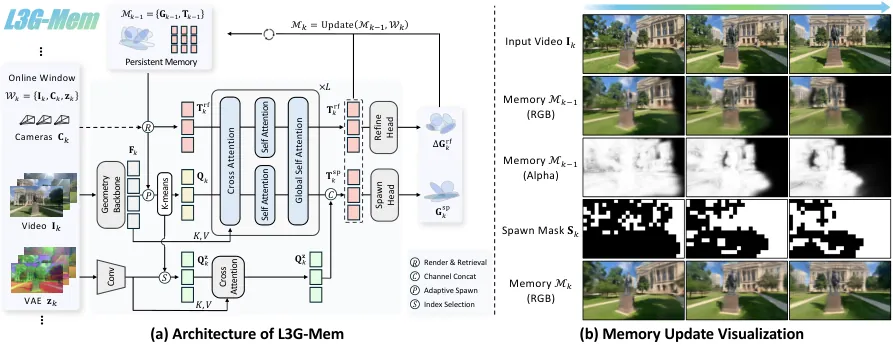
图 2:L3G-Mem 把生成窗口与旧记忆对齐,用误差和透明度决定新高斯生成位置,同时从可见旧高斯中检索 token 做残差细化。
4. 新区域与旧区域共用一个 Transformer
生成 token $\mathbf{Q}_k$ 与细化 token $\mathbf{T}^{rf}_k$ 被拼接到一起,输入同一个 Transformer:
$$(\bar{\mathbf{Q}}_{k},\bar{\mathbf{T}}_{k}^{rf})=F_{\theta}([\mathbf{Q}_{k};\mathbf{T}_{k}^{rf}],\mathbf{F}_{k})$$
每个 Transformer 块先让两路 token 分别对当前窗口的多层几何特征做交叉注意力,再做各自的流内自注意力,最后执行全局自注意力。全局层让“正在新增的墙”和“已经记住的墙边缘”交换信息,避免新图元与旧表面在接缝处各说各话。
两个头分别输出新增和残差更新:
$$\mathrm{G}_{k}^{sp}=\operatorname{Head}_{sp}(\mathrm{T}_{k}^{sp}),\qquad \Delta\mathrm{G}_{k}^{rf}=\operatorname{Head}_{rf}(\bar{\mathrm{T}}_{k}^{rf})$$
按公开实现描述,每个空间 token 可预测 32 个高斯。细化只在被检索的旧高斯上发生,未检索部分保持原样。这个局部性既降低了更新成本,也避免每来一个片段就全场景重写。
5. 把 VAE 特征放进高斯,省去第二次编码
普通三维记忆只保存颜色。L3G-Gen 需要的是潜变量,因此传统接口必须先把高斯渲染成图像,再送入 VAE。L3G-World 使用卷积网络把 16 通道 VAE 潜变量映射为 128 维 token,并通过交叉注意力对齐到新增高斯的空间索引。每个高斯最终同时携带几何、颜色、透明度和 16 维潜特征。
潜特征渲染与 RGB 渲染共享投影、排序、透明度和合成,但会断开几何梯度,只让 VAE 目标监督特征和共享 token 表示。这个选择防止“为了让潜特征更好看”而把高斯中心推离正确几何。它也解释了为何 L3G-Mem 的消融中,去掉 VAE lifting 后条件渲染帧率会从数百帧骤降到约 3 FPS。
6. 目标视图条件被拼到通道维,而不是增加记忆 token
生成第 $k$ 段时,系统从当前记忆在目标相机下渲染潜特征 $\mathbf{z}^{mem}_k$ 与透明度 $\mathbf{o}^{mem}_k$。它们和正在去噪的目标潜变量按通道拼接,再与固定参考潜变量组成序列:
$$\mathbf{z}_{k,t}^{seq}=[\mathbf{z}_{k}^{ref};\operatorname{Concat}_{c}(\mathbf{z}_{k,t};\mathbf{z}_{k}^{mem};\mathbf{o}_{k}^{mem})]$$
参考帧与目标帧的时间位置被明确分开:
$$\mathbf{p}_{k}^{seq}=[-L_{\text{ref}},\ldots,-1;0,\ldots,L-1]$$
新增的记忆条件不占用 Transformer 的 token 槽位,因此长时生成不会因为历史块数增加而线性膨胀注意力序列。空间一致性的主要载体是多视角三维记忆;时间连续性则由固定参考潜变量、时间 RoPE 和片段间的生成习惯保持。
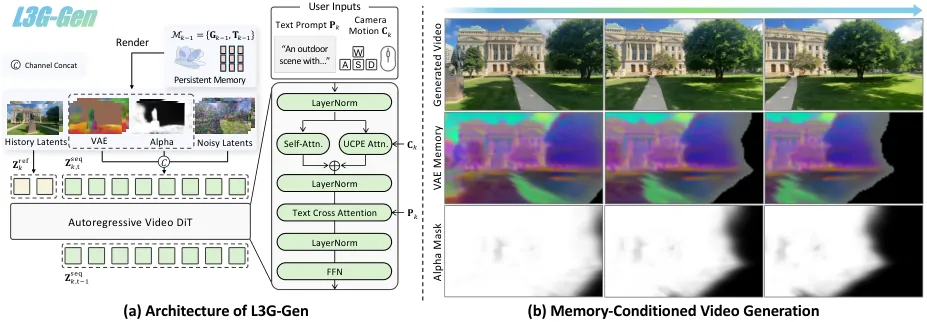
图 3:L3G-Gen 直接接收记忆在目标相机下渲染出的 VAE 潜特征和透明度图,并与参考潜帧一起送入视频 DiT。
7. 教师模型学习记忆条件下的流场
教师模型采用 rectified flow。若干净目标潜变量为 $\mathbf{z}_{k,0}$,加噪样本为 $\mathbf{z}_{k,t}=(1-t)\mathbf{z}_{k,0}+t\epsilon$,则训练目标是预测从噪声走向数据的流:
$$\mathcal{L}_{FM}=\mathbb{E}\left[\left\|\mathbf{v}_{\phi}(\mathbf{z}_{k,t},t\mid\mathbf{z}_{k}^{mem},\mathbf{o}_{k}^{mem},\mathbf{z}_{k}^{ref},\mathbf{C}_{k},\mathbf{P}_{k})-(\epsilon-\mathbf{z}_{k,0})\right\|_2^2\right]$$
监督只加在目标帧,参考帧保持干净且固定。模型因此学会在相机移动时,把几何来自三维记忆、纹理与局部细节交由扩散先验补齐,而不是让记忆直接决定最终像素。
8. 从 35 步教师到四步在线蒸馏
L3G-Gen Fast 以 AnyFlow 的 flow-map 初始化少步学生,再做学生自回归轨迹上的 on-policy 分布匹配。教师使用 81 帧、35 个扩散步;学生每一步只处理三个潜帧、总共四步,并且不使用无分类器引导。
这种蒸馏不是把 35 步输出当成普通监督标签就结束。学生在自己的生成轨迹上产生样本,再重新加噪并与冻结教师比较,使训练分布更接近推理时学生真正见到的状态。实时性能最终来自三部分叠加:紧凑自适应记忆、潜空间直渲染、四步自回归生成器。
9. 主循环如何闭合
给定初始图像,L3G-Mem 建立 $\mathcal{M}_0$。之后每个片段按“从记忆读取目标视图条件、L3G-Gen 生成下一块、解码 RGB、L3G-Mem 更新记忆”的顺序循环。生成的潜变量直接用于 VAE lifting,RGB 只解码一次供渲染与监督路径使用,从而避免生成器与记忆更新器之间反复编码同一内容。
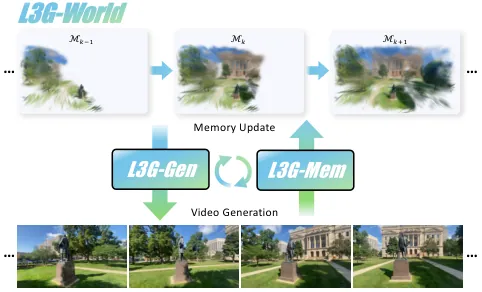
图 4:L3G-World 的块级闭环。生成器读取记忆,更新器消费新片段并写回同一三维表示,下一块继续从修改后的记忆读取。
flowchart LR
    I["Start image + cameras"] --> M0["Initialize latent 3D Gaussian memory"]
    M0 --> R["Render VAE features
at target cameras"]
    R --> G["L3G-Gen / Fast
generate next latent chunk"]
    G --> D["Decode RGB once"]
    D --> S["Spawn mask
error + low opacity"]
    D --> F["Retrieve visible old Gaussians"]
    S --> T["Joint transformer
spawn and refine tokens"]
    F --> T
    T --> M1["Update Gaussian geometry
color and VAE features"]
    M1 --> R
实验分析
论文在 DL3DV 与 RealEstate10K 上评估。长时一致性不是随机比较两帧,而是构造 481 帧的闭环轨迹:镜头先离开起点探索,再沿同一相机路径反向返回。返回时对应姿态的画面若仍与去程一致,说明空间记忆在长期生成后没有完全漂移。该协议比普通相邻帧 FVD 更直接地测试“走过再回来”的记忆。
生成质量使用 LPIPS、FID 与 VBench 的 Imaging Quality、Aesthetic Quality、Subject Consistency、Background Consistency;相机控制使用平移误差、旋转误差,三维一致性使用 MEt3R。效率方面分别报告图元数、记忆体积、重建 FPS、RGB 渲染 FPS 与 VAE 条件渲染 FPS。区分后两项很重要:对普通 RGB 记忆而言,VAE 条件渲染必须额外执行编码。
长期显存与吞吐
| H100,400 帧 | 峰值显存 | 累计吞吐 |
|---|---|---|
| L3G-World | 7.4 GiB | 9.02 FPS |
| NeoVerse | 36.8 GiB | 1.99 FPS |
| ArtiFixer | 11.7 GiB | 0.10 FPS |
| WorldKV | 显存不足 | 显存不足 |
这组对比最能说明论文的实际野心:它不只追求单帧画质,也追求在长视频继续运行时显存不明显失控。WorldKV 在 400 帧条件下出现 OOM,而 L3G-World 仍保持约 7.4 GiB 峰值。9.02 FPS 已接近实时观看所需的 8–10 FPS 区间,但这是特定 H100、特定分辨率和 400 帧长度的累计结果,不能直接外推为任意场景、任意动作频率下都能实时。
两个数据集的记忆质量
| 指标 | DL3DV | RealEstate10K |
|---|---|---|
| 高斯图元数 | 33K | 25K |
| 记忆体积 | 11.88 MiB | 8.91 MiB |
| 记忆重建吞吐 | 40.088 FPS | 38.881 FPS |
| RGB 渲染 | 460.73 FPS | 577.00 FPS |
| VAE 渲染 | 1086.58 FPS | 1101.94 FPS |
| 闭环 PSNR / SSIM / LPIPS | 16.00 / 0.441 / 0.366 | 18.36 / 0.668 / 0.269 |
| 生成 LPIPS / FID | 0.547 / 40.57 | 0.518 / 36.09 |
| 主体 / 背景一致性 | 0.820 / 0.893 | 0.841 / 0.923 |
与各自最有效的既有显式三维记忆相比,论文报告最多少用 38.6 倍图元、记忆重建快 3.2 倍、VAE 条件渲染快 359 倍。需要区分“最多”所对应的不同基线:这些倍数不是同一对手在同一指标上的三连冠,而是每项选择当时最有效的三维记忆作为参照。论文也明确给出另一组面向点云 Lyra 2.0 的比较:重建快 8.9–9.5 倍、显存少 7.8–10.4 倍、VAE 渲染高 643–648 倍。
DL3DV 的闭环 PSNR 为 16.00,RealEstate10K 为 18.36。单看绝对值,它们并不等同于高质量新视角重建;这里比较的是生成视频在去程与回程对应姿态之间的一致性,仍会受视频扩散的模糊和细节变化影响。RealEstate10K 的室内结构、较短路径和更规则相机运动可能对结果有利。因此,更稳妥的结论是“在论文自己的长期一致性协议下领先”,而非“场景几何已经达到精确重建级别”。
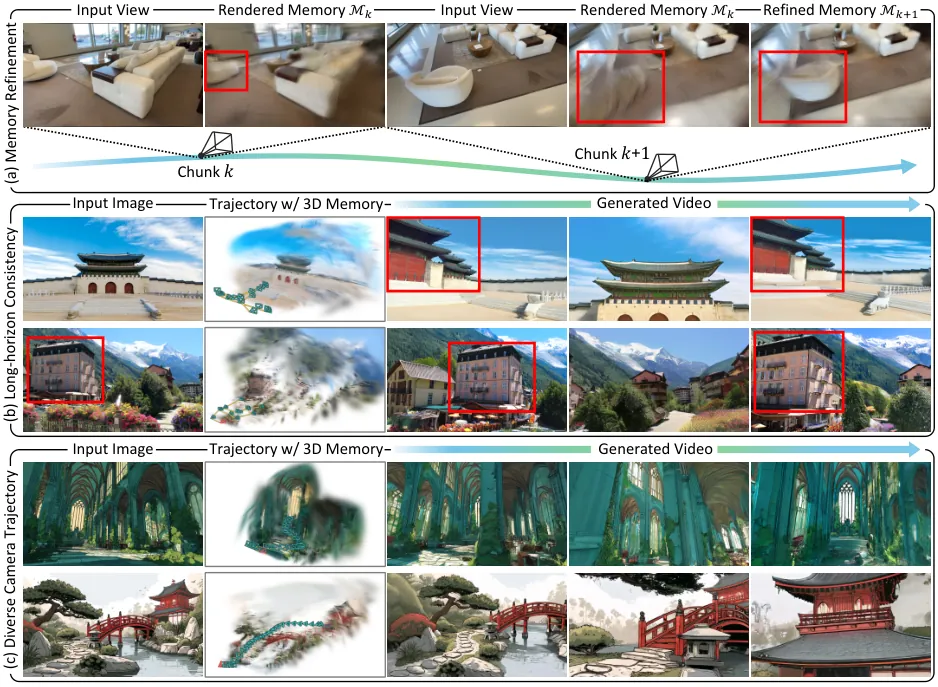
图 5:定性结果。(a) 新片段暴露旧记忆几何误差后,残差细化进行修正;(b) 数分钟生成中的长期一致;(c) 目标相机下的 VAE 记忆条件支持不同轨迹。
消融:紧凑、修正、潜空间直渲染缺一不可
| L3G-Mem 变体 | 图元数 | VAE MSE | 余弦相似度 | PSNR | VAE FPS |
|---|---|---|---|---|---|
| 无自适应生成 | 75K | 0.182 | 0.776 | 16.26 | 742.4 |
| 无残差细化 | 45K | 0.213 | 0.743 | 15.52 | 937.5 |
| 无 VAE lifting | — | 0.570 | 0.467 | — | 2.97 |
| 完整模型 | 41K | 0.177 | 0.782 | 16.52 | 943.6 |
不使用自适应生成时,图元从 41K 增至 75K,PSNR 反而下降到 16.26,直接说明“每块都补一批点”制造了冗余。去掉细化后图元只稍多,但 PSNR 降至 15.52,表明旧内容如果永远不被修改,早期错误会一直留在世界里。去掉 VAE lifting 的代价最戏剧化:潜特征 MSE 从 0.177 升到 0.570,条件渲染只有 2.97 FPS,证明潜接口不是工程微优化,而是实时路径能否成立的前提。
世界模型消融还检查了记忆细化是否真的改善最终视频。完整模型在 DL3DV 上为 PSNR 15.11、LPIPS 0.435、FID 48.09;无细化变为 14.82、0.464、50.63;无 VAE lifting 为 15.41、0.461、51.84。这里出现一个值得认真解释的现象:无 VAE lifting 的 PSNR 反而略高,但感知 LPIPS 与分布 FID 更差。像素 L1/L2 类指标偏爱保守平滑,感知指标则更能反映条件路径是否保留了正确纹理。作者因此没有只拿 PSNR 宣传,而是同时报告多项指标与定性结果。
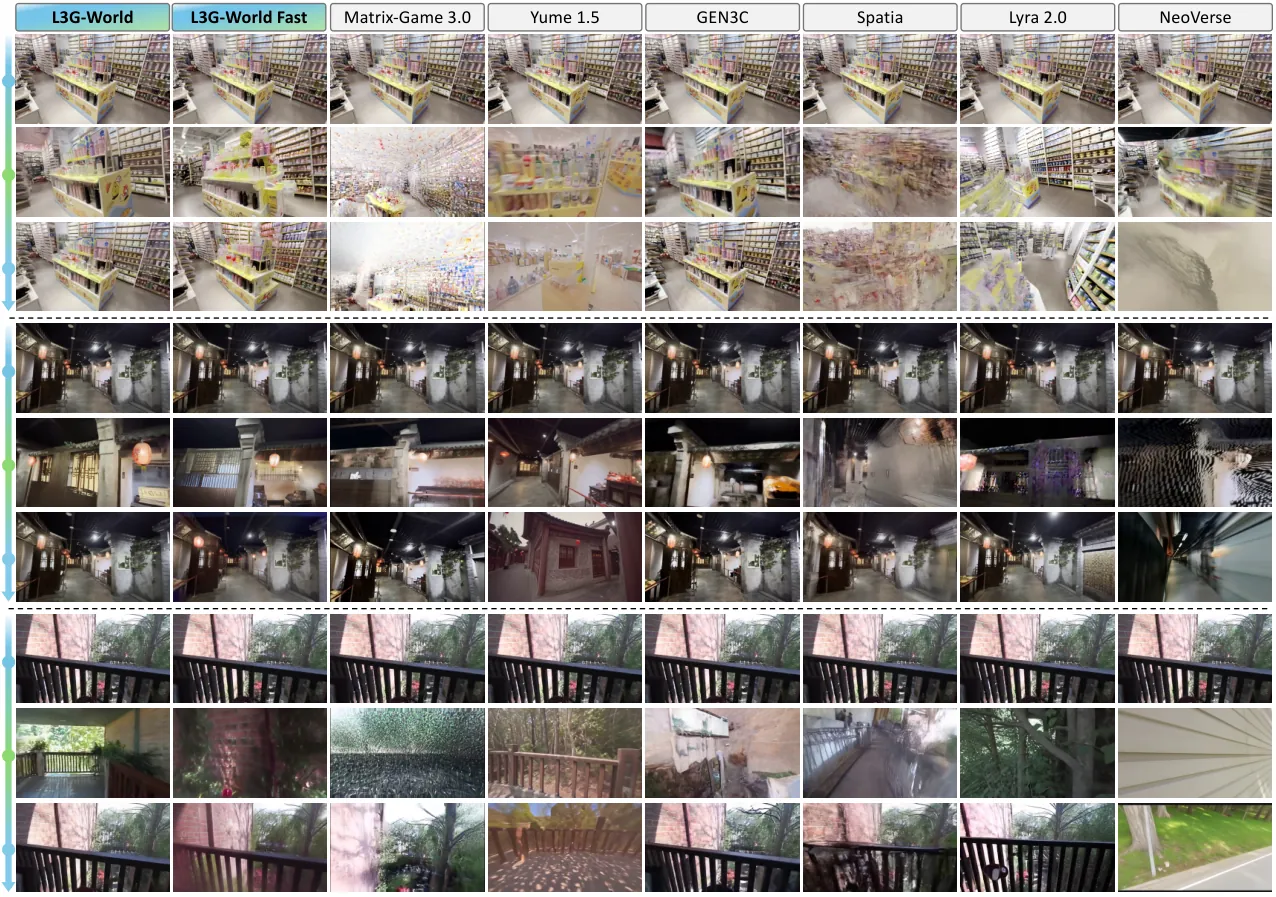
图 6:所有方法从同一输入视角出发、探索未知区域再返回起点。L3G-World 与 Fast 在闭环处更能保持场景结构,时间上下文法和部分显式记忆基线则出现漂移、模糊或渲染伪影。
独立判断:它离机器人仿真还有多远
论文把相机控制放在核心位置,这比纯文本驱动世界模型更适合具身场景。但实验给定单张输入图和预设相机轨迹,机器人动作、碰撞、物体状态和物理响应都没有进入闭环。系统可以生成“沿某条轨迹看过去是什么样”,还不能回答“推一下杯子会发生什么”。因此它更接近视觉世界生成器或可探索场景先验,而不是可直接替换物理引擎的行动模拟器。
长期一致性协议设计得较扎实,因为返回同一姿态能暴露记忆漂移。不过 481 帧仍只是一个有限长度的闭环。论文没有证明在街区级连续探索、频繁遮挡切换、相机快速旋转或动态行人条件下都保持相同优势。更重要的是,场景记忆以静态高斯为主,独立运动对象会破坏“同一个空间位置永远是同一内容”的假设。
效率数字也存在测量边界。生成吞吐的主表在 H100 上测 400 帧,部分消融与记忆效率在 A100 上测;重建 FPS 包含检索、掩码、更新网络与残差写回,而 RGB/VAE 渲染 FPS只描述记忆到目标视图的一段。它们不能相加成一个端到端“每秒完整交互步数”。尽管如此,分项测量反而比只给一个模糊 FPS 更透明,读者可以定位速度收益来自记忆压缩还是扩散步数蒸馏。
基线适配也值得保留警惕。为了让所有方法在一图输入和统一尺度下比较,作者用 Depth Anything 3 估计度量深度并对齐相机轨迹,部分方法还经过包装。这样的统一化有利于公平,却可能让某些原始系统偏离其最佳运行条件。最终判断应等待代码和权重公开后,在相同分辨率、帧数、硬件与闭环路径上重跑。
局限分析
作者明确承认三点。第一,潜在三维高斯记忆主要面向静态场景,没有显式建模独立运动物体。第二,虽然记忆不再随生成流长度线性增长,但极端大范围探索仍会让图元数量上升,未来需要自适应剪枝或层级记忆。第三,长时自回归生成中的错误仍可能传播到后续记忆更新,细化机制只能逐步缓解,不能保证消除。
本文另外补充两点判断。其一,单图初始化和相机轨迹输入高估了“观察充足”的程度;真实机器人常常只有稀疏、抖动且部分过曝的视觉输入,系统对传感器噪声、曝光变化和深度失败是否稳健仍未验证。其二,当前评估主要验证视觉一致性,没有任务成功率或物理合理性实验。即使闭环看起来相同,也不能推出下游导航或操作策略会在生成世界中获得正确奖励。
代码与权重尚未发布是当前最实际的门槛。没有推理代码,无法核验论文中的 token 预算、K-means 采样策略、残差门控和显存测量是否与描述一致;没有权重,也无法检查四步模型在分布外场景是否仍保持项目页展示的质量。文章中的工程细节因此只能作为论文方法说明,不能当作已经可用的软件接口。
总结与展望
L3G-World 的核心贡献不是单独提出一种三维高斯,也不是单独蒸馏一个视频扩散模型,而是把“场景如何增长”“旧内容如何修正”“生成器如何读取场景”三件事放进同一闭环。自适应 spawn 控制记忆容量,residual refinement 抵抗长期漂移,latent lifting 把三维记忆直接接到扩散模型的潜空间。三者相互依赖,消融结果也支持这种系统性解释。
下一步最有价值的方向是把静态记忆扩展为“静态几何加动态实体层”。如果每个可动物体有独立状态、位姿和交互约束,机器人就不只是沿轨迹观看一个会动起来的视频,而是能在动作前后查询同一物体发生了什么。另一个方向是层级记忆:近处保留高精度高斯,远处压缩为更粗表示,并在返回时按需展开。只有当记忆增长、误差修正和动力学状态同时可管理,世界模型才可能从视觉演示走向具身训练环境。
金句
真正决定长期世界一致性的,不是把更多历史帧塞进注意力,而是让三维记忆只在该长的地方生长、在该改的时候修正,并让生成器用同一种潜语言读取它。