PAPER DEEP DIVE
AutoRL:面向自主强化学习的多智能体系统
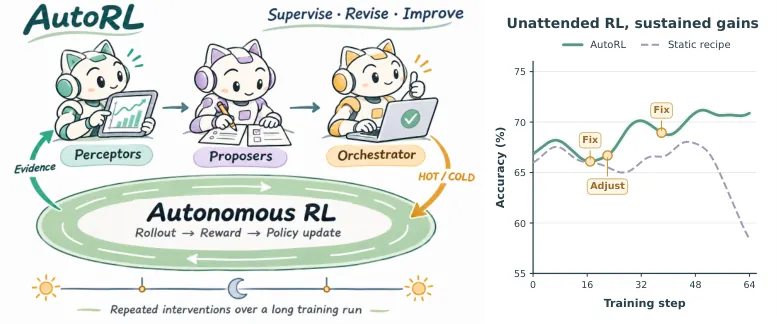
AutoRL 将强化学习训练拆为持续感知、独立提案与受控执行三类智能体,通过在线热更新或检查点回滚修复训练,在 Qwen3 与 LongCat 上稳定超过静态配方。
AutoRL:面向自主强化学习的多智能体系统
论文信息:Simon Tang、Wenjie Shi、Yongjing Yin、Keheng Wang、Jialin Liu、Zheng Zhang、Linvo Lin、Xiangyuan Xue、Kan Ren、Jingang Wang、Xunliang Cai。arXiv 2026,论文编号 2611.17790。截至精读时,按标题、作者组合和论文全文中的链接检索,未发现作者公开的实现仓库,因此本文不提供代码级对应关系。
一句话总结:AutoRL 把强化学习训练视为持续演化的过程,由四个感知智能体发现异常、三个提案智能体在冻结证据上辩论、编排器执行在线热更新或检查点冷恢复,使训练能在配方缺陷、平台期和运行故障中继续改进。
研究背景:为什么强化学习不能只做一次静态配置
强化学习后训练通常从一个配方开始:指定学习率、采样组大小、裁剪范围、奖励函数、KL 正则和训练数据,然后启动长时间任务。这个配方在早期可能有效,却不保证在策略分布变化后仍然有效。生成样本的分布会随着策略更新而移动,同一奖励在不同训练阶段可能暴露出错误映射、解析缺陷或异常的长回答,最终让原本正常的损失曲线演化为退化。
人工研究者处理问题的方式并非只在实验结束后比较若干完整配方。他们会在运行中查看梯度、损失、回答长度、奖励分布和评测曲线,发现异常后回到代码检查评分器,或者提出新的正则化与探索设置。能在线修改的参数可以热更新,需要改数据加载器或训练代码的变更则要保存检查点并重新启动。真正困难的工作因此分成两部分:持续监视,以及在训练状态仍然新鲜时形成可执行诊断。
已有自动研究系统多数把研究组织成“一次实验结束,再决定下一次实验”的串行循环。这样能比较整体结果,却把长时间训练中的大量中间证据浪费掉。对一个已经出现 NaN、奖励坍塌或长期平台期的任务,等到下一次实验再修正意味着继续消耗 GPU,也让故障的因果链更难定位。串行实验还容易把一次失败压缩成一个总分,忽略究竟是评分器、优化器、数据还是分布式执行出了问题。
直接把通用编码智能体放进训练循环也不充分。监视要求频繁响应,而研究平台期需要阅读日志、检查代码、比较历史干预和进行小型验证,两类任务会争夺同一上下文。训练输出数量庞大,容易挤占分析所需的注意力;没有明确角色的智能体还可能看过期日志、重复验证同一假设,或者在没有运行时回执时误以为修改已经生效。
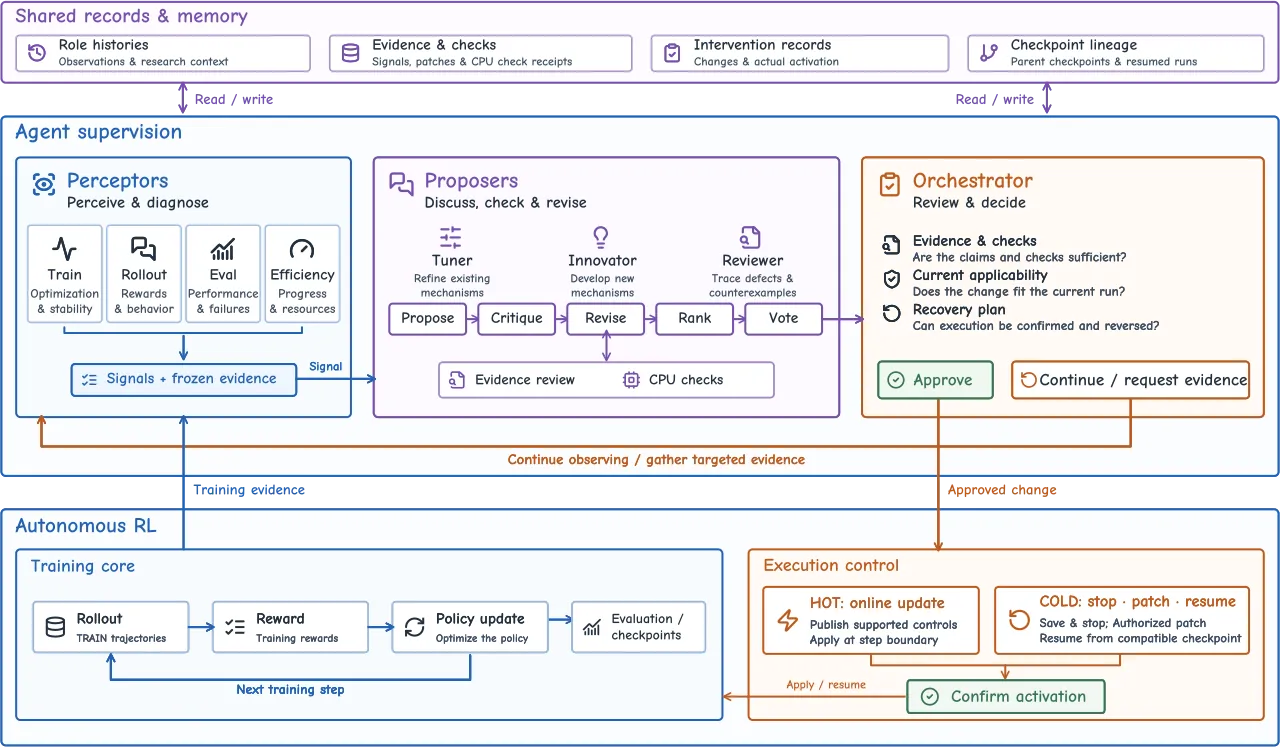
论文由此提出三个设计问题:如何及时干预;如何让持续监视和深度研究并行;如何在昂贵的强化学习验证之前尽可能排除错误提案。AutoRL 的答案不是让一个智能体同时完成全部工作,而是把专家研究者的工作流拆成专门的感知、提案、辩论和执行角色,并把每次观察、改动、运行回执与检查点谱系写入共享记录。
方法详解:把训练监督组织成可审计闭环
系统输入包括初始模型、训练数据、优化目标、计算预算和研究者授权的工具范围,评测协议在干预期间保持不变。主训练进程照常执行 rollout、奖励计算、策略更新、周期评测和检查点保存,多个监督角色并行工作。这样的边界很重要:AutoRL 可以改奖励实现、损失设置、数据选择或受支持的训练控制项,但不能通过修改评测集来制造提升。
第 $k$ 次研究决策写成下面的映射。$E_k$ 是本次决策所依据的训练观察和证据,$H_k$ 是可检索的训练与干预历史,$a_k$ 是编排器审核后真正执行的动作。$\mathcal{F}$ 并非单一模型提示词,而是由角色工作流、证据冻结、辩论协议和执行控制共同实现的程序。
$$a_k=\mathcal{F}(E_k,H_k).$$
四个感知角色各有独立上下文。训练感知器检查梯度、损失和数值稳定性;采样感知器分析奖励、样本质量与生成行为;评测感知器跟踪固定评测协议下的性能和失败类型;效率感知器观察吞吐、进度和运行故障。每个观察结果都绑定运行编号、训练步、时间窗口和源文件,避免后续智能体读取一条脱离上下文的结论。
感知器先用工具计算窗口内的计数、均值、标准差、斜率和标准化偏差,再由语言模型解释这些统计量。例如,梯度尖峰要结合损失和裁剪比例判断;熵下降要结合训练进展区分正常收敛与策略坍缩。论文还设置了明确触发器,包括验证到的 NaN/Inf,以及连续若干次评测没有刷新最佳分数。没有异常时,训练直接继续,不产生一次昂贵的辩论。
当某个角色报告异常、退化或停滞,系统进入提案阶段。调参者负责调整现有配方中的系数和保护措施;创新者寻找任务范围内的替代机制;审查者追踪实现缺陷并构造反例。三人从同一批冻结证据出发,先独立诊断,再读取彼此提案。冻结初始证据避免了“谁先搜索谁定义问题”的信息不对称。
三位提案者生成初始候选后,辩论最多持续五轮。候选的初始集合与最终推荐可写成:每个 $\mathcal{G}_j$ 是第 $j$ 个提案者的诊断过程,$\mathcal{C}_k^0$ 汇总三份初始候选,Debate 执行批评、修订、合并、排序和投票;$E_k$ 表示辩论期间新增的证据。CPU 检查与历史轨迹回放会扩充证据,但不能越过冻结的初始观察来改写问题起点。
$$\mathcal{C}_k^0=\bigcup_{j=1}^{3}\mathcal{G}_j(E_k^0,H_k),\qquad \widehat a_k=\operatorname{Debate}(\mathcal{C}_k^0,E_k,H_k).$$
辩论中的验证有明确产物。提案者可以在隔离工作目录中复制相关代码和经过授权的训练输入,执行 CPU 检查并记录候选版本、命令、输入、输出和结果。通过记为 PASS,失败记为 FAIL,超时或依赖不可用记为 INCONCLUSIVE,无法应用时还要给出原因。这样可以把“代码看起来合理”与“实现确实覆盖目标行为”区分开,同时避免把每个想法都送到 GPU 上做完整实验。
排序采用 Borda 计分。若有 $m$ 个存活候选,某个提案者把候选 $c$ 排在第 $\rho_j(c)$ 位,则该候选的总分为:
$$S(c)=\sum_{j=1}^{3}\left(m-\rho_j(c)+1\right).$$
得分最高的至多两个候选进入最终投票,分数相同则按候选编号稳定排序。最终推荐必须形成 3:0 或 2:1,只有一个候选时也要得到三票确认,异议和未解决问题会被保留。若三轮提案者在完整一轮中共同选择同一合格候选,辩论可以提前结束。任何失败检查或未解决阻塞都不能被多数票掩盖。
论文给出的动作集合只有三类。NONE 表示维持当前配方;HOT 在训练后端支持的步边界应用控制更新或代码补丁;COLD 从兼容且完整的检查点 $b_k$ 恢复,再应用需要重启的代码、配置或数据变更。$\delta_k$ 是具体改动。HOT 的准入条件不是“模型认为可热更”,而是修改必须完全落在运行后端确实消费的在线控制文件与接口内。
$$a_k\in\{\mathrm{NONE},\mathrm{HOT}(\delta_k),\mathrm{COLD}(\delta_k,b_k)\}.$$
状态转移进一步说明两者如何保留训练进度。执行前状态 $x_k^-=(\theta_k^-,z_k^-,c_k^-)$ 包含模型参数、优化器与采样等运行时状态,以及有效配置。HOT 保留 $\theta_k^-$ 与 $z_k^-$,只把改动并入配置;COLD 从检查点恢复模型和运行时状态,再用新配置继续。$\oplus$ 表示应用修改并核对哪些旧控制项需要继承。
$$x_k^+=\begin{cases}x_k^-, & a_k=\mathrm{NONE},\\( \theta_k^-,z_k^-,c_k^-\oplus\delta_k), & a_k=\mathrm{HOT}(\delta_k),\\( \theta_{b_k},z_{b_k},c_k^-\oplus\delta_k), & a_k=\mathrm{COLD}(\delta_k,b_k).\end{cases}$$
HOT 并非没有风险。后端控制文件描述的是完整覆盖集合,新文件必须保留此前仍需生效的修改;替换损失对象时,也要把未变化的裁剪、熵和 KL 设置带入新对象。同步训练器在训练步边界加载控制,并记录生效步和源版本;异步训练器则在派发策略更新之前应用训练器本地控制。只有运行时回执确认修改被消费,感知器才会把后续变化归因于这次干预。
COLD 的过程更长。编排器先决定哪些 HOT 控制写入下一次启动、哪些在恢复后重放或删除,然后发出保存并停止请求,等待训练关闭,再授予代码锁。新任务从兼容检查点恢复模型、优化器、训练器、采样状态、步计数以及可用的随机和数据消费状态。若任务已经崩溃,则从未损坏的完整检查点恢复。每次恢复都记录父运行和检查点,活动历史只沿继承谱系延伸,其他失败分支保留为研究经验,而不被误当成当前模型状态。
这一谱系机制解决了长任务中的典型歧义。假设训练从检查点 100 恢复,那么新运行继承到第 100 步的观察;被放弃分支在第 100 步之后的日志仍然可以作为历史证据,却不能直接解释当前模型。平台期实验确实从检查点 100 和 135 恢复,修改分别在第 101 与 136 步生效。若没有父运行记录,感知器会把被抛弃的轨迹和当前轨迹混在一起。
flowchart LR
  T["RL training
rollouts rewards updates"] --> P["Four Perceptors
train rollout eval efficiency"]
  P -->|"no issue"| T
  P -->|"anomaly plateau failure"| F["Freeze evidence batch"]
  F --> A1["Tuner"]
  F --> A2["Innovator"]
  F --> A3["Reviewer"]
  A1 --> D["Independent diagnosis
critique merge Borda vote"]
  A2 --> D
  A3 --> D
  D --> C["CPU checks
PASS FAIL INCONCLUSIVE"]
  C --> O["Orchestrator review"]
  O --> N["NONE"]
  O --> H["HOT update
keep model and runtime state"]
  O --> K["COLD update
restore compatible checkpoint"]
  N --> R["Runtime receipt
shared records"]
  H --> R
  K --> R
  R --> P
共享记忆分为角色本地历史与全局记录。本地历史保留最近观察和推理,帮助角色在上下文压缩或会话恢复后继续工作;全局记录以运行、步、证据、候选、检查、干预和检查点为主键保存。训练数据特征和领域洞察也可以通过带来源的数据库检索。系统还会定时把 Markdown 摘要链接到原始证据,避免摘要变成不可追溯的二手结论。
这种设计改变了“智能体是否能自动训练”的评价方式。只看最终分数无法判断系统是否真的在执行研究:它可能只是碰巧改对了一个参数,也可能反复重启而浪费预算。论文因此同时记录提案类别、被采纳和撤回的改动、不同训练步索引、失败类型、恢复检查点、恢复延迟以及实际运行时回执。后面的分析都围绕这些过程指标展开。
实验设计:从九项基准到两周长跑
研究包含四个主要设置。Qwen3-1.7B 与 Qwen3-4B 使用 DAPO-Math-17K,处理后共有 17,390 道数学题;LongCat-Flash-Lite 使用包含 9,340 道私有数学题的推理训练集,以及 700 多个仓库级软件工程任务。监督智能体在 Qwen 实验中使用 gpt-6.1-sol,在 LongCat 实验中使用 glm-5.2;通用智能体基线是启用全部内置工具的 Codex,同样由 gpt-6.1-sol 驱动。
Qwen 初始配方采用学习率 $10^{-6}$、每个提示采样 8 个回答、最多生成 8,192 个回答 token。LongCat 推理使用相同的学习率和组大小,但回答上限提高到 131,072 token。编码智能体采用全异步更新,每个任务 16 条轨迹,学习率 $5\times10^{-6}$,最多 400 个交互轮次,上下文上限 262,144 token。Qwen 评测温度为 0.6 并关闭思考模式,评测阶段不随干预改变。
数学评测包括 AIME 2024、AIME 2025、HMMT 2025、Beyond AIME 和 IMO-AnswerBench;通用知识与编码使用 MMLU-Pro、GPQA-Diamond、MBPP 和 LiveCodeBench v6 Hard。在线推理监控集共 190 题,其中 AIME 2024、AIME 2025 和 HMMT 2025 各 30 题,Beyond AIME 100 题,每题采样两次,因此每次评测覆盖 380 个回答。最终 Qwen 基准每题独立采样四次,报告平均正确率或 pass@1。
初始训练配置还包含一些容易被忽略的可复现细节。Qwen 使用组归一化优势和 token 平均策略目标,LongCat 使用 Dr. GRPO 优势估计;所有任务都使用 AdamW 与 1.0 梯度裁剪。Qwen 的 AdamW 参数为 $\beta_1=0.9$、$\beta_2=0.999$、权重衰减 0.1;LongCat 为 $\beta_1=0.9$、$\beta_2=0.95$、权重衰减 0.01。Qwen 初始熵系数为 0,三种初始配方都没有 KL 正则。
计算布局也直接影响了故障类型。Qwen 在 8 张 H800 上让 actor、训练生成器和评测生成器分时复用,采用张量并行 2 与数据并行 4。LongCat 推理初始使用 64 张 GPU;编码智能体在 28 个节点、224 张 GPU 上完全异步训练,其中优化器、训练生成和评测生成分别占 64、128 和 32 张。论文统计 GPU 总数时,共置角色只计算一次。
主结果:九项基准上的增益
在 Qwen3-4B 上,AutoRL 相比静态 GRPO 配方在九项基准上全部提升。AIME 2024 从 46.67% 升到 66.67%,增加 20.00 个百分点;AIME 2025 与 HMMT 2025 各增加 11.67 个百分点,达到 56.67% 和 31.67%;Beyond AIME 和 IMO-AnswerBench 分别增加 6.50 与 9.75 个百分点。数学训练带来的收益还外溢到通用知识与编码,MMLU-Pro、GPQA-Diamond、MBPP 和 LiveCodeBench v6 Hard 分别提升 1.80、2.52、1.70 和 1.08 个百分点。
| 基准 | 静态 GRPO | Codex 通用智能体 | AutoRL | 相对 GRPO |
|---|---|---|---|---|
| AIME 2024 | 46.67 | 50.00 | 66.67 | +20.00 |
| AIME 2025 | 45.00 | 43.33 | 56.67 | +11.67 |
| HMMT 2025 | 20.00 | 26.67 | 31.67 | +11.67 |
| Beyond AIME | 26.00 | 25.00 | 32.50 | +6.50 |
| IMO-AnswerBench | 27.00 | 16.06 | 36.75 | +9.75 |
| MMLU-Pro | 57.93 | 37.73 | 59.73 | +1.80 |
| GPQA-Diamond | 44.70 | 45.33 | 47.22 | +2.52 |
| MBPP | 63.55 | 31.80 | 65.25 | +1.70 |
| LiveCodeBench v6 Hard | 5.71 | 4.50 | 6.79 | +1.08 |
小模型的结论没有完全复制大模型。Qwen3-1.7B 上,AutoRL 在 AIME 2024 与 AIME 2025 都达到 30.00%,分别比静态配方高 3.33 和 8.33 个百分点;HMMT 2025 持平在 18.33%,Beyond AIME 从 11.00% 升到 12.50%,IMO-AnswerBench 从 8.63% 升到 14.63%。它仍在四项通用知识与编码基准上领先静态配方,但 AIME 2024 和 IMO-AnswerBench 分别落后通用智能体 1.67 与 0.37 个百分点。这说明专门化监督在较广范围内有利,但不是每个模型尺度、每项任务都无条件占优。
与通用智能体相比,Qwen3-4B 的差异尤其明显:AIME 2024 从 50.00% 升到 66.67%,IMO-AnswerBench 从 16.06% 升到 36.75%,MMLU-Pro 与 MBPP 分别提高 22.00 和 33.45 个百分点。通用智能体在 Qwen3-4B 的 MMLU-Pro 与 MBPP 上甚至明显低于基线,提示“会写代码和会管理持续训练”不是同一能力。AutoRL 的优势来自角色分工、强化学习专用观测和可逆执行,而不仅是后端语言模型更强。
修复有缺陷的奖励配方
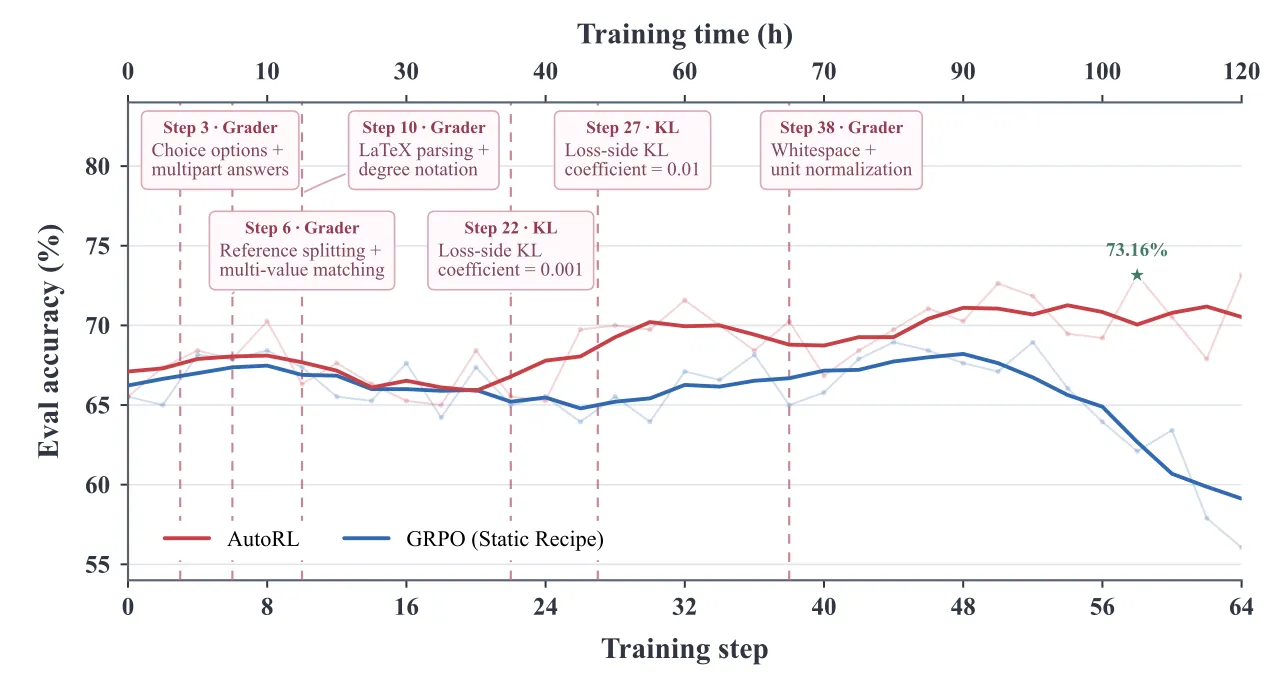
LongCat-Flash-Lite 推理实验故意从一个有潜在缺陷的配方开始:训练评分器过于简单,没有 KL 正则,回答长度上限达到 131,072 token。这个配方在开头可以正常工作,因此问题不是“训练根本启动不了”,而是缺陷随着策略和回答分布变化才变得有后果。对照任务保持原配方,AutoRL 任务允许在线修改。
前 64 步每两步评测一次,每组共 33 个测量点,AutoRL 轨迹持续约 115.5 小时。两个运行早期接近,随后分离。AutoRL 从 65.53% 提升到第 64 步的 73.16%,增加 7.63 个百分点;静态配方降到 56.05%,两者差距扩大到 17.11 个百分点。AutoRL 第一次峰值出现在第 58 步,并在第 64 步追平,而整个实验没有从检查点重启。
六次 HOT 干预分成两类。前四次修复训练评分器:第 3 步修正选项映射和多部分答案处理,第 6 步修正参考答案切分与多值匹配,第 10 步改善 LaTeX 解析和度数写法,第 38 步处理空白与单位。后两次加入 KL 正则,第 22 步系数为 0.001,第 27 步提高到 0.01。评分器修复改善学习信号,KL 约束抑制策略漂移,二者针对退化的不同来源。
这个实验支持“早期可用不等于长期可用”的判断。若只看前几步,静态配方没有明显问题;只有把训练视为状态不断变化的系统,才能解释为什么同一个奖励实现会在后面错误处理更多回答格式。每次 HOT 修改后都保留模型与优化器状态,既避免了重新训练,也让感知器能够在既有轨迹上比较干预前后行为。
突破平台期:先积累证据,再执行组合干预
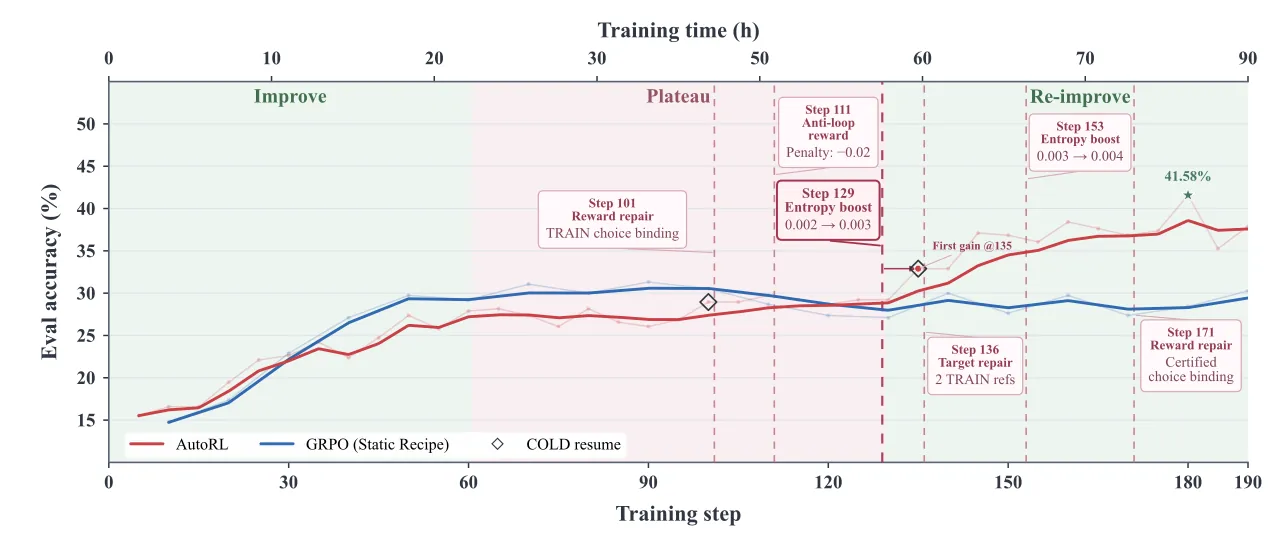
Qwen3-4B 平台期实验从一个可工作配方出发。前 100 步配置保持不变,AutoRL 继续观察和讨论,并推迟一次熵调整提案以等待更多证据。第 101 步先通过 COLD 从检查点 100 恢复,修复训练评分器的答案选项绑定;第 108 步把熵系数设为 0.001;第 111 步再加入一个针对严格循环模式的错误回答辅助惩罚。
之后熵系数在第 121 与 129 步分别提高到 0.002 和 0.003。第 130 步准确率仍为 29.21%,第 135 步升到 32.89%,首次超过平台期最大值。第 129 步的熵增加是这次上升前最后一次改动,但论文没有把它单独认定为唯一原因;更合理的解释是前期评分器修复与后续探索增强累计产生作用。第 136 步又从检查点 135 冷恢复并修复两份训练参考答案,第 153 步把熵系数升至 0.004,第 171 步用证明证书继续改进选项绑定。
| 步 | 动作 | 执行方式 | 直接目的 |
|---|---|---|---|
| 101 | 修复答案选项绑定 | COLD,检查点 100 | 纠正训练奖励映射 |
| 108 | 熵系数设为 0.001 | HOT | 增加探索 |
| 111 | 循环回答辅助惩罚 | HOT | 抑制严格重复模式 |
| 121 / 129 | 熵系数升至 0.002 / 0.003 | HOT | 逐步增强探索 |
| 136 | 修复两份训练参考答案 | COLD,检查点 135 | 修正监督目标 |
| 153 | 熵系数升至 0.004 | HOT | 继续调节探索强度 |
| 171 | 证明证书约束选项绑定 | HOT | 提高奖励验证可靠性 |
结果显示,AutoRL 在第 180 步达到 41.58%,比 29.74% 的平台期最大值提高 11.84 个百分点,也比图内静态配方最佳值 31.32% 高 10.26 个百分点。到共同比较的第 190 步,AutoRL 仍有 37.89%,静态配方为 30.26%。峰值与终点同时领先,说明收益不是单次评测的偶然波动。
表 2 的时间顺序也解释了为什么“一个神奇参数”不足以概括方法。系统先修复奖励信号,再调整探索;当表现开始上升后,它没有停止,而是继续检查参考答案和探索设置。每一步都依据当时运行状态,而非在实验开始前一次性搜索完整配方。这种顺序依赖是过程级监督与普通超参数搜索的核心差别。
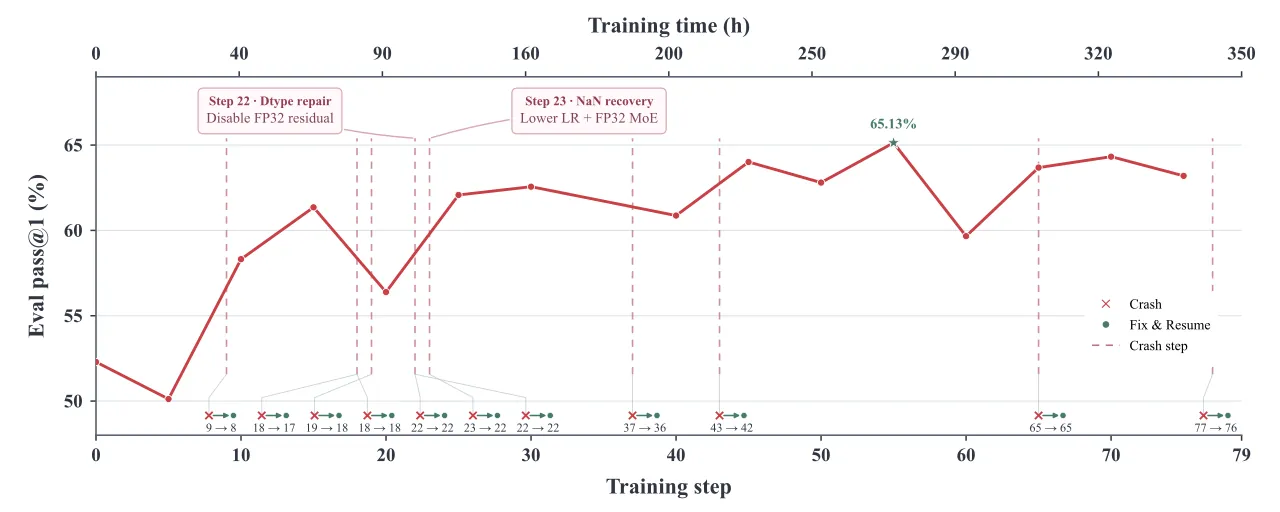
352.5 小时编码智能体训练中的故障恢复
编码任务使用 28 个节点、224 张 GPU 和完全异步的 LongCat-Flash-Lite 训练。模型每步检查点,每 5 步评测,单条编码轨迹最多 400 轮工具调用和代码执行。长交互、分布式通信、MoE 数值路径与异步策略版本叠加,使任务远比数学推理更容易在运行层面失败。
全程 352.5 小时,约 14.7 天,共出现 11 次故障:7 次 NaN、1 次 dtype 不匹配、3 次 worker 或通信故障。每次故障后都从有效检查点恢复,并通过智能体修复与重启组合使任务继续到第 79 步。到第 75 步的 15 次评测中,pass@1 从 52.29% 升到第 55 步的 65.13%,最终为 63.20%;峰值提升 12.84 个百分点,最终仍比起点高 10.91 个百分点。
连续 NaN 促使系统降低更新幅度并收紧数值路径。它把 log-ratio 裁剪区间从 $[-13,5]$ 改为 $[-5,3]$,把概率比尖峰上限设为 5,把学习率与最小学习率都从 $5\times10^{-6}$ 降到 $2\times10^{-6}$,并启用 MoE 组件中的 FP32 累加。修复目的不是“让训练不再报错”这么简单,而是改变导致发散的具体数值条件,再从检查点验证新配置能否继续学习。
系统也犯过一次修复错误。启用 FP32 残差后出现 dtype 不匹配,AutoRL 没有把所有数值修复全部扔掉,而是只撤回残差不兼容项,保留降低后的学习率、MoE 精度与更新约束,再从检查点 22 恢复。这个案例比一次成功修复更能说明执行层的重要性:同一组改动可能部分有效、部分引入新问题,恢复时要知道撤回什么、继承什么。
| 观测项 | 论文记录 | 含义 |
|---|---|---|
| 运行时长 | 352.5 小时 | 约 14.7 天无人值守训练 |
| 故障总数 | 11 次 | 7 次 NaN、1 次 dtype、3 次 worker/通信 |
| 评测 | 15 次至第 75 步 | 起点 52.29%,峰值 65.13%,终点 63.20% |
| 数值修复 | 裁剪 $[-13,5]\rightarrow[-5,3]$ | 学习率 $5\times10^{-6}\rightarrow2\times10^{-6}$ |
| 部分撤回 | 撤回 FP32 残差 | 保留学习率、MoE 精度与其他约束 |
分析:角色分工究竟比通用智能体多做了什么
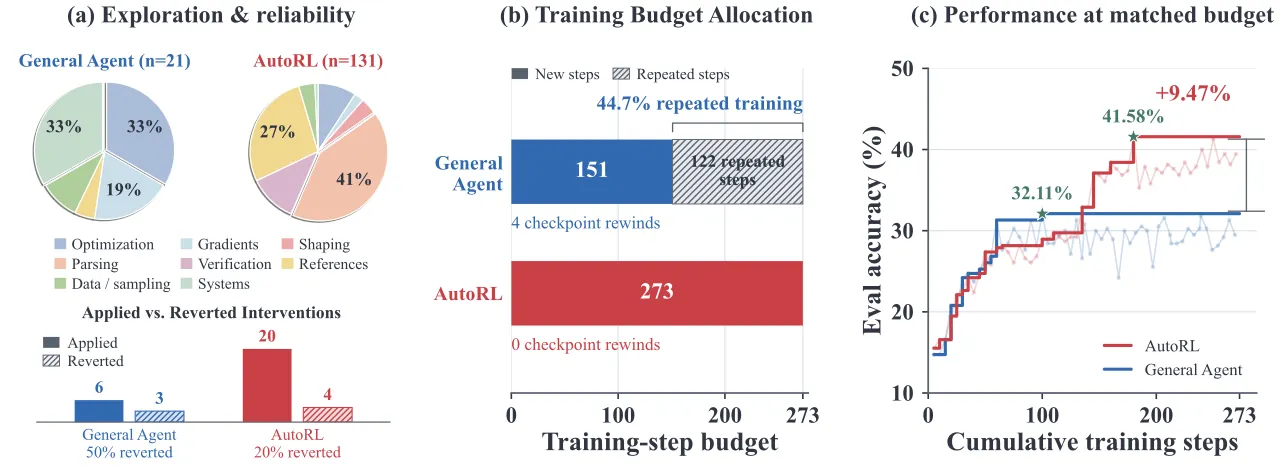
论文在相同 Qwen3-4B 任务上让 AutoRL 与原生 Codex 通用智能体共享初始模型、数据、评测协议和后端模型,并按累计完成步数对齐预算。AutoRL 达到 41.58%,通用智能体为 32.11%,相差 9.47 个百分点。通用智能体在第 100 个累计步附近取得最佳,AutoRL 则继续改进到第 180 步。
研究覆盖面差异很大。AutoRL 产生 131 个初始候选,覆盖八类目标;通用智能体产生 21 个设计提案,覆盖五类,主要集中于优化与系统配置。AutoRL 还大量检查回答解析、奖励验证和参考答案正确性,也就是学习信号的缺陷。273 步预算内,AutoRL 应用 20 个改动并撤回 4 个,通用智能体应用 6 个并撤回 3 个,撤回率分别为 20% 与 50%。
训练预算的使用方式更能解释收益。通用智能体四次回到早期检查点,最终只到达 151 个不同训练步;累计 273 步中有 122 步是在重复此前的数值索引,占 44.7%。AutoRL 在该主实验中通过 HOT 撤回四个改动,没有回滚检查点,因此 273 个累计步全部推进到不同索引。撤回一个控制项和重训一段旧轨迹,在模型质量与算力成本上完全不同。
计算预算可由保留步与重复步分解。论文定义累计预算 $B=U+R$,其中 $U$ 是不同训练索引数,$R$ 是重访数。通用智能体的 $U=151$、$R=122$,AutoRL 的 $U=273$、$R=0$。这里的 $B$ 是研究记账口径,不直接等价于墙钟 GPU 小时;初始化、采样、评测、等待、检查点和恢复仍需计入实际耗时。
$$B=U+R.$$
| 指标 | Codex 通用智能体 | AutoRL |
|---|---|---|
| 最佳准确率 | 32.11% | 41.58% |
| 初始候选 / 类别 | 21 / 5 | 131 / 8 |
| 应用 / 撤回 | 6 / 3 | 20 / 4 |
| 撤回率 | 50% | 20% |
| 不同训练步 | 151 | 273 |
| 重访步 | 122,占 44.7% | 0 |
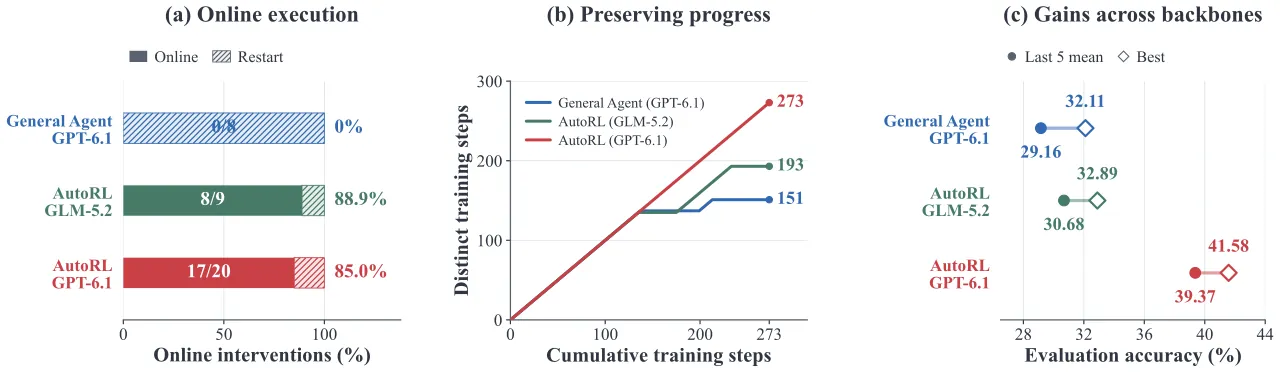
监督大模型本身仍然重要。把 AutoRL 后端从 GPT-6.1 换成 GLM-5.2 后,峰值从 41.58% 降到 32.89%,相差 8.69 个百分点;不过仍略高于 GPT 通用智能体的 32.11%。在共享预算内,最后五次评测均值分别是 GPT AutoRL 39.37%、GLM AutoRL 30.68%、通用智能体 29.16%。框架能提供执行通道,但无法完全弥补监督模型在问题发现和提案质量上的差异。
完整运行记录中,GPT AutoRL 的 20 次干预有 17 次 HOT,GLM AutoRL 的 9 次中有 8 次 HOT,通用智能体的 8 次改动全部通过重启执行。273 步比较中,GPT AutoRL 到达 273 个不同索引,GLM AutoRL 到达 193 个,通用智能体为 151 个。GLM 方案虽然研究范围较窄,仍比通用智能体少重访 42 步,说明角色分工与在线控制具有独立于后端模型的贡献。
局限性与风险
作者明确承认,当前智能体主要擅长在已有配方内调参、修复实现和局部改进奖励。131 个初始候选经过讨论后形成 51 个联合建议,编排器批准 28 个、推迟 21 个、拒绝 2 个,最终只有 20 个新改动进入训练。三个试图重新设计学习规则的候选没有一个被部署。这意味着系统还没有证明能够提出根本不同的强化学习算法。
监督模型能力构成第二项限制。GPT 与 GLM 的峰值差 8.69 个百分点,而研究记录显示 GPT 更常检查解析、奖励验证与参考答案,GLM 更偏向优化和奖励塑形。AutoRL 可以缩短“想法到执行”的距离,却不能保证后端模型想到正确实验。若把系统用于更高风险训练,仍需对提案分布和能力上限做独立评估。
评测虽然固定,训练奖励却能变化,因此存在奖励投机风险。评分器修复可能真实纠正错误,也可能意外放宽某些答案;论文通过保留评测协议、审查候选和记录训练评分器改动降低风险,但并没有给出形式化保证。自动系统需要在奖励可修改时持续检查训练集与评测集之间的偏差,尤其要防止对评测格式或答案模式过拟合。
外部有效性还受模型与任务范围限制。主要证据来自 Qwen3 两个尺度和 LongCat-Flash-Lite,任务集中于数学推理与仓库级编码。机器人控制、具身交互、离线强化学习和多模态环境中,状态更嘈杂,仿真器更昂贵,奖励更难修复,无法直接假定同一套感知器和提案器仍然有效。对 Agientry 的大语言模型栏目,这篇论文的价值属于通用训练自动化,而不是机器人策略学习实验。
资源成本也需要单独核算。系统同时运行多个长期智能体会话,进行日志读取、代码检查和辩论;论文报告了 GPU 布局、训练步与墙钟时间,但没有给出完整的监督 token 成本、人工维护成本与每次正确干预的边际收益。若一个提案需要大量智能体计算才能避免一次短训练,过程级自动化的经济性可能不如静态配方搜索。
可观测性同样有边界。感知器依赖日志、指标和评测摘要,隐藏状态或缺失日志会让诊断建立在错误证据上;共享记录能保留来源,却不能自动发现所有记录偏差。两周长跑证明了故障恢复能力,但仍可能出现“训练继续、模型质量悄悄退化”的软故障。未来系统需要更强的反事实比较、统计功效估计和独立审计,而不只是检测 NaN 或曲线停滞。
总结与展望
AutoRL 的主要贡献是把自主强化学习从“让智能体启动一个实验”推进到“让智能体在实验运行中维护研究状态”。感知角色持续发现信号,提案角色从同一证据独立诊断后辩论,编排器用 HOT 与 COLD 两条路径执行,检查点谱系和运行时回执再把新证据接回下一轮判断。这个闭环同时处理了上下文分工、昂贵验证和可逆执行三个问题。
实验支持三项有限结论。第一,专门化监督在 Qwen3-4B 的九项基准上超过静态 GRPO 与通用智能体。第二,过程级干预能够修复一个早期正常、后期退化的配方,并在 Qwen3-4B 的长期平台期后恢复提升。第三,编码任务在 352.5 小时、11 次故障中保持 pass@1 增长。它们共同说明,长时间无人训练的瓶颈不仅是启动脚本,而是持续解释状态、选择小改动并保留学习进度。
论文同样清楚暴露了边界:系统会调参、修错和改善局部奖励,却尚未自动提出基础学习算法;监督模型决定研究质量;评测与训练奖励分离仍是安全关键;资源成本没有被完整核算。下一步最有价值的方向,是让系统主动设计更高信息量的对照实验,估计改动的不确定性,并在更广泛的任务域中验证“过程级自动化”是否仍能保持收益。
金句:自主强化学习真正难的不是让智能体改一个超参数,而是让它在训练不断改变自己证据的同时,仍能判断哪一次改动值得保留。