PAPER DEEP DIVE
视觉语言动作模型谷歌具身智能
RT-2: 视觉-语言-动作模型将网络知识迁移到机器人
RT-2 将预训练视觉-语言模型转化为机器人策略,使机器人能根据自然语言指令执行未见过的操作,展现强大的零样本泛化能力。
RT-2 将预训练视觉-语言模型转化为机器人策略,使机器人能根据自然语言指令执行未见过的操作,展现强大的零样本泛化能力。
PAPER DEEP DIVE
RT-2 将预训练视觉-语言模型转化为机器人策略,使机器人能根据自然语言指令执行未见过的操作,展现强大的零样本泛化能力。
RT-2 将预训练视觉-语言模型转化为机器人策略,使机器人能根据自然语言指令执行未见过的操作,展现强大的零样本泛化能力。
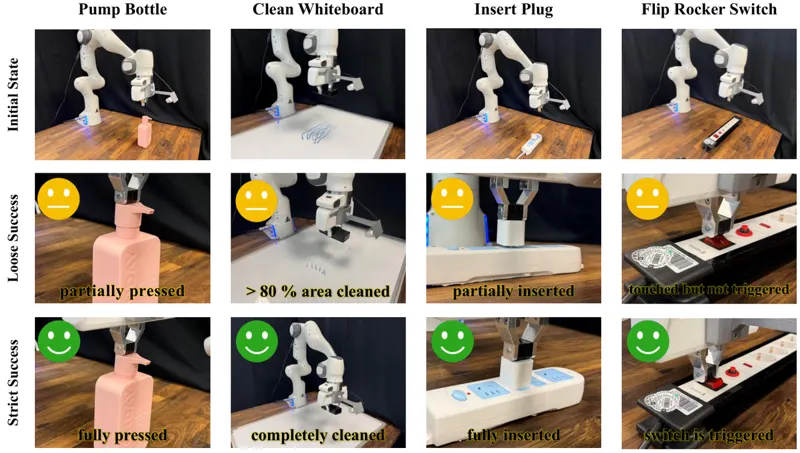
VT-Bridge 不改动预训练 VLA 的架构,只在其预测的动作块之上外挂一个 0.98M 参数的触觉残差适配器,以机器人执行频率逐步修正动作:骨干低频推理(π0 每块 153.1 ms),适配器单步 0.7 ms,两者在同一块 GPU 上时间片交错,互不抢占算力。每个任务最多 50 条双边遥操作视触演示即可完成 LoRA 微调骨干与训练适配器;残差监督取遥操作记录的期望位姿而非实际执行位姿,以补偿阻抗控制下 4-5 cm 的接触偏移,非接触样本的残差目标置零。在 π0、π0.5、SmolVLA 三个骨干与 Pump Bottle、Clean Whiteboard、Insert Plug、Flip Rocker Switch 四个接触密集任务上,平均严格成功率从 11.7% 提升到 62.9%,条件完成率提升 58.8 个百分点,12 个任务-骨干组合全部最优。代码正在整理开源。
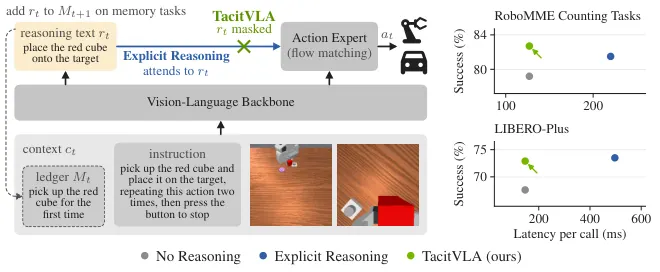
TacitVLA 让动作专家从不关注本次生成的推理文本:训练阶段仍用推理监督塑造骨干表征,部署阶段把记忆台账的生成挪进动作执行窗口。四个基准上与显式推理精度相当而单次调用延迟最多降 3.4 倍,RoboMME 计数 82.7%、RMBench 77.5% 均超过已发表最好成绩。
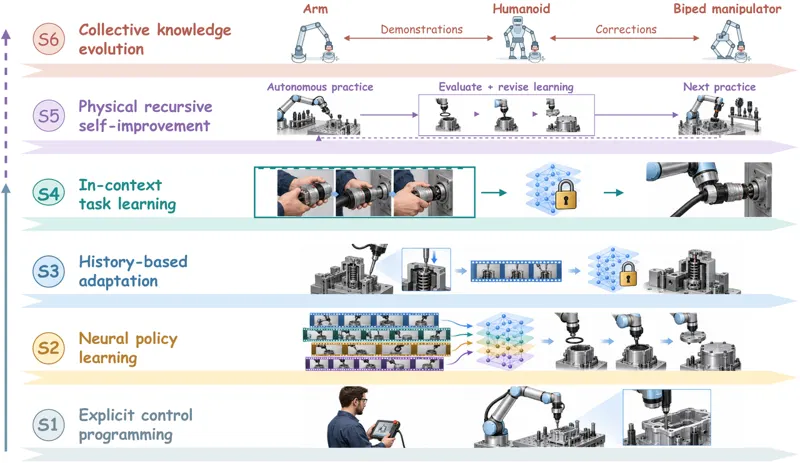
通用机器人必须推断新任务的要求,并把这种理解转化为恰当的物理动作。机器人上下文学习(ICL)用示范与交互来引导已有能力,并在部署期间冻结神经参数。这份综述围绕「把上下文证据连接到执行」的接口来组织文献,区分出四大家族:上下文条件策略、几何示范迁移、基于世界模型的控制、技能与智能体执行。比较这些接口可以厘清各自的迁移假设,以及训练、对应关系与记忆在让上下文变得可用时扮演的角色。在操作与导航两类场景中,我们考察当物体、环境与执行条件发生变化时,这些机制如何保留教学所设定的要求。这一分析把方法设计与评测实践连接起来,区分「对教学敏感」「物理可迁移」与「从保留经验中获益」三种不同的主张。由此形成的研究议程把组合式任务获取与忠实迁移,同物理递归自我改进联系起来——在后者中,经验提升的是学会后续任务的能力。全文逐条编码 412 条参考文献(其中 260 条为方法类),并记录 14 组已报告对照。
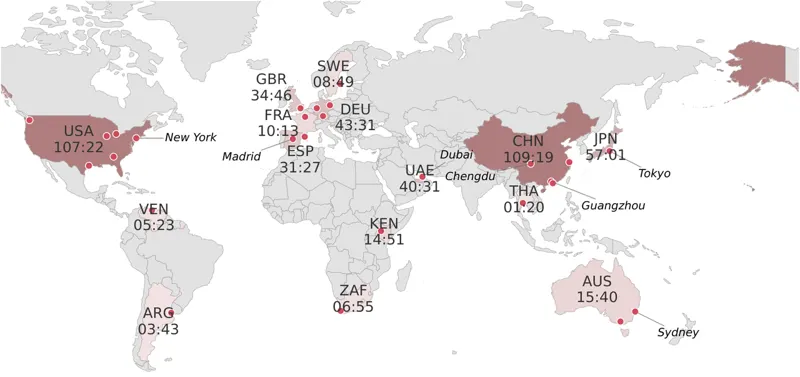
把 500 小时、横跨 30 座城市的网络步行视频自动重建成度量轨迹并标注「感知—分析—规划」推理,训出推理感知的点目标城市导航模型 WILD-Nav;再用分布稀有度与模型难度两条互相独立的轴把长尾从聚合指标里剥离出来,用特权反思把失败归因到具体推理与规划环节,并给出「困难样本微调 + 随机回放」这一尾部收益与整体保持之间的最佳平衡。
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。