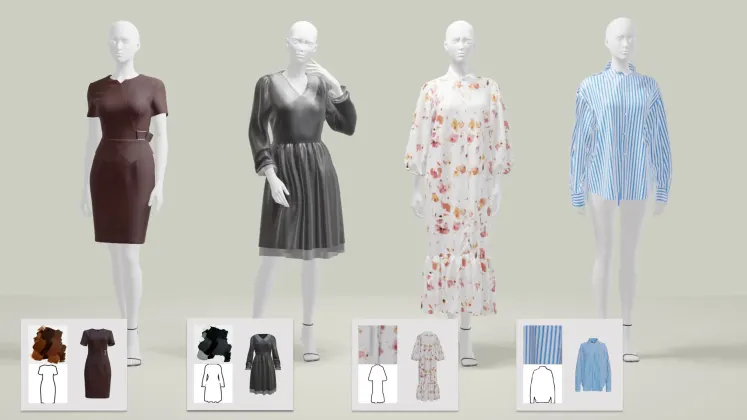
提出Fashion-3DLR,基于成对时尚元素实现可控3D服装生成,服务于3D内容生成与数字人/机器人外观建模。
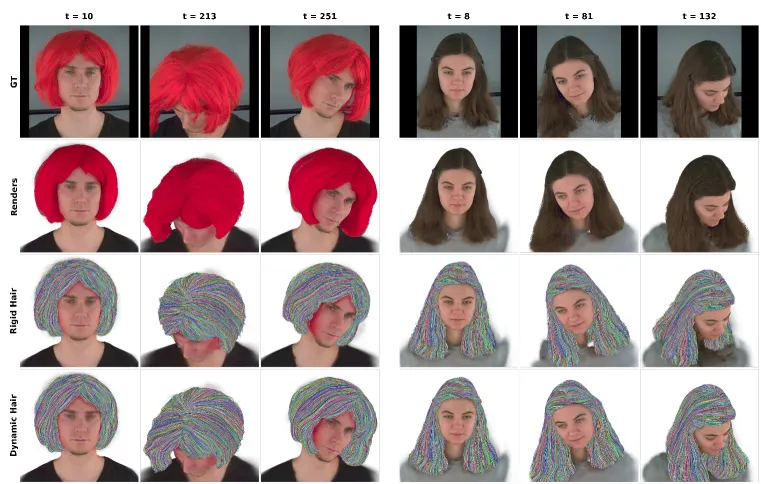
提出带动态显式头发的人头部化身方法,服务于3D人体建模与数字人,属3DGS/CV交叉。
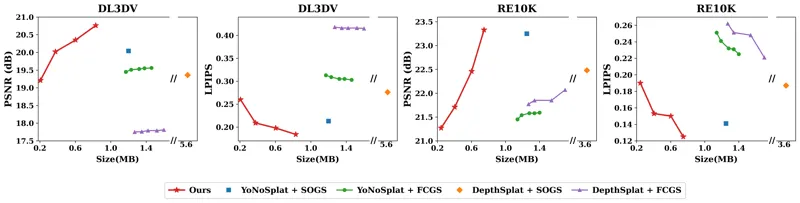
提出GenSplatCodec,通过一步扩散实现前馈3D高斯泼溅压缩,降低存储与传输开销,服务于3DGS高效部署。
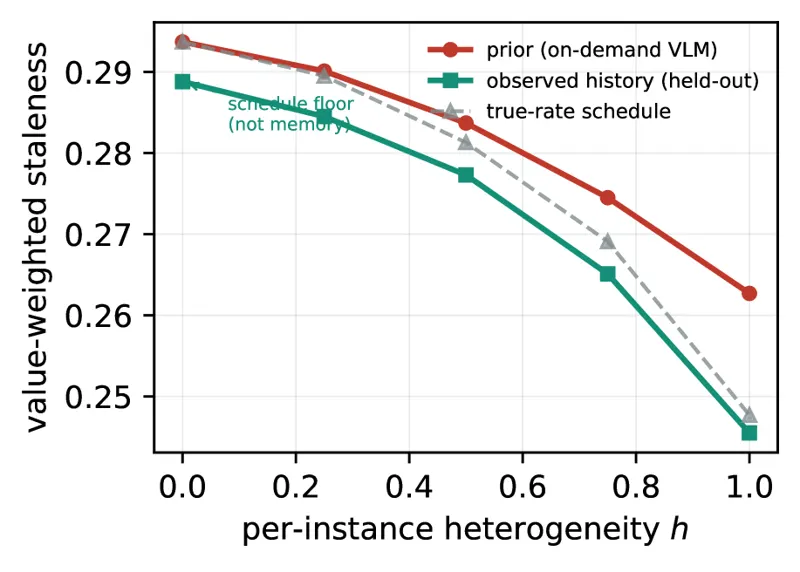
提出去冗余过程记忆方法,支持跨回合探索的试一次即最优,提升agent在长时程任务中的探索与决策效率。
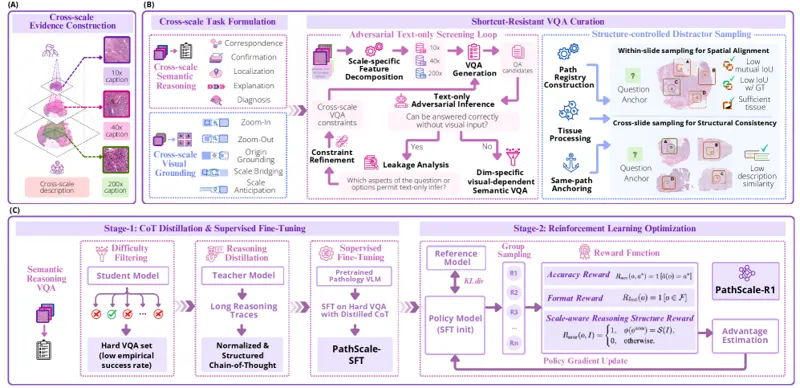
提出PathScale-R1,面向病理图像分析的跨尺度推理方法,属于医学CV与多模态推理交叉。
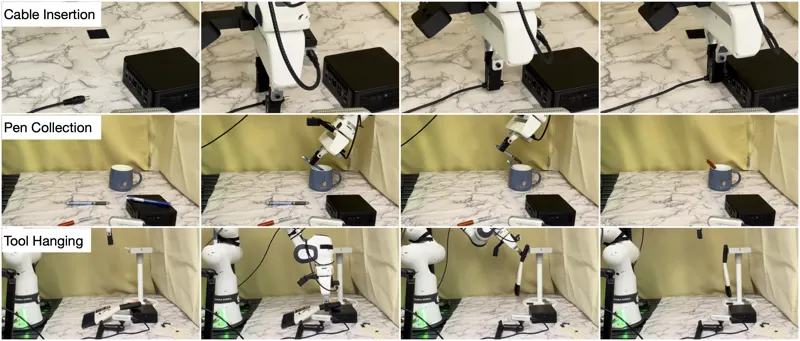
提出语言条件的再感知方法,基于视觉-语言模型实现注意力引导的再感知,服务于机器人视觉感知与VLM。
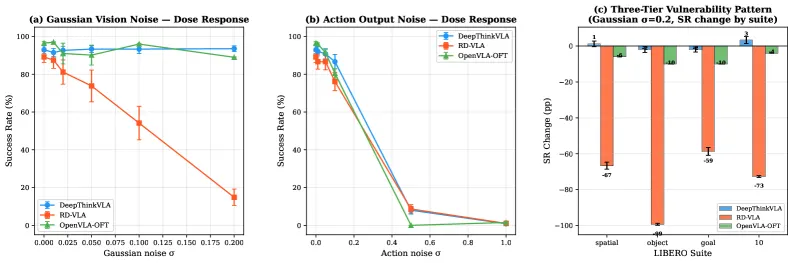
研究视觉语言agent中推理的架构与跨阶段鲁棒性,分析推理作为双刃剑的利弊,服务于VLA与agent设计。
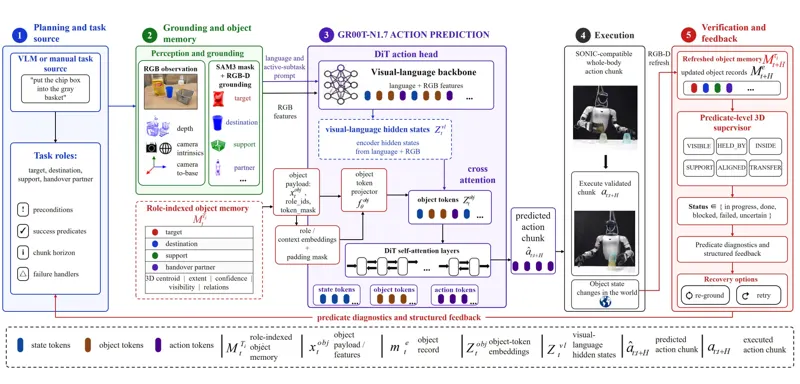
提出持久物体令牌化(POT),从RGB-D观测维护角色索引3D物体记录并转换为动作专家的物体令牌,实现动作生成与几何谓词检验的闭环执行。POT-VLA在Unitree G1上将GR00T-N1.7基线从39/80提升至71/80,在Being-0对齐服务任务上达44/50。
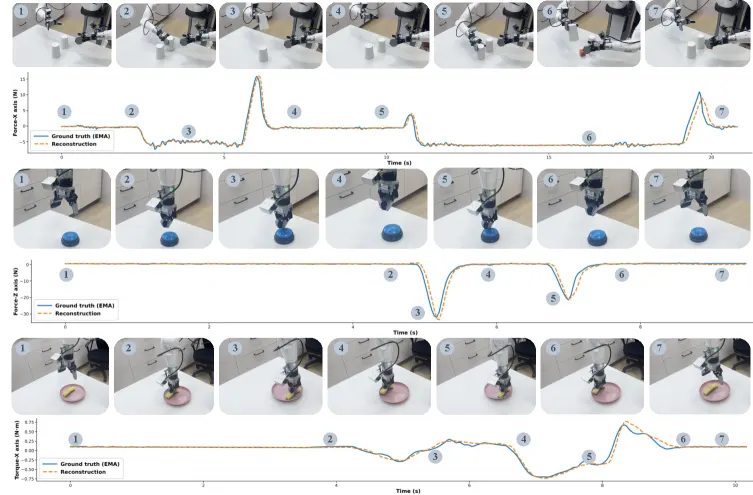
提出基于力觉记忆的 VLA 模型,用 VAE 将力时序编码为紧凑记忆 token,注入动作专家模块,使模型能利用累积接触事件历史引导非马尔可夫接触丰富操作,在隐藏方块、按钮按压、擦拭盘子三个记忆依赖任务上超 80% 成功率。
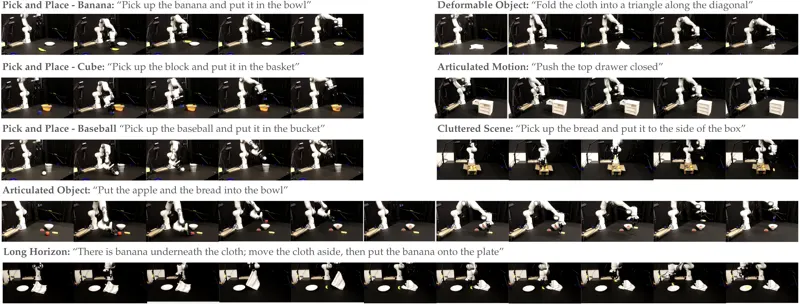
Patch Policy 提出一种轻量 Transformer 策略架构,直接消费冻结预训练 ViT 的稠密 patch 特征,避免全局池化带来的空间信息损失,也不需要亿级参数 VLM 的推理开销。其核心是 block-causal 注意力掩码:帧内 patch 全注意力,帧间严格因果,从而兼容 VQ-BeT、Diffusion Policy 等标准策略头。实验表明,在四个仿真和三个真实操作任务中,Patch Policy 相对全局特征策略平均提升 40%,并超越微调 OpenVLA-OFT 约 18%,同时参数量仅为后者的约 0.7%。
研究语言引导的机器人策略合成,证明少量语言指令即可显著提升机器人策略的泛化与组合能力。
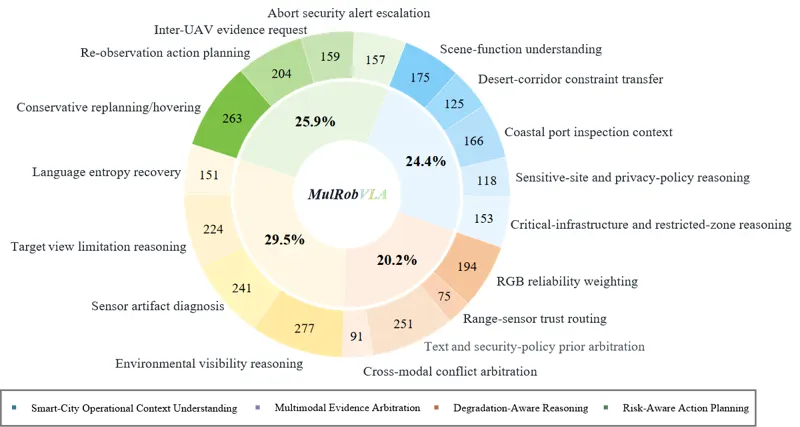
提出MulRobBench,面向多机器人安全与安全策略合规的决策级基准,评估多机器人系统的安全决策能力。