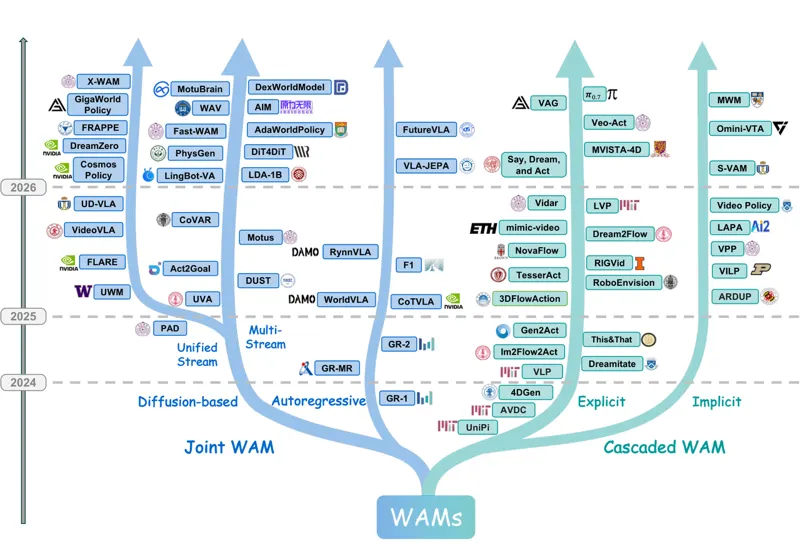
提出世界行动模型 (WAMs),统一状态预测与动作生成,弥补 VLA 局限。构建分类体系并分析数据生态。
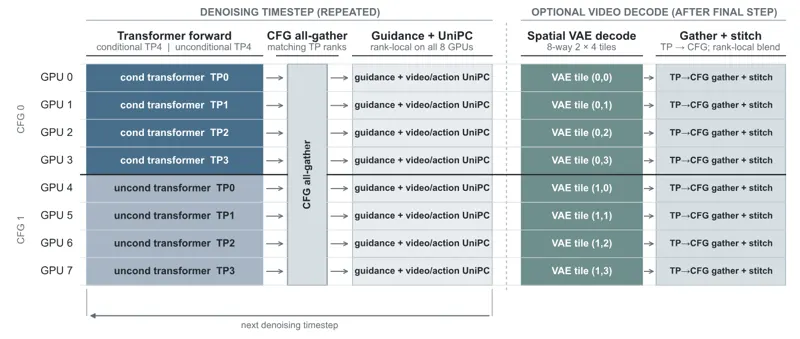
统一推理运行时,让 VLA 与世界动作模型在机载/边缘/云端共用同一套代码完成评估、RL rollout 与部署;较 pi0、pi0.5、GR00T N1.7 等官方实现提速 1.40–4.65 倍。
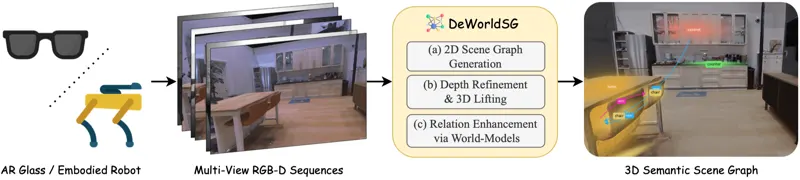
DeWorldSG从RGB-D序列生成时空鲁棒的3D语义场景图。通过深度引导滤波估计实例级几何3D高斯分布,将每个物体表示为概率3D节点而非单点投影;跨物体对聚合时空证据并用世界模型(V-JEPA 2)的上下文先验精炼关系。三元组召回率提升77.4%,谓词召回率提升23.2%。
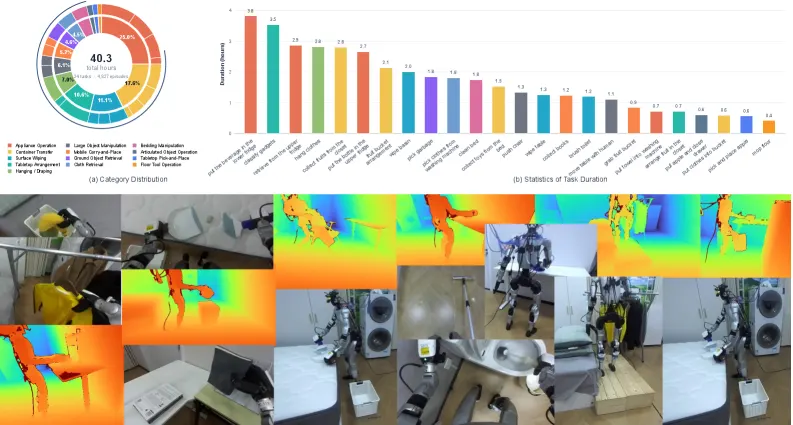
提出ω-0,面向真实人形机器人协同移动操作的全身世界动作模型:给定语言指令、视觉观测与本体状态,直接预测控制器可执行的全身动作潜变量;以轻量未来观测嵌入预测替代视频重建,耦合潜空间视觉预见与扩散式全身动作生成;并采集40+小时真机数据集ω-HOME,在11项家庭任务上稳定超越IL/VLA/人形/WAM基线。
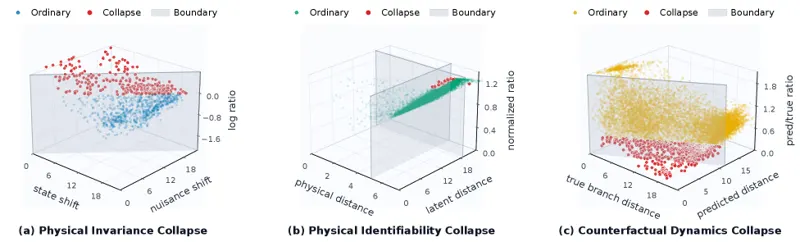
本文提出PhyLatent,用SVIC、PSG、FRA、CASC和LD约束JEPA潜空间,解决物理不变性、可辨识性与反事实动力学塌缩;Cube MPC成功率从70.0%升至78.1%。
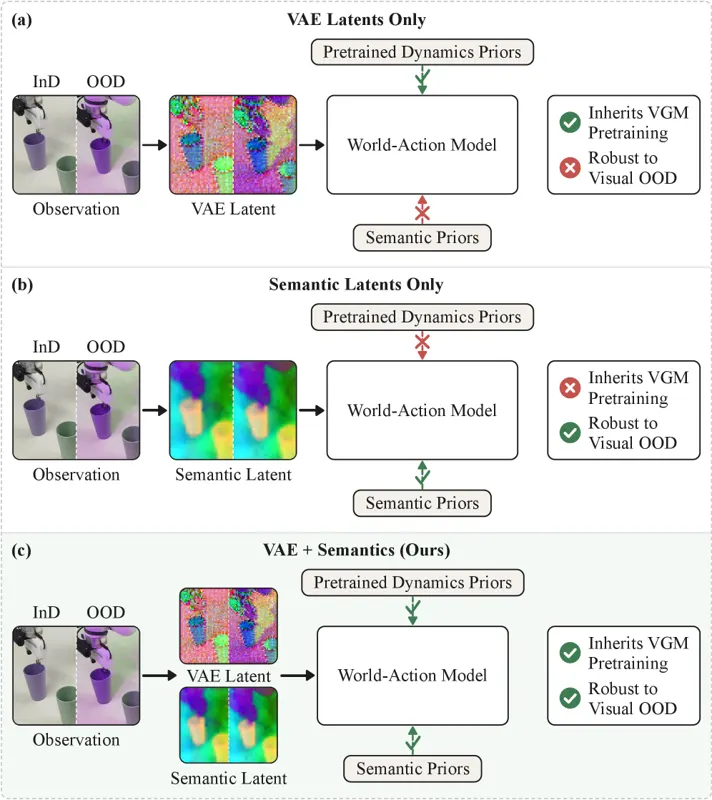
提出视频生成式世界-动作模型的通用后训练方法,保留 VAE 潜空间的生成路径并添加轻量语义前瞻对齐目标,用可学习查询 token 将未来场景语义引入动作流,使动作基于外观不变的动态表示,在 OOD 泛化仿真和真机上持续提升多种 WAM 基线成功率。
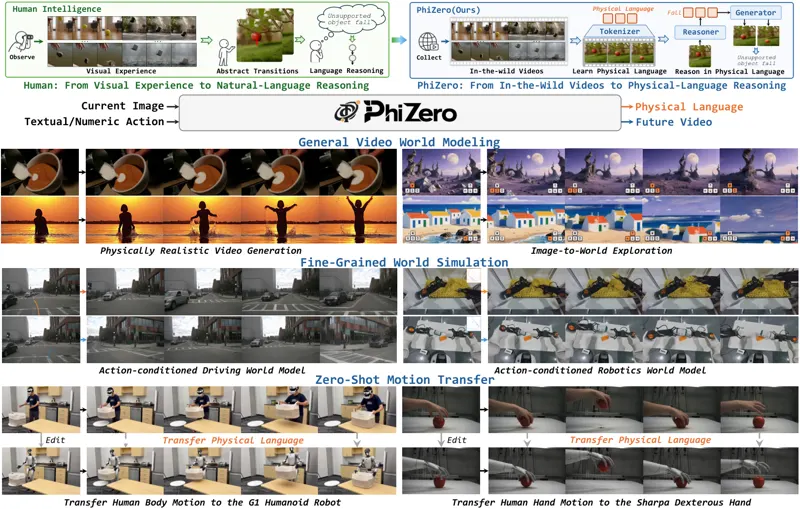
提出物理语言——世界状态转移的紧凑离散表示。PhiZero 采用先推理后渲染范式:先从真实视频自监督学习物理语言,推理出未来世界演化的语言序列,再渲染为视频;在生成与理解基准上验证了物理一致性,并展示交互式建模、细粒度动作条件仿真与零样本运动迁移的潜力。
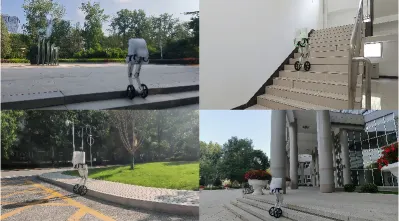
在并发师生框架中引入世界模型(深度残差网络预测未来地形状态)和动量目标编码器(BYOL 式 EMA),通过预测损失强制教师编码器学习时空感知表示,为 student 提供稳定蒸馏目标,解决连续楼梯平滑运动问题。
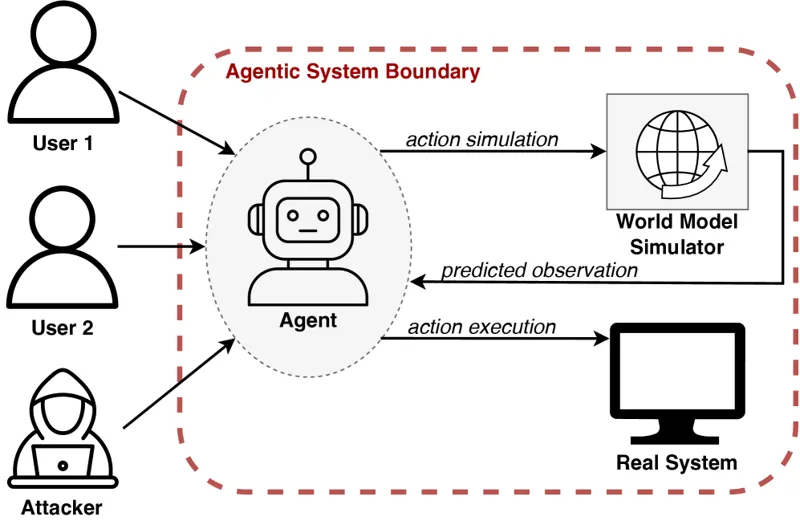
研究agent系统中世界模型的安全性问题,分析世界模型可能成为假先知的风险,提出安全评估与防护方法。
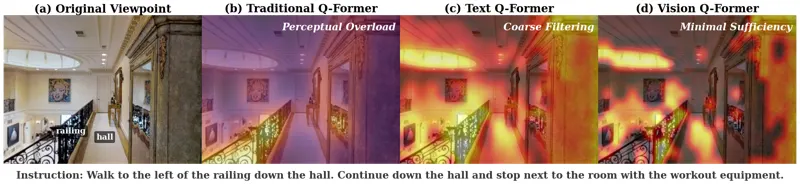
提出双脑最小充分表示方法,用于视觉-语言导航,在效率与性能间取得平衡,提升具身导航的泛化。
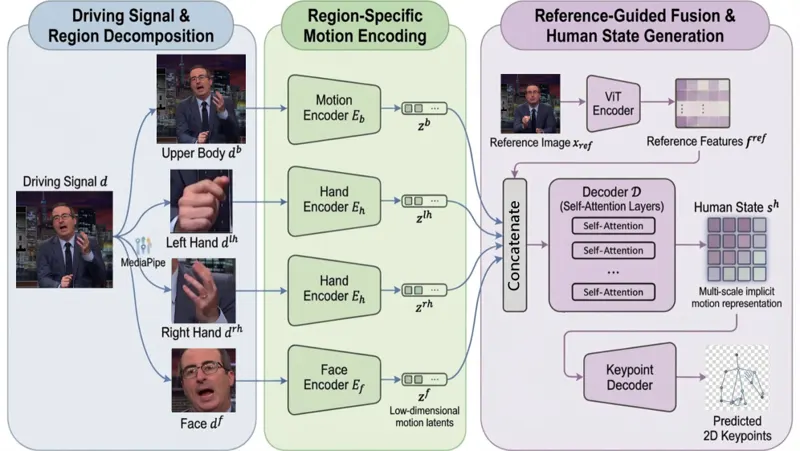
提出实时以人为中心的世界建模方法,针对上半身人物-物体交互,服务于人形机器人交互与世界模型。
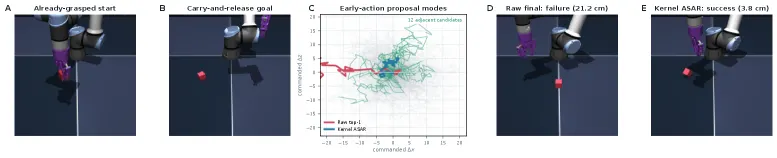
研究在世界模型中,物理空间相邻集合的动作策略优于最佳预测,为世界模型动作生成提供新视角。