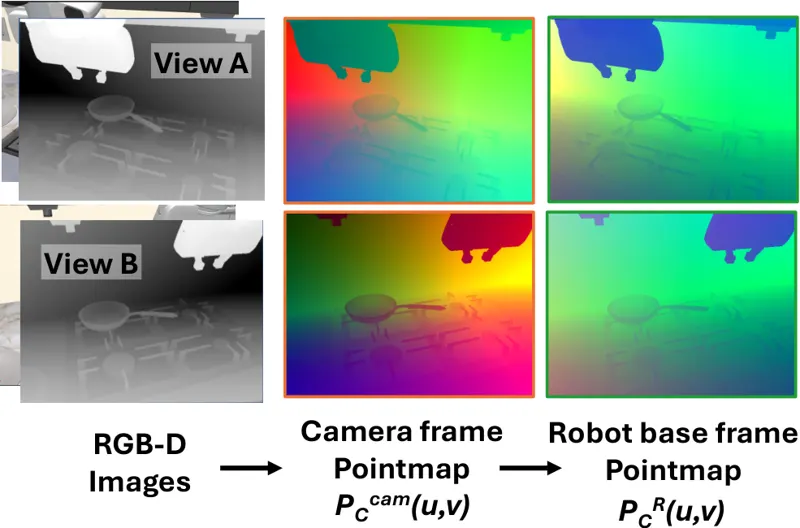
本文通过引入机器人中心点图(pointmap)解决VLA模型中相机帧观测与机器人帧动作之间的坐标系不匹配问题。点图的像素存储场景点在机器人坐标系下的3D坐标,在保留图像结构的同时提供机器人帧3D几何,使策略能跨不同相机设置泛化。
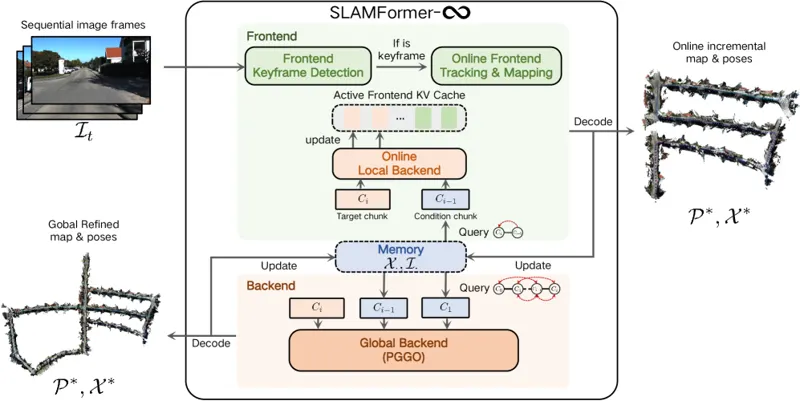
我们提出无限SLAM变换器(SLAMFormer-∞),首个能同时支持长程前端和后端处理且无需显式距离边界的几何变换器。SLAMFormer-∞采用记忆条件定义灵活的坐标系和尺度,而非依赖首帧锚定。基于此,前端保持高效局部计算,后端联合优化长程轨迹和场景几何,实现全局一致性。实验表明SLAMFormer-∞在大规模数据集上的轨迹估计和场景重建均取得优越或极具竞争力的性能,并能泛化到超过17公里的极长轨迹。
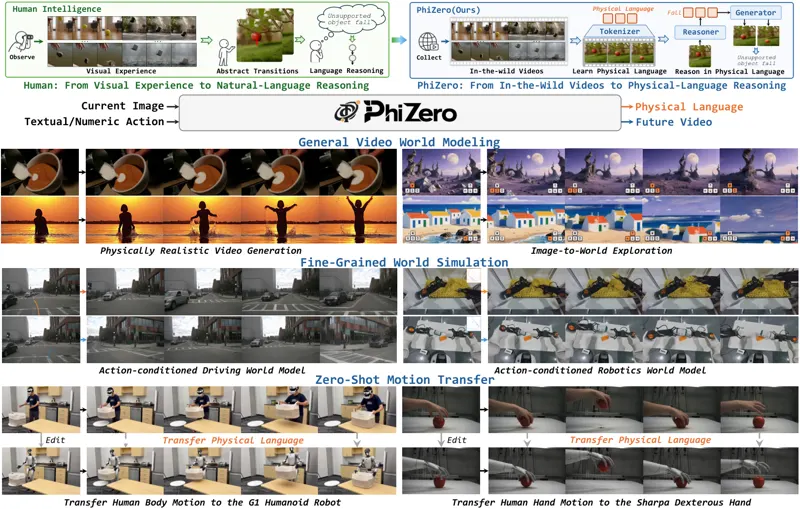
提出物理语言——世界状态转移的紧凑离散表示。PhiZero 采用先推理后渲染范式:先从真实视频自监督学习物理语言,推理出未来世界演化的语言序列,再渲染为视频;在生成与理解基准上验证了物理一致性,并展示交互式建模、细粒度动作条件仿真与零样本运动迁移的潜力。
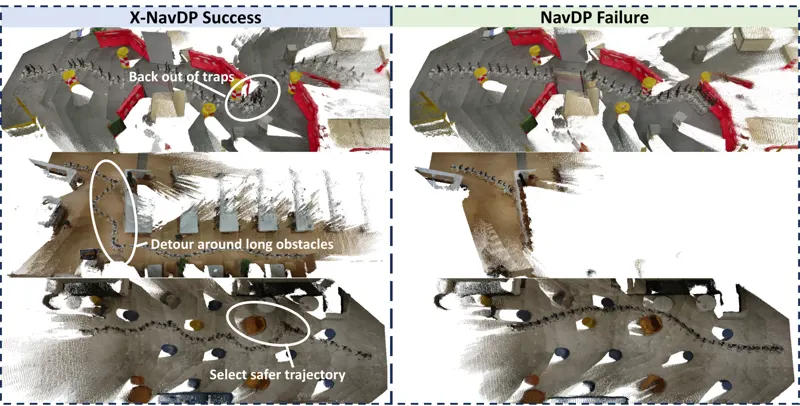
提出GQRM强化学习后训练框架,通过自举探索与群组Q值归一化机制对导航扩散策略进行跨本体微调,仿真成功率从61%提升至84%,真实世界从10%提升至65%。
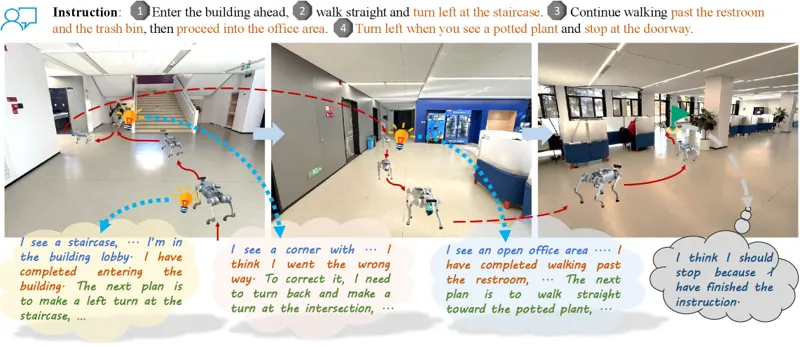
视觉语言导航(VLN)要求智能体将语言指令与自身在视觉环境中的运动进行关联。当前最先进的方法利用视觉语言模型(VLM)的推理能力进行端到端动作预测,但往往缺乏对智能体自身状态、指令和场景之间关系的显式且可解释的理解。另一方面,显式构建场景图进行启发式规划虽然直观,但依赖额外的3D传感器并阻碍大规模视觉语言预训练。为弥合这一差距,我们提出 AwareVLN,一种赋予导航模型自感知推理机制的新框架,使其能够以完全端到端和数据驱动的方式理解智能体状态和任务进度。该方法包含两项关键创新:(1)一个结构化推理模块,培养空间和任务导向的自感知能力;(2)一个带有进度划分的自动数据引擎,用于有效训练。在 Habitat 仿真器中多个数据集上的大量实验表明,AwareVLN 显著优于先前最先进的视觉语言导航方法。
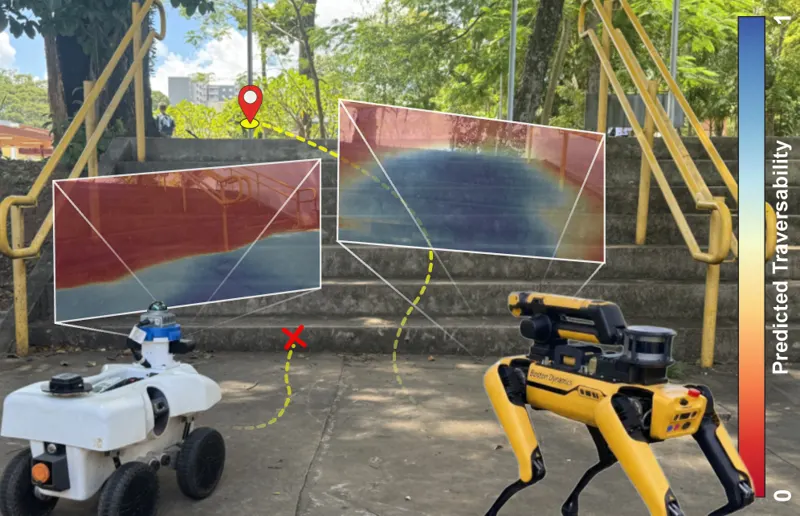
提出能力感知的可通行性导航方法,在非结构化环境中根据机器人能力评估可通行性,提升导航鲁棒性。
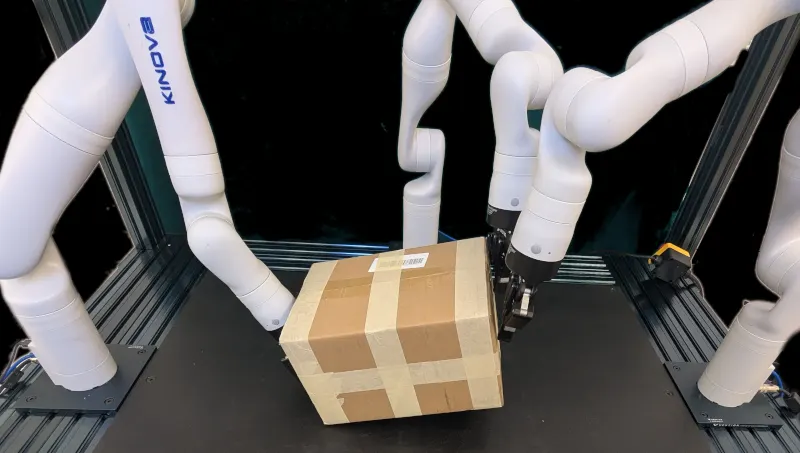
提出通过搜索分配与零空间体现多手操作策略的方法,提升多手/多指机器人操作的协调与泛化。
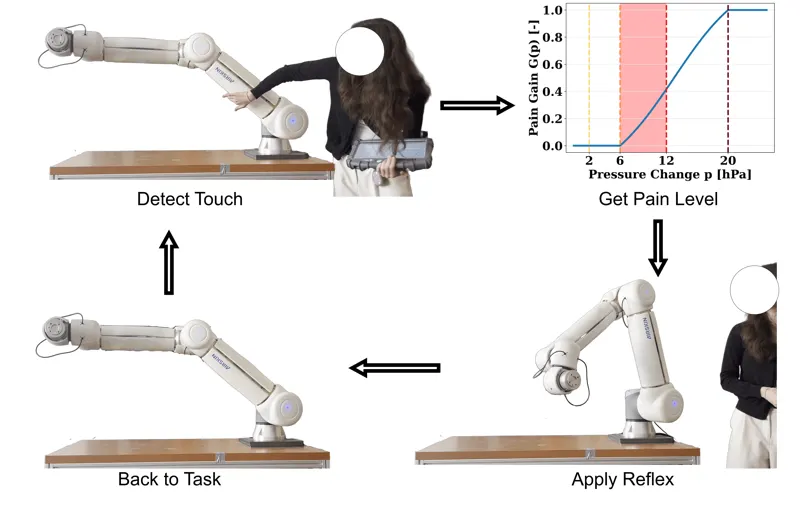
设计覆盖皮肤机器人的触觉撤回反射,并进行人因评估,服务于安全人机交互与触觉感知。
提出MEMENTO,记忆引导的模因代码即策略进化方法,将代码即策略与记忆机制结合,提升agent长时程任务能力。
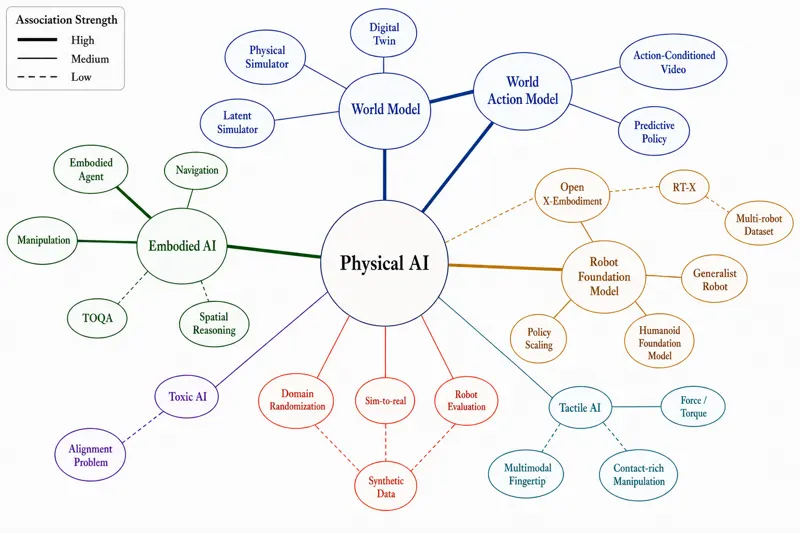
研究物理AI(具身AI)的治理,从理论到实践贯穿全生命周期,涵盖实时安全约束与人机交互,服务于具身智能的负责任部署。
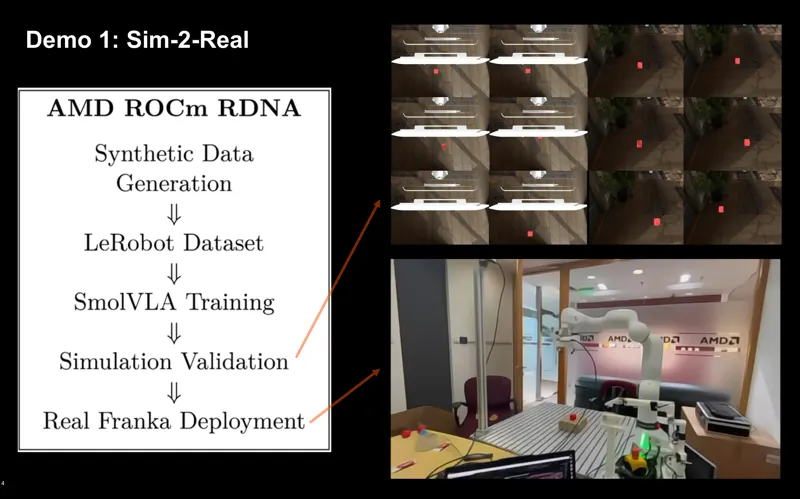
提出基于AMD ROCm的Real2Sim2Real流水线,服务于视觉-语言-动作操作,降低VLA训练与部署的硬件门槛。
提出WCM世界-认知模型,面向可泛化人机交互,超越VLA与世界模型规划器的指令执行局限,提升机器人交互的认知能力。