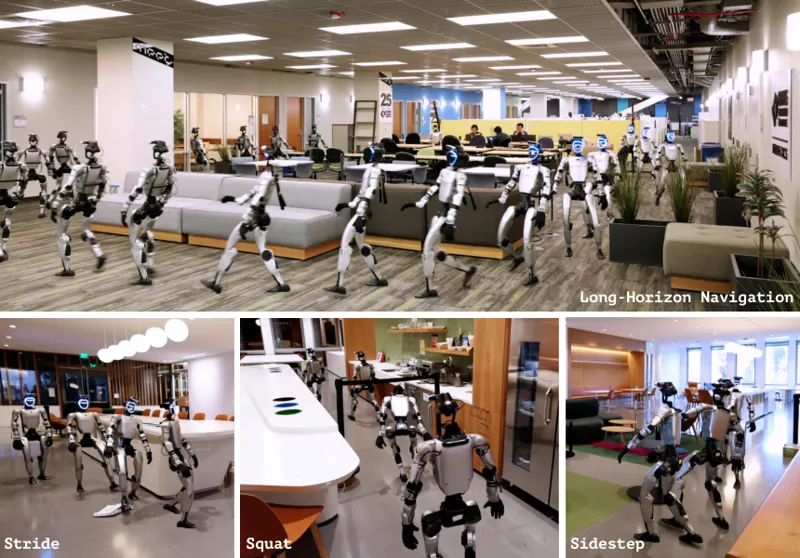
人形机器人在杂乱室内的导航不是 2D 路径规划问题:身体的几何形状在运动中持续变化,穿过狭窄通道需要手臂摆放、躯干调整与步态调制的连续协同。TANGO 是首个面向杂乱环境语言条件通行的全身视觉-语言-动作框架,输入自然语言指令与第一视角 RGB 观测,直接预测 29 自由度关节空间动作块交给下游全身控制执行。训练数据全部在仿真中合成:Plan-Edit-Track(PET)管线用全局路径规划、运动学全身动作生成、障碍感知动作编辑与强化学习跟踪自动产出 64,633 条动力学可行的无碰撞通行轨迹,仅耗 211 GPU 小时。TANGO 在 VLNVerse 上取得 54.69 / 52.89 的 seen / unseen 成功率,是对比方法中唯一具备真实物理控制能力的,并把杂乱场景碰撞率压到 9.90%(最强基线 15.81%,且对方额外使用了 LiDAR)。零样本部署到 Unitree G1 后,可在真实杂乱场景中完成语言引导通行,无需任何真实导航数据。已被 CoRL 2026 接收。
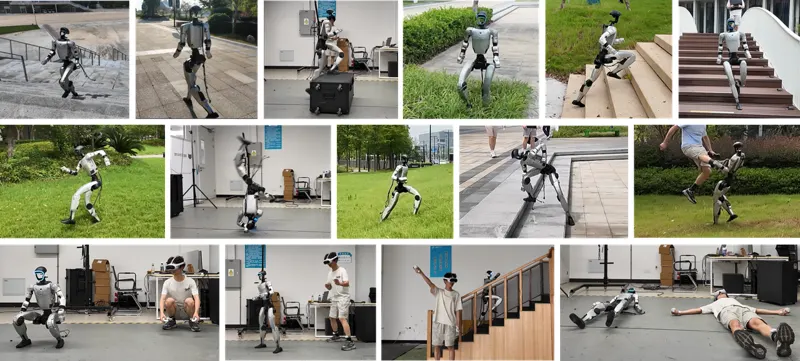
人形动作跟踪器已能复现多样的全身动作,但一旦地形复杂起来,地形无关的参考动作常常物理不可行——参考要求右脚落在某处,而那里恰好是台阶棱或石块。PGMT 把地形适应做成跟踪策略自身的能力,而不是上游参考动作生成器的负担:第一阶段在平地上用 LAFAN1 人体动作学出通用的跟踪与跌倒恢复先验;第二阶段通过「动作条件化的地形一瞥」把高程图中与当前动作真正相关的区域稀疏注入意图融合模块,并用地形感知的跟踪松弛允许必要偏离、同时保住参考动作的意图。整套流程不需要任何「动作—地形」配对数据,任务完成率从 40.02% 提升到 87.81%(最难的 L9 档从 35.31% 提升到 83.33%)。在 29 自由度 Unitree G1 上零样本部署,可跨越 37 cm 高障碍箱、在楼梯上慢跑与冲刺、完成侧手翻并自主起身,同时支持遥操作与动态动作跟踪。
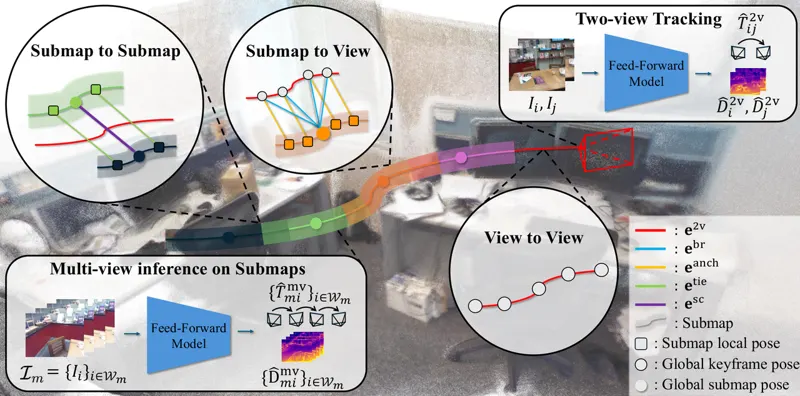
几何基础模型(DUSt3R、VGGT 等)让 SLAM 第一次可以前馈推理,但它们的预测强依赖输入视角配置:同一帧图像与不同共视帧一起推理会得到不同的尺度与位姿,长序列串接时几何不一致与轨迹漂移由此而来。UniSim-SLAM 把经典 SLAM 的「前端里程计 + 后端优化」架构搬到前馈模型上——前端跑轻量两视关键帧跟踪保证低延迟,后端周期性做多视子图精化补充约束,再用一张统一的 Sim(3) 多层因子图把定义在异质局部坐标系、尺度互不一致的预测联合优化:图中包含时间序的视-视里程计边、带深度统计尺度锚定的视-子图桥接边,以及子图间的连接与尺度约束。在 TUM RGB-D 与 7-Scenes 上,未标定设置下的轨迹误差分别比此前最好结果降低 38.5% 与 45.9%。已被 ECCV 2026 接收。
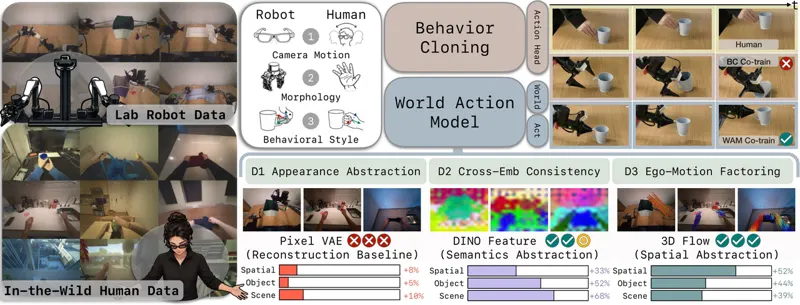
把骨干、动作头与数据配比全部锁死,只换世界模型的预测目标:像素几乎不迁移,DINO 让分布外物体与场景泛化最多提升 4 倍,相机稳定 3D 流让域内提升 20–30%,而推理时世界模型头被整个丢掉,部署成本与行为克隆相同。
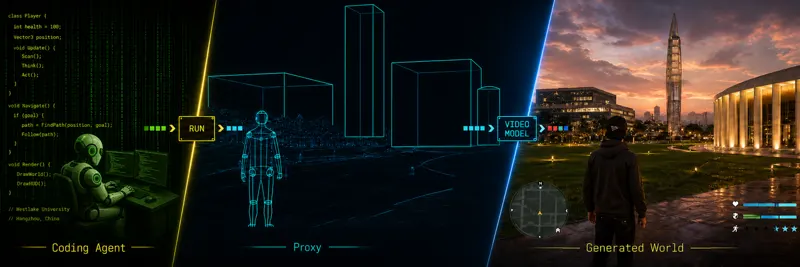
编程智能体以可执行代码维护持久世界状态,代理视频传递逐帧时空约束,视频模型负责高保真视觉实现。
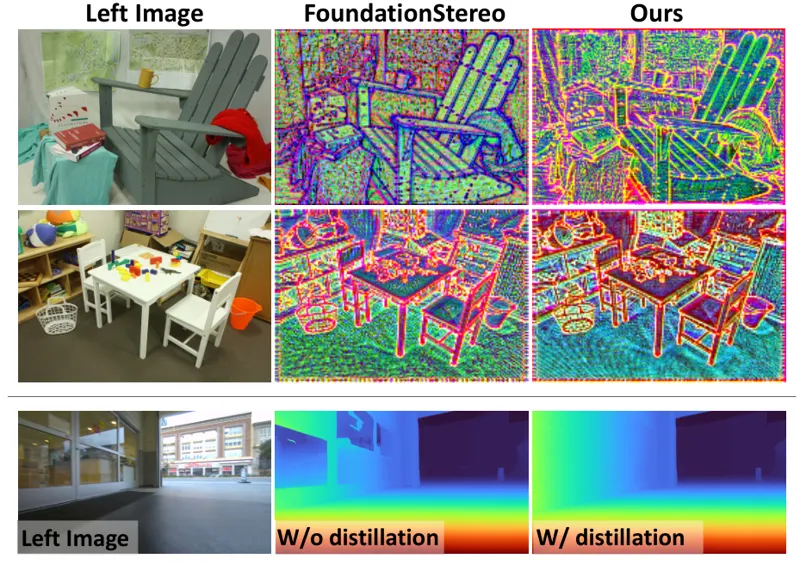
NVIDIA 用分而治之的加速策略把 FoundationStereo 拆成特征提取、代价滤波、视差精化三段各自提速:知识蒸馏压缩混合骨干、块级神经架构搜索在延迟预算内自动配出代价滤波网络、结构化剪枝精简迭代精化模块,再用 140 万对自动伪标注的真实立体图像补训。模型比 FoundationStereo 快 10 倍以上,零样本精度几乎追平,在 Middlebury/ETH3D/KITTI 上是实时立体匹配的新 SOTA。
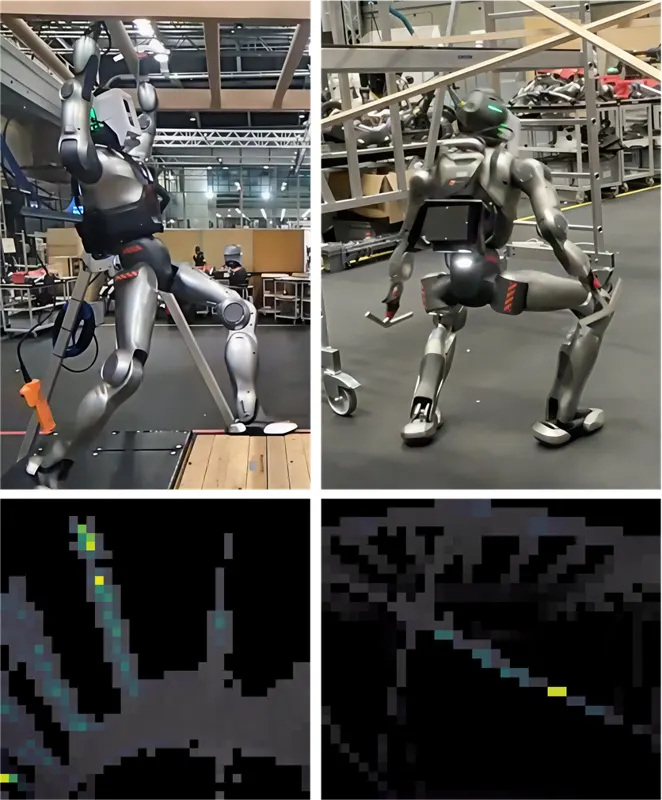
ETH RSL 让人形机器人只靠头部固态激光雷达原始回波完成跳上云梯、臂行横越、跳下落地的完整序列:三个特权教师经相位调度蒸馏为一个注意力感知学生,配合电池压降、电机热极限与雷达噪声建模,硬件 15 次成功 14 次,臂行速度 0.5 m/s。
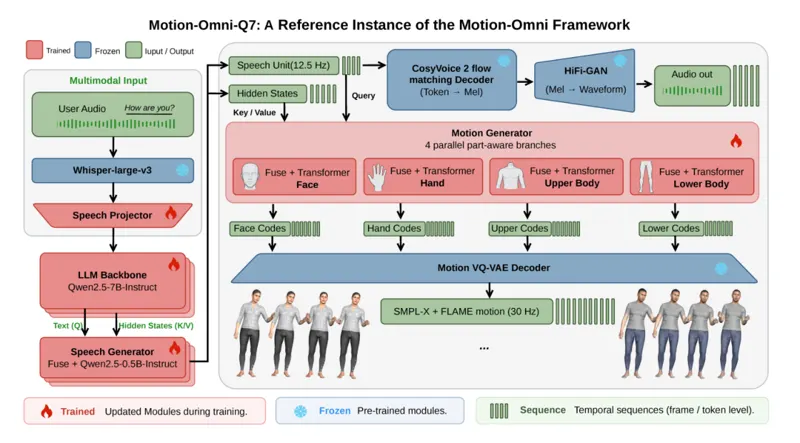
把动作输出从级联改成原生:一个 7B 主干在说话的同时生成面部、手、上肢、下肢动作,响应比教师级联快 5.4 倍,无参考动作指标差距在 2% 以内。
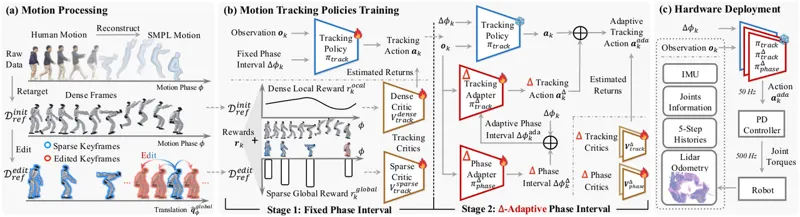
AdaMimic 把单条参考动作稀疏成关键帧并轻量编辑,先训跟踪策略,再冻结策略学相位与跟踪适配器,实现时间扭曲式可适配人形控制,已部署 Unitree G1。
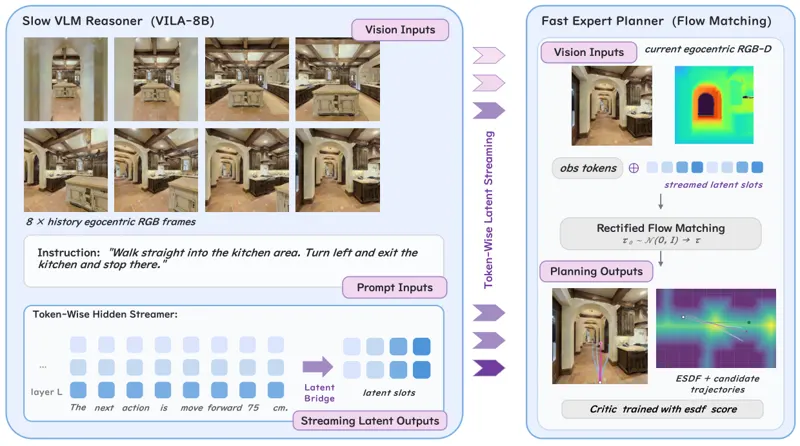
冻结的 VILA-8B 慢推理器把逐 token 多层隐状态流式汇成 8 个潜槽,实时条件化流匹配快规划器;动态行人导航基准上理想/真实两阶段成功率 41.6%/34.8%,碰撞率最低。
PrimeBot等发布1500小时双臂家庭操作数据,训练5B VLA模型XR-2;叠衣任务上专家数据把成功率从34%推到84%后饱和,三轮DAgger在策略纠正再从58%提至93%。
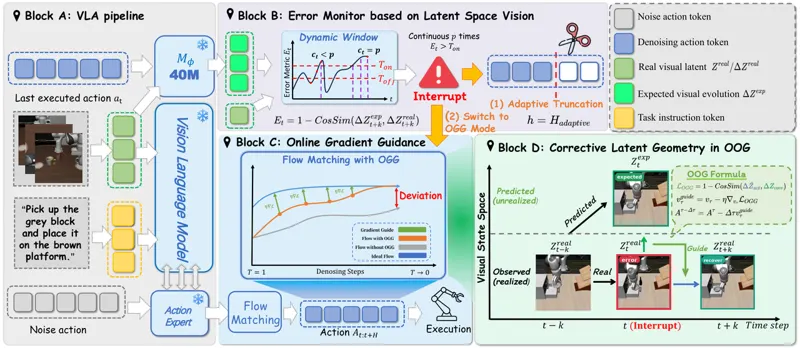
视觉-语言-动作(VLA)基础模型在具身智能上进展显著。为降低策略调用频率并保持时间连贯性,多数生成式策略采用动作块机制,在固定动作视界下以开环方式执行多步未来动作。然而这种先预测后盲目执行的范式牺牲了闭环反应性:在接触丰富的物理交互中,即使微小的局部扰动也会在开环盲区内迅速放大,导致误差复合并最终任务失败。为此本文提出 VLA-Corrector,一个面向动作块 VLA 策略的轻量纠正推理框架。在不修改主干策略权重的前提下,VLA-Corrector 引入轻量潜空间视觉监控器(LVM),持续比较预测与实际的视觉特征演化,实现在线检测视觉动力学偏差;一旦检测到持续偏差,系统触发截断事件、丢弃剩余陈旧动作,并通过在线梯度引导(OGG)发起纠正重规划。该检测-纠正机制自然诱导出事件触发的自适应动作视界:当前动作块可靠时保留长视界执行,执行开始漂移时调用短视界纠正重规划,从而缓解静态视界在执行鲁棒性与策略调用频率之间的权衡。VLA-Corrector 可在不重训 VLA 主干的情况下集成到不同 VLA 模型中,在保留动作块效率收益的同时中断复合误差,显著提升长视界、接触丰富机器人操作任务的鲁棒性。