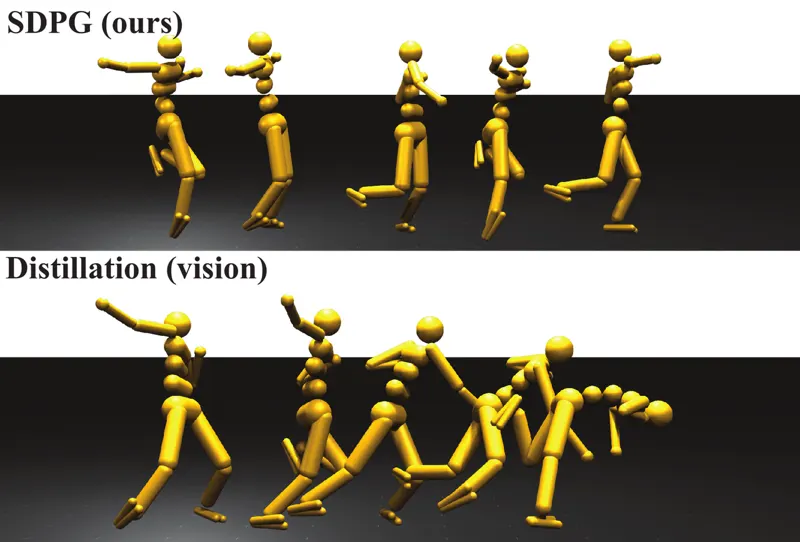
SDPG 用同一名义轨迹周围的随机动作扰动估计平滑策略梯度,只批量渲染少量名义环境,并用大量无渲染物理环境计算回报差。论文在视觉 MuJoCo 与多类机器人任务上实现单张 RTX 4080 的端到端训练,并在 Unitree Go2 上验证零样本 sim-to-real 迁移。
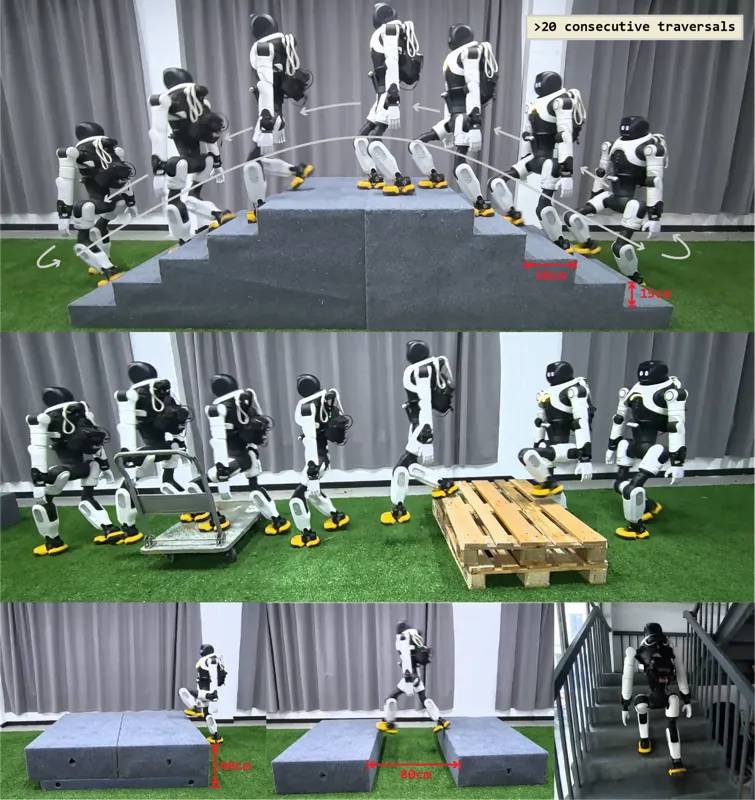
CReF 提出单阶段、直接以深度图+本体感知映射到关节目标的视觉人形运动框架:本体感知查询的跨模态注意力、门控残差融合与 GRU 高速公路门控循环融合从原始前向深度提取运动相关特征,并引入基于足端点云可支撑候选的地形感知落脚奖励。仿真中在楼梯/间隙/平台三类地形全部难度档取得领先,零样本部署到 AGIBOT X2 Ultra,在带扶手楼梯、镂空托盘、强反光与杂乱户外场景中稳定行走。
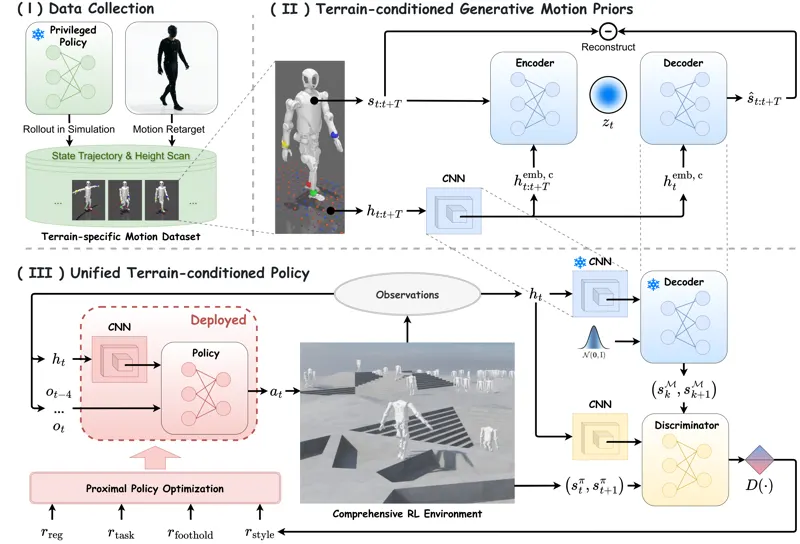
人形机器人同时实现拟人自然性与地形鲁棒通行仍是核心挑战。现有RL方法依赖固定运动先验,环境适应性有限。本文提出地形条件生成式运动先验(T-GMP),用CVAE从少量专家状态-地形示教中学习地形条件的潜在运动流形,使风格平滑过渡、策略统一适配地形变化;结合Foothold Penalty与对抗学习判别器,按局部地形动态调制自然性约束。实验表明该方法在通行成功率与运动平滑度上优于基线,同时保持仿生自然且物理协调的运动。
将多阵列足底压力作为人形机器人运动的直接反馈,通过拓扑保持序数表征与双分支编码器提取时空特征,结合增强本体感知进行策略学习,实现复杂地形稳健运动。
提出 Marope 多智能体强化学习框架,让多台 Unitree G1 人形机器人协作跳长绳:下层去中心化 MARL 学习摇绳操作,上层集中调度策略协调执行节奏,并融入多样跳跃策略提升对不同玩家风格的泛化,仿真与真机实验均优于基线。
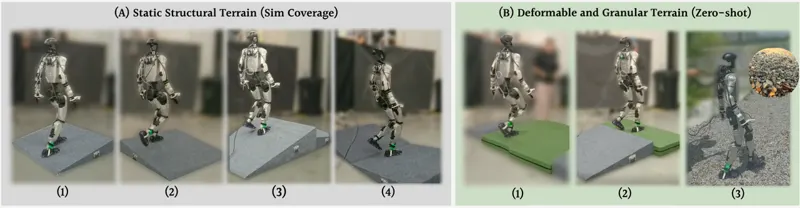
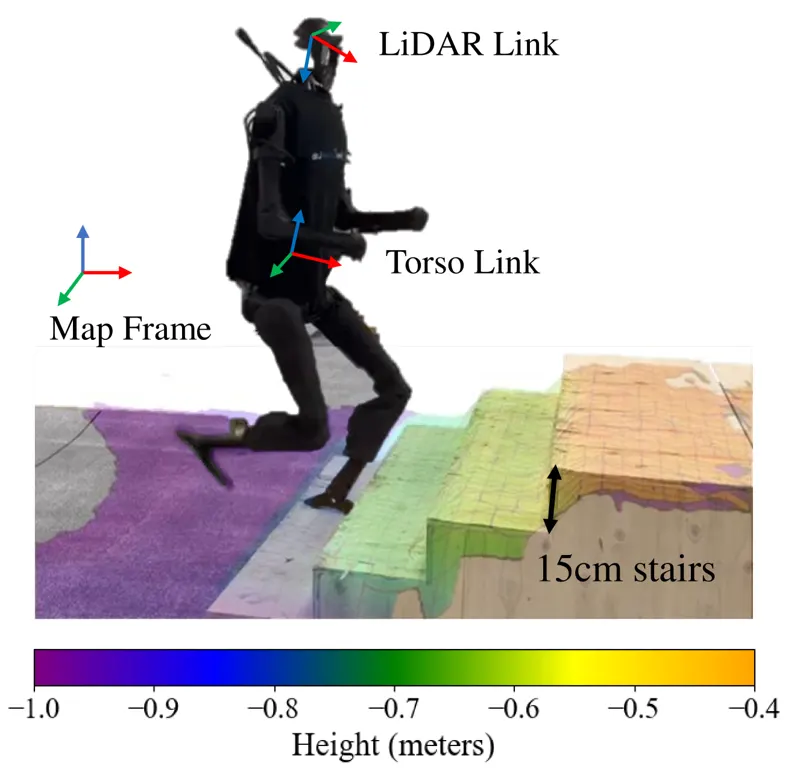
与四足机器人可以使用盲策略导航多种地形不同,人形机器人由于高自由度和本质上不稳定的形态,需要精确感知才能稳定运动。然而引入感知信号往往会给系统引入额外干扰,降低鲁棒性、泛化性和效率。本文提出感知内部模型解决这些问题。
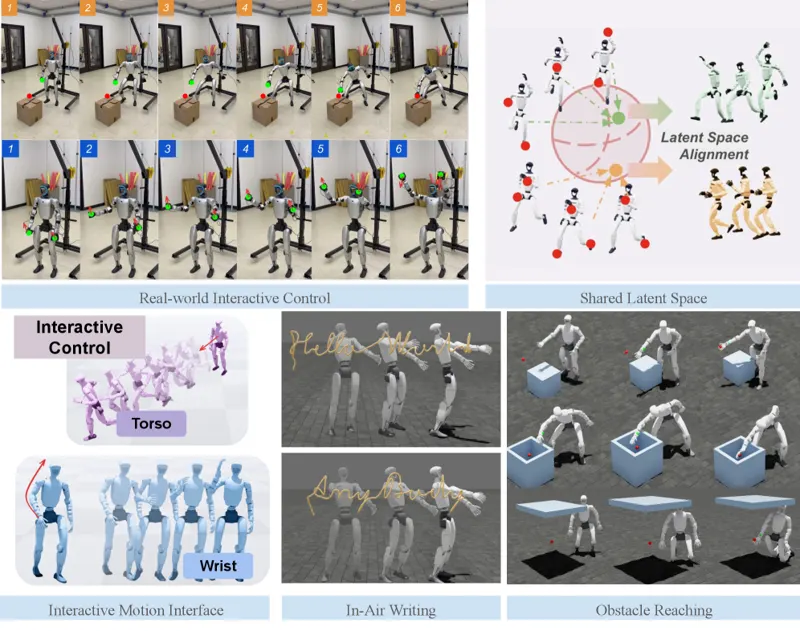
AnyBody 提出统一的全身人形控制器,可由任意子集的身体关键点驱动,实现自由形式的全身运动控制。无需完整运动捕捉数据,仅用部分关键点即可引导人形机器人完成多样化全身运动。
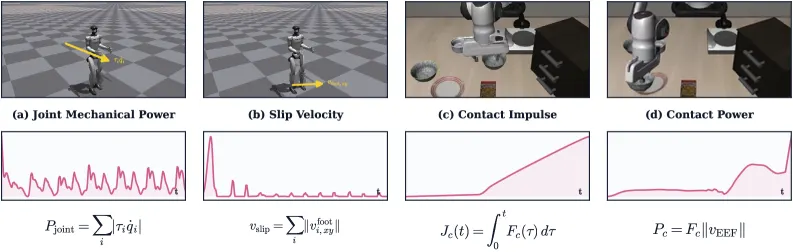
PRISM 提出一种紧凑的策略表示方法,将可观测物理变量间的多项式交互显式化、可学习化。标准 MLP 策略接收一阶变量(位置、速度),但许多动作相关线索来自乘积交互(如关节功率=扭矩×速度)。PRISM 用因子化多项式模块直接暴露这些交互,无需枚举所有单项式,在人形机器人行走和接触丰富操作上显著超越 MLP 基线。
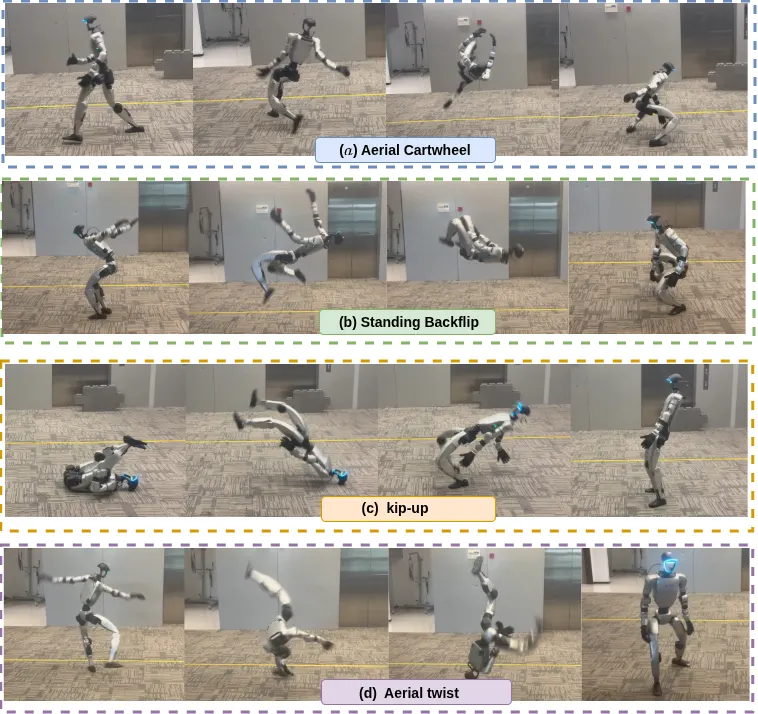
Extreme-RGMT提出持续学习方法用于人形机器人的高动态技能获取,实现对通用机器人控制的鲁棒泛化。