PixelUMM:像素空间统一图像视频模型
视频加载中
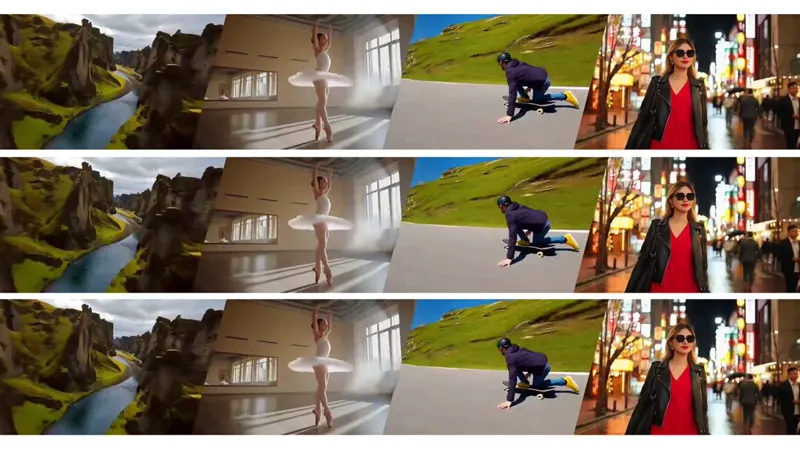
视频加载中PixelUMM 去掉视觉编码器与 VAE,直接用 16×16 图像块和四帧视频管片建模,在 Qwen3-8B 主干内统一理解与生成。
Category: research
Author: @CongWei1230
Date: 2026-10-01T00:00:00
Duration: 28.966s
Reference: https://arxiv.org/abs/2609.38597
PixelUMM 去掉视觉编码器与 VAE,直接用 16×16 图像块和四帧视频管片建模,在 Qwen3-8B 主干内统一理解与生成。
 0:30
 6:43
 1:56
 2:02
 0:17
 0:30
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。