UVTA: Unified Visual-Tactile-Action Modeling for Dexterous Manipulation
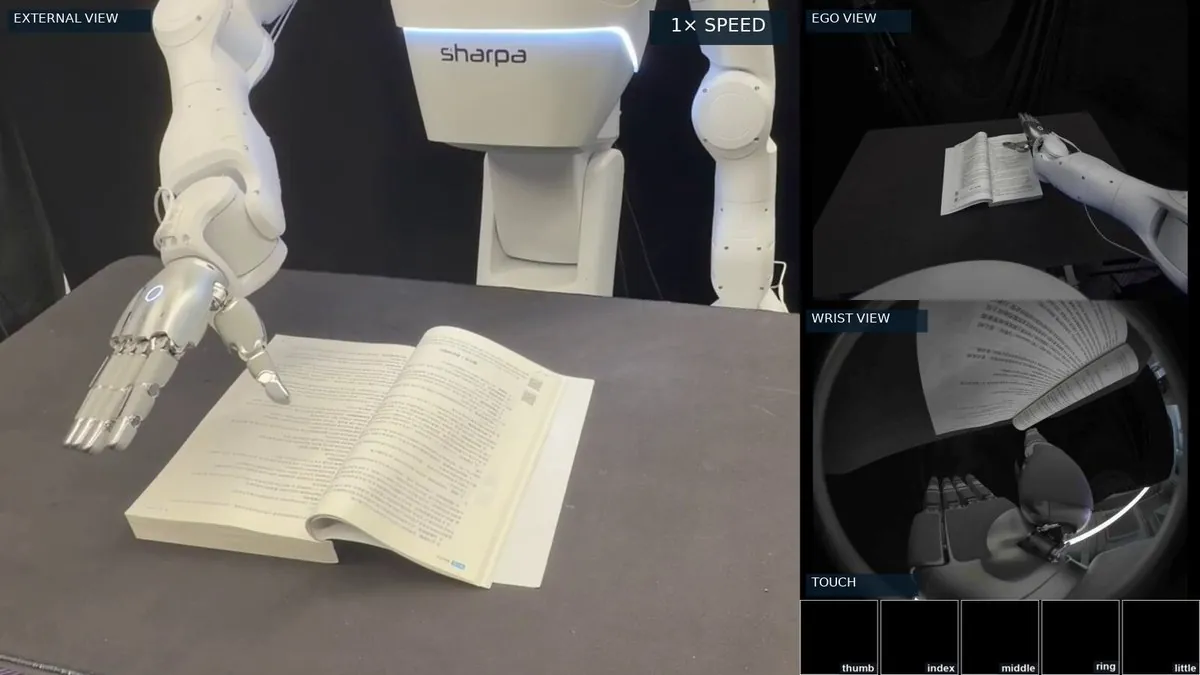
Loading video
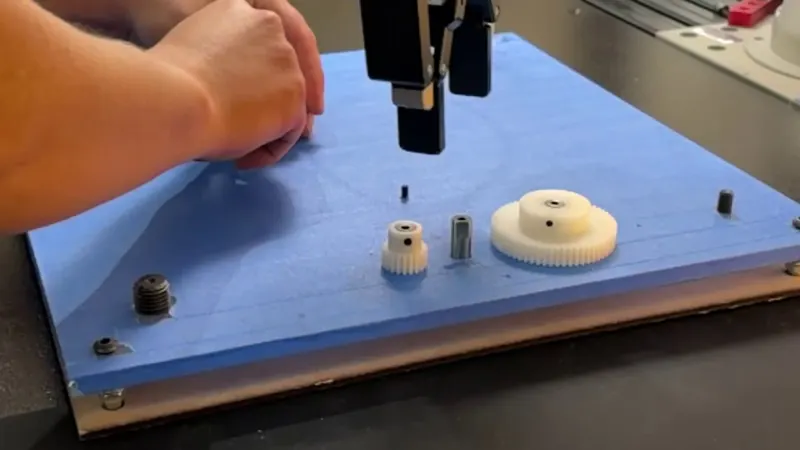
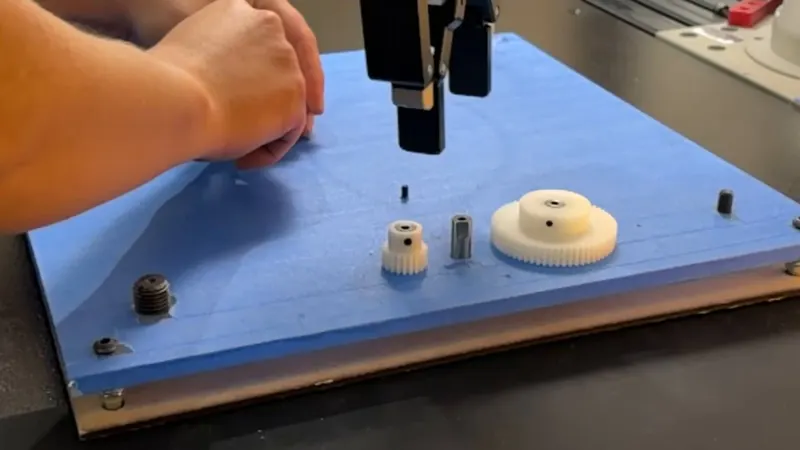
Loading videoUVTA unifies vision, tactile sensing and action in one model trained on human demonstrations collected with a passive 22-DoF exoskeleton (~1,000 per task plus ~150 robot demos). It predicts the next touch while acting, averaging 70% across five contact-rich tasks versus 29% for the best visual-tactile baseline.
Dexterous ManipulationTactile SensingHuman demonstrationsVisuotactile LearningBIGAISharpaDexterous HandTactile Perception
Category: manipulation
Author: @CyberRobooo
Date: 2026-10-10T00:00:00
Duration: 28.2s
Reference: https://uni-vta.github.io/