UVTA:视觉-触觉-动作的灵巧操作
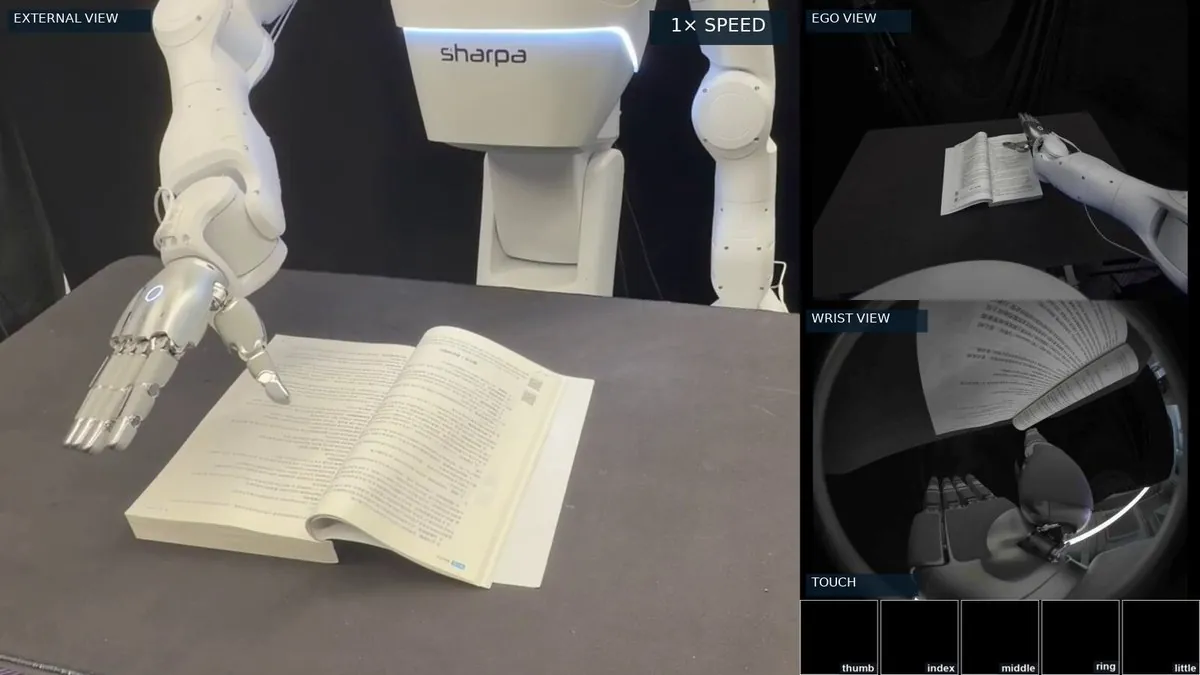
视频加载中
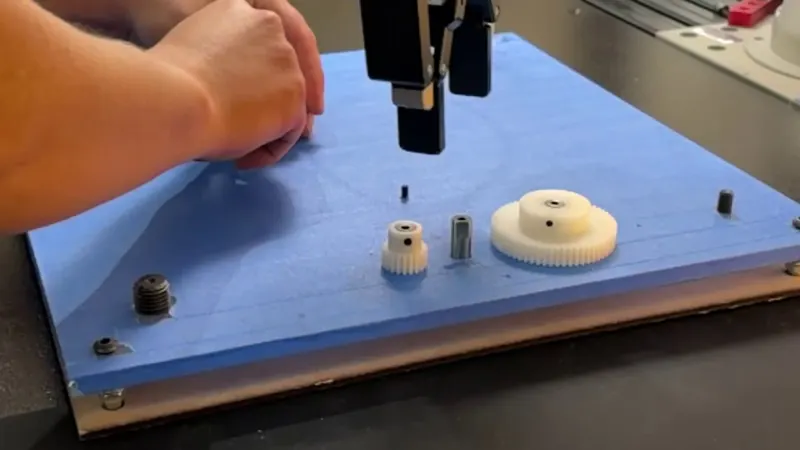
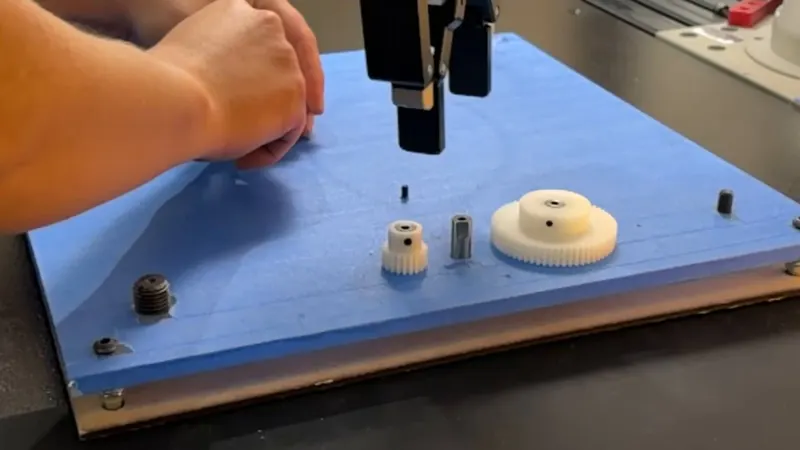
视频加载中用22自由度被动外骨骼采人类演示(每任务约1000条),UVTA统一建模视觉、触觉与动作并预测下次接触,五项接触任务平均70%,最佳基线仅29%。
Category: manipulation
Author: @CyberRobooo
Date: 2026-10-10T00:00:00
Duration: 28.2s
Reference: https://uni-vta.github.io/
用22自由度被动外骨骼采人类演示(每任务约1000条),UVTA统一建模视觉、触觉与动作并预测下次接触,五项接触任务平均70%,最佳基线仅29%。
 7:59
 0:10
 0:07
 0:07
 0:29
 2:37
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。