Jev Engineering 与 Kimi K3:用置信度级联压低智能体成本
拆解 Jev 的 Choice、Score、Noul 判断,如何在代码中按概率路由,并用 Kimi K3 处理低置信样本、控制成本与误差。
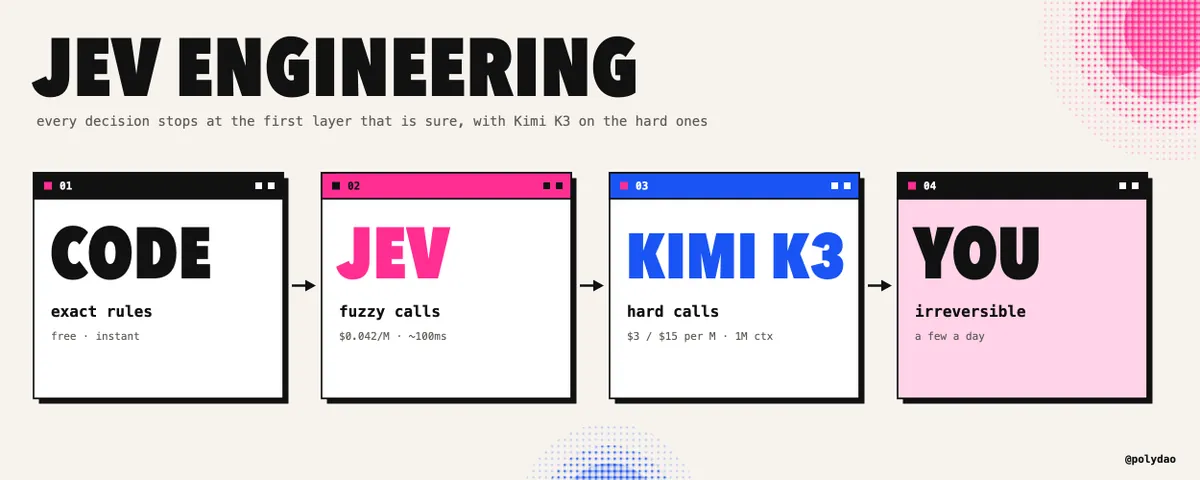
大多数智能体账单并不是由最终答案产生的。真正反复消耗推理预算的,是最终答案出现之前的那些小判断:下一步调用哪个工具、这条来源是否相关、测试是否通过、命令是否安全、任务是否已经完成。所谓 Jev 工程化,本质上就是把这些边界明确的判断从通用大语言模型里拆出来,用概率控制路由,只把真正需要昂贵生成的少数样本交给更大的模型。
版本核验说明。本文依据 Mr. Buzzoni 于 2026 年 9 月 29 日发布的 X 长文,以及采集时公开可查的 TypeSafe、Kimi 与 GitHub 文档整理。原文写于 Jev 1.13.0 时期;核验时当前生产模型已经是 Jev 1.14.0,因此历史模型名、上下文限制与评测数字都按现状单独标注。原文中的付费服务、合作邀约、订阅推广与 Telegram 引流均已删除。
智能体最贵的环节,往往不是创作
打开一段真实的智能体执行记录,逐项判断每一步到底需要什么能力。有些步骤确实在创作:起草修复、编写计划、总结证据、解释失败原因。有些步骤只执行确定规则:计算重试次数、检查 token 预算、比较日期、核对白名单。有些步骤则是从一组可以提前写出的答案里做选择:账单还是技术支持、相关还是无关、安全还是危险、完成还是未完成。还有极少数步骤无法撤回:发送邮件、发布内容、转移资金、删除记录、修改权限。
原文的核心观察是:第三类工作被按第一类工作的价格收费了。一个前沿模型读取大段状态,最后只输出一个分类词,推理过程仍然承担生成式模型的成本与延迟。如果智能体每一轮都做这样的调用,原本不起眼的“小判断”就会变成主要运营成本。
Jev 是针对这类判断设计的 system one 模型。它不负责写文章,而是接收调用方提供的状态与结构化问题,再返回带概率的结构化答案。TypeSafe 将大多数调用的完成时间描述为约 100 毫秒。当前价格为每十亿输入 token 42 美元,也就是每百万输入 token 0.042 美元,输出 token 不单独收费。
先做四类审计,再决定是否换模型
分类审计比模型选择更重要。如果一项工作本来就属于确定性代码,把语言模型换成另一个语言模型并不会让它更可靠;如果一项工作必须由人承担风险,仅凭分类器给出的数字就自动执行,反而会扩大事故面。真正需要分析的单位是决策边界,而不是整个智能体。
| 步骤类型 | 正确执行者 | 例子 | 判断依据 |
|---|---|---|---|
| 开放式创作 | 通用大语言模型 | 起草、改写、解释、综合、规划 | 输出空间开放,需要语言生成能力。 |
| 精确规则 | 确定性代码 | 重试次数、算术、预算、日期顺序、权限 | 可以写成可测试规则的工作,不应交给概率模型估算。 |
| 有边界的判断 | Jev | 路由、排序、保留或丢弃、安全或危险、完成或未完成 | 答案可以表达为 Choice、Score、Noul 或 Box 问题。 |
| 不可逆副作用 | 代码加人工审批 | 发送、付款、发布、删除、授权 | 概率判断可以提出建议,但不应单独执行。 |
迁移应从一项每天出现几十次、并且已有可复查历史的决策开始。每次执行都记录:模型当时看到的状态、作出的判断、置信度、下游结果,以及人工是否纠正。这样的日志比通用榜单更有价值,因为它测的是路由器真正要面对的数据分布。
置信度是路由信号,不是正确答案证明
system one 模型真正重要的性质,不是每个答案都正确,而是置信度能把“可以直接执行”和“应该再检查”分开。TypeSafe 将 Jev 描述为面向校准判断训练,而不是面向取悦人类的解释训练。原文引用 Diogo Almeida 的观点:如果一个模型在 95% 的任务上成功,却无法告诉你哪些 5% 会失败,这项任务就很难安全自动化。
当前文档也明确指出,Jev 返回的置信度衡量的是答案分布形状,并不等于所选答案正确的概率。因此生产系统不能只拿一个置信度数字就决定高风险操作。
对于含概率向量 pi 的 Choice 问题,路由层至少应同时观察首选概率和第一名与第二名的间距:
$$C_{\mathrm{choice}}=\max_i p_i$$
$$M=p_{(1)}-p_{(2)}$$
首选概率高但间距小,说明概率质量集中在两个相邻选项;首选概率不高但间距较大,仍然是不确定,只是歧义方式不同。两者都不能证明答案正确,但都可以用带标签样本针对具体动作做校准。
对于有序等级的 Score 问题,期望分数回答“这个样本落在量表的哪里”,分布集中度回答“模型有多集中”:
$$\mathbb{E}[s]=\sum_{j=1}^{n} j\,p_j$$
$$C_{\mathrm{score}}=\max_j p_j$$
对于 Noul 问题,返回值是陈述为真的概率。越接近 0.5 越不确定,越接近两端越确定:
$$u_{\mathrm{noul}}=1-2\left|p_{\mathrm{true}}-0.5\right|$$
这也是为什么不应把 Noul 命名为 is_not_safe。命名反转了输出含义,后面的阈值代码看起来仍然合理,实际却会把安全判断整体翻面。每个 Noul 都应写成“数值越高,就表示路由器想检测的条件越成立”。
当前四种判断原语
Jev 1.14 支持 Choice、Score、Noul 与 Box。前三者覆盖大多数智能体判断;Box 用于定位图片中的区域,不能替代通用视觉推理。当前请求已经接受文本与图片,但图片和 Box 请求需要设置 TypeSafe-Danger-Zone-Images 请求头。
| 原语 | 问题形式 | 返回证据 | 使用规则 |
|---|---|---|---|
| Choice | 从已知集合中选择一个 | choice、confidence、probabilities |
选项必须互斥,并用可观察情境描述。 |
| Score | 放到有序量表的某一档 | score、confidence、legend、probabilities |
每个等级都写成独立、完整的定义。 |
| Noul | 这个陈述是否为真 | noul,即陈述为真的概率 |
适合二元门控;“其他情况”应另问一个问题。 |
| Box | 定位一个区域 | 归一化的上、下、左、右坐标及置信度 | 只有边界框本身就是决策结果时才使用,并在代码中验证几何关系。 |
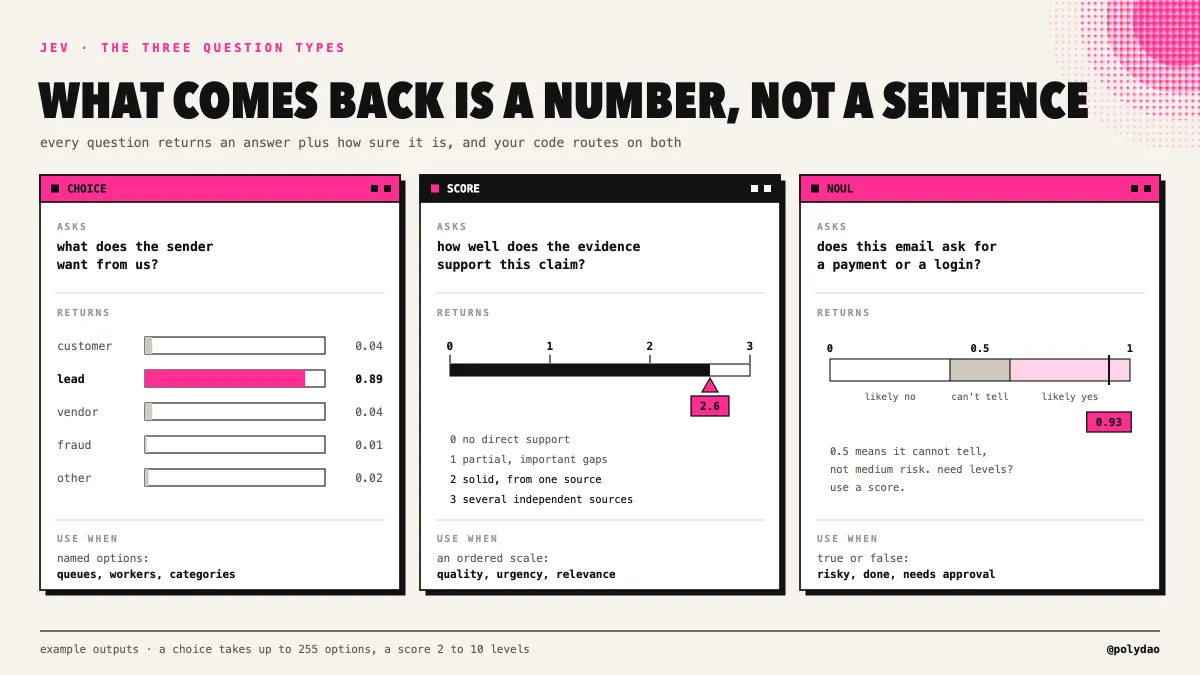
问题 ID 不会发送给模型。因此字段名 is_fraud 本身不会向模型提供任何语义,所有含义都必须写在指令和选项描述里。同一个请求中的问题看到同一份状态并并行执行;一个问题不能读取另一个问题的答案。
9 月快照与当前 API 的差异
原文记录的是 Jev 1.13.0 的接口与限制。生产集成不能直接照抄历史示例,应使用当前契约。
| 项目 | 9 月原文快照 | 当前核验结果 |
|---|---|---|
| 接口 | POST /v1/systemone |
POST https://api.typesafe.ai/v1/systemone |
| 固定模型 | jev-1.13.0 |
jev-1.14.0;jev-latest 会跟随移动别名 |
| 原语 | Choice、Score、Noul | Choice、Score、Noul、Box;Box 为 1.14 新增 |
| 输入模态 | 仅文本 | 支持文本与图片;图片和 Box 需要危险区请求头 |
| 默认上下文 | 总计约 64K,单个最长问题约 32K | 默认仍为 64K 与 32K |
| 长上下文 | 原文未提供 | 使用 TypeSafe-Danger-Zone-Long-Context: true 后两项上限均为 262K,但更慢且准确率下降 |
| 速率限制 | 每秒 1,200 个请求、250,000 token | 由组织在开发者控制台单独确定,历史数字不是通用额度 |
| 延迟 | 70 至 500 毫秒 | 大多数调用约 100 毫秒;长尾仍受状态大小与负载影响 |
| 退出选项 | 每个 Choice 都加 other 或 none |
更推荐为主 Choice 配一个独立 Noul,而不是机械地加入人工退出项 |
价格仍为每百万输入 token 0.042 美元,输出免费。长上下文与图片请求头被命名为“危险区”是有意为之:它们是风险开关,不是无代价的性能升级。只有证明较小的结构化请求确实不够用时,才应扩大上下文或加入图片。
相关问题放在一次调用里
推测式扇出是原文中最大的结构性节省。如果多个问题面对同一份状态,就把它们一起发送,Jev 会并行评估并共享同一份状态。路由判断、安全判断与完成判断可以在一次推理中返回,不必把同一份长文档分别发送三次。
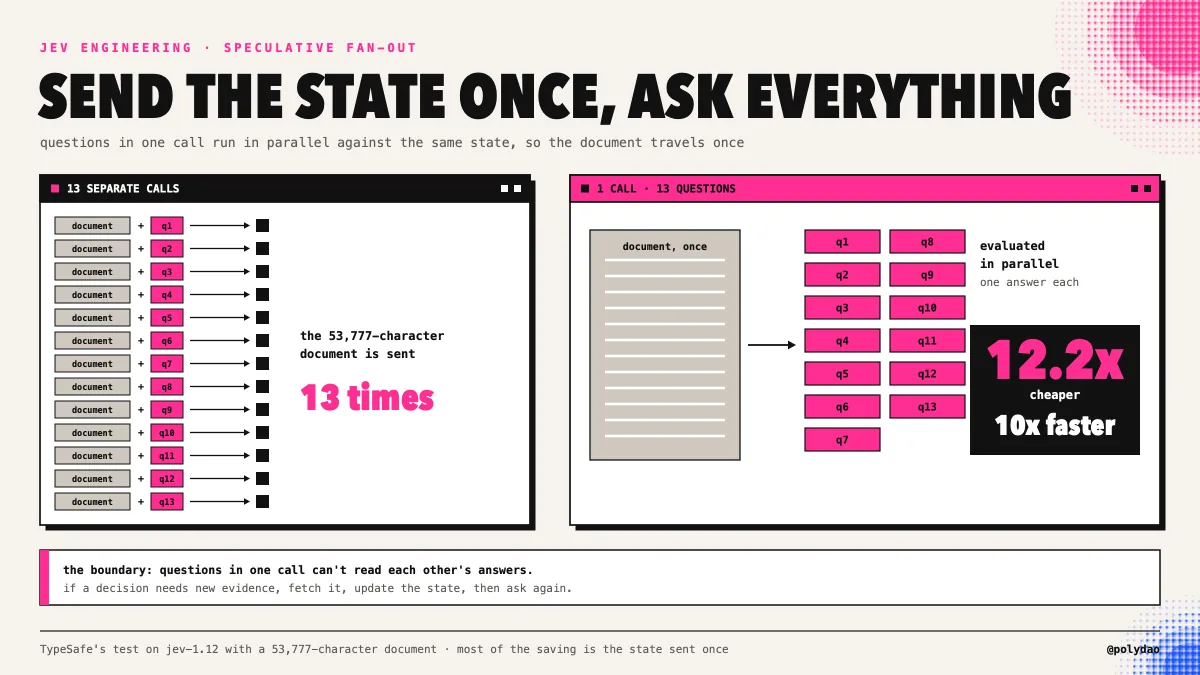
原文报告测试中约快 10 倍;当前 TypeSafe 的扇出示例则报告:在 53,777 字符文档上并行询问 13 个问题,相比 13 次独立调用便宜 12.2 倍、快 11.8 倍。两组数字来自不同运行快照,不需要取平均,也不能把一个结果当成通用常数。它们共同说明状态复用会显著影响成本;真正上生产前,仍应针对自己的状态大小、问题数量与供应商负载重新测量。
是否适合扇出,取决于两个边界。第一,问题必须真的共享同一份状态;无关问题应该拆开。第二,问题不能读取彼此答案。如果问题 B 依赖问题 A 之后才取得的新证据,就必须完成一次调用、更新状态,再进行下一轮。
真正需要工程能力的是写问题
很多被归咎于 Jev 的错误,本质上是问题规格错误。模型按字面理解问题,并给出了一个格式正确、语义却错误的答案。修复方式通常是收紧状态、改成可观察标准,或缩小一次判断的范围。
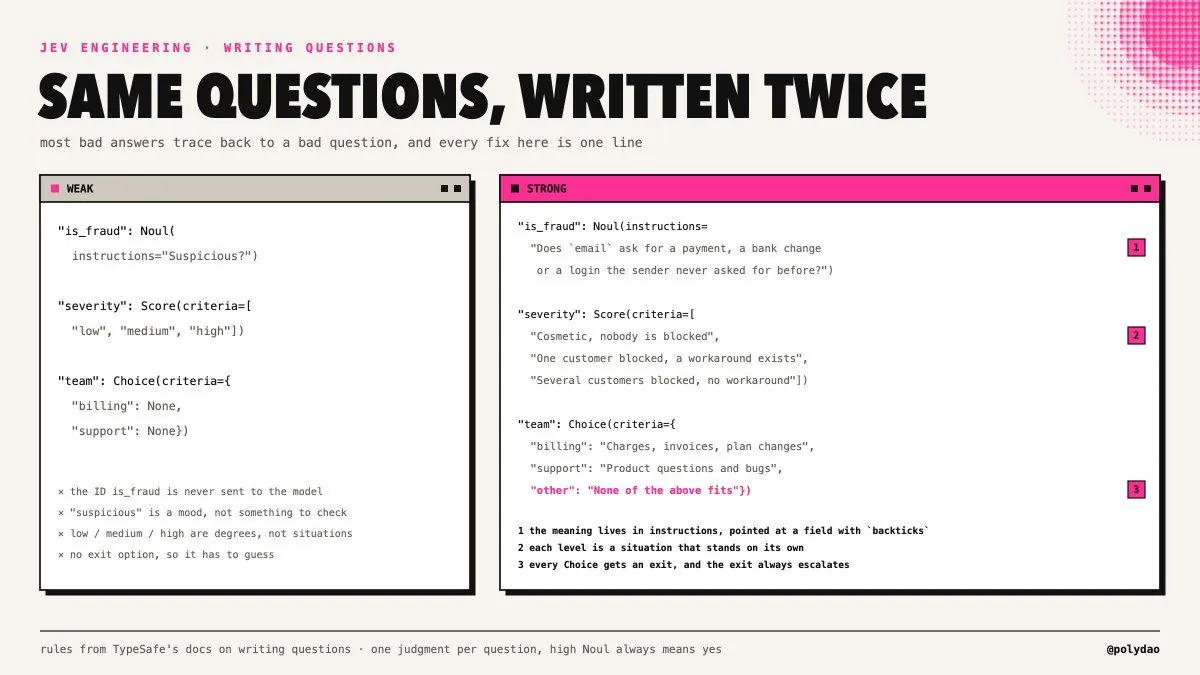
- 每个问题只问一个判断。“这件事是否紧急,而且来自付费客户”包含两个事实和一条规则。分别询问两个事实,再在代码中组合。
- 描述情境,不要描述模糊程度。“提到取消、拒付或公开差评”可以观察;“非常沮丧”不能。
- 每个量表等级都要独立成立。各等级不是一段对话,不能写“比上一档更严重”。
- 精确指向字段。像
order.charges这样的反引号路径能缩小模型搜索范围。 - 先过滤,再推理。无关状态会降低准确率。七条经过选择、附带原始陈述的证据,往往优于把整个研究目录直接塞进请求。
- 尽量把抽取变成选择。如果需要供应商名称,就把已知供应商列表交给模型选择,不要期待分类器生成模式之外的新值。
- 优先使用配套 Noul,而不是所有 Choice 都塞“其他”。当前建议是让主 Choice 保持互斥,再单独询问“以上类别都不适用”的 Noul。
模型仍然会在哪里失败
类型安全只保证输出形状,不保证输出内容为真。一个符合模式的错误答案仍然是错误答案。Jev 也不是计算器、日期引擎或稳定的多跳推理器。这些运算应在代码中完成,再把结果作为事实传入模型。
| 失败模式 | 实际会发生什么 | 外层程序如何补足 |
|---|---|---|
| 按字面理解 | 宽松指令得到机械但错误的答案 | 把问题当作代码来版本化、测试与审查 |
| 算术 | 输入变大后计数与求和发生漂移 | 用代码计算总数,只让模型对结果做有边界判断 |
| 日期顺序 | “3 月 3 日之后”被当成普通文本 | 构造状态前先由代码完成日期比较 |
| 上下文污染 | 无关材料越多,判断越不稳定 | 按问题选择并裁剪证据 |
| 状态中的提示注入 | 对抗性文本改变模型判断 | 权限与确定性检查必须留在模型之外 |
| 需要解释 | 一个数字无法向人说明原因 | 需要文字说明时升级给大语言模型或人工 |
| 多跳推理 | 推理链越长,稳定性越差 | 拆成多次调用,每一步都把新状态显式写回 |
置信度级联
实际架构是一个分层路由器。确定性代码处理必须精确的事实;Jev 处理有边界的判断并返回概率;代码按照具体动作的阈值检查概率;低于阈值的样本升级给 Kimi K3,后者可以读取长线程、查看截图或扫描文档,并给出原因;两个模型都无法确定的样本进入人工复核;不可逆操作只有在相应审批门通过后才能执行。
状态
  -> 确定性校验与特征提取
  -> Jev:并行提问
  -> 路由器
       -> 首选概率与间距达到动作阈值时接受
       -> 低置信样本升级给 Kimi K3
       -> 问题规格异常时拒绝或补充状态
       -> 两个模型都不确定时进入人工复核
       -> 不可逆操作必须再经过显式审批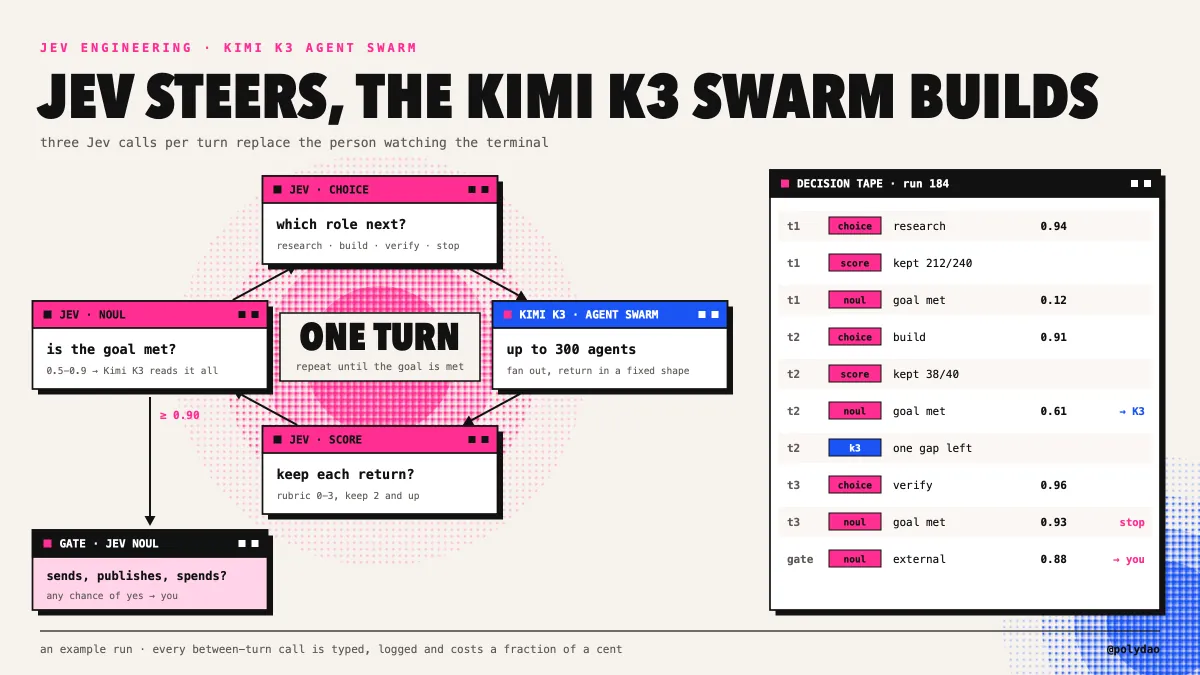
Kimi K3 适合作为升级层,因为不确定样本往往需要的不只是一次短分类,而是完整线程、截图、扫描 PDF 或书面解释。当前 Kimi 文档提供 1M token 上下文,并强调长上下文价格不随长度变化,这使它适合处理 Jev 紧凑状态无法覆盖的样本。模型既能通过托管 API 使用,也有开放权重,因此同一套路由契约可以切换不同部署后端。
升级时可以把 Jev 的选择作为上下文,但不能把它的选择当成证据。有效的升级指令应类似:“快速分类器选择了 X,首选概率 0.71,第一与第二名间距 0.08。请根据原始状态与下列标准重新判断,并解释是否需要修正。”这样 Kimi 是在复核,而不是被第一个答案锚定。
一个完整但克制的级联函数
下面的代码只负责分类和路由,不执行发送、删除或付款。模型 ID、请求头和重试逻辑应从当前 SDK 文档补全;真正关键的是把分类、路由与副作用严格分开。
from typesafe_sdk import Choice, Noul, TypeSafeClient

THRESHOLD = 0.95
MARGIN = 0.10

jev = TypeSafeClient(model="jev-1.14.0")

def classify_email(email):
    response = jev.system_one(
        state={"email": email},
        questions={
            "category": Choice(
                instructions="What does the sender of `email` want?",
                criteria={
                    "customer": "A current customer asks about an order, bill, or account",
                    "lead": "Someone asks about prices, a demo, or working together",
                    "vendor": "Someone is selling a product or service to us",
                    "fraud": "Urgent payment change, spoofed sender, or credential link",
                },
            ),
            "none": Noul(
                instructions="Does none of the listed categories fit `email`?"
            ),
        },
    )
    return route_j_email(response)

def route_j_email(response):
    answer = response.answers["category"]
    probs = sorted(answer.probabilities.values(), reverse=True)
    margin = probs[0] - probs[1] if len(probs) > 1 else 1.0
    none_probability = response.answers["none"].noul

    if (
        probs[0] >= THRESHOLD
        and margin >= MARGIN
        and none_probability < 0.5
    ):
        return {"status": "accepted", "category": answer.choice}

    return {
        "status": "escalate",
        "jev_guess": answer.choice,
        "selected_probability": probs[0],
        "margin": margin,
    }
这个例子故意不包含发送、删除、发布或改权限。那些动作应放在路由器之后,由工具白名单和人工审批控制。分类器可以建议不可逆操作,但不应成为执行该操作的授权来源。
欺诈筛查:两次运行,两组不同结果
公开的 jev-fraud 仓库是原文最具体的证据,也恰好说明为什么不能把一个演示数字直接复制到生产。原文报告了一次运行,仓库中签入的 Together AI 轨迹则记录了另一次运行。
| 指标 | 原文所述运行 | 仓库中的 Together AI 运行 |
|---|---|---|
| 数据集 | 100 封邮件,合法与欺诈各半 | 同一演示的 100 封邮件 |
| Jev 阶段 | 分类全部 100 封 | 接受 70 封,升级 30 封 |
| 仅 Jev | 未单独报告 | 90/100 正确 |
| Kimi 升级 | 31 个样本 | 30 个样本 |
| 最终准确率 | 96/100 | 92/100 |
| 修正情况 | 未拆分 | 修正 2 个,没有回归 |
| 欺诈召回率 | 未报告 | 84% |
| Jev 延迟 | 批量阶段 1.42 秒 | 汇总在 6.114 秒总时长中 |
| 总延迟 | 16 秒 | 6.114 秒 |
| 记录成本 | 约 0.07 美元 | 0.101775 美元 |
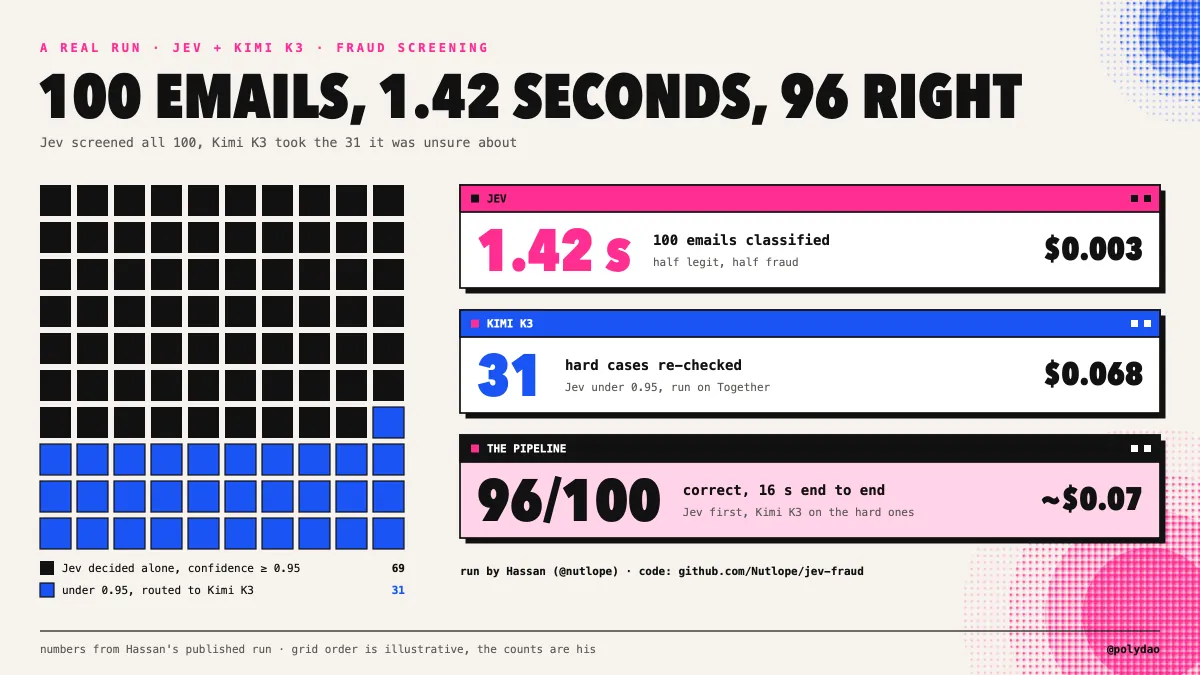
仓库运行将 Jev 并发设为 20、Kimi 并发设为 25,并把首选概率阈值设为 0.95。记录中的 Jev 网关成本为 0 美元,是因为该路由处于免费额度或推广状态,所以 0.101775 美元不是可移植的 Jev 生产报价。原文对未缓存 Kimi 输入的估算采用每百万 token 3 美元,输出采用每百万 token 15 美元,这部分才更接近长期运营成本。
两次运行不同,因为级联不是一台只有一个全局基准的确定性规则引擎。模型版本、供应商路由、提示词、阈值行为、并发和缓存 token 的处理都会改变结果。正确结论不是“这条流水线准确率 96%”,而是“这条流水线可以被完整记录,并分别审计接受层和升级层”。
把成本算术摆出来,而不是只写 90%
沿用原文每月一万封邮件的例子。假设每封邮件给 Jev 约 1,000 输入 token;每次升级给 Kimi 1,500 输入 token 和 300 输出 token;升级率为 10%;Kimi 输入价格每百万 3 美元,输出每百万 15 美元。
| 路径 | 输入成本基础 | 输出成本基础 | 每月估算 |
|---|---|---|---|
| 每封邮件都交给前沿模型 | 1,500 万 token,每百万 10 美元 | 300 万 token,每百万 50 美元 | 300 美元 |
| 每封邮件都交给 Kimi K3 | 1,500 万 token,每百万 3 美元 | 300 万 token,每百万 15 美元 | 90 美元 |
| Jev 全量,Kimi 处理 10% | 1,000 万 Jev token 加 150 万 Kimi token | 30 万 Kimi 输出 token | 9.42 美元 |
Jev 部分为:
$$\frac{10{,}000\times1{,}000}{1{,}000{,}000}\times0.042=0.42$$
升级部分为:
$$\frac{1{,}000\times1{,}500}{1{,}000{,}000}\times3+\frac{1{,}000\times300}{1{,}000{,}000}\times15=9.00$$
设升级概率为 e,Jev 单次成本为 cJ,升级模型单次成本为 cK,则一次级联的期望成本为:
$$\mathbb{E}[C]=c_J+e\,c_K$$
如果比例为 r 的样本因证据不足或风险过高而没有进入自动接受,而是退回补充状态或转人工,则每个被接受决策的期望成本为:
$$\mathbb{E}[C_{\mathrm{accepted}}]=\frac{c_J+e\,c_K}{1-r}$$
升级后的最终准确率同时取决于第一层准确率 AJ,以及升级模型在升级子集上的准确率 AK:
$$A_{\mathrm{final}}=A_J+e\left(A_K-A_J\right)$$
这些式子揭示了“便宜 90%”标题背后的真实权衡。降低升级率会减少成本,但也可能降低覆盖率或准确率;提高阈值会改善精度,却把更多样本送给昂贵模型。合理目标不是账单最低,而是在该动作的风险预算内,找到成本最低的配置。
阈值属于动作,不属于模型
新闻邮件路由与付款账户变更不应共享一个阈值。前者可逆、纠错便宜;后者可能立即造成资金损失。TypeSafe 的指南用较低置信区间触发人工复核,在破坏性动作前要求更高置信度,同时明确这些数值只是示例,不是通用默认值。
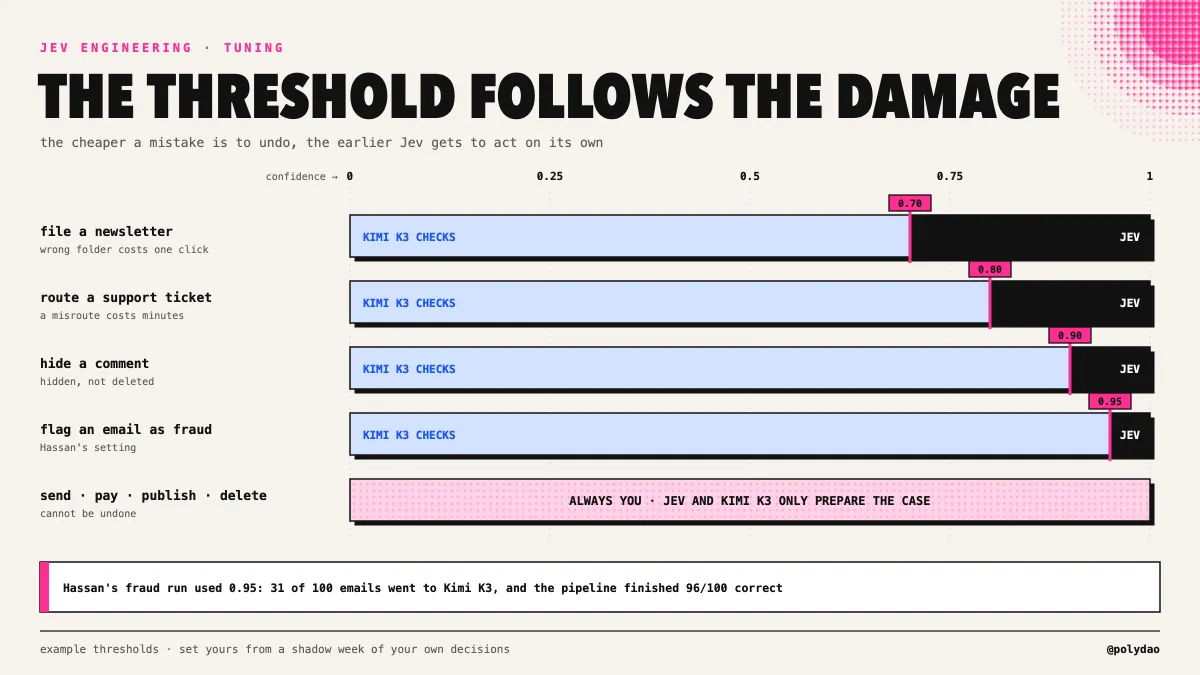
| 动作 | 可逆性 | 初始策略 | 提升自动化前要测什么 |
|---|---|---|---|
| 给内部条目打标签或路由 | 容易撤回 | 影子验证后使用较低阈值 | 各置信区间的精度与人工纠正率 |
| 保留或丢弃来源 | 通常可逆 | 要求概率间距达到最低标准 | 漏掉证据的比例与最终答案质量 |
| 把发票标为欺诈 | 业务影响高 | 高首选概率阈值加第二模型复核 | 欺诈召回率、误报成本与升级收益 |
| 删除数据或修改权限 | 可能不可逆 | 无论模型多自信都保留人工审批 | 授权检查与完整审计日志 |
| 付款或对外发布 | 不可逆 | 模型之外的审批门 | 双人控制、幂等与恢复方案 |
影子模式才是上线机制
不要在第一天直接切换生产路径。先让 Jev 在影子模式运行,旧系统仍然拥有决策权。每次判断都记录模型 ID、原语、完整概率分布、首选概率、第一与第二名间距、阈值、升级结果、最终人工决定以及后续结果。评估时按置信区间看,而不是只看模型全局平均。
- 先记录一个决策。选择有明确事实依据、已有复核流程、每天重复足够多次的调用。
- 收集有代表性的影子样本。覆盖普通样本、对抗样本、稀有类别,以及旧系统本来就处理不好的失败。
- 检查校准。对每个置信区间计算准确率、动作精度、覆盖率与升级率,不要假设 API 的置信度数字自动适用于你的数据。
- 先自动化最安全的区间。如果 0.98 以上长期稳定正确,先让该区间自动执行,其余仍走旧路径。
- 只在划算的地方加入第二模型。遍历现实升级阈值,比较最终准确率、审查工作量与总成本。
- 固定版本并记录问题版本。固定模型版本,问题文本也要版本化;修改判断标准等同于修改生产行为。
- 监控漂移。持续观察状态分布、升级率、人工纠正与每个接受决策的成本。升级率突然上升,可能是输入分布变化的最早信号。
flowchart TD
  A[智能体状态与候选证据] --> B[确定性校验]
  B --> C[并行 Jev 问题]
  C --> D{概率和间距达到动作阈值?}
  D -->|是| E[接受并继续]
  D -->|否| F[升级给 Kimi K3]
  F --> G{K3 能给出有证据支持的答案?}
  G -->|是| H[返回带理由的判断]
  G -->|否| I[人工复核]
  E --> J{是否存在不可逆副作用?}
  H --> J
  I --> J
  J -->|否| K[允许工具执行]
  J -->|是| L[要求显式审批]
  L --> K
Jev 与 Kimi K3 的边界
原文介绍了 LangChain、Pydantic AI 与 Vercel AI SDK 的集成。这些适配器的价值,是把路由放进智能体外层,而不是让每个应用重新发明协议。
| 集成位置 | 适合承担的边界 | 应用仍需负责什么 |
|---|---|---|
| LangChain middleware | 模型路由与工具调用前的风险检查 | 工具权限、副作用审批与状态脱敏 |
| Pydantic AI | 把输出类型映射为问题,并配置回退模型 | 阈值选择与真实数据分布上的验证 |
| Vercel AI SDK | 在 TypeScript 智能体中评估结构化判断 | 请求构造、用户同意与下游执行 |
| Kimi K3 升级层 | 长上下文、图片、推理与书面解释 | 按策略复核答案并保留审计轨迹 |
即使供应商变化,这条边界也应保持稳定。代码负责授权、算术、预算、日期、幂等和真实执行;Jev 负责在一份受控状态上做结构化判断;Kimi 负责更难的生成或多模态推理;人负责不可逆决定。这个分工比任何一次 SDK 调用都更可移植。
最重要的结论
真正有用的思路不是“把小型模型塞得到处都是”,而是把决策边界写清楚。当工作可以压缩成答案空间已知的问题、状态可以裁剪到相关证据、概率可以驱动路由时,system one 模型非常合适。它不适合开放式写作、精确计算、隐藏的多跳推理,也不应拥有不可逆动作的执行权。
原文的乐观场景确实可能把成本压低一个数量级,但结果取决于 token 量、升级率、供应商价格,以及可以共享多少上下文。欺诈演示的两次轨迹同时证明了两个方面:级联可以用较低成本取得不错的准确率,而模型、供应商与计费方式的微小变化也会改变可观测结果。应衡量低于阈值的真实样本群,而不是只看标题里的平均数字。
从智能体每天重复五十次的一个判断开始。先完成四类审计,再写出版本化问题与影子日志;证明某个置信区间可靠后,再逐步自动化;只把真正需要的样本升级给第二模型;让不可逆动作停在人工或确定性审批边界。相比照抄演示里的阈值,这才是更持久的“Jev 工程化”。
来源:Mr. Buzzoni,〈How to Cut Your Agent Bill by 90% With Jev Engineering and Kimi K3〉,2026 年 9 月 29 日。本文为完整翻译与重组,并结合当前公开文档核验事实,已删除商业推广内容。
主要参考
原文来源:Mr. Buzzoni / Xhttps://x.com/Mr_Buzzoni/status/2104783226833186920