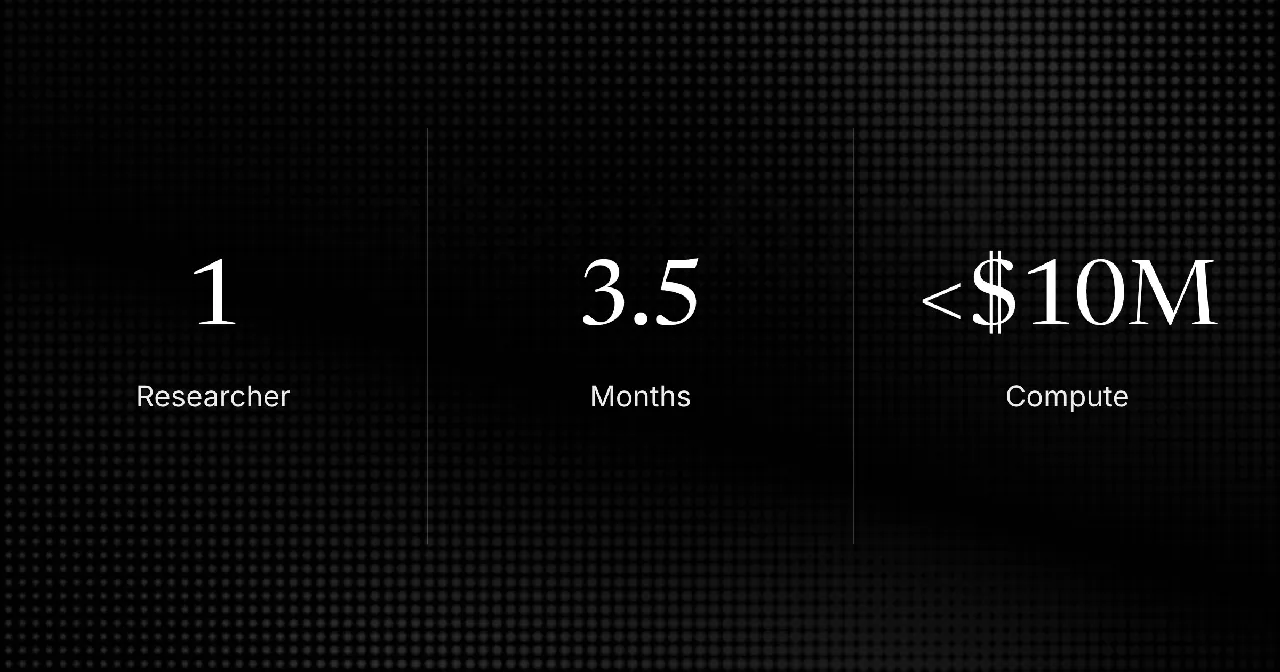
没有预训练团队的规模化预训练:一位研究员、3.5 个月、不到 1000 万美元
Mirendil-Base 由一位研究员带 AI 智能体 3.5 个月预训练完成,算力不到 1000 万美元;智能体写 99% 代码,仅用公开数据,代码损失优于多个千亿级 MoE 基座。
过去十年的大部分时间里,预训练一个有竞争力的基础模型都需要一支专职团队:开源模型项目要几十名专家,前沿实验室要上百人。有人研究模型该长什么样、怎样扩展才有效;有人收集并清洗模型要学习的数万亿 token;还有人优化并维护训练所用的数千张芯片,而在如今最大的实验室里,这个数字是数十万张。
今年,情况开始改变。随着 AI 能力的提升,在前沿实验室内部,智能体承担了下一代 AI 构建工作中越来越大的份额。Anthropic 与 OpenAI 都发布过内部测量数据,显示这一转变在近几个月还在加速。Mirendil 想把这条趋势推到极端,问一个问题:一位研究员带着智能体,能不能预训练出一个有竞争力的代码模型?
Mirendil-Base 就是这个实验的结果。他们的第一个预训练模型由一位研究员在 3.5 个月内完成,算力花费不到 1000 万美元。这个数字包含了抵达终点所需的全部研究与小规模实验,以及最后的正式训练 run;而且是全口径的:包含智能体的 token 开销与数据处理费用,没有蒸馏,也没有购买或授权任何额外数据。AI 智能体编写了超过 99% 的代码、运行实验、诊断故障,而研究员决定试什么、信什么,并在必要时介入。
为了让实验足够干净,他们刻意在 PyTorch、JAX 等标准库之上从零编写全部代码,模型也只从有机的、公开可得的数据中学习。这篇发布于 2026 年 10 月 21 日的文章讲了模型能做什么,以及这个结果对其他人意味着什么。
我们做了什么
Mirendil-Base 是一个代码专用模型系列的第一个成员,目标是在前沿 AI 实验室内部的代码工作上表现尤其出色。这里所需的一般能力,支撑着 AI 研究中的大部分软件工作,从实现实验到调试训练代码。
从零构建。项目从一个空仓库开始。研究员与智能体自己搭建了训练基础设施、模型架构、训练算法与数据流水线,只依赖 PyTorch、JAX 等通用库和少数其他库,并参考流行的开源项目。
只用公开数据训练。全部训练数据来自 GitHub 及其他公开可得的代码、网页与公开数据集。没有购买或授权任何额外数据,本实验也没有使用蒸馏或合成数据。
为效率而设计。他们从改进的架构、数据配比的精细调优与其他数据改进、以及 kernel 优化中获得了显著的效率收益。这三件事在常规预训练团队里通常分给不同的专家;在这里,研究员与智能体把三件事全做了。
扩展性良好。模型变大后这套配方依然成立。作为参考,Mirendil-Base 处于 100B–500B 参数量级,Mirendil-Base-Large 处于 500B–2T 量级,Mirendil-Base-XL 处于 2T–10T 量级。Mirendil-Base-Large 的训练进度约 80%,目前相对 Mirendil-Base 的提升与他们的缩放趋势一致;Mirendil-Base-XL 进度约 19%,已经接近 Large 当前的分数(图 1)。
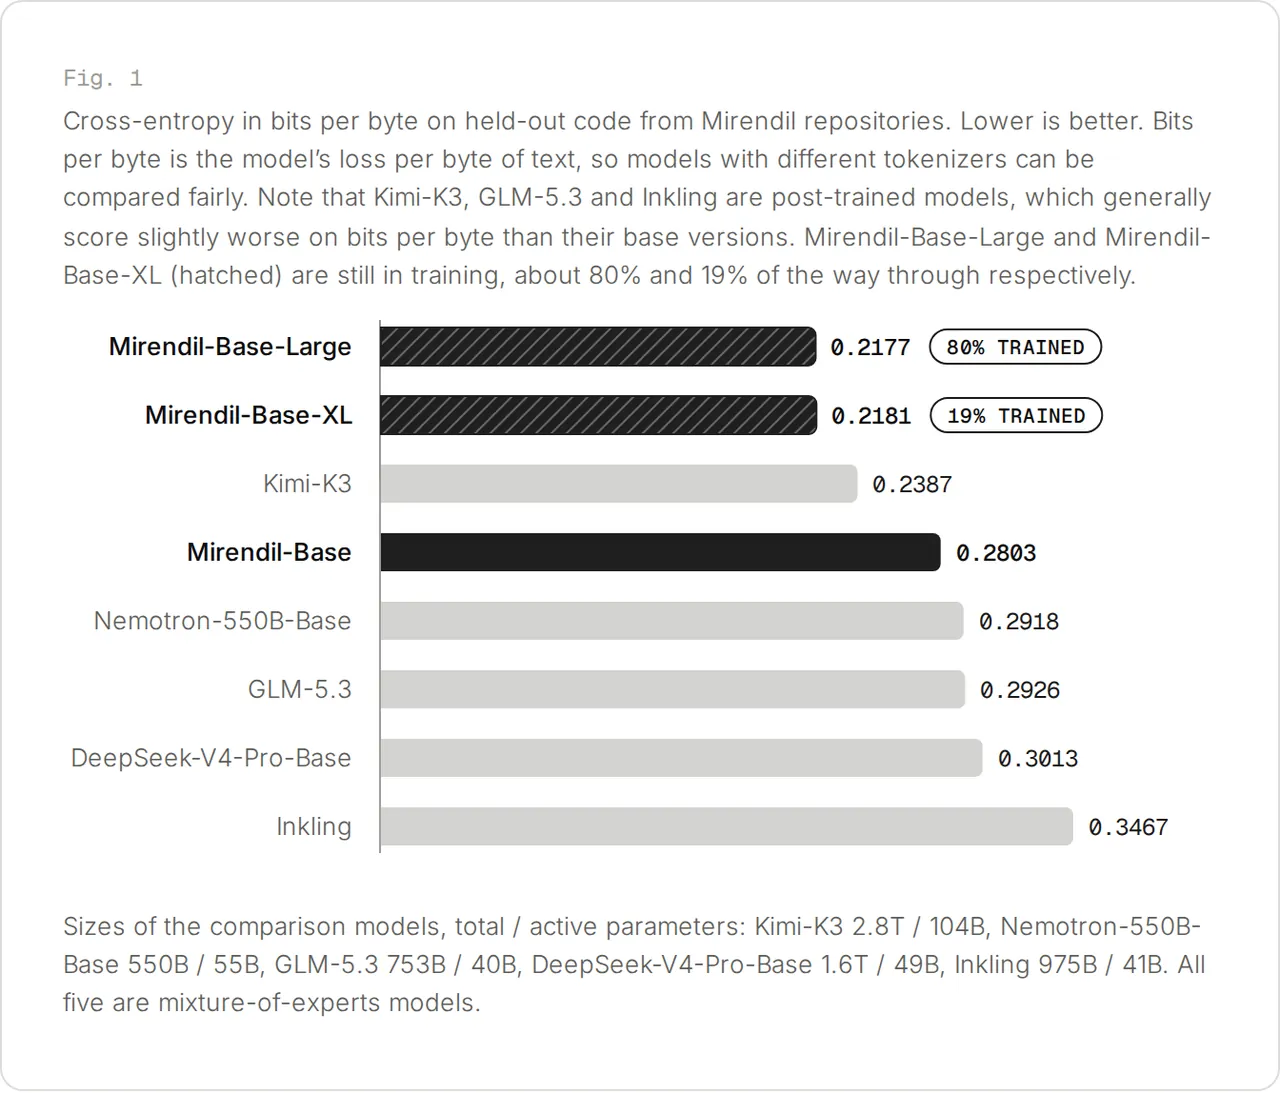
图 1 展示了 Mirendil-Base 与五个强代码模型(Kimi-K3、GLM-5.3、Nemotron-550B-Base、DeepSeek-V4-Pro-Base、Inkling)在「预测 Mirendil 自有仓库保留代码」这一任务上的对比。图 2 则把比较移到实验室之外:七个在模型训练完成之后才发布的外部仓库,因此它们不可能泄漏进任何一方的训练集。
| 仓库 | Kimi-K3 | Mirendil-Base | Nemotron-550B-Base | GLM-5.3 | DeepSeek-V4-Pro-Base |
|---|---|---|---|---|---|
| codex-sec | 0.200 | 0.228 | 0.241 | 0.247 | 0.245 |
| grok-build | 0.183 | 0.210 | 0.220 | 0.220 | 0.225 |
| openworker | 0.229 | 0.268 | 0.296 | 0.287 | 0.304 |
| json-render | 0.127 | 0.127 | 0.185 | 0.181 | 0.173 |
| native | 0.210 | 0.257 | 0.263 | 0.257 | 0.263 |
| scriptc | 0.203 | 0.219 | 0.274 | 0.252 | 0.228 |
| anydoc | 0.200 | 0.246 | 0.251 | 0.250 | 0.261 |
| 平均 | 0.193 | 0.222 | 0.247 | 0.242 | 0.243 |
图 2 —— 七个在模型训练完成后才发布的外部仓库上的交叉熵,单位 bits per byte,越低越好,每行最优加粗。Kimi-K3 与 GLM-5.3 是后训练模型,在该指标上通常比其基座版本略差。表:Mirendil 博客。
这可能意味着什么
直到不久前,预训练一个有竞争力模型的瓶颈还是人:一支需要数年才能建成的专家团队。Mirendil-Base 是他们拿出的第一份证据,证明这件事正在改变:曾经只有大型研究机构才能做到的事,现在一位研究员就能做到。当智能体承担大部分动手工作时,瓶颈就转移到了算力、数据,以及指挥智能体之人的判断力上。以下是 Mirendil 认为随之而来的变化。
让更多人有能力构建 AI。Mirendil-Base 是一位经验丰富的研究员用今天的通用工具建成的。随着这些工具继续改进、以及 Mirendil 打造专为此类工作设计的工具,他们预期同样的事情将发生在那些深耕自己领域而非预训练的团队身上:芯片设计团队、机器人实验室、或者用自有数据为自己问题训练模型的医院。今天大多数组织租用通用模型、只在边缘做适配;到那时,基座模型及围绕它构建的系统将不再是少数实验室的专属,而会变得容易获得得多。
组织随算力扩展的新方式。传统上,组织靠招聘来扩大产出。算力提供了另一条扩展轴:把人放大得更远。当智能体承担大部分动手工作时,团队可以通过增加算力来承接更多事情。人均野心随之上升:曾经需要一个机构才能启动的项目,可以从小团队开始;随着算力更便宜、更强,将有更多人能够尝试它们。
杠杆率持续提升。随着智能体承担更多工作,研究员的一天将越来越不像「亲自做工作」,而更像「领导一个小型实验室」:定研究方向、设计值得运行的实验、决定哪些想法值得继续推进。智能体已经能把持续数天的工作从头到尾独立完成,并且开始参与研究品味:提出方向、判断稀缺算力该如何分配——就在去年,这还被认为是 AI 够不到的能力。
循环开始闭合。Mirendil-Base 不是自主把自己造出来的;是一位有专长的人用 AI 工具造出来的。但这些工具对 AI 开发的帮助程度在过去一年里急剧上升。他们的下一个模型将部分由 Mirendil 自己的模型来构建,而每一个更擅长构建 AI 的模型,都会让下一个模型更便宜、更快。他们不认为完全自主的递归自我改进已经到来,但距离它比任何时候都更近。
下一步
Mirendil 已经启动 Mirendil-Base 的后训练,并将很快分享更多进展。Mirendil-Base 是这个家族中最小的模型;Mirendil-Base-Large 与前沿级的 Mirendil-Base-XL 都仍在训练中,两者都会有后续更新。
如何冷静地读这些数字
有两个前提让这个结果保持诚实。第一,指标是预训练损失,而非下游能力:保留代码上的 bits per byte 说明模型很会预测代码,而且原文明确指出五个对比模型中有三个是后训练模型,这通常会让它们在该指标上吃点亏。在损失上领先 Kimi-K3,还不等于在智能体基准上领先。第二,「全口径不到 1000 万美元」仍然超出大多数实验室与公司能花的钱一个数量级,所以标题的诚实读法不是「预训练免费了」,而是「预训练不再需要一个常设组织」。稀缺的投入变成算力、数据获取、以及指挥智能体之人的判断力——正是原文点名的那三样。
更重要的主张是最后一条。如果下一个 Mirendil 模型部分由 Mirendil 自己的模型构建,那么构建模型的成本曲线就开始对自己复利,本次 run 的 3.5 个月与不到 1000 万美元,将成为被后继者不断打破的「昂贵基线」。这条循环能否完全闭合仍是开放问题,但本次 run 是迄今最干净的公开数据点:它的第一圈,已经可以由一个人跑完。
来源:Mirendil 博客,《Pretraining at scale without a pretraining team》(mirendil.com/news/pretraining-at-scale-without-a-pretraining-team,发布于 2026 年 10 月 21 日)。本文为全文翻译与改编;图 1 与图 2 来自原文。