从一句话到游戏角色:文本生成动作的四条技术路线与交付边界
拆解 MDM、MotionGPT、MoMask 与 Text-To-VRMA:从连续扩散、动作 token、残差量化到 VRM 重定向,说明文本动作如何跨过脚滑、循环、长时漂移与游戏引擎集成。
文本生成动作模型本身,并不会让一个游戏角色立刻可玩。它输出的是骨骼轨迹、动作 token,或一组关节旋转。游戏还需要一致的骨骼、重定向、脚底接触、转场策略、根运动规则、动画状态机和明确的失败回退。演示视频与生产角色动画之间的差距,主要就在这层转译工作里。
原帖用很短的篇幅列出了四个项目:动作扩散模型 MDM、MotionGPT、MoMask 和 Text-To-VRMA。它们并不是在同一个维度上竞争。MDM 处理连续动作轨迹,MotionGPT 把动作与语言放进共享 token 空间,MoMask 通过残差向量量化和掩码 token 预测生成动作,Text-To-VRMA 则把生成结果打包成 VRM 角色可播放的资产。放在一起看,它们刚好勾勒出一条可用的生产栈。
本文没有停留在仓库简介,而是继续阅读论文、源码和项目文档。文章不会用仓库热度或单个 HumanML3D 分数推断游戏可用性。文本生成动作论文优化的是数据集层面的分布相似度和提示匹配;游戏还要求脚底接触、碰撞、转场、可复现性、资产兼容和响应时间。这是两套完全不同的验收标准。
真正的产品边界
常见的误解是把这件事描述成“输入一句话就得到动画”。更准确的流水线是:
- 意图:游戏把提示词、NPC 状态或剧情节拍转换成动作请求。
- 动作合成:模型生成连续轨迹或离散动作 token。
- 解码与重定向:把模型骨架映射到游戏角色的人形骨骼。
- 接触与轨迹修正:处理脚底落地、根运动、地面穿透和滑动。
- 片段组装:让起始帧、动作段、循环、转场和结束姿势彼此兼容。
- 运行时接入:动画状态机消费片段,物理、导航和玩法逻辑继续拥有最终决定权。
flowchart LR
  A[游戏意图或文本提示] --> B{生成路线}
  B -->|连续轨迹| C[扩散模型]
  B -->|类语言动作编码| D[VQ 或 RVQ token 模型]
  C --> E[动作样本]
  D --> F[token 序列]
  F --> G[tokenizer 解码]
  G --> E
  E --> H[骨架重定向]
  H --> I[脚底接触与根运动]
  I --> J[循环与转场组装]
  J --> K[动画状态机或 VRM 片段]
  K --> L[引擎物理与玩法]
四个项目分别占据图中的不同位置。所以工程问题不是“哪个仓库最好”,而是“哪一种动作表示及其失败模式适合当前玩法”。
路线一:MDM 把动作当作连续场逐步去噪
MDM 在人体动作上使用无分类器扩散。训练时,干净的动作序列被逐步加入高斯噪声;transformer 学习在文本条件下恢复干净样本。推理时从噪声开始,反复执行反向过程。
前向加噪过程可以写成:
$$q(x_t \mid x_0)=\mathcal{N}\left(\sqrt{\bar{\alpha}_t}x_0,\left(1-\bar{\alpha}_t\right)I\right)$$
常规扩散模型通常预测噪声,MDM 则预测干净动作 $x_0$。这个选择对动画很实用,因为位置、速度和脚底接触项可以直接加在模型输出上,不必在每次噪声估计后重新构造。简化后的训练目标为:
$$\mathcal{L}=\mathbb{E}_{t,x_0,\epsilon,c}\left[\left\|x_0-f_\theta(x_t,t,c)\right\|_2^2+\lambda_{\mathrm{aux}}\mathcal{L}_{\mathrm{aux}}\right]$$
其中 $c$ 是文本条件。辅助项可以包含关节位置、速度或脚接触等几何约束。推理阶段的无分类器引导会比较有条件预测与无条件预测,以增强文本对生成结果的影响。
连续扩散带来了什么
当动作本身就是可编辑资产时,MDM 很有吸引力。导演可以固定根路径、重新生成上半身、补一段中间动作,或者要求另一种风格。模型直接操作动作轨迹,不只是一串压缩 token,因此几何约束和修补掩码可以作用在帧级分辨率上。
代价是迭代推理。仓库在特定的 50 步生成和缓存 CLIP 特征条件下,自述单样本约 0.4 秒,文本生成动作最长约 9.8 秒。这些数字适合描述实现背景,不能当作与硬件无关的延迟承诺。采样步数、显卡、批大小、引导强度、序列长度和预处理都会改变结果。
对游戏来说,MDM 更适合离线创作和短而可控的镜头,不像低延迟反应循环。9.8 秒也不是所有动作系统的普遍上限,它反映的是已发布模型和训练设置。生产系统必须自行建立长时动作与转场策略。
路线二:MotionGPT 把动作变成类语言 token
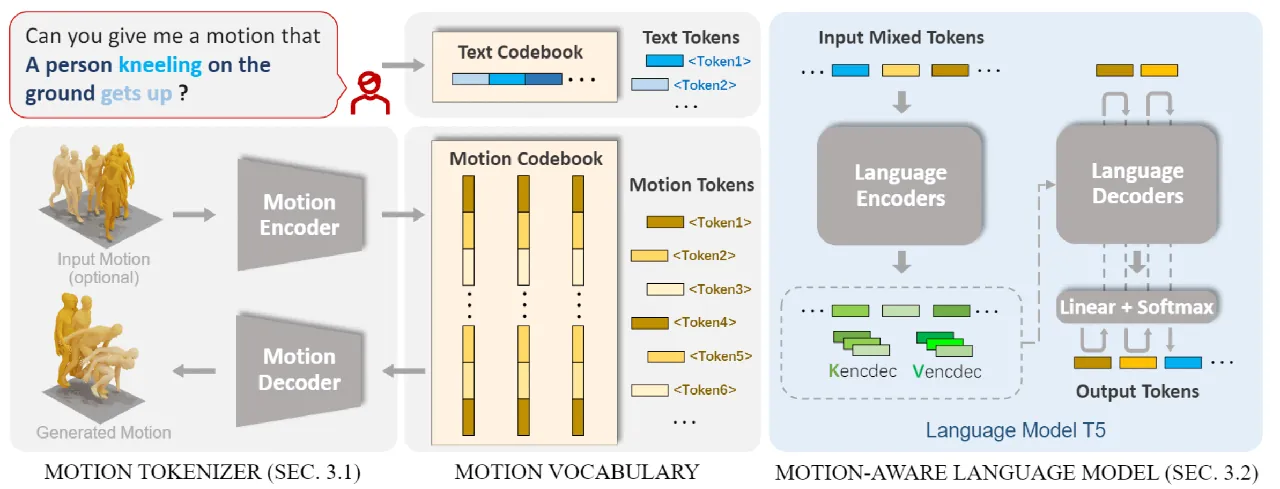
MotionGPT 选择了相反的表示。VQ-VAE 先把动作序列编码为潜变量,再把每个潜向量量化到码本条目。得到的离散动作 token 与文字 token 进入同一个生成接口。随后,T5 模型可以执行文本生成动作、动作描述、动作预测和时间区间补全等任务。
量化器选择距离最近的码本向量:
$$k=\arg\min_j\left\|z_t-e_j\right\|_2,\qquad z_t^{q}=e_k$$
论文实现使用四倍时间下采样。HumanML3D 和 KIT-ML 的原始数据是每秒 20 帧,所以离散序列大约每秒只有五个动作状态,再由解码器恢复更密集的轨迹。这样效率很高,但也定义了类语言决策能够达到的时间粒度。
优势在于语义互译
当游戏需要语义闭环而不只是一个动作片段时,MotionGPT 最有价值。系统可以要求角色“查看门、后退一步并耸肩”,也可以把生成动作转成文字用于调试,或根据上一姿势预测后续动作。论文正式比较的主模型使用 2.2 亿参数的 Flan-T5-Base,并另外评估 6000 万和 7.7 亿参数版本;更大的语言模型并没有在所有指标上自动胜出。README 还明确说明,项目尝试过 130 亿参数的 LLaMA,但在现有动作数据下效果和训练效率都不够。更多语言参数不能替代更大、更干净的动作语料。
在 HumanML3D 上,MotionGPT 论文报告预训练版本 FID 为 0.160,指令微调版本为 0.232。这个差异不表示微调后的产品能力更差。两种训练目标分别偏向分布相似度与指令遵循。游戏团队应按任务选择检查点,不能只盯排行榜的一列。
限制在于 token 粒度
类语言模型擅长安排事件顺序,却不擅长保证亚帧级接触。项目文档明确承认,基于 VQ 的方法不如直接在原始动作上做扩散修补那样适合身体局部编辑;时间下采样也会让短于 token 窗口的动作变得别扭。模型可以表达“走三步再左转”,但脚是否穿地、落地后是否滑动,仍要由引擎验证。
因此,更现实的定位是动作规划器和创作助手:先生成语义连贯的候选,再生成描述与索引,然后交给接触感知的重定向和验证阶段决定能否上线。
路线三:MoMask 把粗结构与残差细节分开
MoMask 是建立在残差向量量化动作 tokenizer 上的掩码生成模型。tokenizer 先为动作潜变量生成基础码;后续码本层继续量化上一层没有解释的残差。掩码 transformer 负责生成基础动作 token,残差 transformer 再逐层补充细节。
残差量化可以描述为:
$$r_1=z,\qquad k_v=\arg\min_j\left\|r_v-e_{v,j}\right\|_2,\qquad r_{v+1}=r_v-e_{v,k_v}$$
解码后的潜变量是所有被选中残差向量之和:
$$\hat{z}=\sum_{v=1}^{V}e_{v,k_v}$$
论文设置在四倍时间下采样下使用六层量化,每层码本包含 512 个 512 维向量。基础 transformer 并行预测被遮住的基础 token,保留高置信度结果,把不确定位置重新遮住,再重复这个过程。随后,残差 transformer 预测后续码本层。论文称整个生成约需 15 次迭代,且与动作长度基本无关。
这是三条生成路线里最明确的“由粗到细”方案。它避免了数千次顺序自回归决策,又通过残差码保留细动作。MoMask 论文在 HumanML3D 上报告 FID 0.045,在 KIT-ML 上报告 0.204。这些结果对方法本身很有价值,但仍不能证明角色鞋底在不平地面上不会滑动。
它在游戏流水线中的位置
MoMask 很适合预生成可检索动作库,例如数百个行走、转身、受击、手势和短表演变体。输出通常是 22 个关节、每个关节三维坐标的序列,工具链还可以导出 MP4 或 BVH。它仍然必须重定向到目标骨架。
仓库坦言,简单的脚部反向运动学后处理“有时有效、有时失败”。这不是可以忽略的实现细节。生产验证器应测量脚跟与脚尖轨迹、接触区间、根速度、自相交和转场误差。如果动作要循环,首尾姿势及其导数都要处理,不能只把两个片段并排摆放。
路线四:Text-To-VRMA 解决的是交付,不是合成
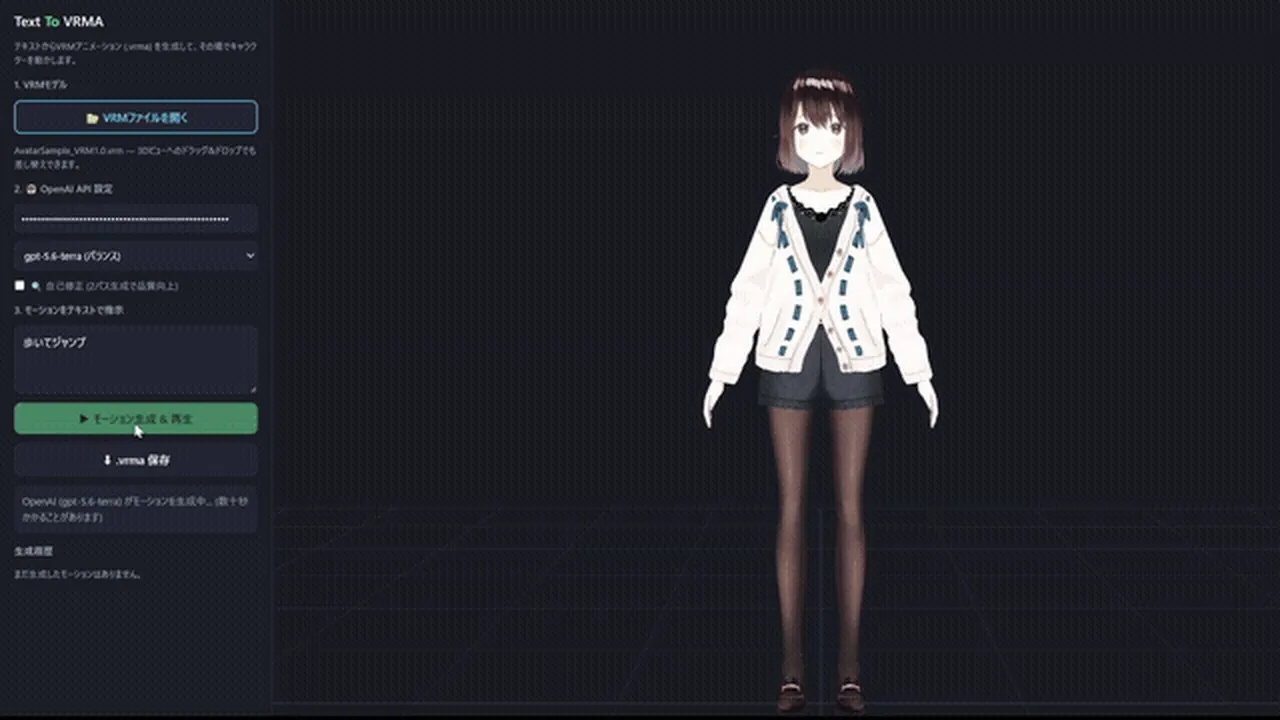
Text-To-VRMA 是原帖中最新的一项,也最直接回答另一个问题:模型生成动作后,独立 VRM 游戏角色究竟怎样真正播放?项目把动作规格打包成带 VRMC_vrm_animation 扩展的 GLB,生成 .vrma 文件,用来驱动受支持的 VRM 0.x 与 VRM 1.0 人形骨架。
它提供两条路径。一条让通用大模型按结构化格式生成骨骼关键帧;另一条运行 NVIDIA ARDY 本地引擎,并可以在前面加规划器来生成全身动作。项目的价值不在于发明更强的动作基准,而在于把最后一公里摊开:骨骼命名、坐标系、身体比例、肩部间隙、默认手指弯曲、循环接缝、根运动、表情和视线曲线。
重定向是一连串坐标变换
ARDY 的 CoreSkeleton27 并不是 VRM 人形骨架。转换器先做语义骨骼映射,再把全局旋转转换成相对父骨骼的局部旋转。简化形式是:
$$R^{\mathrm{local}}_b=\left(R^{\mathrm{global}}_{\mathrm{parent}(b)}\right)^{T}R^{\mathrm{global}}_b$$
仓库还会做身体比例修正。在受支持的 Core 到 VRM 设置中,腿长缩放约为:
$$s_{\mathrm{leg}}=\frac{0.90-0.08}{0.896}\approx0.915$$
这不是通用重定向常数,而是该项目坐标系和模型比例下的应用级标定。换一套源骨架,就必须重新测量并做姿势测试。
构建器还加入了几项面向交付的默认处理。没有手指动作输入时,它会烘焙轻微自然弯曲;手臂抬高超过 55 度时,会加入最多 14 度的肩部补偿,避免现实动作套到动漫体型后直接穿进躯干。这些细节很重要,因为即使关节角传递在数学上正确,源角色与目标角色的身体外形不同,也可能出现明显穿插。
循环和根运动不会自动正确
VRM 动画扩展承载人形变换、表情与视线数据,却不规定游戏里的全部播放策略。Text-To-VRMA 会写入循环请求和根运动元数据,在完整动作满足条件时烘焙循环,但最终仍要由应用消费这些语义。忽略元数据的引擎不会因此自动得到无缝循环。
项目自己的评测记录比发布演示谨慎得多。一个六秒的 ARDY 原地行走单样本报告首帧约 844 毫秒、完整生成约 3.49 秒;另一个加入规划器的样本首动作 7.98 秒、完成 10.60 秒。改用蒸馏编码器后,两个固定样例的首个 VRMA 时间分别是 755 毫秒对 730 毫秒,以及 736 毫秒对 246 毫秒。这些都是个别测量,不是生产服务等级协议,而且会随模型、硬件、提示、规划和会话状态变化。
质量记录同样重要。二十秒和三十秒生成在后续区段可能偏离目标。脚部接触、手势时机、终止姿势保持和自然手臂位置仍会失败。一个不同身体比例的转轴测试仍有约 7.7 厘米脚部漂移。固定住脚关节不等于消除了脚底相对地面的滑动。
对游戏团队来说,这意味着该项目是有用的桥,不是动画质量合格证。应把它看作序列化、重定向和会话管理层,并在周边配置验证器与玩法回退。
四条路线的对比
| 路线 | 动作表示 | 主要优势 | 主要游戏风险 | 适合的首个用途 |
|---|---|---|---|---|
| MDM | 带扩散的连续关节轨迹 | 帧级控制、修补和几何损失 | 迭代生成与短时动作 | 离线镜头、动作编辑和高质量变体 |
| MotionGPT | 与语言模型共享的量化动作 token | 语义创作、描述和多任务交互 | token 分辨率与较弱的局部身体控制 | NPC 意图展开、动作检索和对话式工具 |
| MoMask | 残差 VQ token 加掩码与残差 transformer | 由粗到细且生成过程紧凑 | 重定向和接触修复仍在模型之外 | 大规模预生成动作库 |
| Text-To-VRMA | 带 VRM 人形元数据的动画 GLB | 真实角色交付、表情、循环和本地接口 | 重定向误差、比例差异和运行时语义 | VRM 原型与独立游戏接入 |
这张表也说明,为什么单张指标榜会误导决策。MDM、MotionGPT 和 MoMask 在不同检查点、不同训练目标下报告 HumanML3D 与 KIT-ML 指标;Text-To-VRMA 根本不使用 FID 评估,因为它是交付系统。团队应该分别问四个问题:
- 模型是否理解所需动作与时序?
- 在要求的时长内,动作是否保持物理合理?
- 经过目标骨架和实际环境后,动作是否仍然成立?
- 运行时能否满足产品的延迟、内存和确定性要求?
真正缺失的是动作验收层
游戏行业早就有这套语言。一个动画是否能上线,不只看“像不像”。它还需要明确的根运动曲线、接触约束、碰撞质量、转场窗口、事件标记,以及检查失败时的回退。文本生成动作研究经常在进入这一层之前结束。
验证器可以测量接触脚与地面的距离:
$$d_{\mathrm{contact}}(t)=\left|p_{\mathrm{foot}}(t)-p_{\mathrm{ground}}(t)\right|$$
在落地区间 $t\in[a,b]$ 内,还可以测量水平滑动:
$$S=\max_{t\in[a,b]}\left\|p_{\mathrm{foot}}^{xz}(t)-p_{\mathrm{contact}}^{xz}\right\|_2$$
循环质量也不只是首尾姿势距离。边界处的速度和加速度同样重要:
$$\Delta_{\mathrm{loop}}=\left\|p(0)-p(T)\right\|+\lambda_v\left\|\dot{p}(0)-\dot{p}(T)\right\|+\lambda_a\left\|\ddot{p}(0)-\ddot{p}(T)\right\|$$
这些量可以对每个生成候选自动计算。游戏可以拒绝不合格候选、重定向到另一套骨架,或者在玩家看到坏帧之前切换到手工动画。
不同玩法应该选哪条路线
预烘焙过场与脚本演出
离线使用 MDM 或 MoMask。每个节拍生成多个候选,通过人工审查和数值接触检查后,把批准的片段烘焙进引擎。这样运行时没有模型延迟,艺术家也能继续调整根轨迹、镜头时机和交互。需要中间帧或局部修改时,连续扩散更自然;需要大量连贯动作变体时,MoMask 更有吸引力。
NPC 反应与短对白动作
使用按语义标签索引的预生成动作库。MotionGPT 可以把对白目标转成结构化动作查询,MoMask 可以离线扩充动作库。运行时从少量已验证片段中选择,按移动状态混合,并让面部、视线和道具动画继续由现有引擎系统负责。每句对白都现场生成新片段,成本高且难以验证。
连续移动与交互控制
把 ARDY 风格的生成当作实验性控制层,不要把它直接当成移动状态机的替代品。两秒未来窗口可以支持滚动会话,但游戏仍需掌握输入、碰撞、体力、加速度和中断语义。前文的延迟样例远高于 16.7 或 33.3 毫秒的单帧预算,因此现实设计必须预生成、缓冲或混合,并保证玩家操作持续生效。
VRM 优先的独立原型
从 Text-To-VRMA 开始,因为它先消除了资产格式摩擦。准备一组短而固定的测试动作:行走、转身、挥手、坐下、站起和急停。至少在两种身体比例、不平地面、带外套或裙摆的角色上测试同一组动作,再判断质量能否满足游戏镜头距离。四分之三近景里好看的动作,放到全身玩法镜头里可能完全失败。
成本、许可与可复现性
仓库代码的许可证不等于完整的许可审计。MDM、MotionGPT、MoMask 和 Text-To-VRMA 使用较宽松的代码许可,但模型权重、训练数据、第三方模型和生成结果可能有各自条款。Text-To-VRMA 的 README 明确区分了 MIT 代码与 NVIDIA ARDY 权重及其他模型组件。商业游戏应维护依赖清单,并在上线前逐项核对检查点、数据集、tokenizer 和运行时库。
可复现性是另一个生产问题。扩散采样、大模型关键帧生成和长时间 ARDY 会话都可能随种子、上下文、模型版本和硬件变化。游戏需要用提示、模型版本、种子、目标骨架和动作长度建立缓存键,否则一次补丁或服务重启就可能悄悄改变已经批准的动画。对实时 NPC,更安全的模式是记录动作规格并烘焙批准变体,而不是玩家每进一次房间都重新生成同一段情绪表演。
一条可执行的原型路线
小团队不必一次押注完整研究栈,可以先这样接通第一版:
- 定义标准骨架。选一套人形骨架,记录关节名、静止姿势、单位、前向轴和根节点约定。
- 冻结动作数据结构。保存帧率、时长、根轨迹、局部旋转、接触状态、事件标记和循环意图。
- 离线生成。需要可编辑连续镜头时用 MDM,需要较大动作库时用 MoMask。保留提示、检查点、种子和解码设置。
- 先重定向,再判断好坏。映射到游戏骨架后,至少用两种身体比例测试。不能只在模型源骨架上调参。
- 做数值检查。测量脚滑、地面穿透、根漂移、骨骼长度变化、循环接缝误差和终止姿势误差。
- 缓存跑通后再加运行时。可以用 Text-To-VRMA 或本地接口做实时原型,但必须保留已验证回退动作和硬超时。
近期最有价值的产品,不是让 NPC 每次从零即兴生成全部肢体动作,而是把语言请求转成一小批物理合理、已重定向、可量化检查的动作片段,再由玩法系统确定性地选择。
怎样才算真正进步
下一项有用的研究结果,应同时处理语义控制与接触感知的长时生成。更强的游戏基准至少应报告:
- 指定动作与时序是否成功;
- 整段动作的脚滑与地面穿透;
- 目标场景中的根轨迹和碰撞误差;
- 在游戏动画状态机下的循环与转场连续性;
- 多种身体比例下的重定向误差;
- 真实运行时路径的延迟分布与内存占用;
- 模型或服务不可用时,系统是否确定、是否会安全回退。
在这些测量普及之前,最稳妥也最有用的结论是:MDM 展示了连续扩散如何让动作可编辑;MotionGPT 展示了共享语言与动作 token 如何统一任务;MoMask 展示了强力的由粗到细 token 生成器;Text-To-VRMA 展示了怎样把结果送入真实角色格式。它们都没有消除重定向、接触验证、运行时策略和失败回退。
这不是单个项目的缺陷,而是生产问题的形状。演示结束于角色看起来动得可信;游戏开始于这段动作必须活过玩家操作、摄像机、碰撞体和接下来的十二秒。
来源
- @dogahack 的原帖
- MDM 仓库与 Human Motion Diffusion Model 论文
- MotionGPT 仓库与 MotionGPT 论文
- MoMask 仓库与 MoMask 论文
- Text-To-VRMA 仓库及其 ARDY 集成文档
- NVIDIA ARDY 仓库
仓库与文档陈述检查于 2026-11-17。星标数和延迟样例都是会变化的快照。上文论文指标和项目自述限制不能视为独立的游戏引擎基准测试。
原文来源:X / @dogahackhttps://x.com/dogahack/status/2122454917311070217