Jev 与 System One Model:把前沿智能做成一次函数调用
TypeSafe 首个 System One Model Jev 精读:三种提问原语、并行经济学、置信度分层路由、官方评测偏差与八处毛边,附 OpenJev 本机复现。
2026 年 9 月 15 日,隐身两年的 TypeSafe AI 开放了它第一个 System One Model 的早期访问,模型名叫 Jev。它不生成字符串:输入一段非结构化状态和若干带类型的问题,输出是带类型的概率化决策——是/否的概率、选项上的分布、档位上的分数,每个答案附一个校准过的置信度。官方给它的定位是一句话:把「前沿智能」做成一次函数调用。
这篇文章把发布文、官方文档、Workflow Evals 站、开源复现项目 OpenJev 以及当日社区讨论里真正有用的部分收在一处:它是什么、怎么调、怎么问才对、置信度怎么变成系统行为、评测数字该怎么读、账单长什么样、官方自己承认的八处毛边,以及一个能在本机跑起来的同类实现。
一、System One Model 是什么:名字里的两个典故
System One 取自卡尼曼《思考,快与慢》里快而直觉的系统一;Jev 取自经济学家威廉·斯坦利·杰文斯——杰文斯悖论说的是蒸汽机效率提升之后煤炭需求反而增加,TypeSafe 赌的是同一件事发生在智能上:成本每降一个数量级,就会解锁更多数量级的用例。创始人 Diogo Almeida 此前在 OpenAI 参与了指令跟随与对话训练方法的研究,也就是后来 ChatGPT 背后那批工作。
官方对这类模型的定义很克制:为「软件可以直接使用的、快速的结构化决策」而构建的前沿模型。它不是小模型,也不是 LLM 的蒸馏版;训练方法是 RLCD(面向校准决策的强化学习),配一套新架构和一个硬件感知的并行采样器,训练数据全部自造,不公布任何公开基准分数——官方把这叫 antibenchmaxxing,理由是标准基准测的不是它要做的任务。
| 维度 | 现有 LLM | Jev(System One Model) |
|---|---|---|
| 训练目标 | RLHF(人类偏好)+ RLVR(可验证奖励) | RLCD:校准决策,给出认识论上诚实的概率 |
| 输入 | 非结构化文本,重点是顺序消息 | 非结构化文本或结构化程序状态 |
| 输出 | 字符串:灵活但需解析校验,可能跑偏 | 类型安全的结构化值,不可能类型错误 |
| 采样 | 顺序自回归,一次一个 token | 并行:一次查询生成全部答案 |
| 价格 | 输入每百万 token 0.20 到 10 美元,输出约为输入 5 倍 | 输入每百万 token 0.042 美元,输出免费 |
| 端到端延迟 | 3 到 329 秒 | 70 到 500 毫秒 |
| 置信度 | 倾向过度自信且不一致 | 每个输出带校准置信度:更高置信意味着更高准确率 |
| 适合 | 人在环路的对话、copilot、编码 agent;可验证问题 | 智能的 if 语句:分类、路由、打分、抽取、护栏、PB 级 map-reduce、实时 UX |
关键差异在输出形状。字符串什么都能是,包括幻觉;而 Jev 的答案被约束在你给的选项集合里,它错起来的样子是「在你给的选项里挑错了」,而不是「吐出一个不存在的值」。流水线不会崩,这是优点;但错误看起来很正常、不会被解析器拦住,这是它独有的风险,后面会回到这一点。
二、三种提问原语与一次真实请求
Jev 有且只有三种问题类型,用途由返回形状决定。Noul 是/否判断,返回 0 到 1 的「是」概率,没有单独的置信度字段——那个概率本身就是答案;接近 0.5 表示是与否各半,不是「中等程度」。Choice 从一组选项里挑一个,返回选中的选项、每个选项的概率(和为 1)与置信度。Score 在你写好的档位上给一个位置,返回可以是小数的分数(1.3 表示主要落在第 1 档、有一点落在第 2 档)、档位编号到描述的 legend、各档概率与置信度。
一次请求可以混用三种原语,每个问题对同一份状态独立评估、并行执行,加问题几乎不增加延迟,只多一点输入 token。HTTP 接口只有一个端点:
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer <API_KEY>
Content-Type: application/json

{
  "state": "Help! My payouts have been failing for 3 days.",
  "model": "jev-latest",
  "questions": {
    "is_urgent": { "type": "noul", "instructions": "Does this convey urgency?" }
  }
}
响应里每个问题 id 对应一个 typed answer,外加 usage。Choice 的响应长这样:
{
  "model": "jev-latest",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "probabilities": { "billing": 0.08, "technical": 0.85, "sales": 0.07 },
      "confidence": 0.82
    }
  },
  "usage": { "input_tokens": 312, "output_tokens": 48 }
}
Python SDK(pip install typesafe-sdk,要求 Python 3.10 以上)把同样的请求写成对象,客户端自动读环境变量 TYPESAFE_API_KEY、默认调用 jev-latest:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()
ticket = "Hi, I've been trying to connect my Stripe account for 3 days..."

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=[
                "Calm, just stating facts",
                "Frustrated but civil",
                "Very angry, strong language",
            ],
        ),
        "is_urgent": Noul(instructions="The message conveys urgency or time-sensitivity"),
    },
)

print(response.answers["department"].choice)   # "billing"
print(response.answers["frustration"].score)   # 1.035
print(response.answers["is_urgent"].noul)      # 0.999
当前版本是 jev-1.13.0,别名 jev-latest 与 jev-preview 都指向它。官方提醒:别名会随发布移动,如果你针对某个版本调过置信度阈值,请在 model 字段里钉住版本 id,按自己的节奏迁移。限额为每秒 25 万 token、每分钟 1200 请求,且官方明说早期阶段限额会动态调整。
三、怎么问才对:这门手艺比模型本身更值得抄
判据只有一条:一个问题只问一个「有知识的人看一眼就能答」的判断。「分析这条消息并确定最佳行动」是坏问题,它需要慢思考,看到就该拆。多因素判断拆成原子问题,在代码里加权合成——官方简历筛选的例子把「Python 深度 / 带队 / 系统设计 / 通用」四个维度各打一个 Score,再按岗位合成:
py      = response.answers["python_depth"].score / 4
lead    = response.answers["team_leadership"].score / 4
arch    = response.answers["system_design"].score / 4
general = response.answers["generalist"].score / 4

# Senior IC
ic_score = (0.40 * py) + (0.10 * lead) + (0.40 * arch) + (0.10 * general)
# Engineering Manager
em_score = (0.15 * py) + (0.40 * lead) + (0.20 * arch) + (0.25 * general)
好处不只是准确:优先级变化时你改的是代码里的系数,不用重写提示词,而且最终排序是怎么算出来的完全可见。
其余几条实操规则,全部来自官方文档与 cookbook:
- 状态是 JSON 时用点号路径指名字段,例如「ticket.messages[0].text 是否请求退款?」,让模型明确该看哪一块,而不是自己在整份状态里找。
- 档位写情形,不写程度。「功能坏了但有绕行方案」能匹配状态,「中等严重」不能。同一份 bug 报告,档位写成 0/1/2 三个数字时模型给出 0.57 分、置信度 0.35;写成具体情形描述后判断就稳定了。每档是独立判断,模型看不到档位编号,「比上一档更差」这类相对描述没有意义。
- Choice 的选项列表留一个「其他 / 以上都不是」,否则模型会被迫在错的选项里挑一个。
- 想要等级就用 Score,不要用 Noul。0.5 的 Noul 是「是与否平权」,不是「中等水平」。
- 一次把问题问满,包括投机性问题。工单分类和 bug 严重度同时问:如果不是 bug 报告,代码直接忽略严重度答案,省下一次往返。
四、并行是经济学的核心
Jev 先读入整份状态,再并行处理全部问题,所以它的上下文口径和别人不一样:状态加全部问题合计 64k token,状态加最长单个问题 32k token。最高效的用法就是把问题塞满一次调用。官方并行问题手册的实验是 13 个问题(8 个 Noul、2 个 Choice、3 个 Score)跑在一份固定版本的 GDPR 维基百科全文上:合成一次调用比拆成 13 次便宜约 12.2 倍、快约 10.0 倍,答案完全一致;快速上手页引用同一实验时给的是 11.5 倍与 9.6 倍,量级一致,写「约 10 到 12 倍」最稳妥。
基数上限是 255 个选项。超过时走两阶段:先对候选独立打分,再显式选择,会慢一点。官方的 Wikiracing 演示就是高基数选择的复利样本——每一步在几百到几千个链接里选,不幻觉的收益在这里被放大。
五、置信度:把不确定性变成系统行为
Choice 和 Score 的 confidence 是从概率分布形状算出来的统计量:分布越尖越自信,摊得越开越不确定。官方说这只是「大多数场景够用」的默认定义,完整分布 probabilities 也一并返回,你可以自定义更适合任务的度量。官方还特意提醒:如果只是要选最优选项,直接取概率最高的那个即可,不需要阈值;真有统计算法需求时应该用 probabilities 而不是 confidence。
推荐的用法是三段式:高置信自动执行;中置信继续但加确认、标记复核或补信息;低置信不执行,转人工或换路径。关键在下一句——阈值不是一个数,它随风险分层。官方语音银行的例子:
action = response.answers["intent"]

if action.confidence < 0.6:
    route_to_support_agent(account_id)          # 任何动作:低于 0.6 一律转人工
elif action.choice == "check_balance":
    show_balance(account_id)                    # 低风险:0.6 足够
elif action.choice == "approve_transfer":
    if action.confidence > 0.85:
        approve_transfer(account_id)            # 高风险 + 高置信:自动执行
    else:
        ask_user_to_confirm("Just to confirm...")  # 高风险 + 中置信:先反问
else:
    route_to_support_agent(account_id)
flowchart TD
  Q[Jev 返回 intent 的 Choice 与 confidence] --> F{confidence 低于 0.6}
  F -- 是 --> H[转人工客服]
  F -- 否 --> C{动作类型}
  C -- check_balance --> B[直接播报余额:低风险]
  C -- approve_transfer --> G{confidence 高于 0.85}
  G -- 是 --> A[自动批准转账]
  G -- 否 --> K[反问用户确认后再执行]
  C -- 其它 --> H
查余额错了最坏是用户多听一遍余额;批准转账错了是真金白银。风险容忍度写在你的代码里,不在模型里。官方紧接着的警告值得抄在工位上:阈值该定在哪,取决于你的领域和模型在你任务上的表现——从保守值开始,用你自己的数据测。
为什么这句警告重要:我们在一个开源的并行约束解码模型(同一类「校准概率」机制)上跑过 30 条带金标的决策评测,平均置信度 0.82,实际准确率只有 0.70;置信度 0.95 以上的那批子集也只有 72.7% 正确。Jev 是专门按校准目标训练的,理论上应好得多,但「把别人的阈值抄过来直接用」在任何模型上都不可靠。
六、评测怎么读:帕累托前沿与方法论偏差
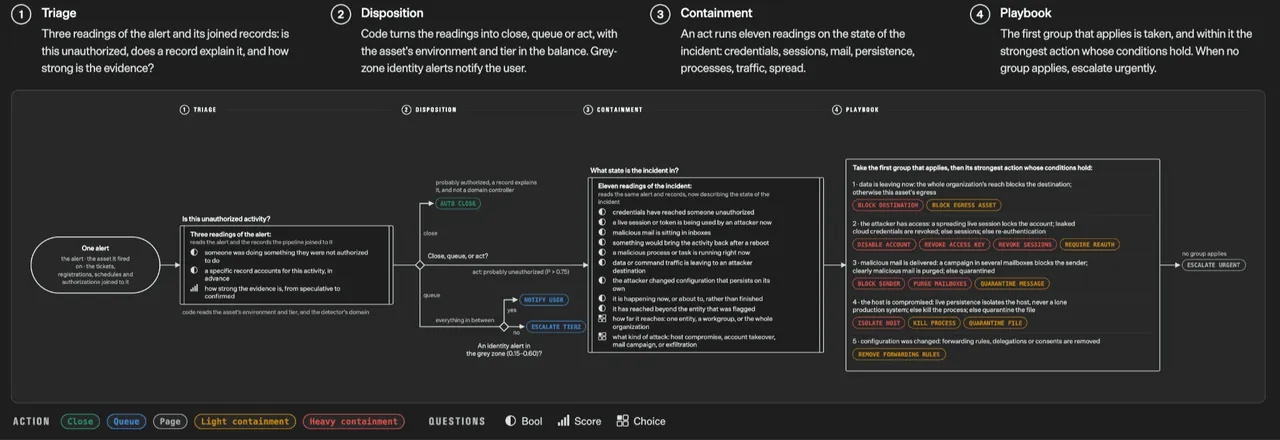
TypeSafe 自己做了一种新评测:不优化标准答案分类,也不让 harness 和模型同时变化(那会鼓励 harness 过拟合),而是假设存在一个正确的计算图,把任务拆成 Noul / Choice / Score 问题加代码规则,参考标签取当前最强两个模型——GPT-6 Astra 与 Fable 5.1、均开高思考——对每个问题回答的平均。四个工作流上 Jev 的成绩:
| 工作流 | Jev 准确率 | 单例成本(USD) | 单例耗时 |
|---|---|---|---|
| 安全事件处置 | 61.7% | 0.0001 | 0.3 s |
| Agent 轨迹可观测性 | 71.6% | 0.0003 | 0.5 s |
| 发票处理 | 61.8% | 0.0011 | 0.5 s |
| 客服下一步动作 | 76.0% | 0.0001 | 0.4 s |
| 四流平均 | 67.8% | 0.0004 | 0.4 s |
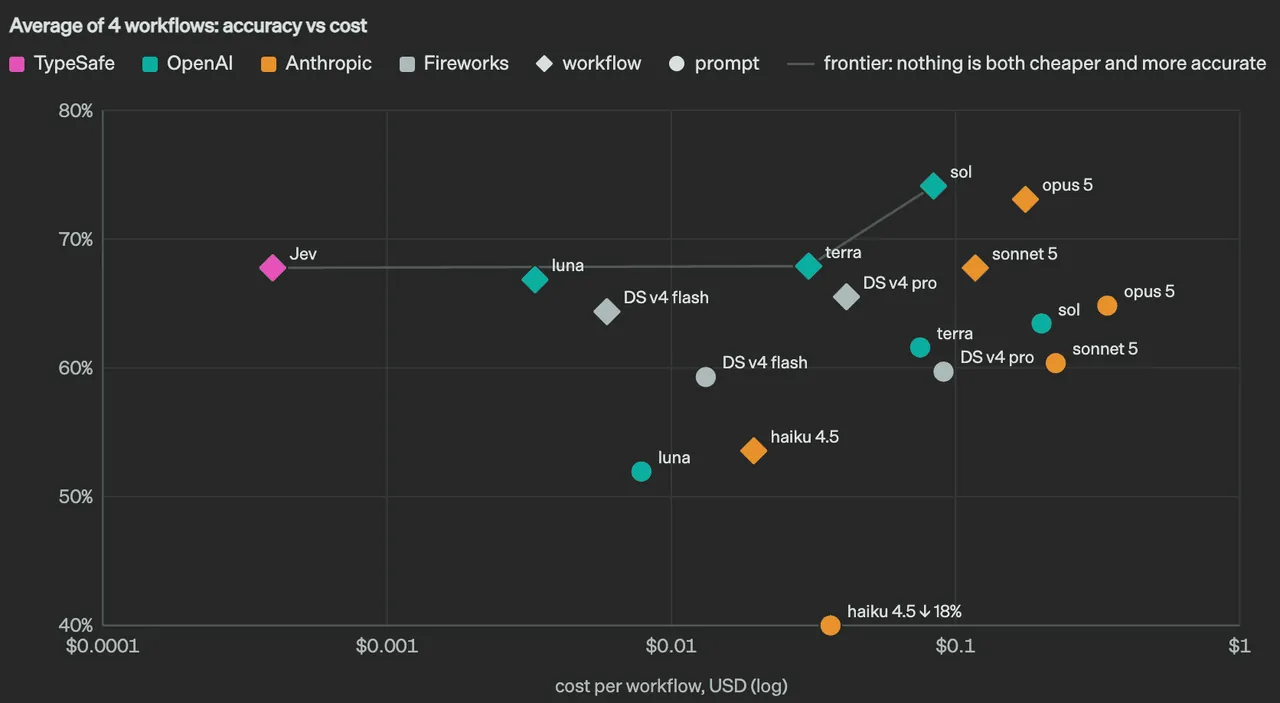
对照组里:opus 5 的 workflow 形态 73.1%、单例 0.1761 美元、37.8 秒;sol 74.1%、0.0836 美元、23.3 秒;terra 67.9%、0.0304 美元、10.1 秒;luna 66.8%、0.0033 美元、12.9 秒;haiku 4.5 的 workflow 形态只有 53.6%,而把同一策略写成一段提示词后掉到 18.1%(安全事件流是 58.8% 对 17.1%)。结构永远更好这条结论对所有模型成立,不只是对 Jev。
方法论的偏差官方自己标了出来:参考标签偏向 OpenAI 与 Anthropic,可能低估 Jev 相对 DeepSeek 系的表现;四个工作流不在 Jev 的训练分布里,但由 TypeSafe 能力团队成员制作;LLM 对照组用的是 TypeSafe 自己的 System One 包装器(把 LLM 约束成兼容的结构化决策),比直接输出决策更准但更慢更贵。首页「快 193.6 倍、便宜 444.6 倍」出自这组评测,官方承认那是真实收益里偏乐观的一端。读数字时把这些折扣一起读进去。
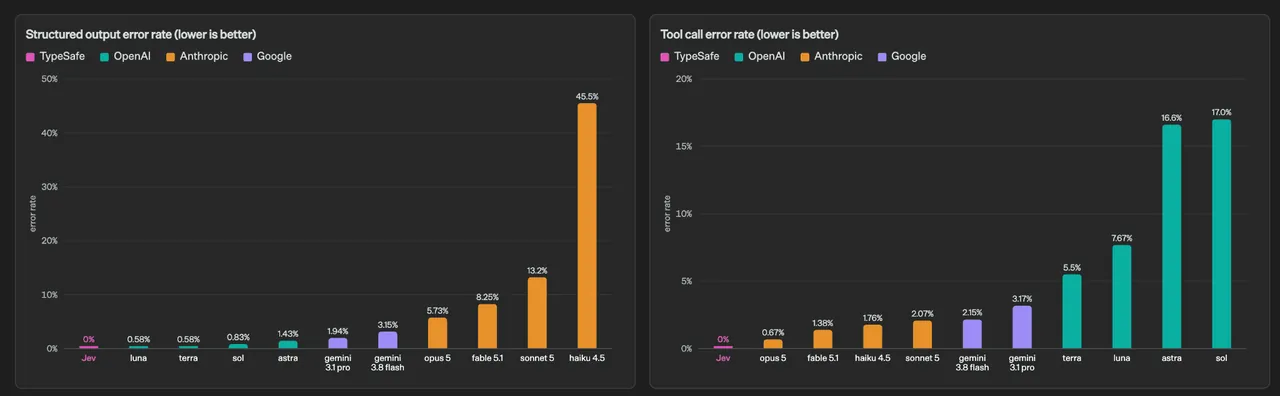
0% 那一栏值得多看一眼:它不是测出来的,而是因为类型安全在构造上成立,所以官方敢在图里写 0。对嵌入代码的决策来说,这一条比准确率更重要——一次幻觉的工具调用在 agent 里只是不方便,埋在有延迟保证的系统或依赖链深处就是灾难。
七、账单:智能每小时多少钱
定价是输入每百万 token 0.042 美元(每十亿 42 美元),输出免费——便宜到不值得计费。比 Claude Fable 5.1 的输入价低 238 倍。用例级的价格感来自 Doom 演示:每秒 10 次查询,约合每小时 7 美元;做这个 demo 的工程师最初担心的就是这笔钱,团队其余人的结论是比预期便宜。
把并行批处理算进去,价格还能再压一个数量级:13 问合一批就是约 12 倍的账单差。对一个每天跑百万次判断的路由层来说,这是「能不能上生产」和「只能做 demo」的区别。官方也坦白:无法证明定价没有补贴,可持续性要靠时间证明,他们预期价格会降而不是涨。
八、官方自曝的八处毛边(jev-1.13,2026-09-16 复核)
| # | 失败模式 | 官方给的替代做法 |
|---|---|---|
| 1 | 字面阅读:回答你写的问题,不是你想问的问题 | 把准确条件写进 instructions,边界情形放进 criteria;解释不清的答案,缺的那半句就是 instruction |
| 2 | 数学与计数:不可靠,误差随规模增长 | 算术留在代码里;计数用循环逐项问 Noul 再自己求和 |
| 3 | 日期时间比较:把日期当文本而非有序量 | 抽取交给模型(月/日/年都是小闭集,用 Choice 并留「未提及」),排序、时长、偏移全部在代码里 |
| 4 | 间接跳转:属性的属性、多跳推理掉准确率 | 指令写直接;用名字点出相关状态片段 |
| 5 | 大而无相关性的状态:无关细节是干扰项 | 先在代码里检索过滤,只送问题需要的字段;必要时用 Noul 做相关性过滤 |
| 6 | 对抗内容:状态是数据,默认不当作敌意输入 | criteria 写明确,上线前测边缘用例 |
| 7 | instructions 与 criteria 互相矛盾 | 把 criteria 当作 instruction 的延伸,两者对齐;true 映射 no 这类反向写法会显著变差 |
| 8 | 生成:它不生成文本 | 需要生成就用生成式模型;或把生成空间枚举成 Choice |
第 2 条的官方示例代码值得直接抄:对列表里每一项问一个「是不是水果」的 Noul,再在代码里按阈值求和,计数这件事模型一点不参与。另外 Score 的期望值不要用来插值还原精确数值——档位的数值校准是弱项,只能用来判断过不过某个阈值。
九、OpenJev:在本机把同一条路走通
排队等早期访问的同时,可以先在本地跑同类实现。OpenJev(MIT 许可)把 Qwen3.5-4B 训成一个 NLI 交叉编码器:读入前提与假设,输出 entailment / contradiction / neutral 三个概率。就这一个原语,足以做重排、按参考打分、内容护栏,以及实时玩游戏——把游戏状态和几句关于它的陈述喂进去,取 entailment 的 argmax 就是下一步操作。Doom 是零样本打出来的,先从文本状态,再直接走 Qwen3.5 视觉塔从像素打;Flappy Bird 同样零样本。没有任何按任务训练。
from modeling_openjev import OpenJevCrossEncoder
jev = OpenJevCrossEncoder("AlexWortega/openjev", subfolder="qwen3.5-4b-nli")

jev.predict([("The bird is 0.05 below the centre of the gap.",
              "The bird is below the centre of the gap.")])
# -> [[contradiction, entailment, neutral]] 三个概率

jev.rerank("Which gas do plants absorb during photosynthesis?",
           ["oxygen", "carbon dioxide", "nitrogen"])
# -> entailment 概率最高的选项下标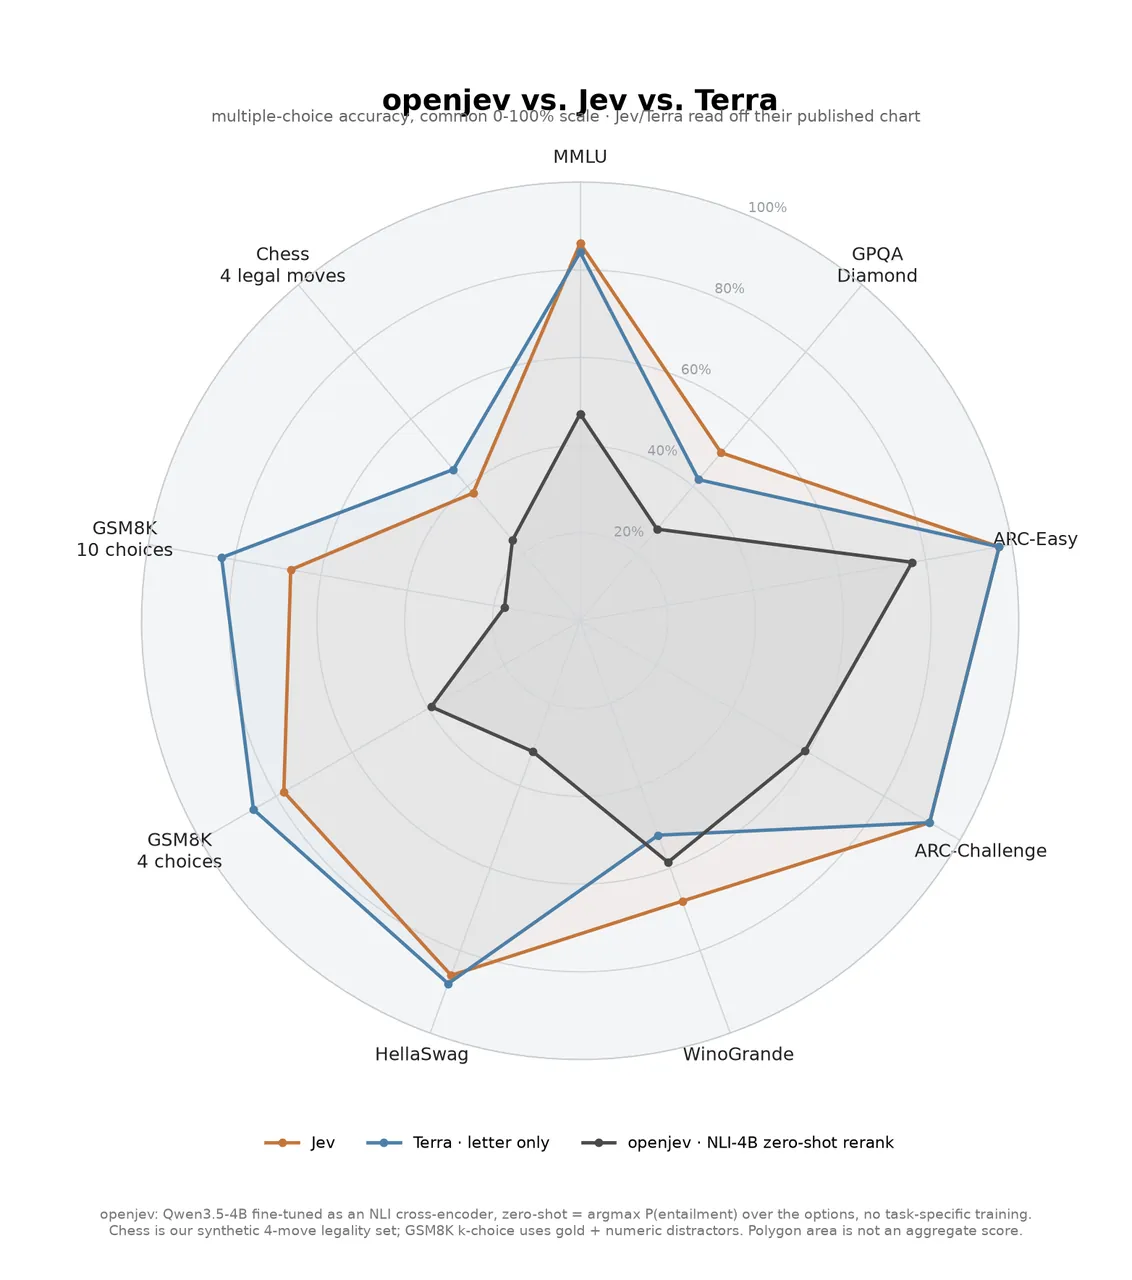
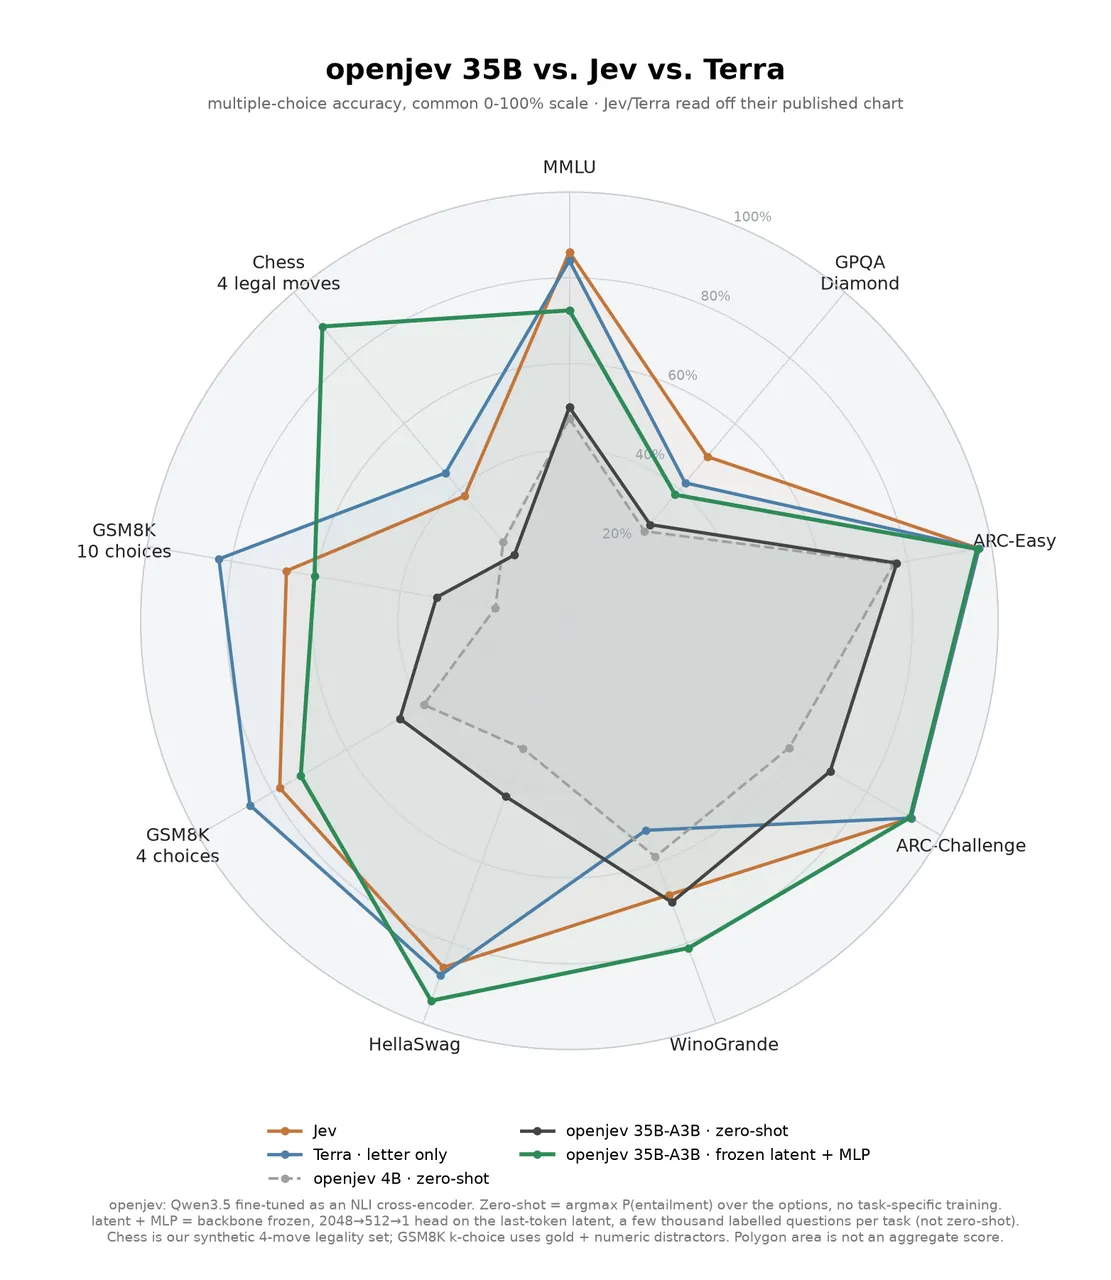
它不是 Jev:没有校准训练、没有并行采样器、基数和延迟都不在一个量级。但它是目前唯一能把「决策原语 + 实时控制回路」这条路在本机完整走一遍的开源实现,用来验证接口形状、harness 结构和自己的阈值策略足够。
十、对 agent 与机器人 harness 的含义
把 Jev 放回 agent 工程的语境里,它抢的不是 LLM 的活,而是 harness 里那些「每次都要叫一次前沿模型太贵太慢」的位置:轨迹要不要人看、工具调用结果是否合规、感知状态是否满足某条前置条件、这一帧该执行哪个离散动作。这些判断的共同点是输入已有、选项可枚举、延迟敏感、调用量巨大——正是 System One 的目标形状。
对机器人侧尤其如此:控制回路里的语义判断(「物体是否已稳定抓取」「指令是否要求放下」「当前场景是否危险」)过去要么写脆规则、要么塞给一个几百毫秒起步的 VLM。Jev 这类模型给出第三条路:把判断写成若干原子问题,概率进代码,阈值按风险分层,执行层永远只看到 typed 值。OpenJev 的 Doom 与 Flappy Bird 已经证明这条回路在零样本下能闭合,剩下的问题是校准与延迟。
也要看清它不做什么:长链条推理不是它的事,生成不是它的事,计数和日期算术不是它的事。它是系统一,慢思考仍然要交给系统二。两者组合的方式官方已经给了:intent routing——Jev 站在最前面做快分类,把请求分给确定性逻辑、专家 LLM 或人类。
上线前清单
- 每个问题只含一个原子判断;多因素拆开后在代码里加权合成,权重集中放在一个文件里便于评审。
- 档位写情形不写程度;Choice 留「其他」;要等级用 Score 不用 Noul。
- 把全部问题(含投机性问题)塞进一次调用;状态先过滤再送。
- 计数、日期、算术全部留在代码里;模型只做抽取与判断。
- 置信度阈值按动作风险分层,从保守值开始,在自己的金标数据上量一遍再放宽。
- 钉住模型版本 id 调阈值;别名只用于实验。
- 为「在选项里挑错」这类静默错误建监控:类型安全意味着解析器不会替你报警。
整理自 TypeSafe AI 发布文与官方文档、Workflow Evals 站、OpenJev 模型卡,以及 yibie 在 X 上的当日实测讨论;文中成本与延迟数字均引自上述一手来源。
- 发布文:Introducing System One Models and Jev
- 官方文档:docs.typesafe.ai(primitives / api / confidence / patterns / model-jaggedness)
- Workflow Evals:evals.typesafe.ai
- 开源适配器:typesafe-ai/system-one-adapter-python;agent skill:typesafe-ai/skills
- OpenJev:huggingface.co/AlexWortega/openjev
- 当日讨论与实测:yibie on X
原文来源:TypeSafe AI / yibie (X)https://x.com/yibie/status/2100541283081023936