OPEN SOURCE DEEP DIVE
EvoOntology:越用越懂数据的自进化本体层
人大数据实验室的自进化本体层(946★,MIT,Python):领域语义固化为带版本管理的本体层,经 MCP 工具供 Claude Code / Codex 按需查询;诊断→归因→补丁→门控评估的演化循环让本体随执行轨迹持续变准,DDR-Bench 四骨干平均 69.5→89.5。
一句话定位
EvoOntology(github.com/ruc-datalab/EvoOntology,MIT,Python,2026-09-15 创建,约 950 star)是中国人民大学数据实验室开源的一个自进化本体层:把散落在表名、字段、文件路径里的领域语义,固化成一个带版本管理的本体(Ontology Layer),通过 MCP 工具提供给 Claude Code / Codex 这类编码智能体按需查询,并在真实执行轨迹的驱动下持续演化。论文(arXiv:2609.15779)把它定位为首个面向数据智能体(data agent)的自进化本体层。
理解它的一句话来自作者自己的比喻:本体层是可训练的 agent 状态,而不是模型权重。模型不变,变的是 agent 赖以理解数据的那层语义——它像权重一样被构建、被评估、被门控发布,只是训练信号来自智能体与数据交互的真实轨迹。
它要解决的问题:agent-data gap
论文把这个鸿沟讲得很直白:异构数据(表格、文件、数据库)住在 agent 身体外面,agent 只能通过通用工具够到它们——看得见列名和文件路径,看不见指标口径、实体关系和业务约束。由此生出三个具体痛点:
| 痛点 | 现状 | 后果 |
|---|---|---|
| 语义不确定性 | 原始数据的语义是隐式的:表名、列名、零散观测值说明不了指标怎么算、实体怎么连 | agent 每个请求都在猜业务含义,猜错就产生语义级错误,而且不报错 |
| 重复的数据探索 | 没有可复用、有依据的知识沉淀,每次任务重新"发现"环境 | 同样的表被反复理解,交互轮次与 token 花在重复劳动上 |
| 高昂的语义维护成本 | 人工写的语义层依赖专家持续维护,数据与工作负载一变就过时;整包注入 prompt 还会带来不断增长的上下文开销 | 静态语义层越"全"越贵,且追不上数据的变化 |
已有的两条路都不理想:让 agent 直接探索原始数据(等于每个任务从零开始),或者把人工构建的语义层整包塞进 prompt(贵、脆、追不上变化)。EvoOntology 的取舍是第三条路:工作负载接地(workload-grounded)、按需查询、受控演化。
本体层:三层架构
整个系统封装为一个 MCP server,内部是三个相互关联的层,分别回答"语义知识是什么""表示规则是什么""运行时怎么访问":
| 层 | 内容 | 作用 |
|---|---|---|
| Content Layer(内容层) | 类型化语义图,四类节点:Term(术语)、Mapping(映射)、Constraint(约束)、Evidence(证据);Semantic Relation 连接 Term,Structural Reference 把 Term 链到 Mapping,并把 Constraint / Evidence 挂到它们管辖或支撑的对象上 | 语义知识本身:每个概念都能追到"哪个表的哪个列、用什么口径、有什么证据" |
| Schema Layer(模式层) | 定义四类节点的字段、允许的 Semantic Relation 类型、合法的 Structural Reference 模式 | 划定本体的表达边界——演化只能在边界内做类型化编辑,不许自由发挥 |
| Tool Layer(工具层) | 通过 browse_semantics、resolve_semantics 和一份紧凑的 session manifest 暴露本体 | 运行时访问面:会话初始化只注入 manifest,具体记录按需检索 |
每个发布版本在磁盘上是五个记录文件(Term / Mapping / Relation / Constraint / Evidence),存放在项目根的 .evoontology/versions/ 下;同一目录还有 trajectories/(每个任务一条工具调用粒度的轨迹,不记录思维链)、evolution/run_N/(每轮演化的诊断、归因、补丁与评估记录)以及 state.json(触发检查点与阈值)。
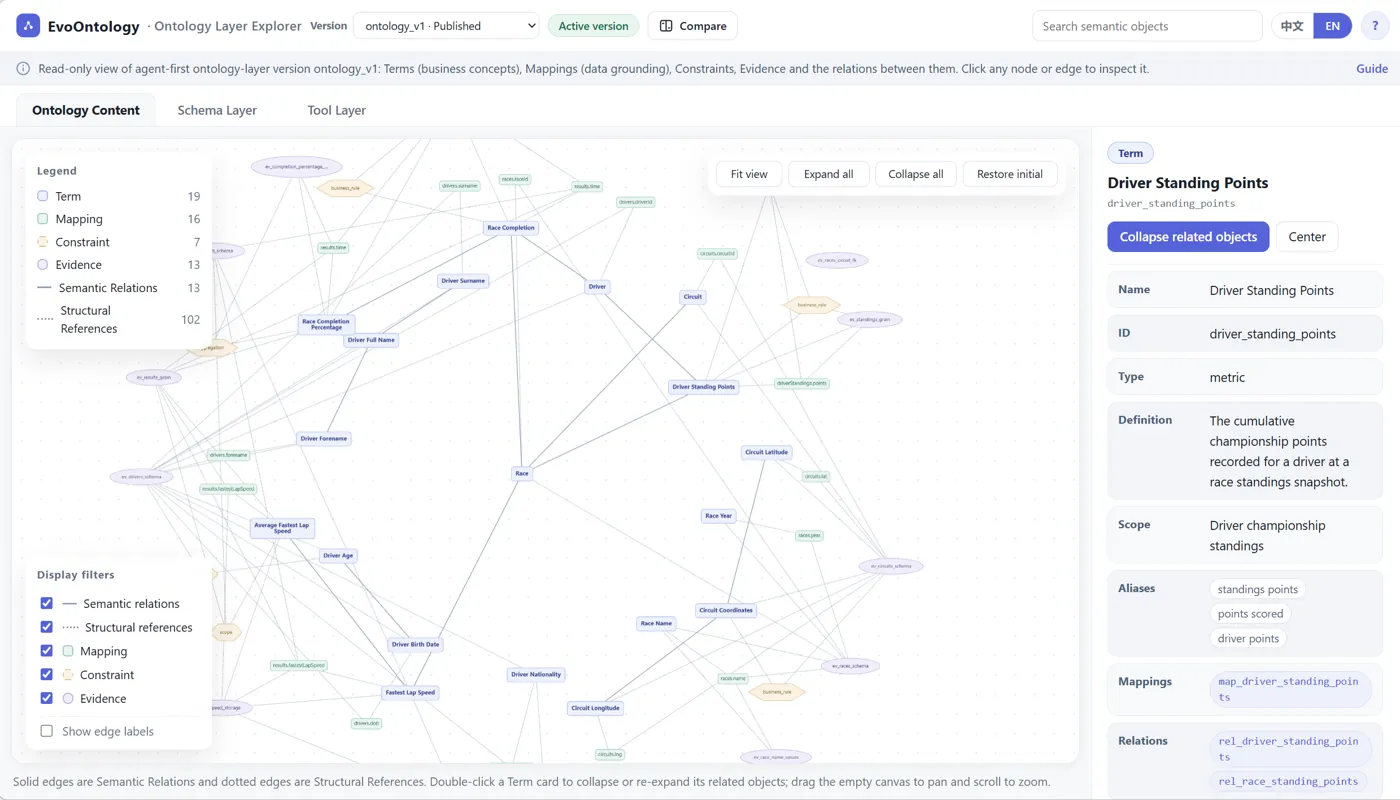
Explorer 里的 Content Layer:概念、映射、约束、证据及其关系全部可点开检查——"可检查"是这套设计对语义维护成本的回答。
工作方式:按需查询,而不是全量注入
装上插件后,数据智能体在 MCP 层面拿到三样东西:browse_semantics(query, kind, limit) 发现相关概念、resolve_semantics(mentions, context) 把提到的概念解析到接地的映射及其关系/约束/证据、以及会话开始时读一次的 evo-semantic://session-manifest 紧凑清单。详细记录和关联对象一律按需检索——这是 README 里"主动访问(Active access)"原则的落地:只取当前步骤需要的语义,不把整个本体倒进上下文。
与之配套的是"基于证据构建(Grounded construction)":Builder 围绕真实工作负载提炼候选概念,并且只有对照底层数据源验证通过,才提交为语义对象。发布前还有一道确定性闸门 validate_semantics:检查 JSON 合法、引用完整、可加载——注意这是结构校验,表和列是否真实存在、映射能否执行、证据能否复现,属于 Builder 探索阶段的职责,两层分开。
自进化循环:诊断 → 归因 → 补丁 → 门控
这是 EvoOntology 与"静态语义层"真正的分水岭。生命周期五步:Build(从工作负载推导候选概念、对照原始数据验证、发布 ontology_v0)→ Use(智能体按需查询,同时记录工具交互与结果)→ Evolve(诊断重复出现的行为,归因到 Content / Tool / Schema 层,生成本地化的候选补丁)→ Evaluate(相同数据、相同智能体、相同解码设置与交互预算下,Parent 与 Candidate 配对比较)→ Publish or reject(通过评估才发布 ontology_vN+1,否则保留 Parent,把结论带入下一轮)。
演化由核心包里的 EvolutionSession 状态机托管,skill 决定"改什么、为什么",状态机保证"一次 run 不会以错误方式结束":
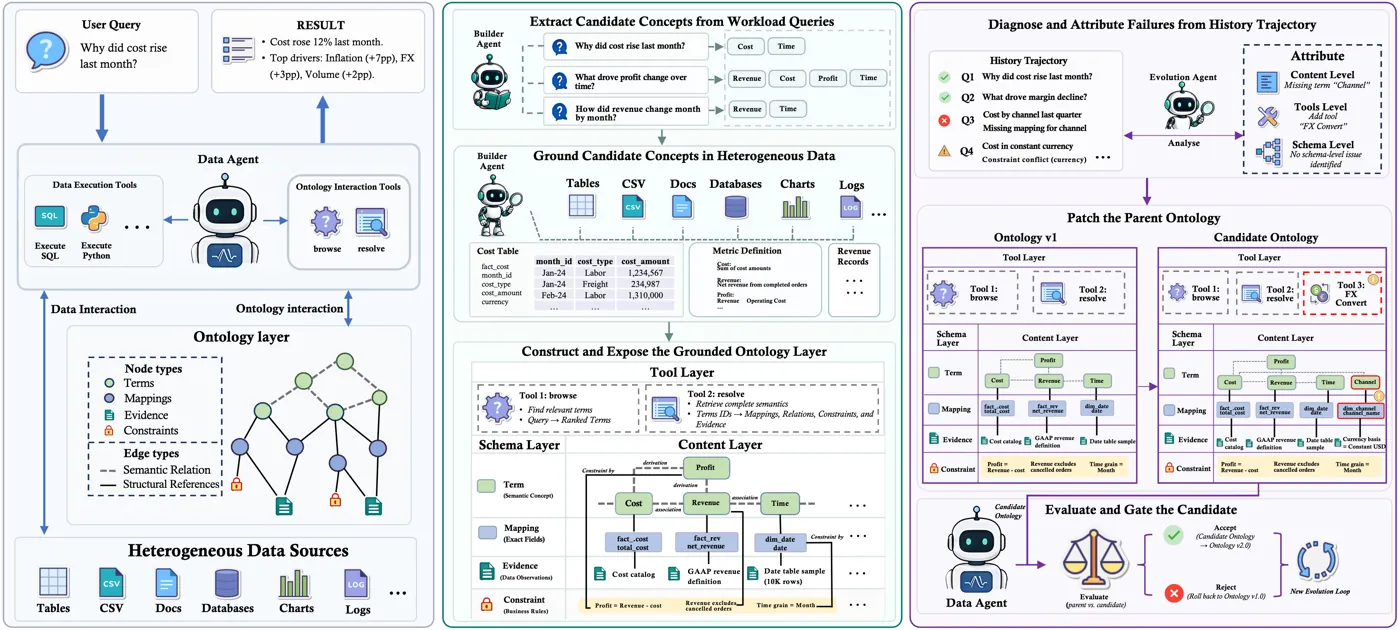
构建与演化框架:左半是"本体从哪来"(Builder 围绕真实工作负载构建、对照原始数据验证),右半是"本体怎么变"(诊断 → 归因 → 补丁 → 配对门控评估)。
| 状态迁移 | 含义 |
|---|---|
| running ──Reject──▶ running | 候选被否不是终点:摘要写进 rounds.jsonl,更新归因与问题地图,同一轮里设计下一个候选 |
| running ──Accept──▶ accepted | 搜索结束:确定性验证 → 发布新版本(不覆盖任何已发布版本)→ 更新 active.json → 检查点只前进一次 |
| running ──预算耗尽 / 外部阻塞──▶ incomplete | 不发布、不推进检查点,同一批数据下一轮重试;判断型停止理由(缺数据、评估不可信)要求同一轮内至少有 2 次正式否决 |
默认参数:一轮 8 个候选预算;距上一检查点新增 30 个任务或满 7 天触发演化;零配置——没有 config.yaml,想改行为直接对 Claude / Codex 说"每 60 个任务提醒我一次",agent 会写进 state.json。版本命名也有纪律:已发布用 ontology_vN,候选用 vN-cK,接受才把 vN-cK 映射成 ontology_vN+1。
两种模式与门控评估
Build 第 0 步会把项目模式写进 project.json,两种模式共用同一套工作区、版本与检查点机制,只是工作负载进入构建/演化/评估的方式不同:
- fixed_split:用于有固定题集、标准答案与评估边界的基准。构建池用于 Build 与诊断;验证储备只用于最终门控,不许回流进构建、诊断或补丁生成——这是防"用考试题训练"的隔离设计。
- rolling_trajectory:用于生产或冷启动,没有固定测试集。种子工作负载初始化 ontology_v0,之后任务轨迹持续累积;触发后冻结一批,用独立采样任务或 LLM Judge 做 A/B 比较,不强行折半。
门控评估本身也两条协议:有标准答案就走绝对评分,没有就走匿名 LLM Judge A/B。配对比较的底色是论文里那个词——backbone-conditional:同一种子演化出的本体是绑定骨干模型的(见下文评测),所以 Parent/Candidate 必须在同一骨干、同一预算下比。
评测:三个基准、六个骨干
论文在三个被广泛采用的数据智能体基准上做了实验:BIRD(真实数据库 text-to-SQL,Oracle Knowledge 设定,主指标执行准确率 EX)、DDR-Bench(10-K 金融数据的开放式深度研究,主指标 Trajectory-Wise)、InsightBench(迭代式业务分析与洞察)。骨干覆盖 GPT-5.5、GPT-5.6-sol、Claude-Sonnet-5、Claude-Opus-4.8、DeepSeek-V4-Flash、Qwen3.5-Flash 六个,分析子集取前四个。以下为论文报告的四骨干平均:
| 基准 / 指标 | ReAct(无本体层) | 初始本体层 | EvoOntology(进化后) |
|---|---|---|---|
| DDR-Bench · Trajectory-Wise | 69.5 | 81.8 | 89.5(+20.0) |
| BIRD · EX | 63.6 | 68.7 | 72.4(+8.8) |
| InsightBench · Insight | 53.2 | 54.0 | 54.2(+1.0) |
读这张表要诚实:DDR-Bench 是主战场,自进化在初始本体之上再拿 7.7 个点;InsightBench 几乎走平(+0.2),说明开放式洞察生成吃不到多少本体红利;同一张表里 ReAct + 情景记忆基线是 75.8——EvoOntology 的 +20.0 里,大概六成来自"有本体",四成来自"会进化"。
消融实验回答了"进化循环里到底哪一步值钱"(DDR-Bench,四骨干平均,Trajectory-Wise,完整循环 89.5):
| 变体 | 得分 | Δ |
|---|---|---|
| 去掉门控(w/o Gate) | 78.3 | −11.2 |
| 去掉归因(w/o Attribution) | 83.2 | −6.3 |
| 去掉诊断(w/o Diagnose) | 84.7 | −4.8 |
| 去掉类型化补丁(自由格式) | 87.8 | −1.7 |
门控是整套设计里最值钱的一环(−11.2),比归因和诊断都大——"进化"本身不稀缺,敢只发布可复现优于父本的候选才稀缺。三个可编辑层级单独进化时, Tool 层 +13.2 > Content 层 +8.7 > Schema 层 +3.6,合起来才够到 +20.0;本体结构消融里 Mapping 最重(−13.4),Evidence 次之(−8.7)——"概念连到哪个表的哪个列"和"凭什么这么连"是这个本体的承重墙。
开销:上下文多了,总 token 少了
按需查询不等于免费。论文在 DDR-Bench 上量了本体层的开销(四骨干平均):每轮输入 token 从 3.2K 涨到 4.6K(初始 4.1K),输出 token 不变;但每任务轮次从 14.6 降到 8.4,每任务总 token 从 52.6K 降到 42.0K(−20%)。少走弯路省下的 token,盖住了多带语义多付的 token——这是"主动访问"相对"全量注入"的账本区别。
另一条值得记住的结论:静态语义层注入(SL)在强骨干上反而掉分(Claude-Sonnet-5 的 Trajectory-Wise −15.0)。prompt 里倒什么,强模型就依赖什么,倒错了比不倒更糟。而各骨干进化出的 Term 标识符两两 Jaccard 重叠不超过 0.62,跨骨干迁移至少掉 6.6 个点——本体是绑定骨干的资产,没有"一个本体通吃所有 agent"的便宜事,这也是评估必须 backbone-conditional 的原因。
安装与使用
产品形态是两个自包含插件,走各自 client 的 Marketplace,不需要 clone 仓库、建虚拟环境或单独 pip install:
- Claude Code:
claude plugin marketplace add ruc-datalab/EvoOntology→claude plugin install evoontology@evoontology - Codex:
codex plugin marketplace add ruc-datalab/EvoOntology→codex plugin add evoontology-codex@evoontology
新会话里三个技能入口:Claude Code 用 /evoontology:build-ontology、/evoontology:evolve-ontology、/evoontology:explore-ontology,Codex 用 $build-ontology 等同名工作流。插件通过 .mcp.json 以模块方式拉起服务,client 自动 spawn,默认工作区是项目根的 .evoontology/。仓库里另有 benchmarks/(BIRD、DDR-10K、InsightBench 三个环境,各实现一个 EvolutionAdapter,python -m benchmarks list 可列出)和约四千六百行确定性 Python 核心——核心只做运行时、最小确定性校验与演化生命周期状态机,智能分析全在技能里,产品没有 CLI。
它在 harness 版图里的位置
本站 harness(智能体运行时)这一域收的是"agent 跑在什么上面":插件与沙箱、工具接口、技能系统、长程记忆与自我改进。EvoOntology 是这条线上一个少见的样本——它不改 agent 本身,而是给 agent 外挂一层会进化的语义状态:插件形态(Marketplace 安装、Session Start 提醒)、工具接口(MCP 的 browse/resolve 双导航工具 + manifest 资源)、技能系统(build/evolve/explore 三技能)、自我改进(门控演化循环)四件全占;它明确把沙箱、常驻 worker、自动循环放在首个版本范围之外,这点也写在这里,不夸大。
和站内同类资产对照:deepagents 们解决"上下文装什么",EvoOntology 解决"上下文里关于数据的部分从哪来、怎么更新"。如果说编码 agent 的骨架管的是任务状态,EvoOntology 管的是数据语义状态——而且它是目前少见把"评估门控"做进演化循环里的:不是"进化完给你看",而是"可复现地更优才发布"。对做数据智能体、Text-to-SQL、分析型 agent 的读者,这个仓库值得按评测章节的数字逐条对论文复核;对做 agent 基础设施的读者,EvolutionSession 那个状态机(Reject 不终点、只有 Accept 推进检查点)是可直接借用的工程范式。
边界与注意事项
- 结构校验 ≠ 语义校验:validate_semantics 只保证 JSON 合法、引用完整、可加载;映射能否执行、证据能否复现,靠 Builder 探索阶段,别把闸门当万能。
- 本体绑定骨干:跨骨干迁移掉分(≥6.6 点),换模型请重新 Build/Evolve,不要直接搬 workspace。
- InsightBench 几乎无感:开放式洞察生成任务别期待本体的红利,它的甜区是结构化查询与深度数据研究。
- 首版范围外:Web UI、SaaS、多租户、消息队列、常驻 worker、并行候选、全自动循环都不在首个发布里——完全无人值守的演化需要常驻后台 worker,当前版本提供检测与提醒,执行由人发起。
- 论文数据:文中全部跑分来自 arXiv:2609.15779(2026-09-14 提交)的报告值,非本站复测;按本站惯例,第三方复现之前请以"论文报告"档看待。