PAPER DEEP DIVE
BSC-Nav:从反应式到认知式,为具身智能体装上类脑的三维空间记忆
清华大学(计算机系、心理与认知科学系)与北京航空航天大学提出 BSC-Nav(Brain-inspired Spatial Cognition for Navigation)。论文指出,现有具身智能体无论走端到端强化学习还是「MLLM + 模块化流水线」,本质上都是反应式、无状态的——处理完观测就丢弃,缺乏持久的空间内部模型,导致知识碎片化、规划短视、泛化差。作者从神经科学借来答案:生物把空间知识巩固为地标、路线知识、概览知识三种互相连接的形式。BSC-Nav 用三个模块在计算上实例化了这套结构——地标记忆以四元组(世界坐标、开放词汇类别、检测置信度、GPT-4o 生成的上下文描述)编码显著线索与位置的持久关联,并用「空间重叠集 + 置信度加权融合」去重;认知地图用 DINO-v2 提取 patch 特征,经逆透视投影与级联坐标变换投射到体素网格,并采用受自由能原理启发的 surprise 驱动更新——按新特征与邻域内既有特征的平均距离决定是否写入,缓冲区满则替换 surprise 最低者,从而既保留跨视点多样性又控制存储;工作记忆按指令复杂度分层检索,简单目标用纯文本 GPT-4 推理地标记忆(甚至能由共现地标推断未记录目标的位置),复杂目标先由 GPT-4o 精炼描述、再用 Stable Diffusion 3.5 「想象」目标外观,经 DINO-v2 编码与中心距离加权池化后查询认知地图(imagine-then-localize),最后用相似度加权 DBSCAN 聚类得到候选坐标。多候选时不贪心选最高置信度,而是用 H_i = λ·p_i + (1-λ)(1-d_i/d_max) 复合打分排序探索序列。实验覆盖 MP3D/HM3D 共 62 个场景、8,195 个 episode:OGN 在 HM3D 达 78.5% SR(超 SOTA 的 UniGoal 24.0 个百分点),OVON 以零样本超越有监督的 DAgRL,IIN 达 71.4%;SPL 提升比 SR 更一致(IIN 达 57.2% vs 23.7%)。主动具身问答 A-EQA 上 LLM-Match 54.6 为最高,但仍落后人类 27.5。真机用 AgileX Ranger-mini-3.0 底盘 + Franka Research 3 机械臂 + RealSense D435i 平台,在约 200 m² 两层空间跑 75 个 episode,IIN 有 4/5 目标达 100% SR,失败时也稳定定位到语义合理区域;并展示了导航与操作原语协同的长程任务(如「做早餐」依次操作三个开放词汇物体)。论文提出「空间认知的具身图灵测试」应考察三个维度:实时构建可复用空间表征、从稀疏部分观测中抽象推理、把高层目标转译为可执行空间计划。
论文来源:arXiv:2508.17198(cs.AI),清华大学(计算机系/心理与认知科学系)+ 北京航空航天大学,2025 年 8 月 24 日提交,40 页。代码 github.com/Heathcliff-saku/BSC-Nav。
一句话概括
现有具身智能体无论走端到端强化学习还是「MLLM + 模块化流水线」,本质上都是反应式(reactive)、无状态的——处理完观测就丢,没有持久的空间内部模型,于是知识碎片化、规划短视、泛化差。BSC-Nav 从神经科学借来答案:生物把空间知识巩固为地标(landmark)、路线知识(route knowledge)、概览知识(survey knowledge)三种互相连接的形式。BSC-Nav 用三个模块在计算上实例化了这套结构——地标记忆编码「显著环境线索 ↔ 空间位置」的持久关联,认知地图把自我中心的运动轨迹体素化成 allocentric(以世界为中心)的地图式表征,工作记忆按目标复杂度分层检索并组合这两者。接上 MLLM 后,它在 Object-Goal / Open-Vocab / 文本实例 / 图像实例四类导航任务上全面达到 SOTA,具备强零样本泛化,并在真实世界的导航与移动操作中验证有效。
1. 从反应式到认知式
1.1 瓶颈到底在哪
空间认知——获取、组织、利用并更新关于外部空间的知识——对人类和 AI 都是基础能力。它不只支撑导航和操作这类感觉运动技能,也支撑抽象、规划与推理等高级认知功能。
尽管 MLLM 进展迅速,现有人工系统在大规模空间认知上仍有根本局限,尤其在需要长程导航与移动操作的任务中。核心瓶颈是缺乏结构化空间记忆——一种持续编码、组织、检索环境空间知识的机制。绝大多数现有方法「以反应式、无状态的方式处理观测」,没有持久的外部空间内部模型,智能体就无法整合出连贯的空间表征,也无法超越即时刺激做推理。
作者因此主张一次范式转变:从反应式处理转向以记忆为中心的空间认知,支持跨时间与空间的持久表征和组合式推理。
1.2 生物学给的三件套
数十年的神经科学研究表明,生物把空间知识巩固为三种不同但互相连接的形式:
- 地标(landmarks)——编码显著环境线索的稳定关联,支撑定位与情境理解;
- 路线知识(route knowledge)——捕捉地标之间的自我中心运动轨迹,用于习惯性导航与路径整合;
- 概览知识(survey knowledge)——把多条路线整合为 allocentric 的、地图式表征,支撑灵活推断、抄近路与绕行规划。
这些表征通过工作记忆(尤其是视觉-空间工作记忆)被访问与协调,从而根据任务需求和环境熟悉度做自适应检索、组合与泛化。
地标"] --> B4["Working Memory
工作记忆"] B2["Route Knowledge
路线知识"] --> B4 B3["Survey Knowledge
概览知识"] --> B4 end subgraph Art["BSC-Nav 的计算实例化"] O["环境观测
RGB-D + 位姿"] --> L["Landmark Memory
地标记忆
(坐标, 类别, 置信度, 描述)"] O --> C["Cognitive Map
认知地图
体素化 DINOv2 特征
+ surprise 驱动更新"] L --> W["Working Memory
分层检索 + 探索序列规划"] C --> W W --> P["低层规划
仿真: Habitat 最短路
真机: A* + TEB"] P --> V["目标验证 + 可供性
360° 扫描 + CLIP + GPT-4o"] V --> S["高层技能
操作 / EQA / 指令导航"] end Bio -.->|启发| Art
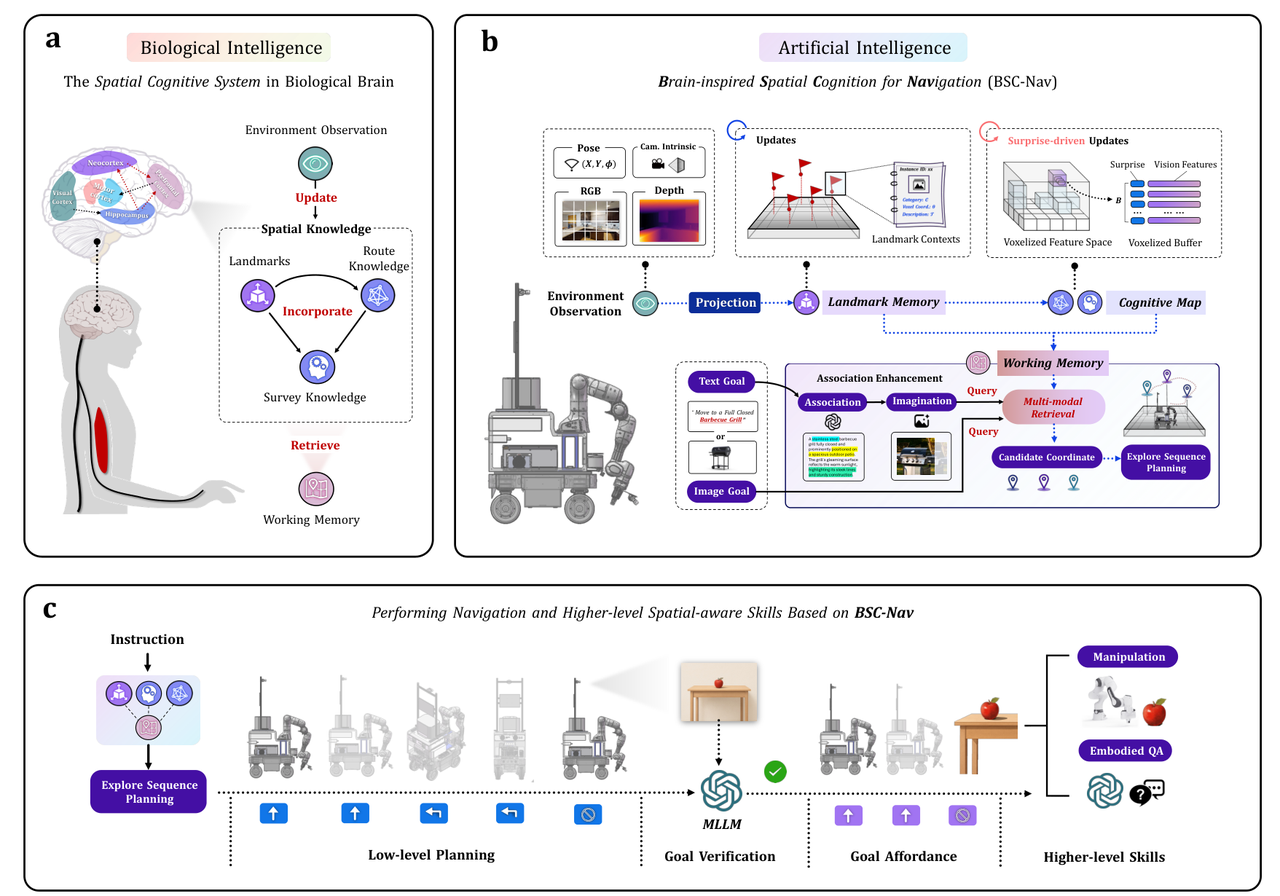
图 1:BSC-Nav 框架——(a) 生物脑中的结构化空间记忆,(b) BSC-Nav 的计算实例化,(c) 结构化空间记忆支撑的导航与高层空间技能。
2. 方法:三个模块
2.0 观测空间
观测定义为 $O_t = \{I_t, D_t, P_t\}$:RGB 图像 $I_t \in \mathbb{R}^{H \times W \times 3}$、深度图 $D_t$、以及位姿 $P_t = (X_t, Y_t, \phi_t^a) \in \mathbb{R}^3$——其中 $X_t, Y_t$ 是世界坐标系下的 2D 位置(默认以 SLAM 初始化点为原点),$\phi_t$ 是偏航角。RGB 供显著目标检测与视觉特征提取,深度与位姿则支撑从像素坐标到世界坐标的投影。
2.1 地标记忆(Landmark Memory)
地标记忆被实例化为一个四元组列表:
$$\mathcal{M}_{\text{landmark}} = \{L_k\}_{k=1}^{N},\quad L_k = \{c_k, \theta_k, \rho_k, T_k\}$$
其中 $\theta_k = (X_k^w, Y_k^w, Z_k^w) \in \mathbb{R}^3$ 是第 $k$ 个实例中心的世界坐标,$c_k \in \mathcal{C}$ 是开放词汇类别,$\rho_k \in [0,1]$ 是检测置信度,$T_k$ 是 GPT-4o 基于观测生成的实例描述(涵盖纹理、形状与空间上下文语义)。
从像素到世界的坐标变换写得很完整。给定检测框中心像素 $(u_k, v_k)$ 与深度 $d_k$,先做逆透视投影到相机坐标系:
$$p_k^{\text{cam}} = d_k \cdot K^{-1}\begin{bmatrix} u_k \\ v_k \\ 1 \end{bmatrix} = d_k\begin{bmatrix} (u_k - c_x)/f_x \\ (v_k - c_y)/f_y \\ 1 \end{bmatrix}$$
其中 $K \in \mathbb{R}^{3\times 3}$ 是内参矩阵。再用位姿构造 base-to-world 变换:
$$T^{\text{world}}_{\text{base}} = \begin{bmatrix} \cos\phi_t & -\sin\phi_t & 0 & X_t \\ \sin\phi_t & \cos\phi_t & 0 & Y_t \\ 0 & 0 & 1 & Z_{\text{base}} \\ 0 & 0 & 0 & 1 \end{bmatrix} \in SE(3)$$
最后级联变换 $\begin{bmatrix} p_k^{\text{world}} \\ 1 \end{bmatrix} = T^{\text{world}}_{\text{base}} T^{\text{cam}}_{\text{base}} \begin{bmatrix} p_k^{\text{cam}} \\ 1 \end{bmatrix}$。实践中使用开放词汇检测器 YOLO-World,预定义常见类别集 $\mathcal{C} = \{\text{ sofa}, \text{ sink}, \text{ bed}, \dots\}$,并用置信度阈值排除语义模糊或不显著的实例。
去重融合机制是这里一个很实用的设计。对新检测到的地标 $L_{N+1}$,定义空间重叠集:
$$\mathcal{U} = \{L_j \in \mathcal{M}_{\text{landmark}} : \|\theta_{N+1} - \theta_j\|_2 < \delta_{\text{overlap}} \wedge c_{N+1} = c_j\}$$
若 $\mathcal{U} \neq \varnothing$,则融合:$\theta_{\text{fused}}$ 按置信度加权平均,$\rho_{\text{fused}}$ 取均值,$T_{\text{fused}}$ 取置信度最高者的描述。融合后 $\mathcal{U}$ 中元素被删除、$L_{\text{fused}}$ 被加入。保证每个四元组代表唯一的空间实例,避免信息冗余。
2.2 认知地图(Cognitive Map)
与地标记忆并行,认知地图把探索轨迹上的 RGB 观测持续投影到体素化的视觉-空间表征中。定义为离散体素表征:
$$\mathcal{M}_{\text{cog}} = \{F_v\}_{v \in \mathcal{V}},\quad F_v = \{f_b\}_{b=1}^{B},\ f_b \in \mathbb{R}^{\hbar}$$
其中 $\mathcal{V} \subseteq \mathbb{Z}^3$ 是体素索引空间,每个体素 $v = (v_x, v_y, v_z)$ 维护一个最多容纳 $B$ 个特征向量的缓冲区,$\hbar$ 是视觉特征维度。
用 DINO-v2 提取 patch 级特征:$F_{\text{patch}} \in \mathbb{R}^{H' \times W' \times D}$,其中 $H' = H/s$、$W' = W/s$,$s$ 为 patch 步长。每个 patch $(i,j)$ 的中心像素为:
$$(u_{ij}, v_{ij}) = (j \cdot s + s/2,\ i \cdot s + s/2)$$
采样该处深度 $d_{ij}$ 后同样做逆投影与级联变换得到世界坐标,再离散化为体素索引:
$$v_{ij} = \left(\left\lfloor \frac{X^w_{ij}}{\Delta} + \frac{G}{2} \right\rfloor,\ \left\lfloor \frac{Y^w_{ij}}{\Delta} + \frac{G}{2} \right\rfloor,\ \left\lfloor \frac{Z^w_{ij}}{\Delta} \right\rfloor\right)$$
其中 $\Delta$ 是体素尺寸,$G$ 是网格维度,$G/2$ 偏移使网格以世界原点为中心。
2.3 Surprise 驱动的更新:自由能原理的计算实例化
关键问题来了:新观测的特征要不要存进体素?全存会导致信息过载与检索低效;常规的网格平均或距离加权融合则会引入表征偏置。BSC-Nav 借用了自由能原理——生物系统通过最小化预测误差来精炼内部模型。对应到计算上,就是按「新观测与既有记忆的偏差程度」即 surprise(意外度)来决定是否写入:
$$S(f_{\text{new}}, v) = \frac{1}{|\mathcal{F}_{\mathcal{N}_n}(v)|} \sum_{f_b \in \mathcal{F}_{\mathcal{N}_n}(v)} D(f_{\text{new}}, f_b)$$
其中 $\mathcal{N}_n(v) = \{v' \in \mathbb{Z}^3 : \|v - v'\|_{\infty} \le n\}$ 是体素 $v$ 的 $n$ 跳立方邻域,$\mathcal{F}_{\mathcal{N}_n}(v)$ 是邻域内所有特征缓冲区的并集,$D(\cdot,\cdot)$ 是距离度量(如余弦距离)。设阈值 $\tau$(默认 0.5):当 $S > \tau$ 时把 $f_{\text{new}}$ 加入 $F_v$;若缓冲区已满($|F_v| = B$),替换掉其中 surprise 分数最低的特征。
两个好处:其一,通过跨视点、跨时间选择性地缓存多样特征,增强空间知识在动态环境中的鲁棒性;其二,避免对稳定环境元素的冗余编码,维持存储与检索效率。每个体素维护一个多特征缓冲区而不是单一聚合向量,这是它与常见体素地图的核心区别。
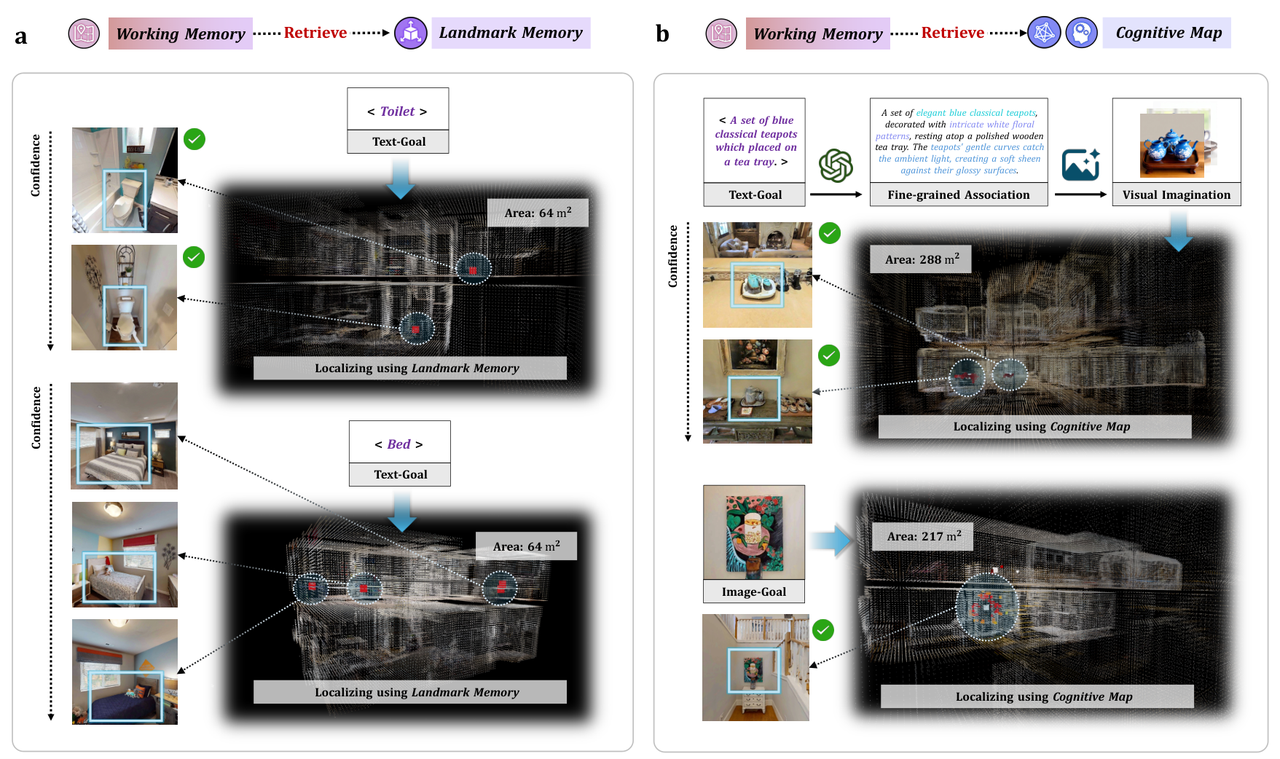
图 2:工作记忆中的分层检索实现精确定位——(a) 简单类别级目标优先检索地标记忆,(b) 复杂实例级目标用关联增强检索查询认知地图。
2.4 工作记忆与分层检索
工作记忆只在收到导航指令时被激活,按指令复杂度采用分层检索:
(a) 简单目标 → MLLM 推理检索地标记忆。地标记忆里的类别、置信度、上下文描述为 MLLM 提供了推理基础。与直接规则匹配不同,这种方式能做上下文感知推理,甚至推断出未被记录的目标位置——例如即便「烤面包机」没被显式记录,系统也能通过「炉灶」「厨房中岛」等共现地标推断其位置。做法是设计检索提示,引导纯文本 GPT-4 综合置信度与描述语义,从 $\mathcal{M}_{\text{landmark}}$ 生成候选坐标集 $\{\theta^{\text{cand}}_i\}_{i=1}^{K}$。
(b) 复杂/细粒度目标 → 关联增强检索认知地图。为了弥合文本指令与视觉表征之间的模态鸿沟:先用纯文本 GPT-4o 精炼目标描述(补充纹理与空间上下文),再用文生图模型(默认 Stable Diffusion 3.5)「想象」目标可能的视觉外观。这个 imagine-then-localize 过程类似人类导航前的心理预演。生成的想象图经 DINO-v2 编码提取 patch 特征后,用中心距离加权池化得到实例视觉表征:
$$f_{\text{target}} = \frac{\sum_{i=1}^{N} w_i \cdot p_i}{\sum_{i=1}^{N} w_i},\quad \text{其中 } w_i = \exp\left(-\alpha \cdot \|(x_i, y_i) - (x_c, y_c)\|^2\right)$$
这个加权抑制背景干扰、强化目标实例的中央特征。池化后的视觉特征作为中间查询,与认知地图中存储的特征做余弦相似度匹配,返回 top-$K$ 体素坐标,再经相似度加权 DBSCAN 聚类得到簇中心的网格坐标作为最终候选。
(c) 探索序列规划。关键设计:工作记忆往往产出多个候选坐标(各有置信度与相对距离),而在类别级导航这类「存在多个合法目标」的场景中,置信度 alone 并不可靠。因此 BSC-Nav 不贪心选最高置信度,而是用复合打分:
$$H_i = \lambda \cdot p_i + (1 - \lambda) \cdot \left(1 - \frac{d_i}{d_{\max}}\right)$$
其中 $p_i$ 是存在概率(地标记忆用检测置信度、认知地图用余弦相似度),$d_i$ 是候选到起点的欧氏距离,$d_{\max} = \max_j d_j$ 做归一化,$\lambda$ 默认 0.5,即对「存在的可能性」与「探索效率」给予同等权重。
2.5 低层规划、目标验证与可供性
低层策略分场景:仿真中用 Habitat 提供的贪心最短路,直接在场景 3D mesh 上计算离散动作空间下的最优动作序列;真机部署用两层规划架构——全局用 A\* 在 LiDAR-SLAM 构建的占据栅格上求全局最优路径,局部用 Timed Elastic Band(TEB) 动态调整轨迹避障,输出连续速度指令控制底盘。
到达候选坐标后:先做 360° 旋转扫描采集一圈 RGB,计算这些图像的 CLIP 视觉嵌入与目标文本/图像嵌入的余弦相似度,选出语义对齐度最高的视角,再送入 GPT-4o 做精确目标验证。GPT-4o 不只确认目标是否存在,还被提示生成一串基于可供性的动作,引导机器人微调位姿、相对位置与朝向,为下游操作创造有利初始条件。
3. 实验结果
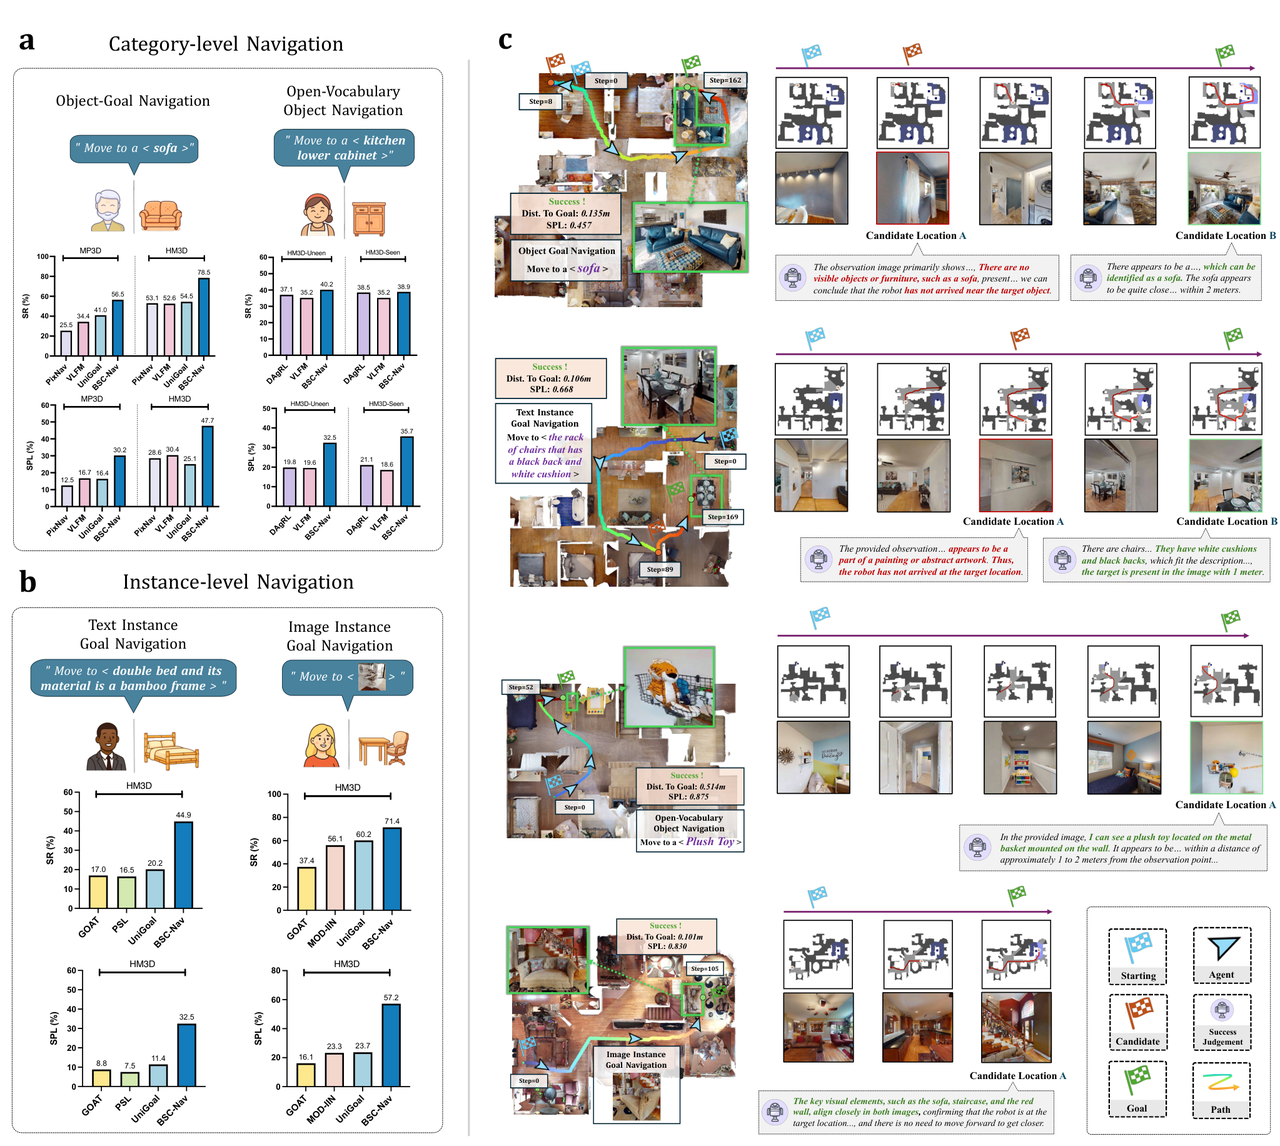
图 3:目标导向的多模态导航——(a)(b) 类别级与实例级四类任务,(c) 导航轨迹可视化与 MLLM 辅助的目标验证。
3.1 仿真:62 个场景、8,195 个 episode
在 Habitat 模拟器的 MP3D 与 HM3D 物理重建环境上,覆盖四类导航任务。每 episode 智能体从随机位置出发,执行离散动作(前进 25 cm、左转 30°、右转 30°、停止);只有在距目标 1.0 m 内执行 stop 才算成功。指标为 SR(成功率)与 SPL(按路径长度加权的成功率)。
| 任务 | 数据集 | BSC-Nav SR | 最强基线 | 提升 |
|---|---|---|---|---|
| Object-Goal (OGN) | HM3D(6 类) | 78.5% | UniGoal 53.1% | +25.4 |
| Object-Goal (OGN) | MP3D(20 类) | 56.5% | UniGoal 52.6% | +3.9 |
| Open-Vocab (OVON) | MP3D unseen | 40.2% | DAgRL 37.1%(有监督) | 零样本超越 |
| Open-Vocab (OVON) | MP3D seen | 38.9% | DAgRL 35.2%(有监督) | 零样本超越 |
| Instance-Image (IIN) | HM3D | 71.4% | UniGoal 60.2% | +11.2 |
| VLN-CE R2R(长程指令) | — | 38.5% | Uni-NaVid 37.4% | 零样本 |
几个要点:
- OGN 上 HM3D 达 78.5%,比 SOTA 的 UniGoal 高 24.0 个百分点;MP3D 场景更大、类别更多,仍高出 15.5 个百分点。作者归因于 UniGoal 只用地标记忆组织了抽象目标与场景图,而 BSC-Nav 用了完整的三种空间知识。
- OVON 涉及 79 种日常物体(如「厨房下柜」),BSC-Nav 以零样本方式超越了有监督的 DAgRL。
- 效率提升比成功率更一致——所有任务上 SPL 都显著更高。原因正是工作记忆里那套「距离+置信度」复合打分,让智能体只检查少量候选位置就能规划出高效的探索序列。
- VLN-CE R2R 长程指令跟随上零样本取得 38.5% SR,距最佳有监督方法只差 8.5 个百分点,且效率更优。
更值得注意的是效率指标 SPL(按路径长度加权的成功率)——BSC-Nav 在所有任务上的提升比成功率还要一致:
| 任务 | BSC-Nav SPL | 最强基线 SPL |
|---|---|---|
| OGN(HM3D) | 47.7% | UniGoal 30.4% |
| OGN(MP3D) | 30.2% | UniGoal 28.6% |
| IIN(HM3D) | 57.2% | UniGoal 23.7% |
| VLN-CE R2R | 53.1% | Uni-NaVid 35.9% |
3.2 主动具身问答(A-EQA)
在 OpenEQA 的 A-EQA 子集(184 个问题,覆盖物体识别 OR、物体定位 OL、属性识别 AR、空间理解 SU、物体状态识别 OSR、功能推理 FR、世界知识 WK 七类)上,与盲 LLM、问题无关的前沿探索策略、Explore-EQA 三种基线比较。指标为 LLM-Match(用 LLM 计算生成答案与参考答案的语义相似度)。
| 方法 | LLM-Match |
|---|---|
| Blind LLMs(GPT-4v / GPT-4o) | 35.5 / 35.9 |
| CG Cap. / SVM Cap. / Multi-Frame | 34.4 / 34.2 / 41.8 |
| Explore-EQA | 46.9 |
| BSC-Nav | 54.6 |
| 人类 | 82.1(BSC-Nav 仍差 27.5) |
分类别看,提升最明显的是需要细粒度空间定位的 OL 与 OSR——这与「结构化空间记忆能做快速准确探索」的假设一致。但作者也诚实指出:与人类仍有 27.5% 的差距,人类空间认知整合了常识知识、因果推断与从极少环境线索中抽象的能力。
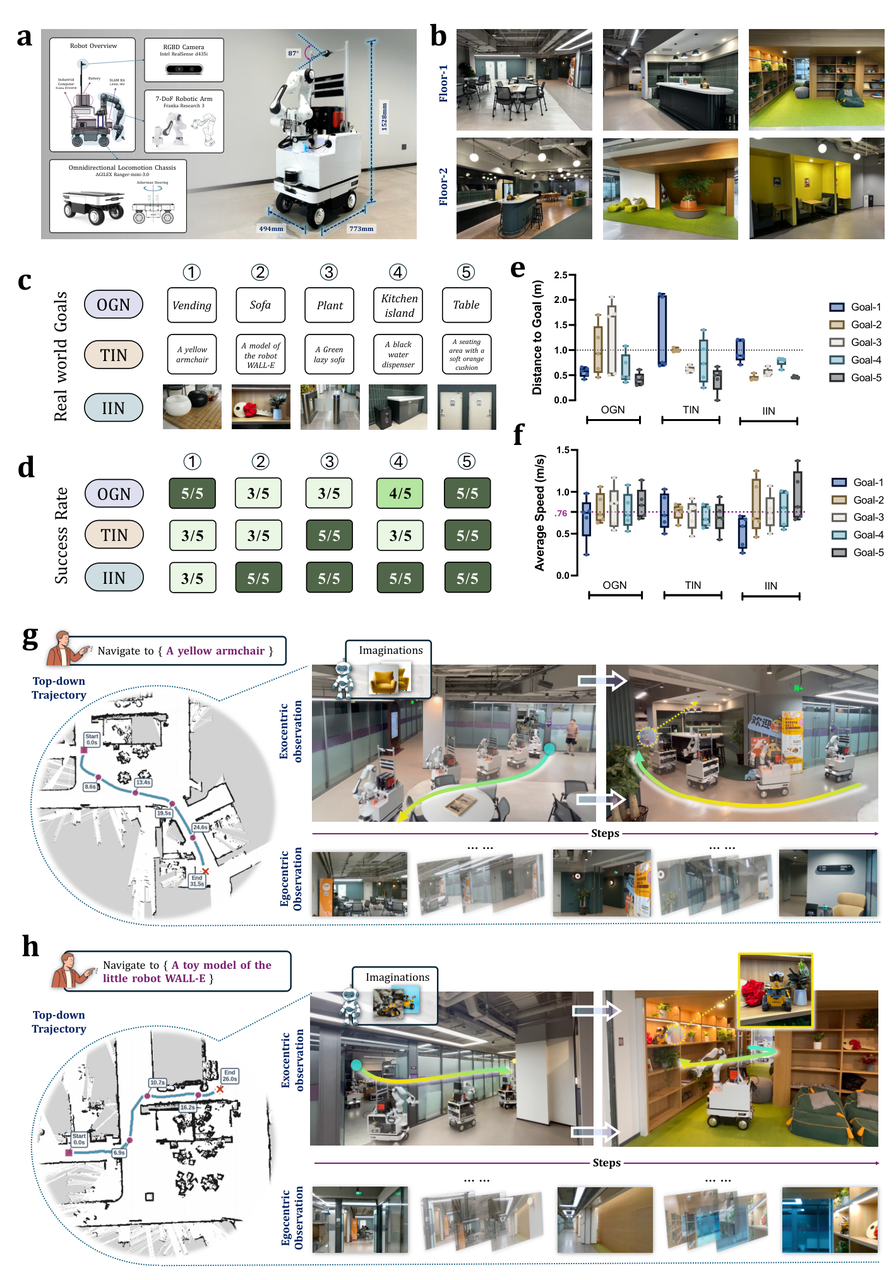
图 5:真实场景中的通用导航能力——(a) 自建移动操作平台,(b) 约 200 m² 两层实验环境,(c)-(h) 三类任务 15 个目标的导航表现与轨迹示例。
3.3 真机:200 m² 两层空间 + 移动操作
自建移动机器人平台:AgileX Ranger-mini-3.0 全向底盘 + Franka Research 3 七自由度机械臂 + Intel RealSense D435i + LiDAR/IMU SLAM 套件 + RTX 4090 工控机,整机尺寸 1528×773×494 mm。
在约 200 m² 的两层室内空间(含办公区、休息区、接待区、厨房等功能分区)跑了 75 个导航 episode,覆盖 OGN / TIN / IIN 三类任务、每类 5 个不同目标,每个目标从随机起点测 5 次,平均路径长 23.4 m:
- 每个目标至少 3/5 次成功(成功定义为 1.0 m 内到达);
- IIN 表现最好,5 个目标中有 4 个达到 100% SR;
- OGN 与 TIN 各有 2 个目标达 100%,所有情况均超过 66.7%;
- 即使失败,BSC-Nav 也稳定定位到语义上合理的区域——这说明它确实具备空间意识,而不是随机游走;
- 最终 Distance-to-Goal 全部低于 2.5 m 且在目标附近紧密聚集;平均速度 0.76 m/s 且方差低,运动稳定高效。
移动操作方面,自然语言指令由 GPT-4 解析为「航点-动作」序列,到达每个航点后执行预定义操作原语(抓取、放置、倾倒等)。三个展示任务:单航点(走到碎纸机旁的大理石桌,用抹布擦掉污渍)、物体转运(把饼干盒从白桌搬到厨房中岛,需要在操作动作之间导航)、多步复合(「做早餐」——依次导航到燕麦罐、可可球、牛奶瓶三个开放词汇目标并操作,把食材组装到盘子里)。最后这个任务最能说明问题:识别并与三个空间分散的开放词汇物体交互,结构化空间记忆在长程推理与可靠物体接地中起了关键作用。
4. 我的读法
这篇论文最值得欣赏的是它把「记忆」作为一等公民来设计,而不是当作一个缓存。地标 / 路线 / 概览三种知识各有明确的生物学对应、明确的数据结构、明确的更新规则——这种一一对应的干净程度在具身智能论文里并不多见。
几个我认为特别有迁移价值的点:
- Surprise-driven 更新是个很聪明的折中。它同时避开了「全存」和「聚合融合」两个极端:用邻域平均距离作为新颖性判据,保留多特征缓冲区而非单一向量,既维持了记忆多样性又控制了存储。这个思路对任何做长期空间记忆的系统都适用。
- Imagine-then-localize 把文生图模型用在了「检索」而非「生成」上——不是为了让图片好看,而是为了把抽象文本指令转成可与视觉记忆匹配的查询向量。这是一个很实用的跨模态检索技巧。
- 不贪心选最高置信度,而是用 $H_i = \lambda p_i + (1-\lambda)(1 - d_i/d_{\max})$ 复合打分——这个设计的价值在 SPL 的大幅领先上体现得很直接。在多候选场景下,纯置信度排序会让人反复折返。
- 地标融合的加权平均公式(按置信度加权坐标、均值置信度、取最高置信度的描述)是一个小而完整的工程细节,处理的是所有 SLAM/语义地图都会遇到的重复观测问题。
也必须看到边界:
- 系统是模块化的、零样本的,因此依赖多个现成大模型:YOLO-World 做检测、DINO-v2 做特征、GPT-4o 做描述与验证、SD 3.5 做想象、CLIP 做视角选择。推理成本与延迟在真机部署上不可忽略(论文未报告单步耗时)。
- A-EQA 上离人类还差 27.5%,作者自己承认这是持续的开放挑战。
- 地标类别集 $\mathcal{C}$ 是预定义的(sofa / sink / bed 等),开放词汇能力主要靠 YOLO-World 与认知地图分支兜底,并非完全无约束。
- 真机实验规模有限:75 个 episode、15 个目标、单一环境(200 m² 两层),且操作部分是预定义原语而非学习出来的策略——展示的是「导航 + 原语调用」的集成能力,不是操作泛化能力。
最后,论文提出的「空间认知的具身图灵测试」这个提法值得记住:它建议未来基准应当考察三个基础维度——(i) 实时构建可复用的空间表征;(ii) 从稀疏、部分观测中抽象与推理;(iii) 把高层目标转译为可执行的空间计划。这比单纯刷 SR / SPL 更能刻画「认知」二字。
5. 资源
- 论文:arXiv:2508.17198
- 代码:https://github.com/Heathcliff-saku/BSC-Nav
- 机构:清华大学(计算机科学与技术系、心理与认知科学系、BNRist、THBI、清华-博世联合 ML 中心)、北京航空航天大学人工智能学院
- 关键词:spatial navigation, spatial cognition, cognitive map, neuro-inspired learning, embodied intelligence