
PAPER DEEP DIVE
SGM-SLAM:面向数据高效分布式SLAM的场景图匹配
本文提出一个面向多机器人系统的数据高效分布式同步定位与建图框架,机器人配备激光雷达、相机和惯性传感器,可在无GPS且通信受限的环境中运行。每个机器人用融合的RGB-LiDAR点云构建包含关键帧层、物体层和语义点云层的场景图,并只向邻居交换物体ID、语义类别和质心等轻量数据。系统通过物体图匹配识别机器人间候选约束,估计相对位姿后进行稀疏物体点云ICP精化,最后将观测加入因子图优化。真实四足机器人数据覆盖室内外场景,实验同时验证了轨迹精度和通信效率。
一句话总结
SGM-SLAM 把多机器人 SLAM 的机器人间回环检测从高维描述子匹配改为“语义标签 + 物体质心”构成的轻量物体图匹配,先估计粗位姿,再用匹配物体的稀疏点云做 ICP 精化,因此能在低重叠、视角变化和无 GPS 条件下降低通信量并保持室内外建图精度。
研究背景与动机
多机器人 SLAM 的核心不只是让每台机器人各自跑通里程计。当队伍中的机器人从不同初始帧出发、没有共享 GPS、只能在有限带宽下通信时,系统必须判断不同局部地图中的观测是否对应同一环境,并把相对变换引入因子图。这个机器人间数据关联问题决定了合并后的地图是否可用:错一回环会撕裂地图或把位姿拉向错误解,漏掉关键回环则会让两段轨迹长期无法对齐。
传统特征级方法常用图像描述子或激光描述子寻找候选回环。视觉词袋对光照和视角变化敏感,激光 Scan Context 这类紧凑描述子在轨迹重叠很少时也容易失败。论文中给出的对比也体现了这一点:户外数据集的两条轨迹重叠很小,Swarm-SC 的绝对轨迹误差达到 20.29 米;室内环境光照较暗且手持设备与四足机器人视角高度不同,Swarm-CP 的误差升至 5.70 米。这些失败模式并不是实现细节问题,而是表示方法与任务条件之间的错配。
场景图为这个问题提供了另一种组织地图的方式。与只保存几何点的点云地图相比,场景图可以把关键帧、物体、语义点云和它们之间的关系放进同一结构中;对下游任务规划或人机交互来说,一个“桌子”“椅子”“房间”的层级也比原始点云更容易解释。Hydra、Kimera-Multi 和 Hydra-multi 等工作已经证明 3D 场景图可以服务于语义建图,但多数系统仍然依赖视觉描述子做机器人间匹配,或者采用集中式合并,低带宽链路下的地图更新会被推迟。
作者抓住的点很具体:机器人间匹配的第一步不必传输完整场景图,也不必比较高维描述子。若每个机器人已经能从 RGB-LiDAR 融合点云中提取稳定物体,那么物体的语义标签、质心和物体间的距离结构本身就带有足够的拓扑与几何信息。标签能抑制外观变化,物体间的边长在机器人局部坐标系内保持相对关系,因此可用于跨坐标系匹配;质心虽然不能直接相减,但一旦图匹配成功,就能反过来解出局部世界系之间的刚体变换。
这与“只用物体检测做回环”也不完全相同。单机器人物体回环通常可以用同一坐标系下的几何一致性直接过滤候选;多机器人场景没有这个前提。SGM-SLAM 因此把问题拆成两级:先用同标签和边长相似度做图匹配,找到足够的对应物体;再由对应质心估计粗位姿,最后用局部场景图中已有的稀疏物体点云注册精化。这个流程同时回应了鲁棒性、通信量和分布式执行三个约束。
问题形式化
设队伍包含 $n$ 台机器人 $\mathcal{R}=\{R_0,\dots,R_{n-1}\}$。机器人 $R_\alpha$ 的局部世界系 $\mathbf{W}_\alpha$ 对齐到它初始时刻的身体系 $\mathbf{B}_{\alpha_0}$。因此,机器人间关联可转化为估计
$$\mathcal{T}=\{\mathbf{T}_{\mathbf{W}_\alpha\rightarrow\mathbf{W}_\beta}\mid R_\beta\in\mathcal{R}\}.$$
这里的 $\mathbf{T}_{\mathbf{W}_\alpha\rightarrow\mathbf{W}_\beta}$ 表示把邻居 $\beta$ 的局部世界系变换到本机 $\alpha$ 的局部世界系。这个定义和集中式全局系不同:每台机器人仍然保留自己的轨迹与地图,机器人间只需要恢复相对变换,不要求先建立一个中心节点。
机器人在时刻 $t_i$ 的 6 自由度位姿记作 $\mathbf{x}_{\alpha_i}$,完整轨迹为 $\mathcal{X}_\alpha=\{\mathbf{x}_{\alpha_0},\dots,\mathbf{x}_{\alpha_i}\}$。观测分三类:顺序里程计 $\mathcal{Z}_\alpha^{\text{odom}}$、机器人内部回环 $\mathcal{Z}_\alpha^{\text{intra}}$、机器人间观测 $\mathcal{Z}_\alpha^{\text{inter}}$。论文选择一个有意保留的分布式约束:本机检测到的机器人间观测不广播给邻居,因此同一个观测只进入检测方的因子图。
局部后端随后求解最大后验问题:
$$\mathcal{X}_\alpha^{*},\mathcal{X}_{\text{assoc}}^{*}=\arg\max_{\mathcal{X}_\alpha,\mathcal{X}_{\text{assoc}}}P(\mathcal{X}_\alpha,\mathcal{X}_{\text{assoc}}\mid\mathcal{Z}_\alpha),$$
$$\mathcal{X}_{\text{assoc}}=\{\mathbf{x}_{\beta_j}:\mathbf{z}^{\text{inter}}_{\alpha_i,\beta_j}\in\mathcal{Z}^{\text{inter}}_\alpha\}.$$
其中 $\mathcal{X}_{\text{assoc}}$ 是与本机产生机器人间关联的邻居位姿集合。通俗地说,每台机器人在优化自己轨迹的同时,把已经确认相关的邻居关键帧位姿作为辅助变量一起约束,从而让本机地图与邻居观测保持一致。这个设计减少了需要同步的状态,但也意味着不同机器人对同一次相遇可能保留各自估计,后文会回到这个边界。
系统架构
图 3 给出的单机流水线由五条主线组成。前端用 Point-LIO 计算 LiDAR-惯性里程计,并用类似 LIO-SAM 的距离规则搜索机器人内部回环;语义融合模块把相机分割结果投到 LiDAR 点云上;场景图构建模块维护关键帧层、物体层和语义点云层;通信模块持续交换轻量物体数据;匹配与注册模块在发现足够对应物体后生成机器人间回环,最后统一交给因子图更新。
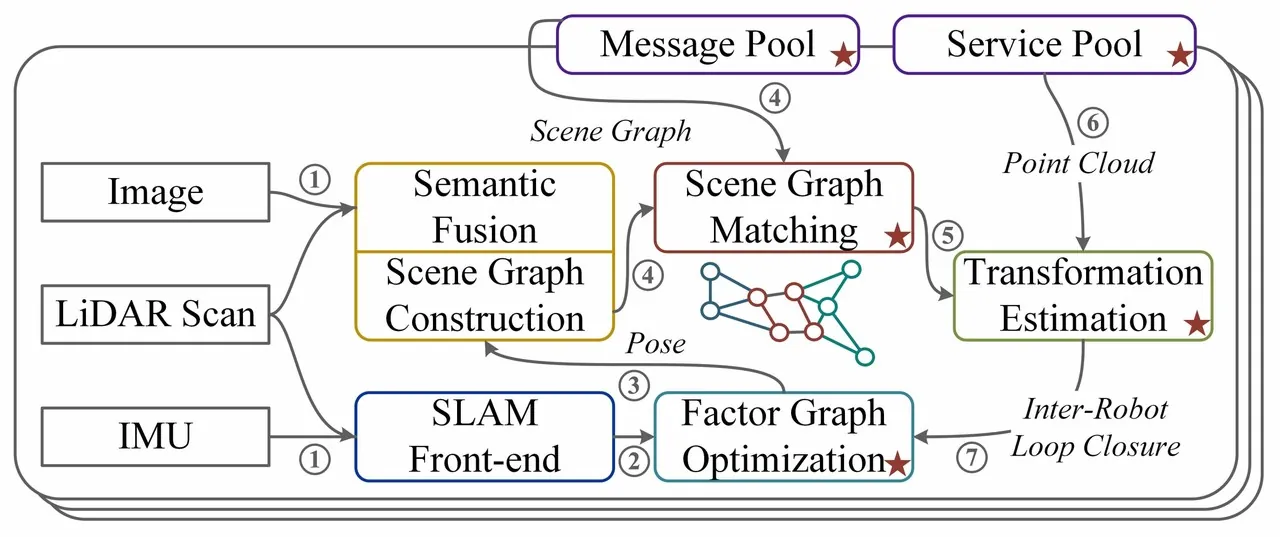
图 1:论文 Fig. 3 的系统架构。星号标出跨机器人交互部分;单机内部同时维护状态估计、语义融合、场景图与局部优化。
这个架构的关键顺序是“先建图,再匹配,后传输重数据”。RGB-LiDAR 语义融合先在本机完成,机器人间只共享物体摘要;只有当图匹配足够可靠时,才请求稀疏物体点云和相关关键帧。因此通信策略不是简单压缩所有数据,而是把“是否可能相遇”的判断放在最便宜的表示上。
flowchart TB
    A[LiDAR + IMU + RGB] --> B[Point-LIO odometry]
    A --> C[Oneformer image segmentation]
    B --> D[Keyframe layer]
    C --> E[Project points by intrinsics and extrinsics]
    E --> F[Semantic point layer]
    F --> G[Cluster bounded objects]
    D --> H[Object layer]
    G --> H
    H -->|IDs, labels, centroids| I[Neighbor object graph]
    H --> J[Local object graph]
    I --> K[Scene graph matching]
    J --> K
    K -->|enough matches| L[Coarse rigid transformation]
    L --> M[ICP on sparse matched object clouds]
    M --> N[Inter-robot factors]
    B --> O[Local pose graph optimization]
    D --> O
    N --> O
    O -->|pose updates| H
图 2:SGM-SLAM 的实际数据流。轻量物体消息先穿过匹配门,点云和关键帧只有在匹配成功后才被请求。
场景图构建:从像素标签到物体层
场景图分为三层。关键帧层由 SLAM 前端选择的关键帧组成,边包括顺序里程计、机器人内部回环和机器人间观测。物体层是一张全连接无向图,顶点是物体,边权是物体质心间的欧氏距离。语义层保存带类别标签的点云,并与采集它的关键帧相连。跨层边把关键帧和它观测到的物体连接起来,使位姿修正可以传播到物体位置。
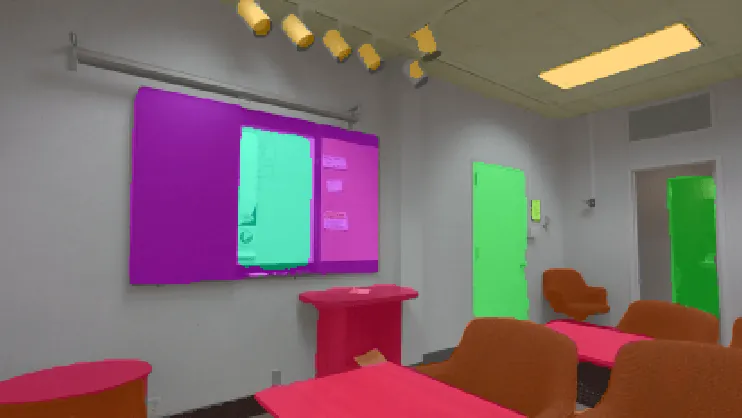
图 3:论文 Fig. 4 展示语义融合过程。左上为 Oneformer 分割结果,右上为 LiDAR 点投影,底部是关键帧与物体层的连接关系。
构建物体层时,RGB 图像先由 Oneformer 分割。论文明确选择只在图像上分割,而不是对三维点逐点预测,以保证语义标签的一致性。LiDAR 扫描点随后通过 LiDAR-相机外参和相机内参投影到 RGB 图像平面,取最近像素的类别赋给该点。带标签点云再聚类成离散有界物体。这样做的优点是语义标签由 2D 分割模型稳定生成,几何范围由 LiDAR 决定,避免了两套模态各自预测导致的冲突。
跨关键帧维护同一物体被写成一个线性指派问题。设当前关键帧的物体候选集为 $\mathcal{V}_\alpha^{(t)}$,上一关键帧为 $\mathcal{V}_\alpha^{(t-1)}$,代价矩阵 $C$ 的元素是两组质心之间的欧氏距离:
$$A_n^{*}=\arg\min_{A_n}\sum C\odot A_n,$$
$$A_n^{*}=\arg\min_{A_n}\sum_{v_i\in\mathcal{V}_\alpha^{(t)}}\sum_{v_j\in\mathcal{V}_\alpha^{(t-1)}}c_{ij}\cdot a_{ij},$$
$$\text{s.t.}\quad \forall v_j\in\mathcal{V}_\alpha^{(t-1)},\sum_{v_i\in\mathcal{V}_\alpha^{(t)}}a_{ij}\leq 1,\quad \forall v_i\in\mathcal{V}_\alpha^{(t)},\sum_{v_j\in\mathcal{V}_\alpha^{(t-1)}}a_{ij}\leq 1.$$
$A_n$ 是布尔指派矩阵,$a_{ij}=1$ 表示把当前物体 $v_i$ 和历史物体 $v_j$ 关联为同一物体;$c_{ij}=\lVert p_i-p_j\rVert_2$ 是质心距离。约束允许某一行或某一列全为 0,因此新出现的物体可以进入地图,消失的物体也不会被强行配给错误候选。只有当 $a_{ij}=1$ 且 $c_{ij}<c_{\max}$ 时才接受匹配,论文用匈牙利算法求解这个指派。
这一步看似常规,却是机器人间匹配可靠性的基础。如果局部物体轨迹断裂或错绑,同一个真实桌椅会被拆成多个顶点,后续边长结构就会失真。场景图的层级还提供了一条更新通道:当机器人内部回环调整关键帧位姿后,每个物体按最近观测它的关键帧顺序更新位置。换言之,物体层不是一次性的检测结果,而是随位姿图一起维护的语义几何索引。
机器人间场景图匹配
机器人间匹配不能直接比较质心坐标,因为 $\mathcal{G}_\alpha$ 和 $\mathcal{G}_\beta$ 定义在不同局部世界系中。SGM-SLAM 把每个机器人选择出的物体表示为 $\phi(v_i)=(p_i,l_i)$,其中 $p_i$ 是质心,$l_i$ 是语义标签;边权取 $w_{ij}=\lVert p_i-p_j\rVert_2$。由于大物体的部分观测会让质心随视角漂移,作者只把特定类别送入匹配,而不是把所有分割结果都当作回环证据。
问题写成二次指派。局部图 $\mathcal{G}_\alpha=\langle\mathcal{V}_\alpha,\mathcal{E}_\alpha\rangle$ 与邻居图 $\mathcal{G}_\beta=\langle\mathcal{V}_\beta,\mathcal{E}_\beta\rangle$ 的匹配矩阵为 $A_e$:
$$A_e^{*}=\arg\max_{A_e}\sum A_e\odot U\odot A_e,$$
$$A_e^{*}=\arg\max_{A_e}\sum_{v_i,v_j\in\mathcal{V}_\alpha}\sum_{v_m,v_n\in\mathcal{V}_\beta}a_{im}\cdot u_{ijmn}\cdot a_{jn},$$
$$\text{s.t.}\quad \forall v_i\in\mathcal{V}_\alpha,\sum_{v_m\in\mathcal{V}_\beta}a_{im}\leq 1,\quad \forall v_m\in\mathcal{V}_\beta,\sum_{v_i\in\mathcal{V}_\alpha}a_{im}\leq 1.$$
这里的 $a_{im}\in\{0,1\}$ 表示局部顶点 $v_i$ 与邻居顶点 $v_m$ 是否匹配。与线性指派不同,收益不再只看单点属性,而是看两条边是否同时成立。四维效用张量定义为
$$u_{ijmn}=d_v(v_i,v_m)\cdot d_v(v_j,v_n)\cdot d_e(e_{ij},e_{mn}),$$
$$d_e(e_{ij},e_{mn})=\exp(-\mu\lvert w_{ij}-w_{mn}\rvert).$$
顶点比较 $d_v$ 在本文中只比较语义标签:同标签为 1,否则为 0。边比较 $d_e$ 用指数核惩罚两条边长度的差异,$\mu$ 控制几何一致性有多严格。若任一端标签不同,乘积立即为 0;若标签相同但边长差距很大,收益也会迅速衰减。这就是“只用标签和质心”的含义:没有图像描述子、没有颜色直方图、没有外观特征,匹配证据来自离散类别和物体间的相对距离结构。
作者把 $A_e$ 向量化为 $\text{vec}(A_e)$,把 $U$ 重排成二维矩阵 $U_{\text{2D}}$:
$$A_e^{*}=\arg\max_{A_e}\text{vec}(A_e)^\top\cdot U_{\text{2D}}\cdot\text{vec}(A_e).$$
为了可解,布尔约束被松弛为 $a_{ij}\in[0,1]$。按 Leordeanu 等人的谱匹配结论,$A_e^{*}$ 取 $U_{\text{2D}}$ 最大正特征值对应的正特征向量。随后再把特征向量作为代价 $C=-A_e^{*}$ 输入一次线性指派,得到离散物体对应;论文还设置最小特征分量阈值,避免弱响应用户被强行配对。这个流程牺牲了严格 0/1 组合最优性,换来低带宽场景下可以在线执行的近似解。
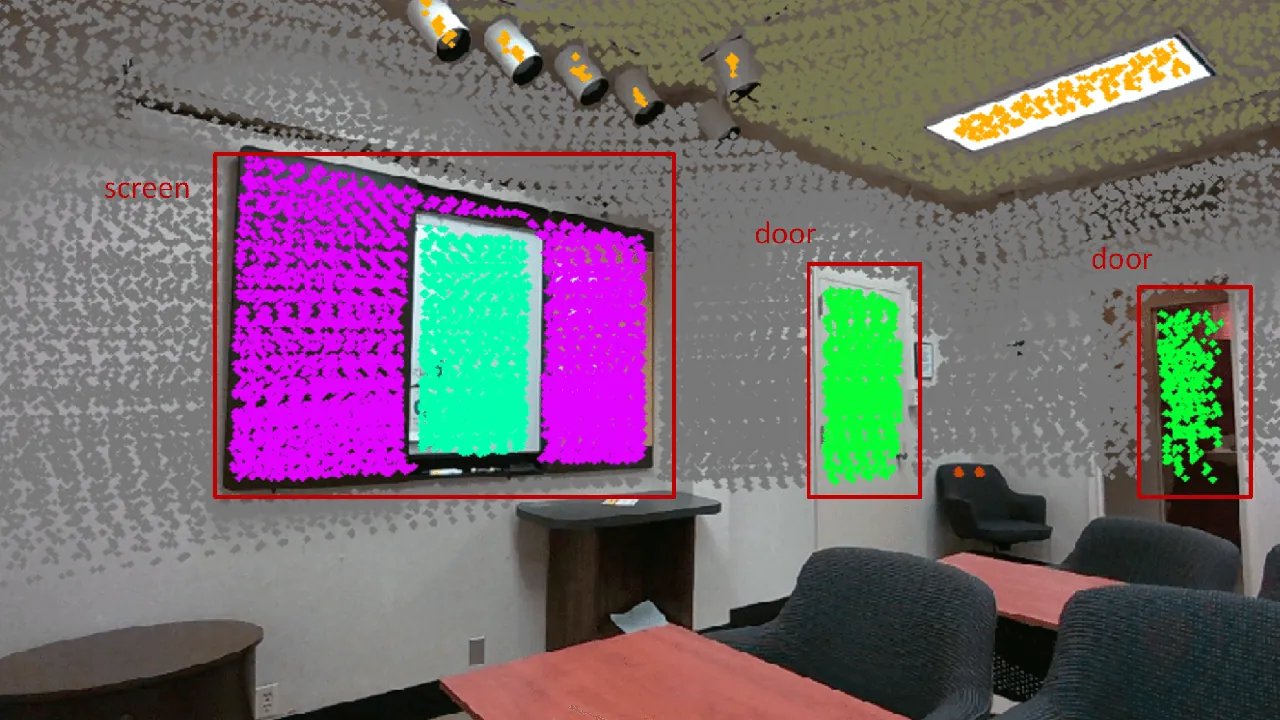
图 4:论文 Fig. 5 的边匹配示例。节点颜色表示类别,边长表示权值;只有端点标签一致且边长接近的对应会获得高效用。
这种表示的选择有一个直接的物理理由。相机描述子依赖观测时的像素外观,而物体间距离在刚体变换下保持不变;语义标签也只要求分类器在两个视角下给出一致类别,不要求纹理或投影方向相同。因此它天然适合手持设备与四足机器人视角高度不同、树木遮挡、光照变化和轨迹重叠低的场景。代价是退化场景:当环境中重复出现大量同类别且间距相似的物体时,单靠这些信息可能产生歧义,必须依靠最小匹配数和后续点云注册兜底。
从物体对应到位姿初值
令 $\mathcal{A}_{\alpha,\beta}$ 表示图匹配得到的物体对集合。对每一对匹配物体,局部质心 $p_\alpha$ 与邻居质心 $p_\beta$ 满足
$$\begin{bmatrix}p_\alpha\\1\end{bmatrix}=\mathbf{T}_{\mathbf{W}_\alpha\rightarrow\mathbf{W}_\beta}\begin{bmatrix}p_\beta\\1\end{bmatrix}.$$
只要有 3 个以上非共线物体,就可以解出刚体变换。作者为了避免里程计倾斜漂移导致物体质心高度不一致,进一步假设物体位于同一平面,把问题压缩成 2D 刚体变换估计。这是一个很实用的先验:室内桌椅和户外长椅大多落在地面附近,先估计平面内的旋转与平移,比直接拟合完整 6 自由度更稳。
这个初值不是最终回环。质心受分割边界、遮挡范围和视角影响,可能偏差数十厘米;2D 假设也会损失坡道、楼梯和竖直结构中的信息。因此系统把它当作 ICP 的初始猜测。匹配物体对各自关联一组关键帧 $\mathcal{F}_v=\{F(i)\}$,本机目标云是
$$M_{v_\alpha}=\bigcup_i F_{v_\alpha}(i).$$
邻居侧采用滑动窗口。对邻居物体 $v_\beta$ 的每个相关关键帧 $F_{v_\beta}(j)$,源云取
$$M_{v_\beta}=\bigcup_{k=-5}^{5}F_{v_\beta}(j+k),$$
先用 $\mathbf{T}_{\mathbf{W}_\alpha\rightarrow\mathbf{W}_\beta}$ 变换到本机坐标系,再与目标云做 ICP。得到的机器人间回环因子进入局部因子图。为了控制计算量,每个邻居关键帧只与本机一个关键帧注册。这种“图匹配给初值、稀疏物体云给精化、因子图给全局一致性”的分层设计,避免了把所有原始点云丢进暴力注册。
通信协议:三段式按需交换
SGM-SLAM 的通信不是一次性同步场景图。第一段持续发送最便宜的数据:物体 ID、类别和质心。只有在场景图发生显著更新时才发布,例如新增物体或大漂移被修正,因此频率低于 LiDAR 原始扫描。第二段在本地发现足够匹配后,向邻居请求匹配物体的稀疏点云和关键帧 ID。第三段请求仍未存储的关键帧,接收压缩点云、优化后的机器人状态和边缘化协方差。
点云只保留几何信息,不传输强度和颜色,并使用 Point Cloud Library 压缩。这一步牺牲了跨机器人重建彩色地图的能力,换取定位和合并所需的必要信息。协议还用“请求方确认此前未收到”避免重复发送关键帧。作者在真实实验中观察到另一个工程问题:图匹配成功后会触发一阵相似请求,较早请求被丢弃,因此请求次数明显高于响应次数;他们提出后续可用延迟请求策略缓解。这也提醒读者,通信瓶颈不只是平均字节数,还有匹配成功后的突发模式。
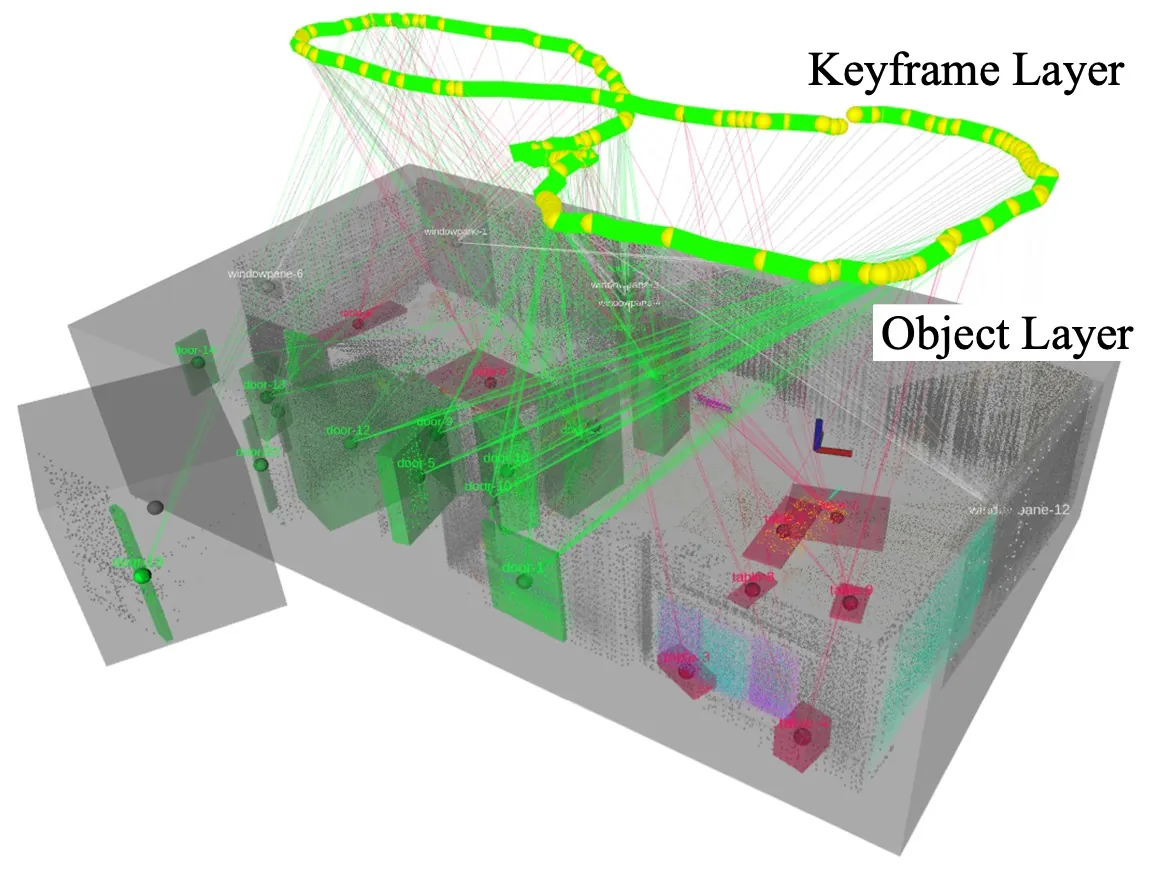
图 5:论文 Fig. 6 的采集平台。四足机器人顶部挂载与手持设备相同的感知套件,包含 Livox mid-360、惯性传感器和 RealSense RGB 相机。
实验设计与合成图匹配
论文先在合成环境中单独压力测试图匹配与变换估计:场景为 $60\text{ m}\times 60\text{ m}$,包含 50 个物体、6 个类别,物体位姿与尺寸随机生成。每组重复 20 次,并给两张图施加随机初始变换。变换估计成功的判据是平移误差 $e_t<2\text{ m}$,且每个轴的旋转误差 $e_r<20^\circ$。误差实验中,物体位置加入 $x,y$ 轴 $\pm1\text{ m}$、$z$ 轴 $\pm0.5\text{ m}$ 的均匀扰动;姿态加入 roll/pitch $\pm2.5^\circ$ 和 yaw $\pm10^\circ$。
第一个表回答“需要多少重叠物体”。当两张物体图分别有 8、15、35 个物体而重叠数只有 4、7、17 时,无位置误差时三次全部 100% 成功。加入位置误差后,4 物体重叠的成功率降到 65%;重叠提升到 7 和 17 后又回到 100%。召回率均保持 100%,说明匹配模块在几何扰动下仍能找回真实对应,失败主要发生在质心扰动过大的极小重叠场景。运行时间从 7 ms 增至 226 ms,图规模扩大后仍满足实时门槛。
| 图 1 物体数 | 图 2 物体数 | 重叠物体数 | 成功率(无误差) | 成功率(有误差) | 召回率(无/有误差) | 时间 |
|---|---|---|---|---|---|---|
| 8 | 8 | 4 | 100% | 65% | 100% / 100% | 7 ms |
| 15 | 15 | 7 | 100% | 100% | 100% / 100% | 14 ms |
| 35 | 32 | 17 | 100% | 100% | 100% / 100% | 226 ms |
表 1:论文 Table 1 的合成图尺寸与重叠度实验,语义标签无错误。
第二个表单独引入语义错标。两张图保持 35 和 32 个物体、重叠 17 个。错标 3 个或 6 个时,成功率仍为 100%;错标 9 个时降到 95%;错标 12 个时,无位置误差为 55%,位置与姿态误差同时存在时只有 30%。召回率也从 82% 逐渐降到 27%。这说明边长结构可以吸收少量语义噪声,但错误标签会直接删掉高效用边;当错误数量接近重叠物体的七成时,鲁棒性迅速消失。
| 错标物体数 | 成功率(无位置误差) | 成功率(有位置误差) | 召回率(无/有误差) | 时间 |
|---|---|---|---|---|
| 3 | 100% | 100% | 82% / 82% | 209 ms |
| 6 | 100% | 100% | 63% / 59% | 188 ms |
| 9 | 95% | 95% | 46% / 46% | 183 ms |
| 12 | 55% | 30% | 29% / 27% | 178 ms |
表 2:论文 Table 2 的语义错标压力测试。基础图为 35 与 32 个物体,重叠 17 个。
论文 Fig. 7 给出一个能解释这种鲁棒性的案例:一张桌子被误分为沙发,但由于其他物体对仍然提供一致的边长约束,变换估计仍然成功。图匹配不是要求每个节点正确,而是寻找整体效用最高的对应结构。不过合成实验也标出了边界:它假设物体图已经可用,没有模拟分割漏检、聚类合并、动态行人或传感器时间同步错误,因此不能等同于完整真实系统的成功率。
真实数据集与轨迹精度
真实实验使用手持设备和 Unitree Go2 EDU 四足机器人。两者均搭载 Livox mid-360 LiDAR、惯性传感器和 Intel RealSense 深度相机,但论文只用其中的 RGB 图像;四足机器人本体传感器未参与,感知套件统一挂在机器人顶部。作者专门采集数据的原因是既有数据集常用 Velodyne VLP-16,其稀疏分层点云与本算法依赖的聚类式物体检测不匹配,而 Livox 点云更稠密。系统运行在 Ubuntu 20.04 与 ROS 2 Foxy,GPU 只用于图像分割。
户外数据集包含 2 台机器人和较大范围轨迹,物体重叠少、人工结构稀疏并有树木遮挡;室内数据集包含 3 台机器人,范围较小,但桌椅和书架等重复物体密集且光照暗。由于设备限制,两个场景都没有 GPS。作者用 COLMAP 的 SfM 结果作为真值,只在特征丰富区域重建,以保证跨机器人相对位姿可靠。对比方法是 ROS 2 分布式 Swarm-SLAM:Swarm-SC 使用 Scan Context 激光描述子,Swarm-CP 使用 CosPlace 图像描述子。
| 环境 | Swarm-SC ATE RMSE | Swarm-CP ATE RMSE | SGM-SLAM ATE RMSE |
|---|---|---|---|
| 户外 | 20.29 m | 3.92 m | 1.32 m |
| 室内 | 3.36 m | 5.70 m | 0.81 m |
表 3:论文 Table 3 的绝对轨迹误差。评测时多机器人轨迹按 EVO 的单机接口合并成整体轨迹。
数字背后的机制比排名更重要。户外 Swarm-SC 达到 20.29 米,对应两条轨迹重叠很小、Scan Context 缺少足够相似扫描的情形。室内 Swarm-CP 达到 5.70 米,对应暗光和手持设备与机器人高度差导致图像描述子不稳定的情形。SGM-SLAM 分别得到 1.32 米和 0.81 米,说明同一套物体图表示可以在两种失败模式间切换:户外靠少而稳定的物体对应,室内靠重复但可辨识的物体空间结构。
这项结果还应与真值方式一起读。COLMAP 全局优化有利于跨图像配准,但作者只重建特征丰富区域,因此 ATE 只覆盖这些区域;SfM 本身在弱纹理、动态物体或尺度不可观时也不是绝对无误的外部真值。即使如此,对比条件对三个方法一致,而失败诱因恰好是本方法声称要处理的低重叠、视角变化和暗光,所以结论仍然有针对性。
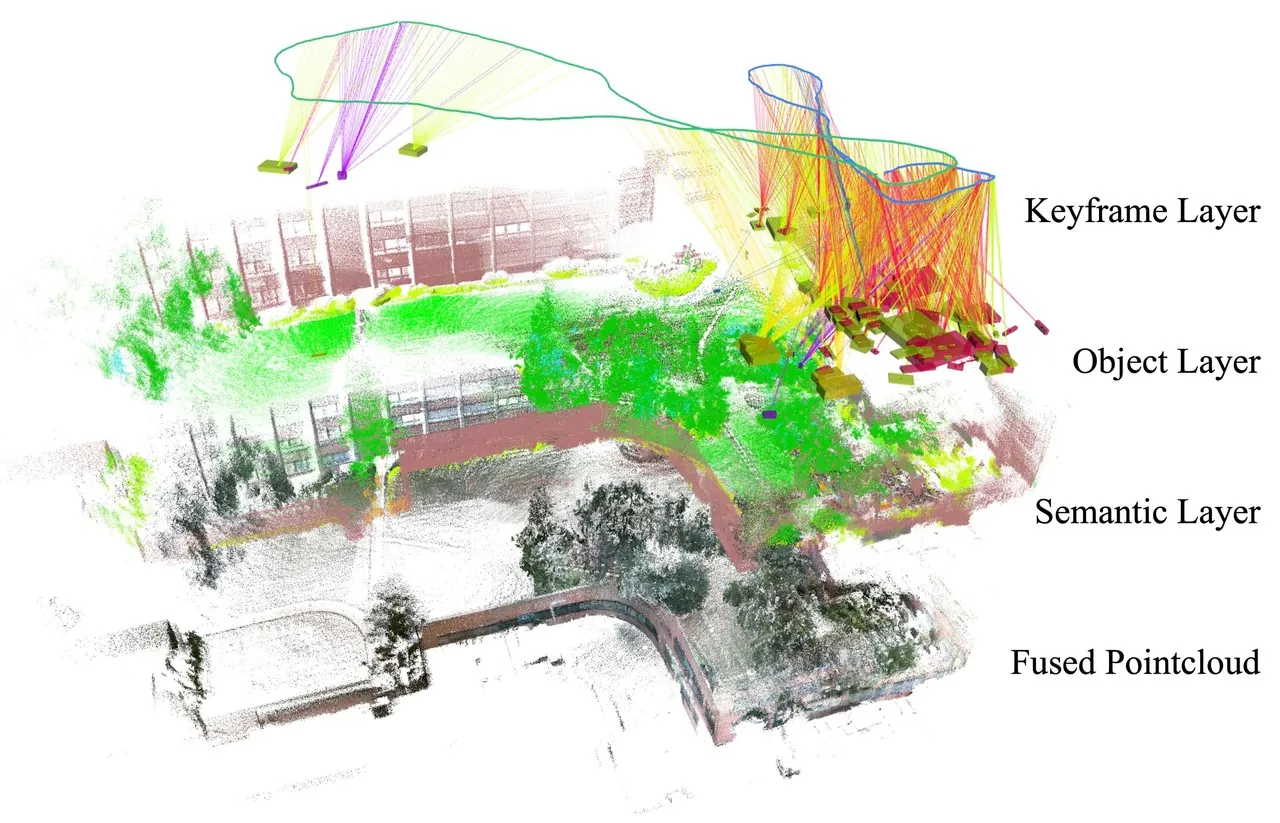
图 6:论文 Fig. 1 的户外两机器人结果。蓝色与绿色轨迹构成关键帧层,彩色包围盒为物体层,语义分割点云构成语义层。
通信量分析
论文用模拟无线通信统计真实数据集中的感知消息。作为对照的“Point-cloud Raw”表示集中式暴力策略,把所有原始点云发给中心节点。户外该基线平均每条消息 508.2 KB、最多 516.9 KB,共 3073 条;室内平均 508.1 KB、共 3079 条。相比之下,户外物体数据平均 7.76 KB、共 701 条;室内物体数据平均 18.40 KB、共 845 条。仅物体数据一项,户外约 5.4 MB、室内约 15.5 MB,而原始点云基线都在约 1.56 GB 量级。
| 消息类型 | 环境 | 平均值 | 最大值 | 消息数量 |
|---|---|---|---|---|
| 原始点云 | 户外 | 508.2 KB | 516.9 KB | 3073 |
| 原始点云 | 室内 | 508.1 KB | 512.1 KB | 3079 |
| 物体数据 | 户外 | 7.76 KB | 16.93 KB | 701 |
| 物体数据 | 室内 | 18.40 KB | 44.37 KB | 845 |
| 关键帧请求 | 户外 | 0.02 KB | 0.02 KB | 61 |
| 关键帧请求 | 室内 | 0.02 KB | 0.02 KB | 411 |
| 关键帧响应 | 户外 | 18.87 KB | 22.95 KB | 10 |
| 关键帧响应 | 室内 | 6.90 KB | 11.05 KB | 72 |
表 4:论文 Table 4 的感知消息统计。压缩点云只包含几何信息,不包含颜色和强度。
请求/响应的不对称很关键。户外只响应 10 次关键帧,室内响应 72 次,但请求分别有 61 次和 411 次。作者解释为图匹配成功后产生突发重复请求,旧请求被丢弃。这说明轻量候选匹配阶段和重数据获取阶段应使用不同的调度策略;后者在真实无线链路上可能需要去抖、合并、优先级或延迟确认。如果没有这一层,按需点云传输的优势会被突发请求抵消。
局限性分析
第一处作者自述限制是数据采集方式。由于设备限制,两条序列分别录制为 ROS 2 bag 后离线同时回放,而不是多机器人同时在线采集;GPS 不可用,真值只能取自 COLMAP SfM,并且只重建特征丰富区域。这使实验能检验跨机器人相对位姿,但没有直接证明系统在真实在线网络延迟、丢包和多机时间同步误差下的稳定性。
第二处作者自述限制是通信调度的突发问题。真实实验中关键帧请求远多于响应,原因是图匹配成功后系统发出一批相似请求,较早请求被丢弃。作者明确指出需要延迟请求策略。这属于协议层而非算法精度的失败模式:候选匹配越成功,瞬时通信压力反而可能越大。
第三处是方法性边界。机器人间图匹配只比较语义标签和边长,主要为了避免大物体质心随视角变化;但这也会在重复结构中引入歧义。合成 Table 2 已经显示,错标 12 个时成功率从 55% 掉到 30%。真实环境中动态行人、分割漏检、物体合并和天气变化都可能改变物体层,论文没有专门消融这些因素。
第四处是变换估计的 2D 平面假设。作者用它抑制里程计倾斜漂移并提高鲁棒性,适合桌椅和长椅接近地面的场景,但在多层结构、坡道、楼梯或高程变化明显的户外地形中,质心高度包含关键信息;压缩成平面内变换可能丢掉这部分约束。后续点云 ICP 可以纠正一部分误差,但初值退化时仍有失败风险。
第五处是分布式一致性边界。本机不把机器人间观测广播给邻居,每台机器人只在本地因子图中优化与自己相关的邻居位姿。这减少了状态同步和重复因子,但也意味着不同机器人对同一相遇可能保留不同估计。论文没有分析多次相遇下的估计一致性、协方差传播或冲突回环处理。
工程启示
对机器人团队系统设计者来说,SGM-SLAM 的价值不只是 ATE 更低。它展示了低带宽多机器人系统中的一个通用模式:先用小而稳定的语义摘要判断“可能在哪里相遇”,再用几何数据确认“如何对齐”,最后只拉取需要的地图块。这个顺序可直接迁移到异构机器人、巡检队伍或救援场景,特别是在 4G/5G 覆盖不稳定或队内无线电带宽有限时。
它也说明场景图不应只被看作人机交互输出。当图节点带有足够的几何关系时,场景图可以直接参与定位。LLM 或任务规划器后续查询“会议室有几把椅子”“长椅在哪个区域”时,机器人已经用同一结构完成了定位与语义索引。论文最后也把 LLM 运动规划列为未来方向,但当前实验仍聚焦状态估计与地图合并,未评估开放词汇物体、动态场景或语言任务。
复现时应注意四个实验细节:语义分割由 Oneformer 完成;里程计由 Point-LIO 提供;机器人内部回环采用类似 LIO-SAM 的距离规则;点云用 PCL 压缩且不传颜色强度。系统运行于 ROS 2 Foxy 和 Ubuntu 20.04,GPU 只服务图像分割。论文未提供公开代码,也没有列出待发布仓库,因此真实工程落地还需要自行实现通信状态机、物体生命周期管理和请求去重。
总结
SGM-SLAM 的核心贡献是把分布式 SLAM 的机器人间关联表示压缩到语义类别与物体质心结构,并用分级流程把轻量候选匹配、粗位姿估计和稀疏点云注册串联起来。合成实验标定了重叠数量与语义噪声的影响;真实实验在户外 2 机和室内 3 机数据中分别取得 1.32 米与 0.81 米 ATE RMSE,优于所选 Swarm-SLAM 描述子配置。通信表进一步显示,仅物体数据就从约 1.56 GB 的原始点云基线降到数 MB 到十余 MB 量级,尽管关键帧请求调度仍有待优化。
这项工作的适用边界同样清楚:它假设物体分割能提供稳定类别,物体大多接近可平面化的地面结构,且图匹配后的突发点云请求可被无线链路承受。未来值得补上的不是另一个更大的描述子,而是开放词汇物体稳定性、高程感知变换估计、多次相遇下的分布式一致性,以及真实网络中的请求调度。