PAPER DEEP DIVE
迈向人类级灵巧遥操作:手-物共跟踪控制器 TeleDexter
人手能在单手内连续完成平移、重定向与指步等接触转换,而现有灵巧遥操作要么只做运动学重定向、忽略接触力与物体惯性,要么依赖生成式动作先验、在闭环中累积漂移。TeleDexter 把灵巧遥操作形式化为手-物共跟踪:操作者指定指尖位置与物体位姿的同步子目标序列,单阶段强化学习控制器在仿真接触中学会如何实现它们;混合奖励耦合稀疏子目标到达与稠密跟踪,几何感知两阶段重定向从动捕人手-物数据构造物理可行参考运动,随机动作掩码与域随机化支撑零样本 sim-to-real。在 Franka FR3 加 SharpaWave/LeapHand 两只灵巧手的七项重定向与长时程工具任务上,TeleDexter 平均成功率 75.2%、任务进度 87.1%,基线近乎全灭;每任务 50 条演示即可行为克隆出 46.7%-73.3% 成功率的自主策略。
论文元信息
标题:Towards Human-level Dexterous Teleoperation(迈向人类级灵巧遥操作,TeleDexter)
作者:Puhao Li(清华大学、北京通用人工智能研究院 BIGAI)、Zeyuan Chen(BIGAI、北京大学,共同一作与通讯作者)、Yingying Wu(清华大学、BIGAI)、Pengkun Wei(BIGAI)、Yuyang Li(BIGAI、北京大学,共同一作与通讯作者)、Tianyu Wang(BIGAI、北京大学,共同一作与通讯作者)、Jiaxiao Shi(BIGAI)、Mingrui Yu(清华大学)、Baoxiong Jia(BIGAI)、Song-Chun Zhu(清华、BIGAI、北大)、Tengyu Liu(BIGAI)、Siyuan Huang(BIGAI)
链接:arXiv:2607.11481(https://arxiv.org/abs/2607.11481 ,v1,2026 年 7 月 13 日,主分类 cs.RO);项目博客 https://bigai-dex.github.io/blog/teledexter
代码与数据状态:部分开源。仓库 https://github.com/ice4133/TeleDexter 提供两阶段重定向链路——scripts/run_kinematic_retargeting.py 做第一阶段向量对齐重定向,scripts/run_interaction_retargeting.py 在第一次结果上做网格感知精修,两阶段以 kinematic_motion.h5 解耦,第二阶段输出 interaction_motion.h5,内含腕坐标系下五指指尖目标与物体 6D 位姿,即 RL 训练所需的共跟踪目标;仓库默认面向 WUJI Hand 2 Beta 2 右手。单阶段 RL 控制器本体与训练代码未随仓库发布。
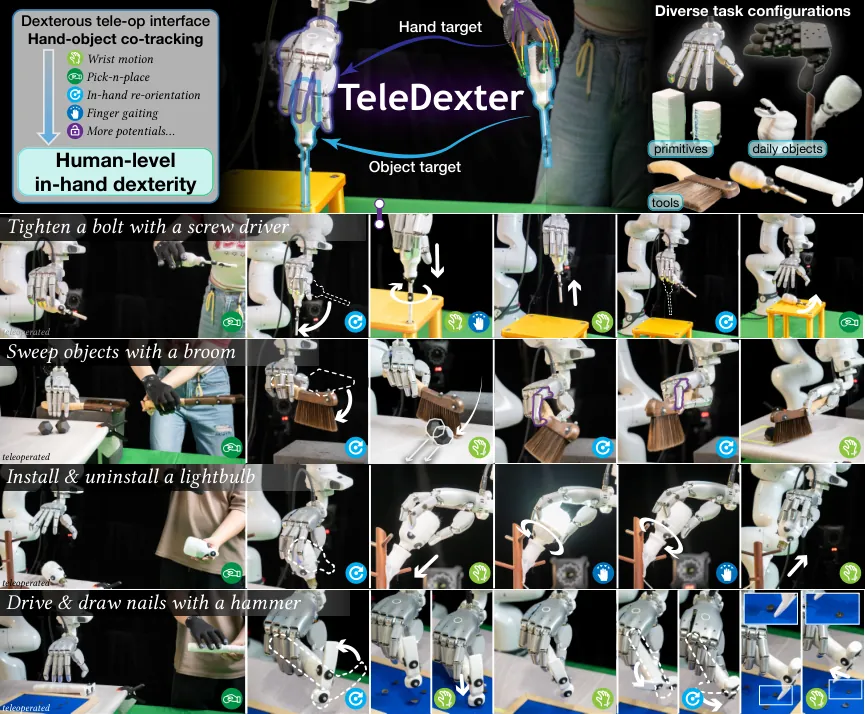
图1:TeleDexter 在单阶段框架内学习多种灵巧手内操作技能(论文 Figure 1)。左上为遥操作接口与手目标/物目标示意,左下为拧螺丝刀、扫刷、装拆灯泡、锤钉四个长时程工具任务序列,右侧为多样物体与工具配置。
一句话总结
TeleDexter 把灵巧遥操作从「映射人手关节」改写为「手-物共跟踪」:操作者只指定指尖位置与物体位姿的同步子目标序列,单阶段强化学习控制器负责在真实接触物理中把它们实现出来;配合随机动作掩码与域随机化零样本上真机,在七项手内重定向与长时程工具任务上取得 75.2% 平均成功率与 87.1% 平均任务进度,而所有基线近乎全部失败,采集的演示还能直接行为克隆出自主策略。
研究背景与动机
人类操纵物体的日常能力包含三类连续协调的接触转换:手内平移、手内重定向与指步(finger gaiting)。把这些能力交给机器人灵巧手的最直接路径是遥操作——操作者在回路中直接示范。但现有灵巧遥操作系统距离人类级手内灵巧仍有明显差距,论文把差距归因于两条主流路线各自的结构性缺陷。
第一条路线是运动学重定向:用视觉跟踪或外骨骼手套捕捉人手姿态,再把它映射到机器人关节拓扑。这条路线接口直观、延迟低、能忠实记录操作者的运动学意图,但它完全忽略手-物接触力与物体惯性。于是高加速度动作、非抓握式交互与连续指步极不稳定,物体滑脱与掉落是常态失败模式。第二条路线以 DexGen 为代表:在仿真中学一个灵巧动作先验,把粗粒度遥操作命令映射到接触丰富的手动作。它改善了局部接触鲁棒性,但训练目标来自合成生成的抓取转换,物理可行性没有保证;把动作先验编码进生成模型又会在闭环执行中引入级联轨迹漂移与协变量偏移,长时程部署时真机性能严重退化。
论文的切入点是重新划分「谁负责什么」:操作者负责指定「手和物体应该达到什么状态」,即指尖位置目标与物体位姿目标的同步序列;学习到的低层控制器负责「怎么达到」,即在仿真接触中训练出的多接触动力学执行策略。这一划分把遥操作形式化为手-物共跟踪问题(hand-object co-tracking),并用三个技术设计支撑它:连续子目标共跟踪、几何感知重定向构造参考运动、以及以随机动作掩码为核心的零样本 sim-to-real 鲁棒性。
与逐帧轨迹模仿相比,连续子目标共跟踪的关键区别在于给策略留下接触策略的搜索空间:策略必须按顺序到达每个手-物子目标,但子目标之间的接触转换方式由它自己在仿真推演中发现。论文认为,此前基于参考运动的灵巧操作学习之所以难以覆盖重定向与指步这类动态技能,正是因为逐帧稠密跟踪的表述过于刚性,把单阶段策略学习锁死在基本抓握与腕部运动的范围内。
预备知识
全部量在腕坐标系 $\mathcal{F}_{\mathrm{wrist}}$ 中表达,机械臂通过逆运动学独立跟踪人手腕部位姿。给定一组手-物参考运动,目标是学习共跟踪策略 $\boldsymbol{a}_{t}=\pi_{\theta}(\boldsymbol{o}_{t},\,g_{t})$:观测 $\boldsymbol{o}_{t}$ 编码当前手-物状态,动作 $\boldsymbol{a}_{t}\in\mathbb{R}^{n_{\mathrm{dof}}}$ 为目标关节位置,共跟踪目标同时指定指尖位置与物体位姿:
$$g_{t}=\bigl(\hat{\boldsymbol{p}}^{\mathrm{tip}}_{t},\;\hat{T}^{o}_{t}\bigr),\quad \hat{\boldsymbol{p}}^{\mathrm{tip}}_{t}\in\mathbb{R}^{N_{f}\times 3},\quad \hat{T}^{o}_{t}=\bigl(\hat{\boldsymbol{x}}^{o}_{t},\,\hat{R}^{o}_{t}\bigr)\in SE(3)$$遥操作时 $g_{t}$ 由实时捕捉的手-物位姿构造,因此「灵巧遥操作」与「共跟踪」在形式上完全同构。观测 $\boldsymbol{o}_{t}$ 由当前手关节位置 $\boldsymbol{q}_{t}$、物体位姿 $(\boldsymbol{x}^{o}_{t},R^{o}_{t})$、腕系重力方向与上一动作 $\boldsymbol{a}_{t-1}$ 组成;SharpaWave 共 142 维、LeapHand 共 112 维。两个设计值得强调:其余量全部在腕系中表达,重力方向是策略唯一的世界系锚点,告诉它腕部的绝对朝向;关节速度与接触力被刻意排除,因为它们在硬件上噪声大或不可得,策略可以从运动学状态、上一动作与重力线索中隐式恢复。
评测协议上,每个任务每方法 15 次试验,任务被分解为若干明确阶段(图3)。成功率 SR 为完成全部阶段的试验占比;任务进度 TP 为每次试验完成阶段占比的平均,各阶段等权。出现不可恢复的抓握丢失或物体掉落即终止该次试验。这一协议让「失败发生在哪一阶段」成为可读信息,而不只是一个二分结果。
方法详解
3.1 连续子目标共跟踪与混合奖励
每条参考轨迹被转换为按可变间隔采样的共跟踪子目标序列。对子目标 $g_{k}=(\hat{\boldsymbol{p}}^{\mathrm{tip}}_{k},\hat{T}^{o}_{k})$,逐指、物体位置与物体旋转的跟踪误差定义为:
$$e^{f}_{t,k}=\left\|\boldsymbol{p}^{\mathrm{tip}}_{t,f}-\hat{\boldsymbol{p}}^{\mathrm{tip}}_{k,f}\right\|_{2},\quad e^{\mathrm{pos}}_{t,k}=\left\|\boldsymbol{x}^{o}_{t}-\hat{\boldsymbol{x}}^{o}_{k}\right\|_{2},\quad e^{\mathrm{rot}}_{t,k}=\left\|\mathrm{Log}\!\left(\hat{R}^{o\top}_{k}R^{o}_{t}\right)\right\|_{2}$$当连续 $N_{\mathrm{stay}}\sim\mathcal{U}\{5,15\}$ 帧同时满足 $\max_{f}e^{f}_{t,k}<\epsilon_{\mathrm{tip}}=3$ 厘米、$e^{\mathrm{pos}}_{t,k}<\epsilon_{\mathrm{pos}}=1$ 厘米、$e^{\mathrm{rot}}_{t,k}<\epsilon_{\mathrm{rot}}=10^{\circ}$ 时,判定子目标到达。驻留帧数随机化避免策略学会「擦边即走」的投机行为。奖励把稀疏子目标到达、稠密跟踪与时间惩罚三项耦合:
$$r_{t}=\underbrace{\mathbbm{1}_{\mathrm{reach}}(t)\,w_{\mathrm{step}}(t)\,r_{\mathrm{score}}(t)}_{\text{稀疏子目标}}+\underbrace{\alpha_{\mathrm{dense}}\,r_{\mathrm{dense}}(t)}_{\text{稠密跟踪}}-\underbrace{c_{\mathrm{time}}}_{\text{时间}},\quad \alpha_{\mathrm{dense}}=0.1,\ c_{\mathrm{time}}=0.1$$子目标得分衡量手与物体对当前子目标的匹配程度,是逐指与物体项的指数核加权和:
$$r_{\mathrm{score}}=\alpha_{s}\Bigl[w^{s}_{\mathrm{tip}}\sum_{f\in\mathcal{F}}\rho_{f}+w^{s}_{\mathrm{obj}}\,(\rho_{\mathrm{pos}}+\rho_{\mathrm{rot}})\Bigr],\quad \rho_{f}=\exp\!\bigl(-\beta_{f}\,e^{f}_{t,k}\bigr)$$其中 $\alpha_{s}=1.5$、$w^{s}_{\mathrm{tip}}=0.5$、$w^{s}_{\mathrm{obj}}=2.0$;衰减率 $\beta$ 按误差类型区分:拇指 100、其余四指 90、MCP 根关节层 50、近端关节层 40、物体位置 80、物体旋转 3(旋转误差以弧度计,故衰减率小)。物体项权重是指尖项的四倍,反映共跟踪中物体位姿才是任务成败的最终判据。稠密项 $r_{\mathrm{dense}}$ 在每一步使用同样的逐指与物体核,但物体部分被 $(1-\sigma_{t})$ 门控:训练早期课程因子 $\sigma_{t}$ 小、物体稠密信号关闭,随课程推进逐渐打开,避免早期用尚不可达的物体目标压制探索。
步权重 $w_{\mathrm{step}}$ 是防止子目标投机的重要细节:命中子目标 $g_{k}$ 后,下一子目标从同一条参考轨迹的 $k^{\prime}=k+\Delta k$ 抽取,$\Delta k$ 的范围随课程扩张;$w_{\mathrm{step}}=|\Delta k|+5$ 使更大的跳跃获得成比例的更大奖励,策略不会偏向剥削平凡接近的子目标。跨轨迹切换时 $w_{\mathrm{step}}$ 取固定大值 100,补偿切换带来的分布跳变。
3.2 课程、重置与随机动作掩码
课程沿三个难度维度推进:重力从 0 退火到 $-9.8$(约 32K 环境帧),降低初始接触建立难度;子目标容差 $(\epsilon_{\mathrm{tip}},\epsilon_{\mathrm{pos}},\epsilon_{\mathrm{rot}})$ 从宽松逐步收紧;子目标间隔 $\Delta k$ 的最大值从 40 帧扩到 80 帧(控制频率 60Hz),使策略先掌握细粒度局部跟踪、再处理长时程目标跳跃。稠密奖励的物体门控 $\sigma_{t}=1-(1-0.7)\min(t/25600,1)$ 与动作掩码时长从 1 帧扩到 10 帧同属课程表。
重置策略与课程配合:以 0.9 概率在同一条轨迹内从 $k+\Delta k$ 继续、0.1 概率跨轨迹切换;切换后前 300 帧奖励置平,失败重置的惩罚系数 $\eta_{\mathrm{fail}}=1.5$;速度越界或物体位置误差超过 15 厘米即终止。参考运动的前 90% 帧用于随机初始状态采样(RSI),保证长时程后段也有足够访问。
随机动作掩码是全文对 sim-to-real 贡献最大的单项设计。给定策略动作 $\boldsymbol{a}_{t}$,采样二值掩码 $\boldsymbol{m}_{t}\in\{0,1\}^{n_{\mathrm{dof}}}$ 并执行
$$\tilde{\boldsymbol{a}}_{t}=\boldsymbol{m}_{t}\odot\boldsymbol{a}_{t}+(1-\boldsymbol{m}_{t})\odot\tilde{\boldsymbol{a}}_{t-1}$$即以概率 0.15 随机选 3 个自由度,把被掩码关节冻结在上一条命令上、持续随机时长。这迫使策略在部分关节响应滞后或完全无响应时仍能恢复有用接触配置,与真机上的主要失败模式(电机滞后、背隙、SharpaWave SDK 偶发丢命令)直接对应。论文在附录中明确称其为「我们测试过的影响最大的 sim-to-real 干预」。动作参数化沿用 HORA 的残差关节目标并加软死区:$\boldsymbol{a}^{\mathrm{cmd}}_{t}=\mathrm{clip}\bigl(\boldsymbol{a}^{\mathrm{cmd}}_{t-1}+0.1\cdot\mathrm{deadzone}_{0.1}(\boldsymbol{a}_{t})\bigr)$,死区给高斯策略一个显式的「保持不动」区域,不必精确输出零。
3.3 几何感知重定向:从 mocap 到参考运动
参考运动来自动作捕捉系统记录的人手-物交互轨迹,覆盖手内平移、手内旋转与混合自由玩耍(任意抓握、指步与工具使用序列)三类。转换分两阶段:第一阶段沿用向量对齐重定向,优化机器人关节角 $\boldsymbol{q}_{1:T}$ 以匹配人手几何;第二阶段引入物体网格做几何感知精修:
$$\boldsymbol{q}^{*}_{1:T}=\arg\min_{\boldsymbol{q}_{1:T}}\sum_{t=1}^{T}\left(\mathcal{L}_{\mathrm{vec}}^{t}+\lambda_{\mathrm{surf}}\mathcal{L}_{\mathrm{surf}}^{t}+\lambda_{\mathrm{pen}}\mathcal{L}_{\mathrm{pen}}^{t}+\lambda_{\mathrm{col}}\mathcal{L}_{\mathrm{col}}^{t}\right)+\lambda_{\mathrm{smooth}}\mathcal{L}_{\mathrm{smooth}}$$表面吸引项 $\mathcal{L}_{\mathrm{surf}}^{t}=\frac{1}{|\mathcal{S}_{t}|}\sum_{p\in\mathcal{S}_{t}}\mathrm{ReLU}(\mathrm{sdf}_{\mathcal{O}_{t}}(p))$ 把接近接触的手部点($\mathcal{S}_{t}=\{p:\mathrm{sdf}<\tau_{\mathrm{surf}}=2\}$ 毫米)拉向物体表面;穿透惩罚 $\lambda_{\mathrm{pen}}=2$ 作用于 $\mathrm{ReLU}(-\mathrm{sdf})$;跨指碰撞项 $\lambda_{\mathrm{col}}=10$ 用指尖球体约束;$\lambda_{\mathrm{smooth}}=0.1$ 的时间平滑能量抑制捕捉抖动;SDF 由 Kaolin 提供可微查询。第一阶段 Adam 学习率 1e-3 跑 6000 步,第二阶段 3e-3 跑 160 步并做 1.0 梯度裁剪。输出 $\{(\boldsymbol{q}^{*}_{t},T^{o}_{t})\}$ 在腕系中给出参考运动,共跟踪目标即 $\hat{\boldsymbol{p}}^{\mathrm{tip}}_{t}=\mathrm{FK}_{\mathrm{tip}}(\boldsymbol{q}^{*}_{t})$ 与 $\hat{T}^{o}_{t}=T^{o}_{t}$。开源仓库中 src 下的 object_aware.py 实现第二阶段(含上述全部 $\lambda$ 权重),kinematic/pipeline.py 实现第一阶段。
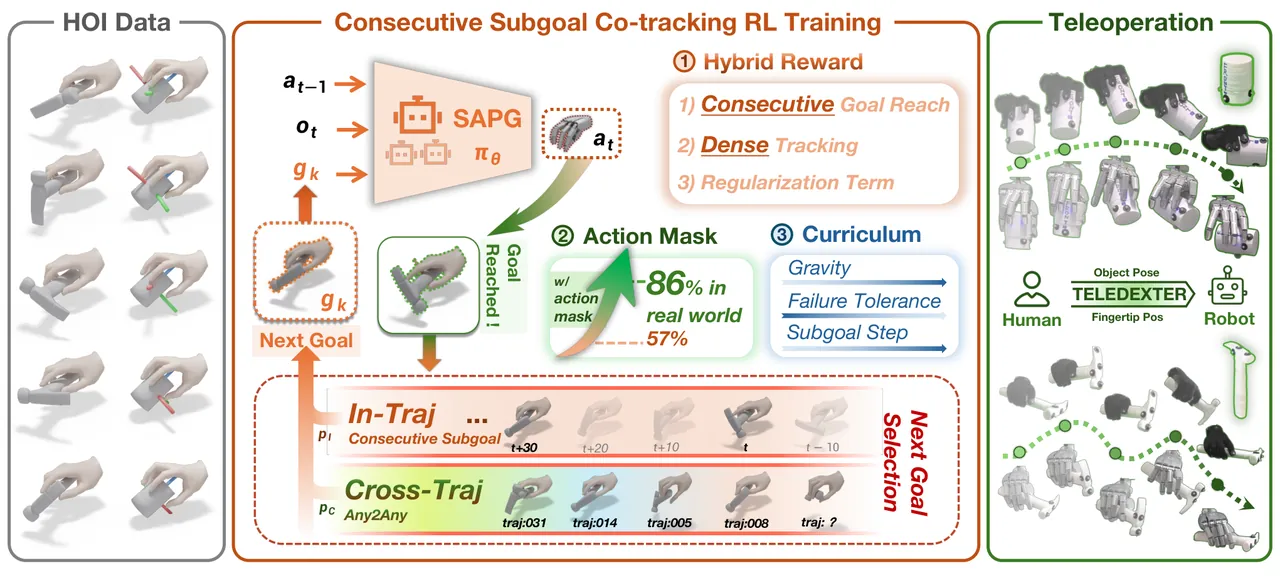
图2:方法总览(论文 Figure 2)。左为手-物交互参考运动;中为单阶段 RL 训练环:连续子目标共跟踪、混合奖励(稀疏到达 + 稠密跟踪)、动作掩码(真机 86%)、课程(重力/失败容差/子目标步长)与轨迹内/跨轨迹重置;右为零样本部署:操作者经 TeleDexter 策略驱动机器人手与物体。
3.4 单阶段训练与真机部署
每个控制器在单一 RL 阶段内训练完成,不做技能分阶段分解、不做任务特定奖励工程。仿真用 Isaac Gym,一个物体的全部参考运动(约 50 分钟、30Hz、每物体 150 条轨迹,NOKOV 动捕采集)同时载入;优化器为 SAPG(6 个注意力块、LSTM 512、MLP [512,1024,1024,512,512] ELU、学习率 2e-4、$\gamma=0.99$、$\lambda=0.95$),4 张 RTX 5090 上每卡 15,600 个并行环境、共 62,400 个,约 $10^{10}$ 环境步(约一天)收敛。域随机化覆盖物体与手的形状和动力学属性、物体外力、观测噪声与延迟。
部署时实时系统捕捉操作者腕部、指尖与物体位姿:机械臂经 IK 跟踪腕部,指尖与物体位姿构成共跟踪目标送入策略。接触初始化阶段仍用运动学重定向完成预抓握定位,稳定接触建立后操作者切换到共跟踪控制器执行灵巧操纵——这一「先运动学、后学习」的切换点是人机接口上唯一需要操作者判断的环节。
实验结果
硬件为 Franka FR3 机械臂加两种灵巧手:16 自由度四指 LeapHand 与 22 自由度五指仿人 SharpaWave。七项任务分两类:三项手内重定向(CylinderReorient、CuboidReorient、BunnyReorient)与四项长时程工具使用(HammerUse、ScrewdriverUse、BrushSweep、BulbReplace)。表1 的主结果中,TeleDexter 七任务平均 SR 75.2%、TP 87.1%;基线方面,运动学重定向 DexRT 平均 5.7/37.6、GeoRT 0/28.5,学习型先验 DexGen 0/25.0,非遥操作方法的 SimToolReal 两个变体也只有 8.9/28.9 与 6.7/20.6。
| 任务(SharpaWave) | DexRT | GeoRT | DexGen | SimToolReal† | SimToolReal‡ | TeleDexter |
|---|---|---|---|---|---|---|
| CylinderReorient | 6.7 / 37.8 | 0.0 / 24.4 | 0.0 / 31.1 | — | — | 80.0 / 86.7 |
| CuboidReorient | 26.7 / 51.1 | 0.0 / 33.3 | 0.0 / 28.9 | — | — | 80.0 / 86.7 |
| BunnyReorient | 0.0 / 35.6 | 0.0 / 31.1 | 0.0 / 26.7 | — | — | 66.7 / 77.8 |
| HammerUse | 0.0 / 26.7 | 0.0 / 30.5 | 0.0 / 26.7 | 0.0 / 27.6 | 20.0 / 36.2 | 66.7 / 86.7 |
| BrushSweep | 0.0 / 39.0 | 0.0 / 29.5 | 0.0 / 8.6 | 26.7 / 41.9 | 0.0 / 5.7 | 73.3 / 89.5 |
| ScrewdriverUse | 6.7 / 37.3 | 0.0 / 25.3 | 0.0 / 33.3 | 0.0 / 17.3 | 0.0 / 20.0 | 73.3 / 86.7 |
| BulbReplace | 0.0 / 35.6 | 0.0 / 25.6 | 0.0 / 20.0 | — | — | 86.7 / 95.6 |
| 平均 | 5.7 / 37.6 | 0.0 / 28.5 | 0.0 / 25.0 | 8.9 / 28.9 | 6.7 / 20.6 | 75.2 / 87.1 |
表1:SharpaWave 灵巧遥操作结果(论文 Table 1),每格为 SR / TP(%)。SimToolReal 非遥操作方法,† 为按工具类别、‡ 为全类别,仅在三工具任务上平均。
SR 与 TP 的差距揭示失败位置:TeleDexter 的 75.2 对 87.1 说明多数失败发生在任务后段,而基线在第一个需要手内重定向或指步的阶段就崩溃。分阶段数据(图6)支持这一读法:BulbReplace 上 TeleDexter 15/15 通过拧入与拧出两个旋转阶段、13/15 到达最终放置;ScrewdriverUse 上 15 次试验中 13 次以连续指步撑过拧紧阶段——这是任何基线都无法执行的接触模式。LeapHand 上同一训练管线只需替换几何感知重定向阶段即可迁移:CylinderReorient 60.0/73.3、CuboidReorient 73.3/82.2,参考运动无需重采。
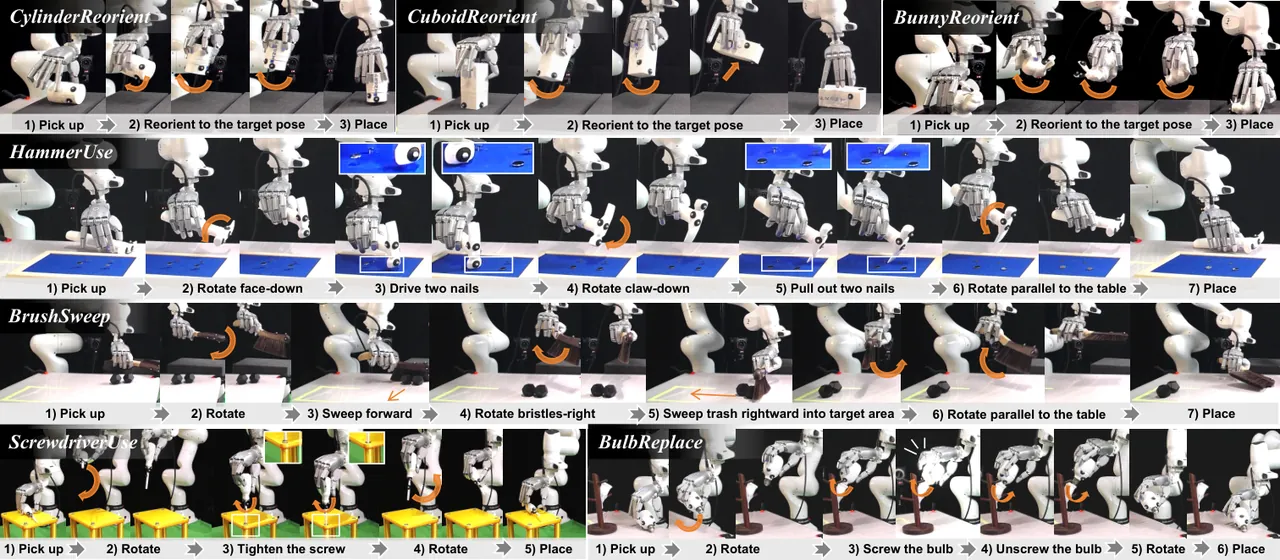
图3:任务描述与阶段分解(论文 Figure 3)。上排为三项重定向任务,下排为四项工具任务;每行缩略序列对应一个明确阶段,SR/TP 即以这些阶段为计分单元。
从遥操作到自主:用 TeleDexter 采集的演示训练 Conv-UNet Diffusion Policy,条件为第三人称与腕部 RGB。每任务 50 条专家演示、15 次真机评测。HammerDriver 取得 73.3% SR,抓握与重定向 15/15 全过,失败集中在对泡沫靶持续施加接触力的钉击阶段;BulbInstall 46.7%,精对准是瓶颈(8/12),一旦对准则 7/8 完成拧入;BrushForward 40.0%,细而不规则的刷柄使抓握成为主要失败点(7/15),但活过抓握的试验 6/7 完成后续旋转与清扫。关键在于:表1 中没有任何基线遥操作系统能可靠完成这三项任务,因此用现有方法根本无法采集可比的演示数据——TeleDexter 同时是遥操作接口与自主灵巧操作的数据采集管线。
| 自主任务 | 阶段序列(存活试验数) | SR |
|---|---|---|
| BulbInstall | 13/15 抓起 → 12/13 重定向 → 8/12 对准 → 7/8 安装 | 46.7% |
| HammerDriver | 15/15 抓起 → 15/15 旋转 → 11/15 钉击 | 73.3% |
| BrushForward | 7/15 抓起 → 7/7 旋转 → 6/7 前扫 | 40.0% |
表2:自主策略分阶段成功(论文 Table 3 与 4.3 节正文)。每任务 50 条演示、15 次真机试验;箭头链为各阶段存活试验数。
消融一:连续子目标对稠密跟踪(仿真,表3)。即便在偏袒稠密基线的稠密评测下,稀疏子目标跟踪的 episode 长度也显著更长(Cuboid 378.6 对 115.8);在稀疏评测下差距放大到数量级(Cuboid 32.6 对 2.6 个连续子目标,Hammer 186.6 对 2.7)。逐帧稠密跟踪强迫策略逐步复刻参考轨迹,没有容差去发现物理可行的接触策略,因而早退。消融二:随机动作掩码(真机,表3 右)。去掉掩码后 HammerUse 从 66.7/86.7 跌到 33.3/57.1,ScrewdriverUse 从 73.3/86.7 跌到 0.0/36.0,CuboidReorient 从 80.0/86.7 跌到 26.7/51.1——掩码作为动作空间正则,阻止策略剥削仿真特有动力学,是零样本部署的前提。
| 消融 | 设置 | 指标 A | 指标 B |
|---|---|---|---|
| 子目标 vs 稠密(仿真) | Cuboid:稠密评测 EpLen / 稀疏评测 Goals | 378.6 / 32.6(本文) | 115.8 / 2.6(稠密基线) |
| 子目标 vs 稠密(仿真) | Hammer / Screwdriver 稀疏评测 Goals | 186.6 / 178.5(本文) | 2.7 / 2.7(稠密基线) |
| 动作掩码(真机 SR/TP) | HammerUse / ScrewdriverUse / CuboidReorient | 66.7/86.7、73.3/86.7、80.0/86.7(有掩码) | 33.3/57.1、0.0/36.0、26.7/51.1(无掩码) |
表3:两组核心消融(论文 Table 4 与 Table 5)。EpLen 为 episode 长度,Goals 为连续到达子目标数,均越高越好。
flowchart TB
  subgraph DATA["参考运动构造"]
    A[动捕人手-物轨迹
每物体 150 条, 20 秒, 30Hz] --> B[第一阶段 向量对齐重定向
Adam 1e-3, 6000 步]
    B --> C[第二阶段 几何感知精修
表面 10, 穿透 2, 碰撞 10, 平滑 0.1]
    C --> D[腕系指尖目标 + 物体 6D 位姿]
  end
  subgraph RL["Isaac Gym 单阶段 RL"]
    D --> E[连续子目标共跟踪
驻留 5-15 帧, 指尖 3 厘米, 位置 1 厘米, 旋转 10 度]
    E --> F[混合奖励
稀疏到达 + 0.1 稠密 - 0.1 时间]
    F --> G[随机动作掩码
概率 0.15, 冻结 3 个自由度旧命令]
    G --> H[课程
重力, 容差, 子目标步长 40 到 80 帧]
    H --> I[SAPG, 62400 并行环境, 4 张 RTX 5090, 1e10 步]
  end
  subgraph DEPLOY["零样本真机部署"]
    I --> J[运动学重定向预抓握]
    J --> K[操作者切换到共跟踪控制器]
    K --> L[七项任务 平均 SR 75.2%, TP 87.1%]
    L --> M[每任务 50 条演示训练 Diffusion Policy
自主 SR 46.7% 到 73.3%]
  end
流程图:依据 3.1-3.4 与 4.3 节重建的完整管线——参考运动构造、单阶段共跟踪 RL、零样本部署并反哺自主策略学习。
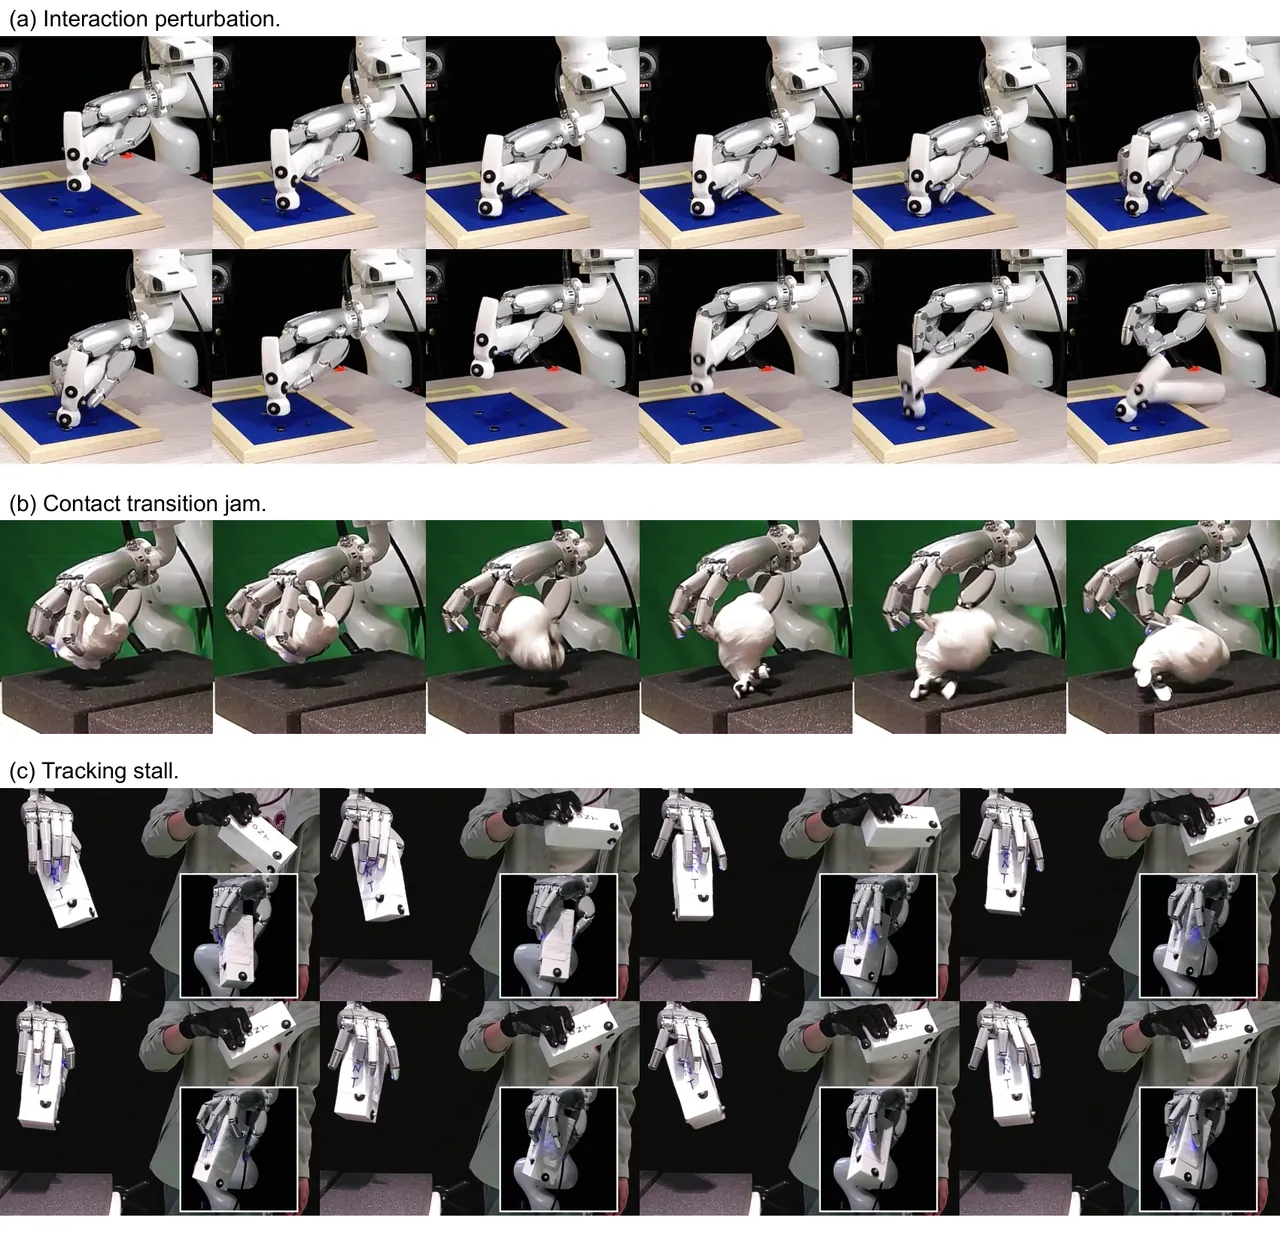
图4:真机失败案例分析(论文 Figure 7)。(a) 交互扰动:外部接触扰动后抓握失稳;(b) 接触转换卡滞:指步切换中物体被夹持几何卡住;(c) 跟踪停滞:无触觉反馈下策略对已滑移物体停止修正。三类失败均发生在接触转换或接触维持环节,而非子目标语义层面。
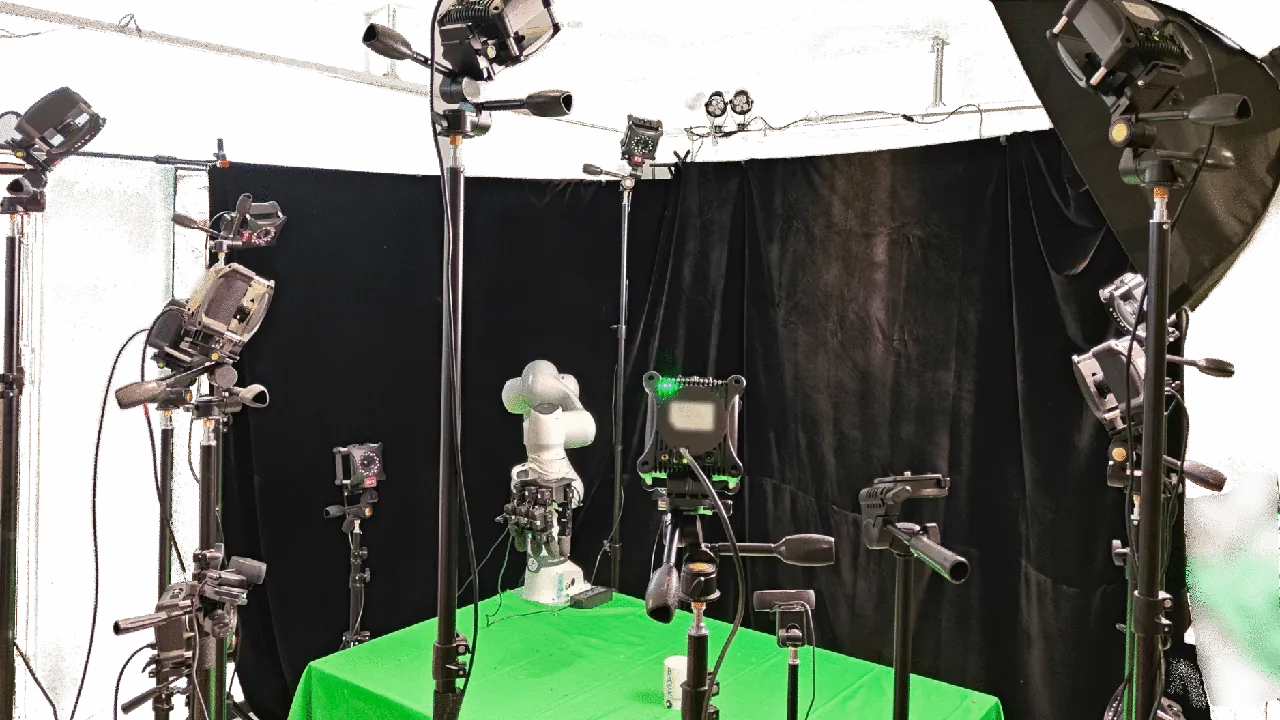
图5:手-物动捕采集环境(论文 Figure 8)。三脚架架设的 NOKOV 红外相机围出专用采集体积;离线参考运动采集用手套在腕、掌与全部指关节布设密集标记点,在线遥操作手套则精简标记以降低延迟。
局限性
作者自述两条边界。其一,TeleDexter 目前学习的是物体特定控制器:换一个新物体就需要重新采集人手-物交互数据并训练一个专用策略;扩展到跨物体类别泛化的、物体条件化的统一控制器是明确的未来工作。其二,真机部署依赖动捕系统实时估计手与物体位姿;换成无标记的视觉跟踪将显著降低部署门槛、扩大实用范围。
我们的独立判断补充三点。其一,SR 与 TP 的协议依赖人工定义的任务阶段分解,阶段粒度直接影响两个指标的数值,跨论文比较时需要谨慎;15 次试验的样本量也使 66.7% 与 73.3% 之间的差距落在二项置信区间重叠范围内。其二,「先运动学重定向预抓握、稳定接触后切换共跟踪控制器」的切换由操作者判断,论文未量化切换时机对成功率的影响,也未报告切换失败的占比,而这恰恰是人机接口上最可能出错的环节。其三,自主策略实验只覆盖三项任务的接触密集子段、每任务 50 条演示,BrushForward 的抓握瓶颈(7/15)说明 RGB 观测对细柄物体的 finger placement 分辨力不足;论文未尝试加入深度或触觉通道,也未报告演示数量从 50 向上扩展时的收益曲线。
总结与展望
TeleDexter 的贡献在于把灵巧遥操作的控制权重新分配:操作者只声明指尖与物体的同步几何目标,接触策略的全部复杂性交给单阶段 RL 在仿真中搜索;连续子目标表述给策略留下接触转换的自由度,几何感知重定向保证子目标物理可行,随机动作掩码把仿真与真机之间的执行器鸿沟变成训练分布的一部分。七项任务 75.2% 的平均成功率与基线的近乎全灭,加上 50 条演示即可行为克隆出自主策略,说明这条管线同时解决了「遥操作够不够灵巧」与「灵巧数据从哪来」两个长期问题。
开放问题同样具体:物体特定控制器意味着每加一个物体就要重走采集与训练全流程,物体条件化或物体几何编码是自然的下一步;动捕依赖把部署锁在实验室体积内,无标记视觉跟踪是走向实用的前提;而 SR/TP 协议、切换时机与演示规模的敏感性分析,则决定了这套评测能否成为社区可复用的比较基准。若这三点被逐一解决,「人类级手内灵巧」将第一次拥有可规模化的数据与控制器供给链。
金句
操作者只需要说出手和物体应该到哪里,接触如何发生是控制器在仿真里自己学会的事——灵巧遥操作的瓶颈从来不是意图,而是意图与多接触物理之间的执行鸿沟。