PAPER DEEP DIVE
LENS:基于动态原始文档的潜在证据探索上下文搜索
LENS是一种无需索引的上下文搜索框架,在动态文档集合上维护查询条件信念,通过词法、局部和探索性提案策略迭代选择候选证据,用LLM相关性预言机更新信念,在可控预算下收敛到高后验区域。在500题评估中达到62.4%精确匹配和84.8%证据召回率。
论文元信息
标题:LENS: In-Context Search via Latent Evidence Exploration over Dynamic Raw Documents
作者:Xingjun Wang, Gongsheng Li, Qi Fan, Yunlin Mao, Luyan Su, Yingda Chen(ModelScope Team, Alibaba Group)
论文链接:arXiv:2608.16185
代码状态:本文未提供公开代码仓库。论文页面未包含 GitHub 链接,作者隶属阿里巴巴 ModelScope 团队,但截至撰稿时未在 ModelScope 或 GitHub 上发现对应实现。
一句话总结
LENS 将 LLM agent 在动态文档集上的上下文搜索形式化为"有预算的证据定位"问题,不做任何预索引,而是维护查询条件信念、用 LLM 相关性预言机迭代收敛到高后验证据区域,在答案质量与 ReAct 持平的同时大幅提升证据可溯源率。
研究背景与动机
大语言模型 agent 在回答问题时越来越依赖外部文档集合。但现实中的文档集合是动态的——文件可以被新增、修改、删除,且这些变化发生在用户查询之前。传统的检索增强生成(RAG)方法在查询到来之前就把证据空间"固化"了:通过固定分块、稠密向量嵌入、持久化稀疏索引、摘要树或图状记忆结构,把文档预先加工成便于检索的表示。
这种预固化策略在语料稳定时有效,因为预处理成本可以被摊销。但在动态文档场景下,它引入了三个核心矛盾。第一,设置和更新成本必须在查询之前支付——即使还没有人提问,索引也要建好并维护。第二,文档变更后索引会变得陈旧——已经构建的嵌入和分块不再匹配当前文档状态。第三,固定分块在查询已知之前就承诺了证据粒度——但不同查询需要的证据可能是一个短语跨度、一个表格条目、一个章节或一个跨文档链条,其适当粒度取决于查询本身。
核心困难在于:原始文档诱导的证据空间是"潜在"的、"可变边界"的、"动态"的、"结构化"的。潜在——因为承载答案的证据存在于文档中但在查询之前不被知晓;可变边界——因为有用证据窗口不限于固定分块集,这使得空间有限但组合爆炸;动态——因为文档更新改变了空间本身;结构化——因为词法锚点、布局、路径和历史搜索信号在可能证据区域上诱导了非均匀先验。把这个空间当作固定分块集合处理,会遮蔽 LLM agent 面对的真实搜索问题。
LENS 提出的核心思路是:不预先固化证据空间,而是在查询到来后,以一种低成本先验压缩搜索域,然后通过 LLM 相关性预言机的顺序观测来迭代收敛到高后验证据区域,整个过程在有界预算下进行。这使得 LENS 在文档变更后立即可查询,无需重建索引,并保持证据可溯源。
预备知识
理解 LENS 需要几个关键概念。首先是"潜在证据空间"——对于时刻 $t$ 的文档集合 $\mathcal{D}_t$,所有可能的证据窗口 $(d, s, e)$ 构成的集合 $\mathcal{E}_t$,其中 $d$ 是文档、$s$ 和 $e$ 是起止位置。这个空间不是被枚举的,而是潜在的——LENS 从不显式列出所有可能窗口。
其次是"查询意图"——LENS 用意图变量 $I(q) \in \{\text{lookup}, \text{computation}, \text{comparison}, \text{aggregation}, \text{summarize}\}$ 来区分查询类型。查询意图决定了证据需求:查 lookup 类查询只需 $K=1$ 个原子事实,而比较和聚合查询需要 $K > 1$ 个事实,这些事实可能分布在不同的文档中。
第三是"预言机"——LENS 将 LLM 视为一个有成本的"相关性预言机"。每次调用 LLM 判断一个候选证据区域与查询的相关性,都消耗 token、延迟和成本。因此搜索方法需要在即时相关性、信息增益、来源可溯性和预算之间权衡。
最后是"信念更新"——LENS 为每个原子事实 $f_j$ 维护一个后验信念 $P(Z_j^* \mid f_j, q, \mathcal{H}_t)$,其中 $\mathcal{H}_t$ 是观测历史。每次预言机调用返回的观测 $o_i$ 会同时更新所有事实的信念——这是"按事实分解"设计的关键优势。
方法详解
第一层:低成本先验
LENS 的第一层在不读取文档内容的情况下,融合五类低成本信号来压缩搜索空间:词法锚点、文档路径结构、编译文档摘要(如有)、历史成功搜索的来源溯源证据,以及轻量级语料扫描。这些信号不是独立的检索模块,而是被用作对先验 $\pi_{\text{prior}}(z \mid q, \mathcal{D}_t)$ 的近似:
$$\pi_{\text{prior}}(z \mid q, \mathcal{D}_t) \approx \sum_{k \in \mathcal{K}_0} w_k \, \pi_k(z \mid q, \mathcal{D}_t) \tag{6}$$
其中 $\mathcal{K}_0$ 是低成本提案信号族。这个联合先验通过链式法则分解为一个边际-条件对,将文档选择与文档内定位分离:
$$\pi_{\text{prior}}(z \mid q, \mathcal{D}_t) = \pi_{\text{file}}(d_z \mid q, \mathcal{D}_t) \, \pi_{\text{pos}}(s_z, e_z \mid d_z, q) \tag{7}$$
其中 $d_z$ 是区域 $z$ 所属的文档。这个分解至关重要:强文件级证据并不自动意味着精确的文档内定位。命题 1 证明了,在消耗任何迭代预言机预算之前,LENS 将有效搜索域从完整文档集合缩减到查询条件子空间 $\mathcal{C}_{\text{search}}$。推论 1 给出了具体量级:在文件准入宽度 $m=10$ 和可比文章长度下,缩减比约为 $\mathcal{C}_{\text{search}} / |\mathcal{E}_t| \approx 1.8 \times 10^{-3}$(D125)到 $4.7 \times 10^{-4}$(D500),约三个数量级。
第二层:预算约束的顺序推理
先验形成后,LENS 进入预算约束的探索循环,包含四个步骤循环执行:提议候选证据区域 $z_t$、查询 LLM 相关性预言机获取观测 $o_t$、更新证据区域上的信念、调整提案权重和覆盖估计。观测历史 $\mathcal{H}_t = \{(z_i, o_i)\}_{i=1}^t$ 为每个事实维护信念并从共享历史中更新:
$$P(Z_j^* \mid f_j, q, \mathcal{H}_t) \propto \prod_{i=1}^t P(o_i \mid Z_j^*, z_i, f_j, q) \cdot \pi_{\text{prior}}(Z_j^* \mid f_j, q, \mathcal{D}_t) \tag{8}$$
一次预言机调用同时服务所有事实——这正是按事实分解设计不会将预言机预算乘以 $K$ 的原因。
下一个候选区域应平衡利用与探索。理想的信息定向目标选择:
$$z_{t+1} = \arg\min_{z \in \mathcal{C}_{\text{search}}} \Psi_t(z), \quad \Psi_t(z) = \frac{[\Delta_t(z)]^2}{\mathbb{I}(\mathbf{Z}^*; O_z \mid q, \mathcal{H}_t)} \tag{9}$$
其中 $\Delta_t(z)$ 是期望即时相关性差距,分母是关于未完成目标 $\mathbf{Z}^*$ 的期望信息增益。最小化这个信息比率是原则性的:它瞄准即时相关性与长期信息增益之间的权衡——这是 regret 最优顺序选择的基础。由于精确计算不可行,LENS 用互补提案族近似:
$$\pi_t(z) = \lambda_{\text{lex}}^{(t)} \pi_{\text{lex}}(z) + \lambda_{\text{local}}^{(t)} \pi_{\text{local}}(z) + \lambda_{\text{global}}^{(t)} \pi_{\text{global}}(z) \tag{10}$$
词法提案利用锚点、局部提案在高信念区域附近精炼、全局提案防范语义遗漏。每个提案族被视为一个臂,LENS 从观测到的预言机效用中在线调整混合权重 $\lambda^{(t)}$,完成提议-观测-更新循环。
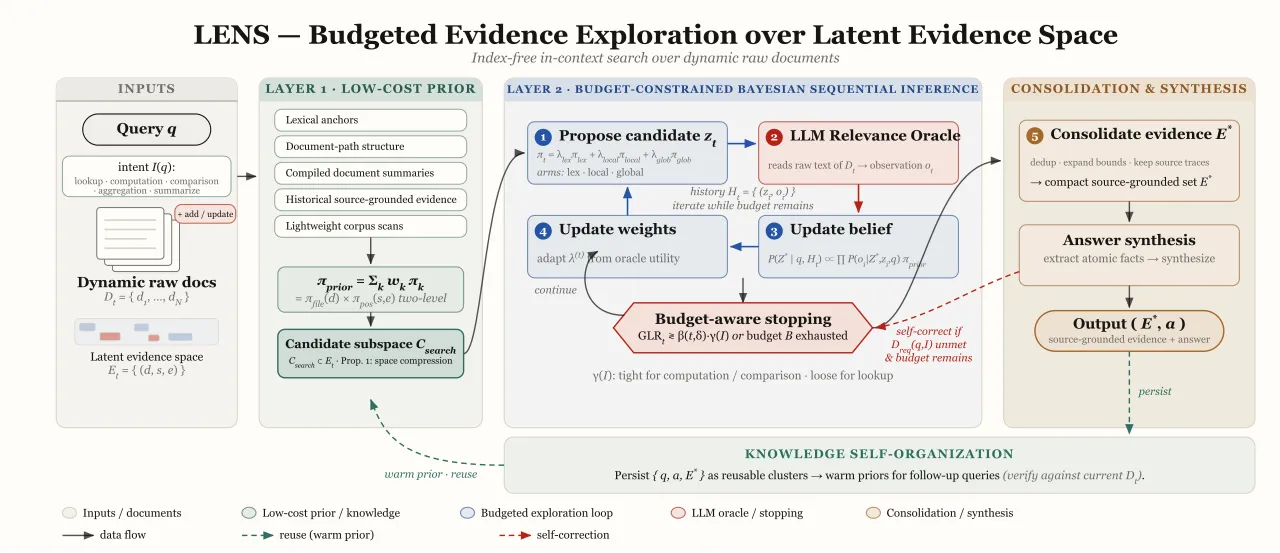
图1:LENS 整体框架。LENS 在候选证据区域上形成查询条件先验,运行预算约束的提议-观测-更新循环,将选定区域整合为紧凑的来源溯源证据集用于答案合成。它从不在原始文档集上预构建持久索引。
预算感知停止
探索循环不应仅因为还能读取更多上下文就继续。LENS 在每次迭代时做停止决策:当剩余预算不足或每个需求都以足够集中的信念被定位时退出循环。借鉴固定置信度最佳臂识别的思想,按事实的停止统计量为:
$$\text{GLR}_t^{(j)} = \min_{z \neq \hat{Z}_{j,t}} \sum_{i \leq t} \log \frac{P(o_i \mid \hat{Z}_{j,t}, f_j, q)}{P(o_i \mid z, f_j, q)} \tag{11}$$
其中 $\hat{Z}_{j,t}$ 是事实 $f_j$ 当前最高信念区域。LENS 在 $\min_{j \leq K} \text{GLR}_t^{(j)}$ 超过意图调制阈值 $\beta(t, \delta) \, \gamma(I)$ 时停止——即最弱需求被解决时。意图因子 $\gamma(I)$ 对计算和比较意图收紧准则,对 lookup 意图放松。lookup 查询有单一需求、通常一个紧凑区域即可停止,而比较和计算查询不能停止直到每个 $K$ 个事实都有各自的确认窗口。
证据整合与答案合成
循环停止后,选定区域进入整合与合成阶段。整合合并按事实窗口 $\{\hat{Z}_j\}_{j \leq K}$,移除冗余或重叠区域,必要时扩展边界以提升可解释性,保留来源追踪,产出紧凑的来源溯源证据集 $E^*$。答案合成在 $E^*$ 上进行:对于计算和比较查询,LENS 将原子事实提取与答案合成分离;对于 lookup 式查询,单阶段合成可能足够。当合成无法满足 $\mathcal{D}_{\text{req}}(q, I)$ 且预算剩余时,LENS 触发自校正路径:放宽停止阈值、以扩展候选集重新进入探索循环,然后重新合成。最终输出是 $(E^*, a)$——一个基于显式证据区域的答案,而非仅基于检索文本片段的答案。
graph TD
    A[查询 q + 动态语料 D_t] --> B[第一层: 低成本先验]
    B --> B1[词法锚点]
    B --> B2[文档路径结构]
    B --> B3[编译摘要]
    B --> B4[历史证据]
    B --> B5[轻量扫描]
    B1 & B2 & B3 & B4 & B5 --> C[候选子空间 C_search]
    C --> D[第二层: 预算约束探索循环]
    D --> D1[提议候选 z_t]
    D1 --> D2[LLM 相关性预言机]
    D2 --> D3[更新按事实信念]
    D3 --> D4[调整提案权重]
    D4 --> E{预算剩余? 需求已满足?}
    E -->|是| D1
    E -->|否| F[证据整合]
    F --> F1[合并去冗余]
    F1 --> F2[来源溯源证据集 E*]
    F2 --> G[答案合成]
    G --> G1{需求满足?}
    G1 -->|否, 预算剩余| H[自校正: 放宽阈值
重新进入循环]
    H --> D
    G1 -->|是| I["输出 (E*, a)"]
图2:LENS 算法流程图。从低成本先验到预算约束探索循环,再到证据整合和答案合成,自校正路径在需求未满足时重新进入循环。
算法总结与理论性质
算法 1 总结了推理循环。命题 2 证明了有界预言机复杂度:对于循环预算 $L$ 轮探索,LENS 执行的 LLM 预言机交互次数以 $c_0 + c_1 L$ 为界,其中 $c_0 = 4$、$c_1 = 2$(在当前配置下),与需求数 $K$ 无关——因为一次预言机观测更新所有按事实信念,也与 $|\mathcal{E}_t|$(文档诱导的潜在证据窗口数)无关。在实际配置 $L=3$ 下,理论上界为每题 10 次预言机交互;实测均值仅 4.00 次(G125/G250)和 4.04 次(G500),零预算超限记录。松弛是预期的——大部分查询通过短路终止(覆盖检查报告完成,或意图门控的直接分析路径在循环耗尽前就解决了查询)。
预言机交互的计数按发出阶段划分:S1 锚点提取(1 次请求)、S2 需求分解(1 次)、S3 探索轮(每轮 2 次——提案观测 + 覆盖检查)、S4 答案合成(1 次)、S5 答案跨度校准(≤1 次),总计 $1 + 1 + 2L + 1 + 1 = 4 + 2L$。关键性质是:这个上界不随语料大小或需求事实数增长——这是 LENS 在大规模动态文档场景下可扩展的根本保证。
实验结果
实验设置
LENS 在 HotpotQA fullwiki 基准上评估——这是一个多跳问答数据集,每个问题需要在两篇或更多维基百科文章上进行推理。实验有两种条件:受控评估($D_n$,从验证集 7405 题中按类型×难度分层抽样,种子 42)和开放域 fullwiki(15,517 个 JSON 分片的完整原始维基百科转储,零预处理、零分块、零索引)。
对比五个系统:LENS(完整算法)、ReAct Search(强迭代基线,使用 ReAct 式工具推理但无 LENS 的结构化先验和预算约束信念更新)、Hybrid-RAG(BM25 + 稠密嵌入检索,预建索引)、BM25-RAG(稀疏检索基线,预建 BM25 索引)、Closed-Book(无检索参考,估计模型参数单独贡献的分数)。所有系统共享同一聊天后端(Qwen3.7,35B 参数 MoE 模型,3B 活跃参数),300 秒/题墙钟上限。LENS 使用 DEEP 配置,128K 查询时 token 预算,最多 10 个候选文件进入证据提取。
| 系统 ($D_{500}$) | 即时就绪 | 需重建 | 索引时间(秒) | 存储 |
|---|---|---|---|---|
| LENS | 是 | 否 | 0.0 | 0 |
| ReAct | 是 | 否 | 0.0 | 0 |
| BM25-RAG | 否 | 是 | 4.0 | 10.0MB |
| Hybrid-RAG | 否 | 是 | 5.7 | 54.9MB |
表1:$D_{500}$ 快照的查询就绪性、重建需求、索引构建时间和索引存储。LENS 和 ReAct 无需预建索引。
主要结果:受控评估
在 $D_{500}$ 的 500 题受控评估中,ReAct Search 取得最高答案分(65.2% EM,78.9% F1),LENS 在答案质量上接近(62.4% EM,76.9% F1),但提供了显著更强的证据定位。LENS 达到 84.8% 证据召回和 96.8% 可溯源答案,而 ReAct 仅 50.4% 和 71.8%。这分离了两个评估维度:ReAct 更频繁产出精确答案字符串,而 LENS 更可靠地定位和追踪支撑证据。
| 系统 | EM | F1 | Ev.Rec | Ground |
|---|---|---|---|---|
| ReAct Search | 65.2 | 78.9 | 50.4 | 71.8 |
| LENS | 62.4 | 76.9 | 84.8 | 96.8 |
| Hybrid-RAG | 38.4 | 51.1 | 80.8 | 92.2 |
| BM25-RAG | 28.8 | 42.3 | 71.8 | 95.8 |
| Closed-Book | 35.2 | 47.0 | 0.0 | 0.0 |
表2:$D_{500}$ 受控评估结果(%,n=500)。EM/F1 是官方答案指标;Ev.Rec 是支撑事实文档召回率;Ground 是答案可溯源率。
相对于 Closed-Book 基线,LENS 增益 27.2 个百分点 EM,ReAct 增益 30.0 个百分点。配对 McNemar 检验显示 LENS 与 ReAct 的答案质量差异在 $D_{500}$ 上不显著(p=0.1143),在 fullwiki dev-150 上也不显著(p=1.0000)。
开放域 Fullwiki 结果
在完整原始维基百科语料(15,517 个分片)上,LENS 和 ReAct 在官方答案质量上几乎持平(43.3% vs 42.7% EM),但 LENS 的答案可溯源率显著更高(84.0% vs 70.7%)。Closed-Book 达到 38.7% EM,说明 fullwiki 检索增益有限但正面:LENS +4.6 个百分点,ReAct +4.0 个百分点。
| 系统 | EM | F1 | Ev.Rec | Ground |
|---|---|---|---|---|
| LENS | 43.3 | 57.5 | 45.0 | 84.0 |
| ReAct Search | 42.7 | 57.3 | 50.4 | 70.7 |
| Closed-Book | 38.7 | 49.7 | 0.0 | 0.0 |
表3:开放域 fullwiki 结果(%,n=150,固定样本 ID)。LENS 和 ReAct 搜索原始维基百科转储,零索引。
证据召回领先性
在所有受控评估规模上,LENS 始终是最强证据定位系统。在 $D_{125}$ 上领先 ReAct 43.0 个百分点,$D_{250}$ 上领先 38.0 个百分点,$D_{500}$ 上领先 34.4 个百分点。Hybrid-RAG 也能检索到大量证据,但其答案质量远低于 LENS 和 ReAct,表明"定位候选证据"和"合成精确多跳答案"是可分离的失败模式。
语料陈旧与生命周期鲁棒性
陈旧索引臂测量当 $D_{125}$ 上构建的索引在语料扩展到 $D_{250}$ 后被复用时的表现。BM25-RAG 和 Hybrid-RAG 是索引依赖的,因此在新增问题上丧失大部分能力:EM 下降 28.0 和 28.8 个百分点,证据召回下降 70.1 和 69.6 个百分点。ReAct 和 LENS 是无索引的,可以直接查询更新后的语料——EM 变化小(+0.8 和 -2.4 个百分点),LENS 几乎保留了全部支撑事实召回(84.7% → 83.9%)。
消融研究
消融在 fullwiki 固定 150 题子集上进行。移除顺序探索产生最明显的退化:EM 从 43.3% 降到 38.0%,F1 从 57.5% 降到 50.9%,证据召回从 45.0% 降到 31.0%。移除多信号先验在这个子集上不降低 EM,但降低了 F1 并改变了成本配置。这证实了顺序探索循环是 LENS 答案质量和证据定位的主要贡献者。
局限性
第一,评估范围有限。HotpotQA 强调百科文本上的 lookup 和 comparison 查询,更丰富的文档布局、聚合意图、表格证据和暖重用行为仍是未来工作。论文作者明确承认这一点——论文的技术补编声明"HotpotQA emphasizes lookup and comparison over encyclopedic text, so richer document layouts, aggregation intents, table evidence, and warm-reuse behavior remain future work"。
第二,理论分析是分析指南而非严格保证。论文的两个命题是结构性声明:命题 1 是关于搜索域缩减的代价陈述(而非充分性陈述),命题 2 的预言机上界是控制流分析(而非预测均值)。更严格的概率预言机模型、位置级先验和重采样分析仍是未来工作。按事实更新的精确性依赖于两个假设(A1 先验独立、A2 条件独立观测),这些假设在需求逻辑耦合或 LLM 判断跨需求相关时会失效——此时按事实更新应被视为可处理的近似。
第三,先验压缩有代价。命题 1 的推论 1 指出,所有后验质量被限制在 $\mathcal{C}_{\text{search}}$ 中——如果某个事实的真实证据窗口 $Z_j^*$ 不在 $\mathcal{C}_{\text{search}}$ 中,则 $P(Z_j^* \mid f_j, q, \mathcal{H}_t) = 0$ 对所有 $t$ 成立,再多的轮预算也无法恢复。这意味着文件级压缩将 $\sim N/m$ 的节省转换为由 $\pi_{\text{file}}$ 质量决定的召回天花板。有界自校正路径部分缓解了这个问题,但这是架构层面的固有局限。
第四,LENS 的 token 消耗高于 ReAct($D_{500}$ 上 16.5K vs 11.8K tokens/query),但换来了高 34.4 个百分点的证据召回和 25.0 个百分点的可溯源率。在延迟敏感场景中,这个权衡需要重新评估。
总结与展望
LENS 的核心贡献是将 LLM agent 在动态文档集上的上下文搜索从"一次性 top-k 检索"重新定义为"有预算的顺序证据定位"。这个重新表述有三个关键含义:证据空间是潜在的而非预固化的、证据粒度是查询条件的而非预设的、搜索过程是有界的顺序推理而非单次查找。
在受控语料上,LENS 是最强的证据定位系统:在 $D_{500}$ 上 EM 落后 ReAct 2.8 个百分点,但证据召回领先 34.4 个百分点、可溯源率领先 25.0 个百分点。在 fullwiki dev-150 上,两系统在官方 EM/F1 上持平,LENS 保留更强的可溯源性。在陈旧索引臂上,索引依赖系统丢失 28.0-28.8 个百分点 EM 和几乎全部证据召回,而无索引系统保持查询就绪。
LENS 的定位不是"EM 最优的答案生成器",而是"无索引的证据定位方法,使答案更可溯源到当前原始来源"。EM 作为窄字符串匹配度量会惩罚可接受的改写和别名,也可能奖励从模型记忆而非检索证据产生的正确答案——这正是 Closed-Book 参考基线的意义所在。
未来方向包括:扩展到更丰富的文档布局和表格证据、聚合意图评估、暖重用行为研究、更严格的概率预言机模型、以及位置级先验和重采样分析。这些扩展将验证 LENS 框架在更广泛动态文档场景下的适用性。
金句
"LENS is not an EM-dominant answer generator, but an index-free evidence localization method that makes answers more traceable to current raw sources." —— 一个正确的答案如果没有可追溯的证据来源,对于需要审计的场景来说是不够的。LENS 选择了一条不同的路:牺牲一点点精确匹配分数,换取大幅提升的证据可溯源性。