PAPER DEEP DIVE
LT-Mem 精读:波动感知的时空记忆——让机器人记住「那把绿椅子都去过哪」
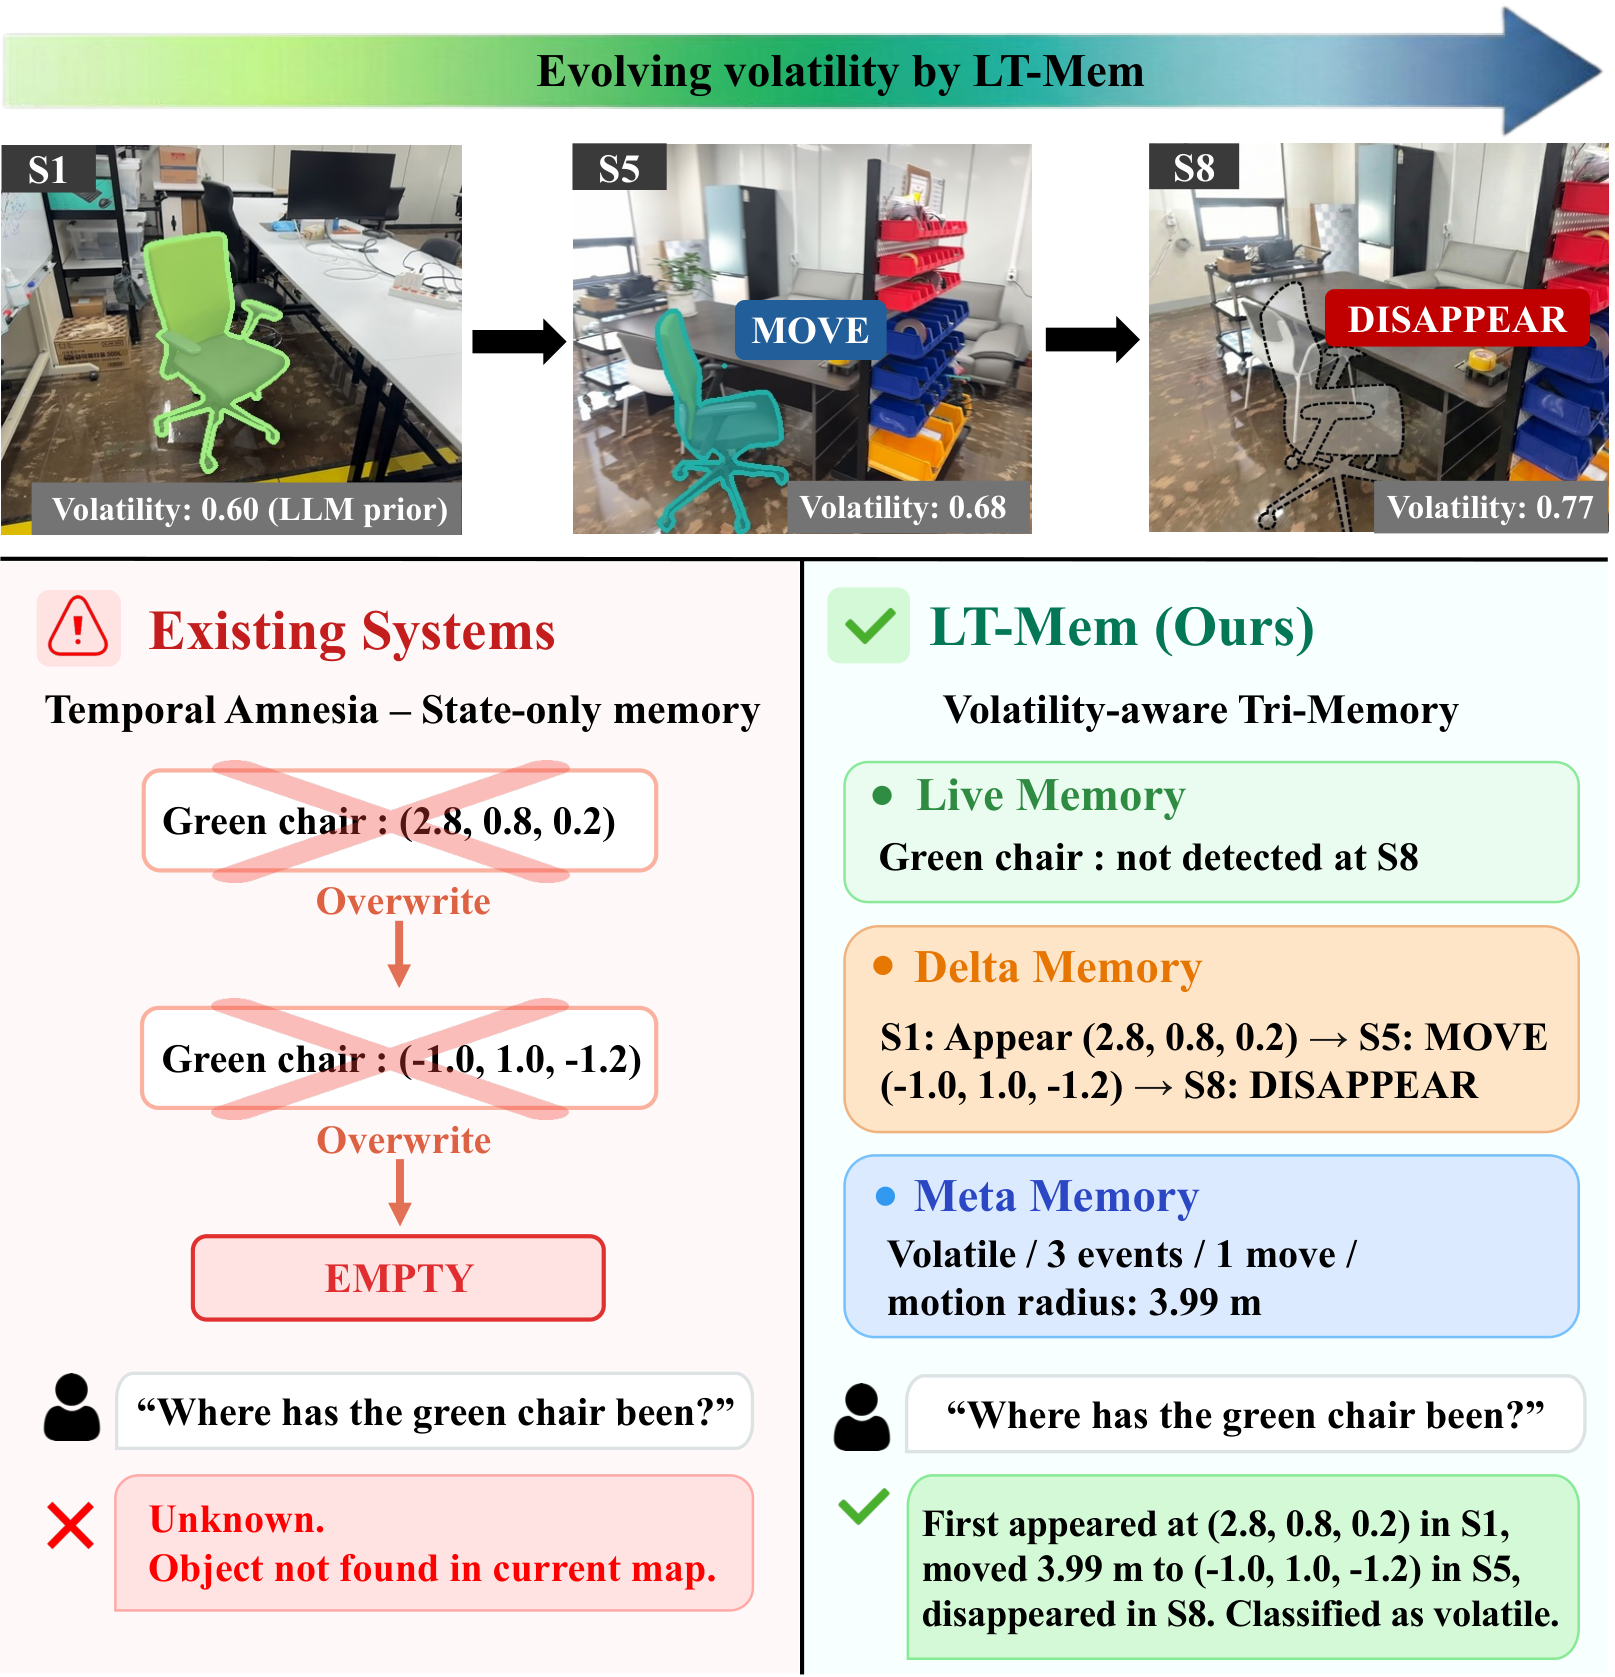
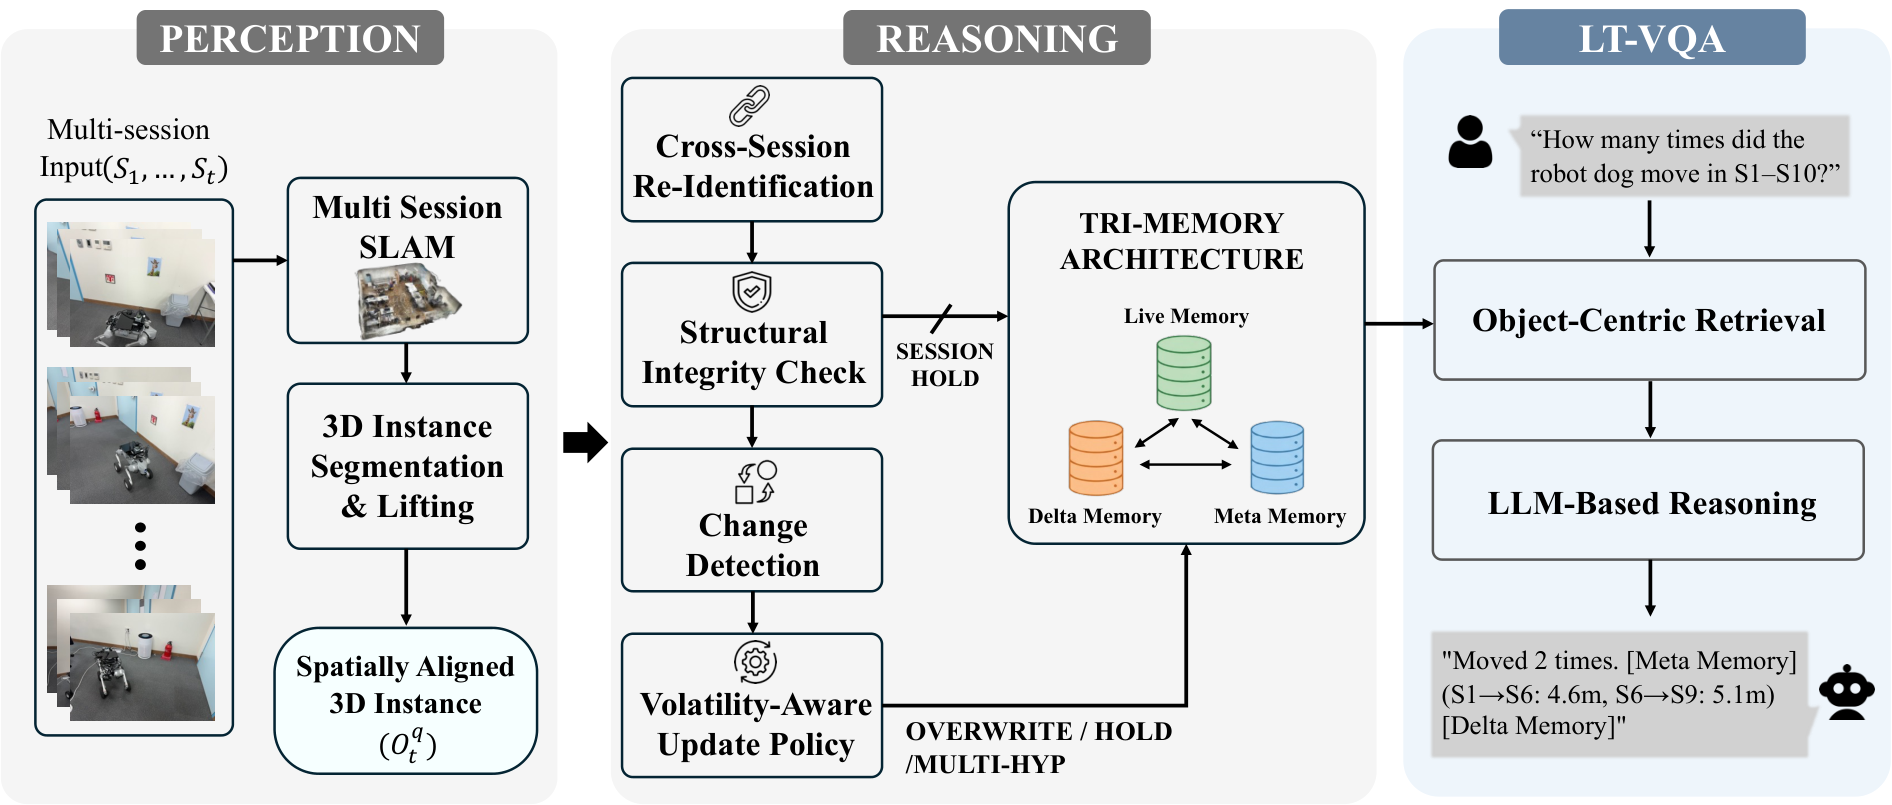
DGIST(韩国大邱科学技术院)团队,IROS 2026 接收。长期作业的机器人反复重访同一环境,现有系统要么覆写历史保最新地图、要么存语义快照却没有跨会话对象身份——作者称之为「时间性失忆」:无法回答「那把绿椅子在所有会话里都去过哪?」。LT-Mem 三层解法:① 感知层:MASt3R-SLAM 多会话对齐(Sim(3) 锚点+跨会话回环+g2o 联合优化)+SAM3 实例分割提取每个对象的质心/体积/视觉嵌入;② 推理层:五项证据评分(E1 空间接近、E2 时间连续、E3 特征相似(主信号 w=0.45)、E4 运动一致性、E5 遮挡处理)做确定性跨会话重识别,仅歧义案例交给受限 LLM 判 MATCH/NEW-TRACK/HOLD;结构完整性检查对齐失败则整会话 HOLD;波动分数 V 用贝叶斯式证据累积(Eq.2,LLM 只给一次先验),据此在 OVERWRITE/HOLD/MULTI-HYPOTHESIS 三种更新间选择;③ Tri-Memory:Live 存当前状态、Delta 记带时间戳事件日志(APPEAR/DISAPPEAR/MOVE/RE-APPEAR/NONE)、Meta 累积波动统计并反馈回更新策略。发布 LT-VQA 数据集(两个室内环境各 10 对象×10 会话+室外停车场 10 会话,61 个状态变化事件+80 组 QA)。结果:Event F1 0.910 / QA-Event 0.820 / QA-Freq 0.600 全面超 Geometric/Text-Batch/VLM-Batch/STAR 四基线,token 消耗 438K 仅为 VLM-Batch(7,114K)的 1/16、STAR(45,859K)的 1/100;换 Qwen2.5-3B 仍达 0.885,证明增益来自结构化记忆架构而非 LLM 能力。消融:去掉重识别 F1 崩至 0.140,去掉波动感知降至 0.615。停车场景景级统计还能答「什么时候去最好找车位」(8:00 AM 0 辆 vs 1:03 PM 34 辆)。
一句话导读
机器人每天在同一个环境里跑任务,物体被挪动、拿走、又放回来。现有系统要么用最新观测覆写旧状态(地图永远是"现在",历史蒸发),要么存一堆语义快照却说不清"两次看到的是不是同一把椅子"。DGIST 团队把这个问题命名为时间性失忆(temporal amnesia)——你永远无法回答"那把绿椅子在所有会话里都去过哪?"。LT-Mem(IROS 2026)用波动感知的记忆演化框架解决它:感知层提供空间对齐的对象观测,推理层决定"何时、如何"更新记忆,Tri-Memory 结构让当前状态与全部历史并存。
Sim(3) 锚点 + 跨会话回环 + g2o"] B --> C["SAM3 实例分割 + 3D 提升
质心 / 体积 / 视觉嵌入"] C --> D{"推理层"} D --> E["跨会话重识别
五项证据评分 E1-E5
歧义时受限 LLM 裁决"] D --> F["结构完整性检查
锚点位移 > 0.3m → 整会话 HOLD"] D --> G["变化检测
APPEAR / DISAPPEAR / MOVE
RE-APPEAR / NONE"] E --> H["波动分数 V 贝叶斯累积
(Eq.2,LLM 只给一次先验)"] G --> H H --> I["更新策略
OVERWRITE / HOLD / MULTI-HYP"] I --> J["Live Memory
当前确认状态"] I --> K["Delta Memory
带时间戳事件日志"] I --> L["Meta Memory
波动统计 → 反馈回策略"] J & K & L --> M["对象中心检索
→ 长时程时序问答"]
问题定义:机器人也需要"记性好"
论文的出发点非常具体:机器人会反复重访演化的环境。物体在会话间可能移动、消失,也可能因为遮挡和对齐噪声被不一致地观测。多会话 SLAM 能给出统一的空间坐标,但空间一致不等于记忆有效——"Session 3 机器狗在白桌旁,Session 9 它在哪?"这类会话索引查询需要持久跨会话身份 + 显式状态转移建模,现有系统都不为此设计。
作者把对象级事件分成一个完整分类学(Table I):
| 事件 | 定义 | 典型查询 | 所需记忆 |
|---|---|---|---|
| APPEAR | 会话 $S_t$ 首次观测到 | "剪刀最早什么时候出现?" | Delta |
| DISAPPEAR | $S_t$ 之后不再检测到 | "Session 9 吸尘器还在房间里吗?" | Delta |
| MOVE | 质心位移超阈值 | "Session 6 棕色篮子动了吗?" | Delta |
| NONE | 状态无变化 | "Session 4 冰箱还在原位吗?" | Delta |
| RE-APPEAR | 消失后重新出现 | "Session 9 绿椅子回来了吗?" | Delta |
| 轨迹(复合) | 跨所有会话的转移序列 | "蓝色手提袋都去过哪?" | Delta+Meta+Live |
| 波动性(复合) | 变化的频率与幅度 | "哪个对象移动最频繁?" | Meta |
| 时间定位(复合) | 何时发生了变化 | "白板最后一次挪动是什么时候?" | Delta |
| 反事实(复合) | 比较两个会话的状态 | "机器狗在 S1 和 S10 位置一样吗?" | Delta+Live |
这张表的价值在于把"记忆要支持什么查询"提前讲清楚——每种查询都对应明确的记忆组件,任何组件被压扁成单一地图,对应的查询类型就结构性不可答。
两条路线的困境
几何中心的长期建图(LT-mapper、Khronos 等)在变化中维持全局一致性,但把对象转移简化成"删除 + 重建",时间历史全部丢失。即使在概率式方法里,对象从 A 挪到 B,旧状态也是被覆写或删除而非记录为轨迹的一部分——这就是"时间性失忆"的机制。
语义记忆路线(ReMEmbR 的视图级嵌入、ConceptGraphs 的开放词汇 3D 场景图、3D-Mem 等)表征很丰富,但通常依赖最新观测或把各会话独立处理,不强制跨会话持久身份:两次看到的"椅子"未必是同一把。即使引入长时程上下文,重处理累积的历史视频流在算力上也撑不起长期部署。
LT-Mem 的定位是桥接:DUSt3R/MASt3R 提供了免训练的度量级多视图几何,SAM3 提供了跨环境的实例分割——感知精度上去了,但"覆写还是累积"的更新两难依然存在。LT-Mem 的答案是:把空间落地的对象实例和一个波动条件化的推理层耦合起来。
感知层:多会话对齐 + 实例提升
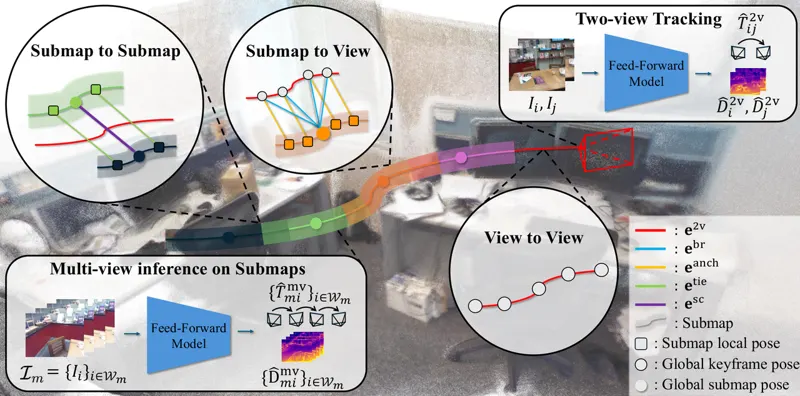
LT-Mem 扩展 MASt3R-SLAM 做多会话对齐。每个会话 $S_t$ 在会话局部坐标系里维护关键帧位姿 $X_i^t \in \mathrm{Sim}(3)$,一个锚点节点 $A^t \in \mathrm{Sim}(3)$ 把局部系映射到全局系,世界系位姿 $T_i^t = A^t \cdot X_i^t$。尺度由 MR.ScaleMaster 机制估计(Sim(3) 锚点节点);跨会话回环用 MASt3R 匹配跨会话关键帧图像、经基于射线的几何优化计算相对 Sim(3) 约束;包含会话内里程计边与跨会话回环边的因子图用 g2o 联合优化,得到全局一致的轨迹。
对齐完成后,对每个关键帧用 SAM3 以文本 prompt 得到 2D 实例掩码,依托全局一致的位姿与稠密点图把掩码区域投影到全局系,得到每实例 3D 点,从中计算质心 $c_t^q$、体积 $v_t^q$ 和视觉嵌入 $f_t^q$;会话内同一实例的碎片检测用空间一致性与点云聚类合并,最终每个对象每会话 consolid 成一个观测 $o_t^q = (c_t^q, v_t^q, f_t^q)$。
这一层看似常规,实则提供了推理层的全部前提:所有会话的对象质心在同一全局坐标系里可直接比较,位移、消失等状态转移才能被几何地检测出来。
推理层:证据、检查、波动、策略
跨会话重识别:确定性优先,LLM 兜底
重访环境时,仅靠几何邻近不足以保住身份。LT-Mem 计算五个归一化证据分数,加权和为重识别置信度:
| 证据 | 线索 | 作用 |
|---|---|---|
| E1 | 空间邻近 | 弱先验;避免惩罚大位移 |
| E2 | 时间连续 | 跨相邻会话的稳定线索 |
| E3 | 特征相似 | 主信号(权重 0.45),对视角变化鲁棒 |
| E4 | 运动一致性 | 以波动估计为条件 |
| E5 | 遮挡处理 | 抑制假消失 |
实验权重为 $w_1{=}0.05, w_2{=}0.20, w_3{=}0.45, w_4{=}0.15, w_5{=}0.15$。为缩小搜索空间,先用持久向量库(BGE-small-en-v1.5 + ChromaDB,检索不调 LLM)做嵌入检索取 top-5 候选。最终关联走混合策略:简单情形(首次观测、类别不匹配)由确定性硬规则解决;歧义的跨会话情形交给受限 LLM 裁决,输出空间严格约束在 MATCH / NEW-TRACK / HOLD 三个 token。LLM 不修改证据分数,只在预计算的结构化输入上做最终消歧。
结构完整性检查:别让烂对齐污染记忆
更新记忆前,用结构锚点验证全局对齐质量:当前会话观测到的锚点质心与其在 Live Memory 中登记位置比较,平均锚点位移 $\bar{d}_{anchor}$ 超过阈值 $\tau_{align}=0.3$ m 就触发 SESSION HOLD——该会话全部更新被跳过,并记录对齐失败事件。即使更新被抑制,失败事件本身也进日志,审计链完整。实验中所有会话都通过了门控(多会话 SLAM 的对齐精度足够),但这个机制保证了最坏情况下错误不会传播。
波动分数:贝叶斯式证据累积
核心变量是波动分数 $V_t \in [0,1]$,按归一化证据累积更新:
$$V_t = \frac{P(E_t|V_{t-1})\,V_{t-1}}{P(E_t|V_{t-1})\,V_{t-1} + P(E_t|1-V_{t-1})(1-V_{t-1})}$$
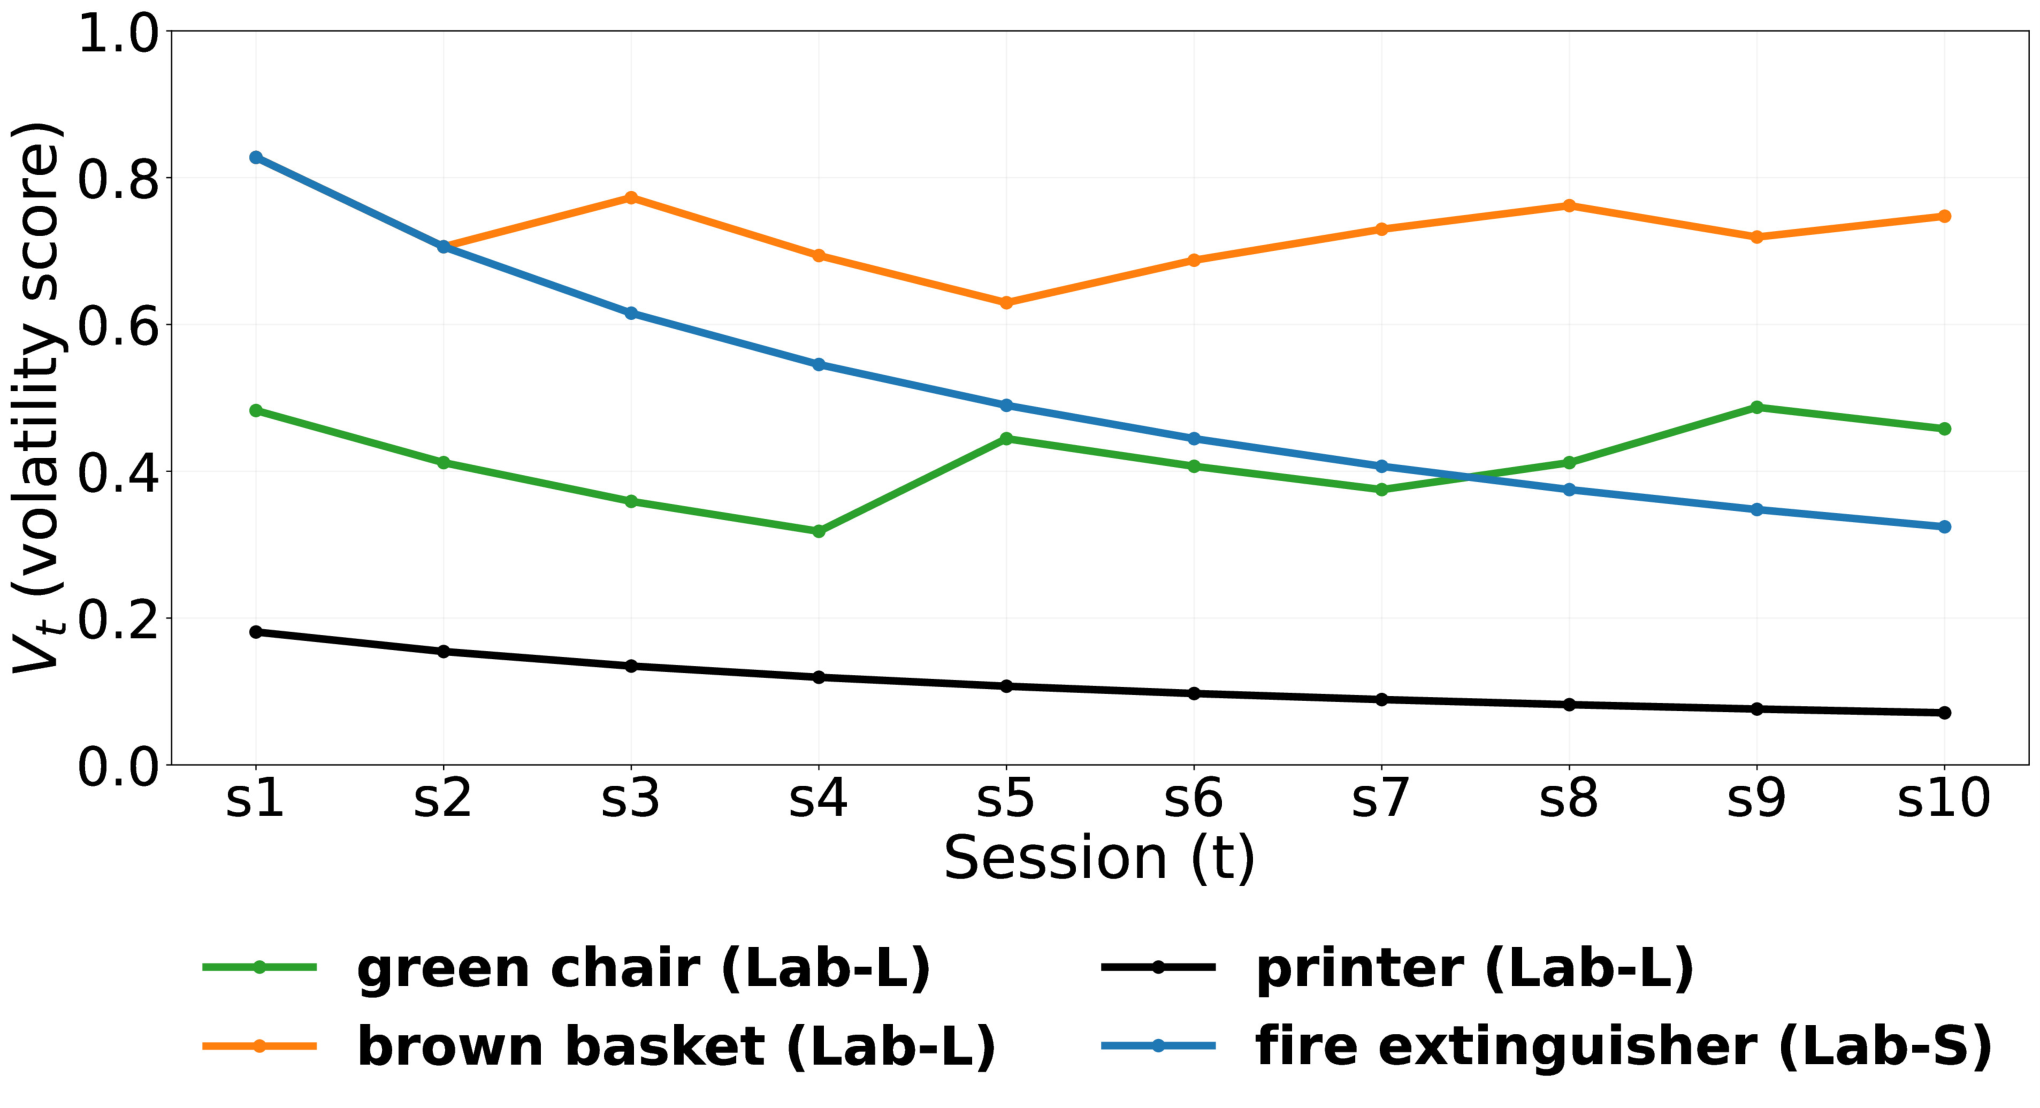
其中 $E_t \in \{\mathrm{NONE}, \mathrm{MOVE}, \mathrm{APPEAR}, \mathrm{DISAPPEAR}, \mathrm{RE\text{-}APPEAR}\}$ 被建模为 $V$ 的固定单调函数(如 $P(\mathrm{MOVE}|V)$ 随 $V$ 递增)。这是一个轻量的时序证据累积器,不是学出来的。初始先验 $V_0$ 由一次 LLM 查询获得(条件是对象的语义标签——"椅子"大概率先验高于"打印机")。
关键观察在图 5 的四条曲线:棕色篮子持续高波动;灭火器的初始先验被高估、几个会话内被逐步修正;绿椅子中段波动后部分回落;打印机全程收敛到近零。即使 LLM 先验与实际动态不符,$V_t$ 也在几个会话内经贝叶斯更新收敛——不需要逐对象调参。这很重要,因为波动性不是类级固定属性:同一类对象在不同环境的使用方式不同。
确定性更新策略
给定变化决策与波动估计,确定性策略三选一:
- HOLD:低置信或遮挡时保留旧状态;
- OVERWRITE:提交新状态;
- MULTI-HYPOTHESIS:保留多个带置信度的位置假设,当某假设连续若干会话以边际 $\Delta$ 超过竞争者时晋升,一致证据积累后竞争假设被合并。
变化检测不是单一阈值,而是优先级排序的确定性规则集:对齐质量 → 缺失证据信号(旧位置消失)→ 波动条件化的运动容差。高波动对象天然获得更大的运动容差,不会被"挪了一点"误判成消失+重现。
Tri-Memory:不是独立发明,是自然产物
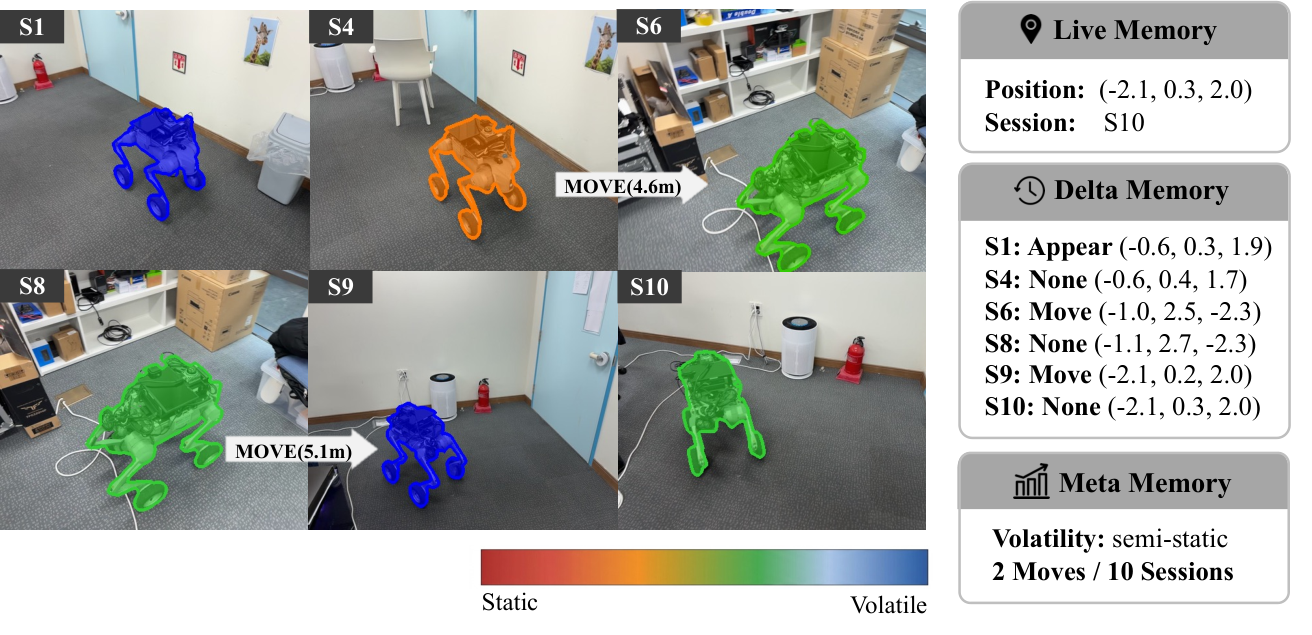
作者很诚实:Tri-Memory 不作为独立架构贡献提出——它是波动感知推理层的直接后果。推理层产出三类异质输出:当前状态估计、带时间戳的事件记录、长期统计。三者无法压进单一地图表示,否则又回到时间性失忆。
- Live Memory:每对象当前确认状态。OVERWRITE 时替换旧状态;MULTI-HYPOTHESIS 时维护带置信度的假设集合。"白椅子现在在哪?"直接从这里答。
- Delta Memory:带时间戳的逐对象事件日志。每次更新追加结构化条目:MOVE / APPEAR / DISAPPEAR / RE-APPEAR / NONE,含会话索引与度量上下文(位移量)。对齐失败事件也记录。"剪刀最早什么时候出现?"、"机器狗在 S1 和 S10 位置一样吗?"靠遍历这份日志回答。
- Meta Memory:从事件日志累积长期统计——波动分数 $V_t$、每对象变化频率。统计反馈回推理层:$V_t$ 条件化后续会话的运动容差,形成观测↔策略的闭环。"哪个对象移动最频繁?"从这里做确定性计算。
作者还辨析了术语沿革:终身建图文献里 delta/meta map 指几何点云差分与地图级统计(LT-mapper);LT-Mem 的 Delta/Meta Memory 则工作在对象-语义层——Delta 记录"某把具体的椅子在 S5 从 A 挪到 B"这种身份保持的转移,Meta 累积每对象的行为统计。从点级图差分到对象级事件日志的迁移,正是结构化时序查询得以成立的原因。
查询时,对象中心检索模块按查询类型路由到相应记忆组件(Table I);位移、频率等度量查询通过对事件日志的确定性计算回答,响应数值有据、独立于 LLM 幻觉。代表性的问答分组示例:
| 记忆组件 | 问题 → 回答 |
|---|---|
| Delta | "剪刀最早什么时候出现?" → "Session 3。" |
| Delta | "机器狗 Session 6 发生了什么?" → "从 $(-0.81,0.43,1.77)$ 移动到 $(-0.97,2.52,-2.27)$。" |
| Live | "所有会话结束后垃圾桶在哪?" → "S10 时位于 $(-0.65,0.52,1.49)$。" |
| Meta | "能用打印机当导航路标吗?" → "可以。波动 0.02,高度稳定,用 S1 的位置 $(-1.75,0.28,0.50)$ 作参考。" |
| Meta | "哪个对象移动最频繁?" → "棕色篮子(4 次)。" |
LT-VQA 数据集:为"长期"专门造基准
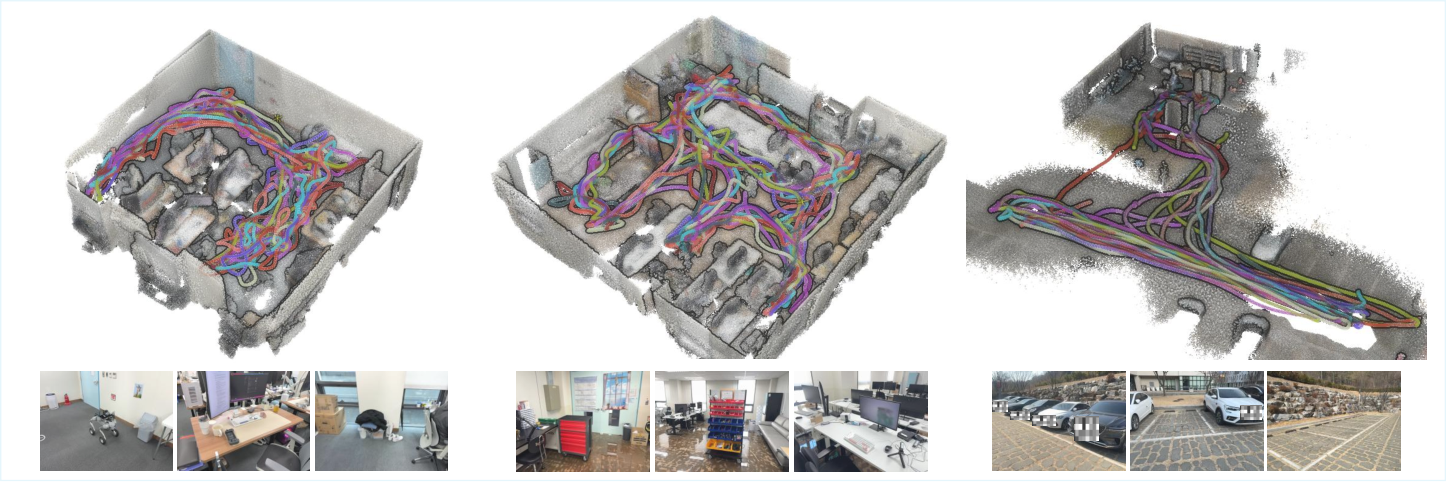
现有数据集都不合用:3RScan 有跨重扫描的实例对应但缺事件级标注与时序 QA 监督;NaVQA 这类是单会话 QA。LT-VQA 联合提供四件东西:全局对齐的多会话几何、持久对象实例身份、事件级状态转移标注、会话索引的时序 QA 对。作者指出跨会话事件标注需要对每个对象做精细的多时相对齐,密集标注本质上资源密集——这也是此前没有此类数据集的原因。
| 环境 | 任务类型 | 会话数 | 每会话帧数 | 每会话时长 |
|---|---|---|---|---|
| Lab-S(紧凑室内,10 对象) | 实例历史 | 10 | 116–159 | 1.6–2.1 min |
| Lab-L(更大室内) | 实例历史 | 10 | 115–183 | 2.6–3.3 min |
| 停车场(室外) | 空间统计 | 10 | 124–195 | 2.2–3.2 min |
对象覆盖高波动实例(棕色篮子、剪刀)到完全静止的(冰箱、沙发)。标注统计:两个室内环境共 61 个状态变化事件(NONE 除外)、80 组 QA。采集为单目 RGB 视频(iPhone 15/17 Pro),全程 RTX 5070 Ti + 64GB RAM,LLM 组件统一用 Gemini 2.5 Pro 保证公平对比。
实验:全面领先 + 两个数量级的 token 优势
指标与基线
实例历史跟踪报三个指标:Event F1(把每个真值事件当正例)、QA-Event(事件历史自然语言查询的精确匹配准确率)、QA-Freq(频率查询对 Meta Memory 累积统计的准确率),QA 均以结构化 JSON 输出与标注比对。基线设计刻意"隔离推理范式"而非改造现有系统(Khronos/ConceptGraphs/ReMEmbR 不产对象级事件日志,硬加模块超出了原设计范围):
- Geometric Only:几何中心终身建图范式,距离阈值检测变化;无事件日志,历史/频率查询结构性不可答(N/A)。
- Text-Batch:每关键帧独立打 caption 聚合成会话摘要,比较相邻摘要推事件;无身份无空间落地。
- VLM-Batch:每对象全部关键帧打包单次查询;有全部视觉上下文但纯靠 VLM 隐式推理。
- STAR:最新的记忆-动作智能体检索系统,禁用其具身导航动作后直接在 LT-VQA 上运行。
主结果
| 方法 | Event F1↑ | QA-Event↑ | QA-Freq↑ | Tokens↓ |
|---|---|---|---|---|
| Geometric Only | 0.630 | N/A | N/A | – |
| Text-Batch | 0.460 | 0.300 | 0.267 | 3,973K |
| VLM-Batch | 0.790 | 0.680 | 0.333 | 7,114K |
| STAR† | 0.420 | 0.460 | N/A | 45,859K |
| Ours (Qwen2.5-3B) | 0.885 | 0.800 | 0.567 | 352K |
| Ours (Gemini 2.5) | 0.910 | 0.820 | 0.600 | 438K |
†STAR 输出自由文本,QA-Event 用关键词匹配评分;其余方法均为严格精确匹配。几个值得咀嚼的点:
- STAR 拿了最高 token(45,859K)却得最低 Event F1(0.420):没有持久身份和事件日志,逐查询检索原始记录无法组成连贯的对象历史,频率类需要结构化计数的查询直接不可答。
- VLM-Batch 证明"上下文长度买不来结构":每对象全帧打包、视觉上下文最全,成绩不俗(0.790/0.680)但 token 是 LT-Mem 的 16 倍。
- 换 Qwen2.5-3B 仍达 0.885/0.800/0.567:增益来自结构化记忆架构而非 LLM 能力——这是全文最重要的结论,消融进一步佐证。
- token 成本与帧数无关:感知是离线一次性的,推理层只吃紧凑文本输入;每会话 token 预算独立于帧数,会话越长优势越大。
空间统计:记忆的"降维打击"用法
停车场序列(10 个会话、不同日期与时段)评估聚合场景级模式。Meta Memory 聚合每会话车辆数后,"想找车位该什么时候来?"、"什么时候最难停车?"这类问题通过确定性查表回答:Session 3(8:00 AM)0 辆车最好停;Session 8(1:03 PM)34 辆最难。不额外推理,数值来自存储的统计。
消融:身份是地基,波动是精度
| 配置 | Event F1 | QA-Event | QA-Freq |
|---|---|---|---|
| w/o Re-ID(每次观测独立成轨) | 0.140 | 0.120 | 0.070 |
| w/o Volatility(固定阈值) | 0.615 | 0.640 | 0.130 |
| Full | 0.910 | 0.820 | 0.600 |
去掉跨会话重识别则近乎全崩——持久身份是所有下游时序推理的地基,没有它 Delta Memory 记不了身份保持的转移、Meta Memory 失去统计连续性。固定阈值替换波动条件化更新则全指标下滑:阈值无法适配逐对象动态,产生假事件污染 Meta Memory 统计。
局限与展望
作者坦承三点:LT-VQA 目前只有两个室内一个室外环境、各 10 会话,泛化性需更广验证;当多对象外观相似且空间上下文接近时跨会话重识别仍然困难——身份保持本来就是歧义下的根本难题;扩展到更长部署周期与更多环境、把 LT-VQA 打造成纵向对象中心推理的公共基准是后续方向。
为什么这篇值得机器人从业者细读
- 它把"长期自主"从地图问题重新定义为记忆问题:空间一致只是必要条件,"何时/如何更新对象状态"才是核心,而答案必须按对象动态自适应。
- LLM 用得极其节制:一次先验 + 歧义裁决 + 回答组织,所有数值结论都来自确定性计算——这在"token 成本 = 1/100"的成绩里直接兑现。
- 消融设计有说服力:Qwen2.5-3B 与 Gemini 双跑证明架构增益;w/o Re-ID 的崩塌定量给出了"身份 > 一切"的优先级。
- 对做 SLAM/场景图/具身记忆的团队,LT-VQA 提供了一个此前缺失的、带事件级标注的纵向基准。
项目页:lt-mem.github.io
参考资料
- 论文:arXiv:2608.19059 — LT-Mem: Volatility-Aware Spatio-Temporal Memory for Lifelong Scene Understanding(IROS 2026)
- 相关系统:Khronos(RSS 2024)、LT-mapper(ICRA 2022)、ReMEmbR(ICRA 2025)、ConceptGraphs(ICRA 2024)、MASt3R-SLAM(CVPR 2025)、SAM 3(arXiv:2511.16719)、STAR(ICRA 2026)
- 数据:LT-VQA(项目页 lt-mem.github.io)