PAPER DEEP DIVE
Show-Harness:仅凭一个 VLM 智能体就能「玩」机器人
基础视觉语言模型(VLM)对世界已有广泛认知,但把这种认知转成机器人控制仍然困难。我们提出 Show-Harness——一套「具身 harness」,通过连接意图与动作的紧凑语义接口,让 VLM 直接「玩」机器人。Show-Harness 对外暴露 VLM 天然可推理的离散语义动作单元,再由机体专属的解释器把它们确定性地接地为局部机器人动作,使 VLM 始终对细粒度物理决策负责。基于同一接口,我们验证了两条路径:(1)直接解锁闭源前沿 VLM 实现零样本机器人控制;(2)只需几 GPU 小时微调,即可把小规模开源 VLM 适配为低成本部署的策略。我们进一步做出 GUMI(GUI 操作界面),把同一语义动作空间延伸到基于 GUI 的演示采集,让人类与智能体无需专用遥操作硬件即可跨机体「玩」机器人。大量实验表明,装配 Show-Harness 的 VLM 智能体在任务、机体与环境之间稳健泛化,优于代表性的 agentic 与 VLA 范式。这些结果说明:合适的接口本身就能从基础 VLM 中释放大量具身能力,无需额外的模型容量,也无需昂贵的机体专属预训练。
论文元信息
- 标题:Show-Harness: Just a VLM Agent Can Play Robots
- 作者:Yanzhe Chen、Zechen Bai、Zhijun Cao、Wenzheng Zeng、Kevin Qinghong Lin、Yiqi Lin、Guoqiang Liang、Kevin Yuchen Ma、Qiming Huang、Mike Zheng Shou(新加坡国立大学 Show Lab,前四位为共同一作)
- 论文链接:arxiv.org/abs/2609.10522 | 项目主页 showlab.github.io/Show-Harness
- 代码状态:已开源,仓库 github.com/showlab/Show-Harness 公开了 harness 主体、GUMI 采集器、全部插件与训练管线;六个 LoRA 适配器发布在 HuggingFace 的 showlab/Show-Harness-VLMs,演示语料发布在 showlab/Show-Harness-Data
一句话总结
把机器人控制改写成一套视觉语言模型天然读得懂的离散语义动作单元,再由每个机体专属的确定性解释器把符号落成有界的笛卡尔运动,于是闭源前沿模型可以零样本直接"玩"机器人,2B 级开源小模型也只需几 GPU 小时微调就能上岗。
研究背景与动机
基础视觉语言模型其实已经编码了机器人操作所需的大部分知识:认物体、判空间关系、把长程目标拆成步骤。问题在于这些知识很难直接变成机器人行为。视觉-语言-动作模型(VLA)选择把 VLM 往低层控制上拉:微调它去回归某个机体专属的连续动作,代价是宽泛的语义知识被压成一个从像素到执行的不透明映射,换一个任务族、换一个环境、换一个机体往往就要重新适配一轮。
层级式与程序化系统走相反的路:VLM 留在上层,输出子任务级调用,或者在人工设计的控制 API 上写程序。这条路保住了语义,却把物理交给了下游控制器与系统专属的接地管线——模型只说"要做什么",看不到"怎么做",语义意图与物理执行之间的直接联系被中介层削弱了。
作者的判断是:缺的不是更强的模型,而是一个合适的接口。这个接口要满足两个看似矛盾的要求——对 VLM 而言语义充分、可以直接推理;对物理控制而言又足够细粒度,让模型的每一步决策都真实落在末端执行器的运动上。Show-Harness 就是围绕这个接口搭建的"具身 harness":模型在感知、推理、动作的闭环里逐步骤地为物理决策负责,而不是把决策权外包给一个不透明的执行器。
这个思路在数字世界里早有先例。计算机使用代理与游戏代理通过鼠标、键盘、手柄这类紧凑且人机共用的接口行动;导航领域的离散方向原语更是模拟器与基准的原生语言。真实操作却一直没有可比的接口:控制是机体专属的、高维的、需要毫米级空间精度的。Show-Harness 要补的正是这一块:把细粒度语义动作确定性地接地到真实机器人运动,同时把同一套动作空间开放给 VLM 代理与人类。
接口一旦人机共用,数据采集的形态也随之改变。作者进一步做出 GUMI:一个基于网页 GUI 的操作界面,人类用键盘、计算机使用代理用浏览器、VLM 代理直接预测动作单元,三方在同一语义空间里采集演示,不需要任何专用遥操作硬件。这使"接口设计"从方法细节上升为贯穿控制、适配与数据三条线的主线。
预备知识
具身 harness 与 agentic 系统。所谓 harness,是包在基础模型外面的一层运行框架:它组织观测、维护记忆、把模型决策翻译成机器人行为、再把执行结果反馈回去,从而闭合感知-决策-执行回路。既有系统的差别主要在"决策如何被执行":组合 API 程序、从技能库选技能、用语言子目标指挥 VLA、或交给符号规划器与数值优化器。Show-Harness 的立场是:harness 不该替模型做物理决策,而该把"怎么做"本身以透明、确定的方式暴露给模型。
动作表示的光谱。低层一端是连续动作块(回归、扩散、流匹配)、离散电机 token、任务空间关键帧与从轨迹中学出的潜动作码;高层一端是子目标、关键点、可供性目标与空间约束。Show-Harness 的语义动作单元落在两者之间:它是离散符号,但每个符号对应一次小幅、有界、可观测的物理变化,因此既保留语义可读性,又保留闭环控制所需的粒度。
笛卡尔位姿与增量运动。解释器内部维护一个 6 自由度位姿设定点 $s_{t}=(\mathbf{x}_{t},Q_{t})$,其中 $\mathbf{x}_{t}\in\mathbb{R}^{3}$ 是位置、$Q_{t}\in\mathrm{SO}(3)$ 是姿态。旋转增量用指数映射 $\exp(\theta[\cdot]_{\times})$ 表示,$[\cdot]_{\times}$ 是斜对称矩阵算子;这套记法让"绕某轴转 15 度"可以写成一次干净的左乘更新,也便于叠加工作空间投影与安全限位。
方法详解
闭环总览。给定语言指令 $\ell$,系统在第 $t$ 步采集观测 $o_{t}=(\mathcal{I}_{t},p_{t})$,$\mathcal{I}_{t}$ 是多视角图像、$p_{t}$ 是本体感知状态。当前观测与一段紧凑的交互历史 $h_{t}$ 先经过一组可配置的推理插件 $\mathcal{P}$,得到推理精炼后的上下文
$$c_{t}=\Phi_{\mathcal{P}}\!\left(\ell,\,o_{t},\,h_{t}\right) \tag{1}$$
中心 VLM 在该上下文上选出语义动作
$$a_{t}=\pi(c_{t})\in\mathcal{A} \tag{2}$$
其中 $\mathcal{A}$ 就是整套语义接口。随后机体专属、与模型无关的解释器把语义决策确定性地接地为可执行控制
$$u_{t}=g_{E}(a_{t};\,s_{t}) \tag{3}$$
$E$ 是机体、$s_{t}$ 是解释器内部的设定点状态。执行 $u_{t}$ 后机器人与环境更新,新的观测与执行状态回流到下一步。整条链路里模型始终面对符号,物理始终由确定性代码负责,两者之间没有需要学习的黑箱。
语义动作空间。共享动作空间 $\mathcal{A}$ 由少量语义动作单元构成。每一步系统先从当前观测中确定一个参考视角,用以定义末端运动方向:相对该视角,MV_FWD 与 MV_BACK、MV_LEFT 与 MV_RIGHT、MV_UP 与 MV_DOWN 让末端沿对应方向走一步;需要重定向时,ROTATE_CW 与 ROTATE_CCW 各配一个指定轴(x、y 或 z),让末端绕该轴增量旋转;GRASP 与 RELEASE 闭合和张开夹爪;DONE 宣告任务结束。词表围绕三条性质设计:增量性,每个单元只引起小幅局部物理变化,模型因此始终"在场",可以靠连续修正逼近精确行为,实验也证实 VLM 无需微调就能在不同步长粒度间切换;可解释且与机体无关,动作是语义符号而非数值目标,机体专属的低层控制全部下放给解释器;视觉可接地,运动方向相对可观测视角定义,空间推理可以直接映射到动作上。
确定性解释器。语义决策 $a_{t}$ 进入解释器 $g_{E}$ 后,位姿设定点按下式更新
$$s_{t+1}=\Pi_{E}\!\left(\mathbf{x}_{t}+\sigma_{t}R_{E}d_{a},\;\exp\!\left(\theta_{t}[R_{E}r_{a}]_{\times}\right)Q_{t}\right) \tag{4}$$
$d_{a}$ 与 $r_{a}$ 分别编码平移与旋转:旋转时 $d_{a}=0$,平移时 $r_{a}=0$,否则 $r_{a}$ 取三个坐标轴的正负单位向量之一。标定好的增量 $\sigma_{t}$ 与 $\theta_{t}$ 决定平移与旋转幅度(默认细步 2 厘米、粗步 4 厘米,旋转每单元 15 度),$R_{E}$ 把语义方向与轴映射到机体 $E$ 的运动坐标系,投影 $\Pi_{E}$ 强制机体专属的工作空间与单步限位。夹爪单元绕过位姿更新,直接映射为开或合。不同机体用不同低层控制器实现同一组语义单元:Franka 用阻抗控制跟踪笛卡尔设定点,AgileX 用逆运动学加流式关节目标,仿真环境执行对应的操作空间指令。安全边界(工作空间、桌面高度下限)在解释器内配置,越界动作在执行前就被拦下。换机体因此只需要写一个新解释器,模型侧接口一字不改。
感知阶段插件。Multi-View Guidance 告诉模型各相机视角的角色与优先级:全局的外心或内心视角给场景级上下文,腕部视角提供细粒度对齐与操作的近距证据。Proprioception 把机器人内部状态翻译成简洁文本反馈:当前夹爪高度、一个动作步引起的位移、分阶段的执行提示(例如位置还高时应先下降)、接触状态与夹爪开合状态。
推理阶段插件。Subtask Planning 先让 VLM 以规划者身份把指令 $\ell$ 分解为带完成判据的有序子任务;执行中子任务的推进权在模型手里:每一步对照当前图像检查判据,未满足就继续动作,满足就声明完成并前进。Situated Planning 处理条件分支:初始计划把不确定的决策留空,等证据在执行中变得可观测时再解析分支并更新剩余计划,避免每步都重规划。Action Chunking 在细粒度反馈还不必要时(目标尚远)降低模型调用频率,让 VLM 一次输出一小段语义动作开环执行。Adaptive Step 按目标可见性动态调步长:目标在腕部视角里可见用 2 厘米细步,否则用 4 厘米粗步。Visual Prompt 用一次专门的模型调用把含糊的语言目标转成一个高亮相关可供性的视觉参考,供后续推理接地,仅在交互区域难以用语言描述时启用。
动作阶段插件。Action History 把最近若干动作(默认 5 条)作为轻量上下文带入下一步,并附带"避免在相反动作间振荡"之类的简单使用指引,为闭环提供时间记忆。Failure Recovery 自动检测抓取失败:空抓被识别后重置夹爪状态并回滚到相应抓取子任务重试,避免模型举着一只空夹爪继续搬运。
flowchart TD
  L["语言指令 task"] --> P["感知 Perception
Multi-View Guidance
Proprioception 文本化"]
  P --> R["推理插件 Reasoning
Subtask 与 Situated Planning
Action Chunking / Adaptive Step
Visual Prompt"]
  R --> C["推理精炼上下文 c_t"]
  C --> V["中心 VLM 决策
a_t = pi(c_t)"]
  V --> A["语义动作单元
MV_* / ROTATE_*
GRASP / RELEASE / DONE"]
  A --> I["机体解释器 g_E
位姿 setpoint 增量更新
工作空间投影与安全限位"]
  I --> X["机器人执行
Franka 阻抗控制
AgileX 逆运动学
仿真操作空间指令"]
  X --> M["动作阶段插件
Action History
Failure Recovery 空抓回滚"]
  M --> P
  A --> G["GUMI 网页界面
人类键盘 / computer-use 代理
同一语义空间采集演示"]
模式一:前沿 VLM 零样本代理。同一个 harness 不做任何微调就能让闭源前沿 VLM 直接控制机器人。默认后端是 Gemini-3.1 Pro,推理时思考预算分 low、medium、high 三档,默认 medium。这条路径的意义在于可扩展性:基础模型每进步一代,物理控制能力随之继承,无需重新训练机器人策略。
模式二:小模型轻量微调。同一接口也支持把小型开源 VLM 直接训练成策略。给定在共享动作空间里采集的演示 $\mathcal{D}$,策略最小化目标单元的 token 级交叉熵
$$\mathcal{L}(\theta)=-\!\!\sum_{(\ell,\,o,\,h,\,a)\,\in\,\mathcal{D}}\!\!\log\pi_{\theta}\!\left(a\mid\Phi_{\mathcal{P}_{\mathrm{min}}}(\ell,\,o,\,h)\right) \tag{5}$$
$\mathcal{P}_{\mathrm{min}}$ 刻意只保留最小决策上下文(指令、多视角观测、短动作历史),以便做受控对比。关键在于语义动作通过 VLM 的原生词表预测:不加动作头、不加特殊 token,因此 rank-64 LoRA 只挂在语言模型的线性层上、冻结视觉编码器与多模态投影器,更新参数约 3%,在 7.9K 单臂样本上训 40 个 epoch(学习率 1e-4、余弦调度、warmup 0.1、bf16、256×256 视角、有效批 32),单张 H200 不到 2 小时,24GB 级显卡即可承担。默认骨干是 Qwen3.5-2B。
GUMI:人机共用的采集界面。语义动作空间离散且可直接操作,因此可以自然地暴露成一个轻量网页 GUI:每个单元对应一个带标签的控件与按键。人类用键盘"玩"机器人,计算机使用代理操作同一个 GUI,通用 VLM 代理直接预测单元。每一步 GUMI 记录执行前观测与所选语义动作,得到策略可直接消费的 $(o_{t},a_{t})$ 对;由于每个语义单元都被解释器确定性地接地,rollout 还能同时保留对应的低层指令与轨迹,一份演示既能训语义动作策略、也能训连续控制策略。GUMI 支持逐步控制、排队动作块、单臂与双臂、以及人机混合采集(人类可随时介入纠正代理的 rollout)。与依赖专用硬件或仿真专属控件的传统遥操作管线不同,它直接在共享语义空间记录演示,因此同一批演示可在实现相同单元的不同机体间复用,同一工作流在仿真与真机通用,且天然支持远程采集。
实验结果
设置。真机平台两套:7 自由度 Franka Research 3,配一个面向工作台的外心 RealSense D435 与一个腕部 RealSense D405;双臂 AgileX,两条 6 自由度臂,配三台 Orbbec Dabai DC1(双臂共享一个自我视角、每腕一个腕部视角)。本地模型跑在单张 RTX 5090 上,前沿模型走 API。任务为 5 种物体配 2 种容器(盘与碗)共 10 个真机操作任务,物体覆盖刚性几何(积木)、不规则形状(香蕉)、滚动动力学(网球)、可变形(泰迪熊)与精密操作(棋子);微调模型只见过积木、香蕉、网球,泰迪熊与棋子留出做分布外评估。每任务 10 次试验、物体位置随机化,回合上限 50 步、超时记失败。
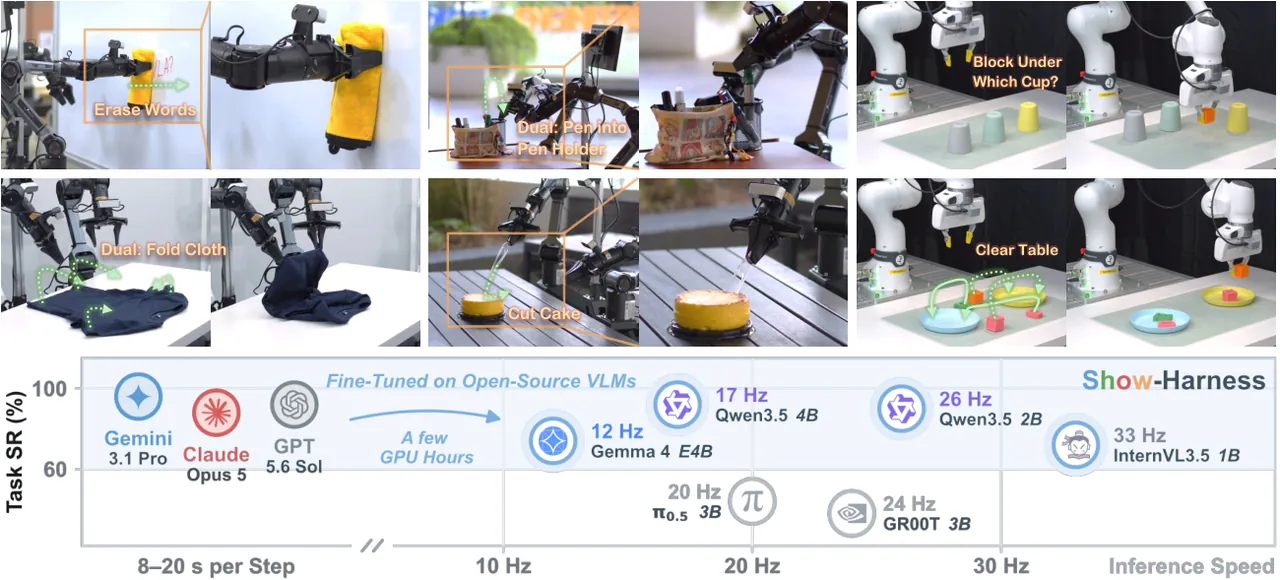
图1:Show-Harness 在多种任务、场景与机体上释放基础 VLM 的泛化操作能力;下方条带对比各模型的单步 token 开销与推理频率。
主结果:三层泛化。跨任务层面,零样本模式(ZS,Gemini-3.1 Pro、medium 思考)十任务平均成功率 89.0%,微调模式(FT,Qwen3.5-2B)86.0%,而最强基线 RATS 只有 57.0%,H-VLA 50.0%、CaP-X 44.0%、π0.5 39.0%、GR00T 35.0%、G-VLA 13.0%。留出的泰迪熊与棋子任务上优势更刺眼:Chess 到 Plate,ZS 10/10、FT 9/10,π0.5 只有 1/10、GR00T 0/10。跨环境层面(背景、光照、视角、干扰物四类扰动各 20 次试验),ZS 四类全部 20/20,平均 100.0%,FT 88.0%,RATS 65.0%、H-VLA 63.8%。仿真到真机一行只给可训练方法:FT 仅用 GUMI 在仿真里采的演示就在真 Franka 上拿到 13/20,而 π0.5 与 GR00T 在同一数据下是 0/20。跨机体层面,ZS 只靠换解释器就在 Franka 与 AgileX 上分别拿到 48/50 与 45/50(平均 93.0%),FT 在双机体演示上共训后直接评测,平均 87.0%。
| 跨任务设置(10 次/任务) | π0.5 | GR00T | H-VLA | G-VLA | CaP-X | RATS | ZS | FT |
|---|---|---|---|---|---|---|---|---|
| Block → Plate | 6/10 | 5/10 | 7/10 | 2/10 | 5/10 | 6/10 | 10/10 | 10/10 |
| Banana → Plate | 7/10 | 7/10 | 8/10 | 3/10 | 8/10 | 8/10 | 10/10 | 10/10 |
| Tennis → Plate | 3/10 | 3/10 | 3/10 | 1/10 | 4/10 | 6/10 | 8/10 | 8/10 |
| Teddy(留出)→ Plate | 5/10 | 4/10 | 5/10 | 1/10 | 4/10 | 6/10 | 10/10 | 8/10 |
| Chess(留出)→ Plate | 1/10 | 0/10 | 3/10 | 0/10 | 2/10 | 4/10 | 10/10 | 9/10 |
| Block → Bowl | 5/10 | 4/10 | 6/10 | 2/10 | 5/10 | 5/10 | 10/10 | 10/10 |
| Banana → Bowl | 6/10 | 6/10 | 7/10 | 2/10 | 7/10 | 8/10 | 6/10 | 7/10 |
| Tennis → Bowl | 2/10 | 2/10 | 3/10 | 1/10 | 3/10 | 5/10 | 7/10 | 8/10 |
| Teddy(留出)→ Bowl | 3/10 | 4/10 | 5/10 | 1/10 | 4/10 | 5/10 | 8/10 | 7/10 |
| Chess(留出)→ Bowl | 1/10 | 0/10 | 3/10 | 0/10 | 2/10 | 4/10 | 10/10 | 9/10 |
| 平均成功率(%) | 39.0 | 35.0 | 50.0 | 13.0 | 44.0 | 57.0 | 89.0 | 86.0 |
| 跨环境与跨机体设置 | π0.5 | GR00T | H-VLA | G-VLA | CaP-X | RATS | ZS | FT |
|---|---|---|---|---|---|---|---|---|
| 背景扰动(20 次) | 11/20 | 10/20 | 15/20 | 4/20 | 12/20 | 14/20 | 20/20 | 18/20 |
| 光照扰动(20 次) | 9/20 | 9/20 | 14/20 | 5/20 | 11/20 | 13/20 | 20/20 | 19/20 |
| 视角扰动(20 次) | 10/20 | 7/20 | 10/20 | 2/20 | 10/20 | 12/20 | 20/20 | 19/20 |
| 干扰物(20 次) | 10/20 | 8/20 | 12/20 | 1/20 | 9/20 | 13/20 | 20/20 | 19/20 |
| 仿真到真机(20 次) | 0/20 | 0/20 | — | — | — | — | — | 13/20 |
| 跨环境平均(%) | 40.0 | 34.0 | 63.8 | 15.0 | 52.5 | 65.0 | 100.0 | 88.0 |
| Franka 7 自由度(50 次) | 22/50 | 19/50 | 26/50 | 7/50 | 23/50 | 30/50 | 48/50 | 45/50 |
| AgileX 6 自由度(50 次) | 19/50 | 17/50 | 23/50 | 4/50 | 20/50 | 22/50 | 45/50 | 42/50 |
| 跨机体平均(%) | 41.0 | 36.0 | 49.0 | 11.0 | 43.0 | 52.0 | 93.0 | 87.0 |
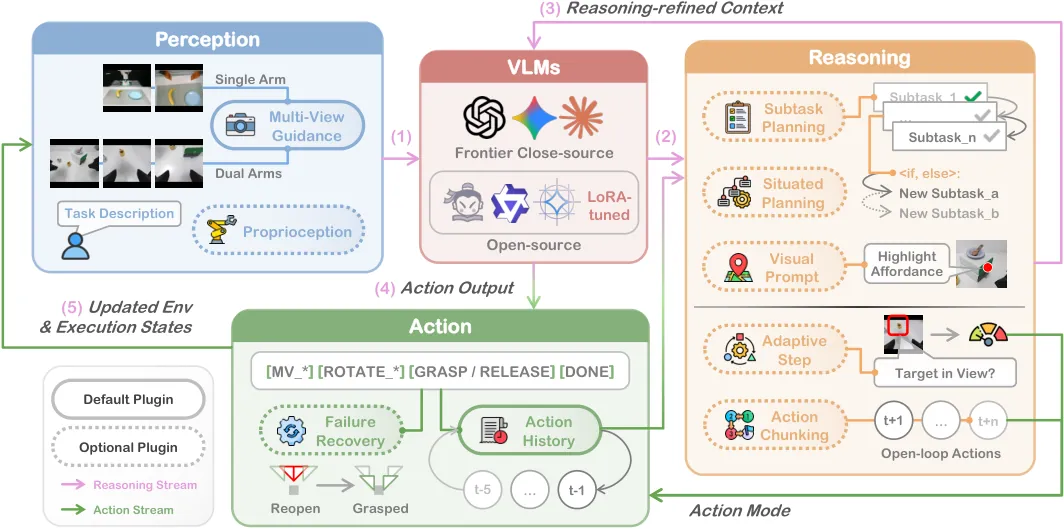
图2:Show-Harness 架构。模块化的感知-推理-动作闭环通过共享语义动作接口把基础 VLM 接到机器人控制上。
物理适应性:精度、组合、外推与工作空间。积木堆叠与销孔插入需要比标准抓取放置更细的运动。作者只把解释器步长从 2 厘米调到 1 厘米,接口与模型都不动:ZS 从 60% 升到 82%,FT 从 40% 升到 65%;同样演示下 π0.5 只有 18%,要再补一轮细粒度训练才到 62%。这正是"语义决策与度量执行分离"的红利——新的精度要求只改解释器。动作组合亦然:在五个 Plate 任务上把两个正交平移单元组合成一次对角位移,步数显著下降而成功率几乎不掉,新组合无需重训即可引入。旋转外推更说明问题:胡萝卜抓取任务中胡萝卜相对夹爪摆 0 度、45 度与未见过的 90 度,每个旋转单元改 15 度;ZS 全角度稳健,FT 在只见 0 度与 45 度演示的情况下于 90 度拿到 70%,π0.5 只有 20%——增量旋转靠重复组合单元覆盖未见角度,连续动作回归则被演示角度范围绑住。工作空间偏移上,从核心 25% 区域(S@1)扩到近边界 90%(S@3),Show-Harness 只轻微退化,π0.5 急剧下滑,说明视觉接地的语义决策对训练分布的依赖更弱。双臂协调上,"收拾桌面"与"传递香蕉"两个各 20 次的任务中,联合预测两臂动作的策略显著优于两个独立单臂代理,并消除了碰撞。
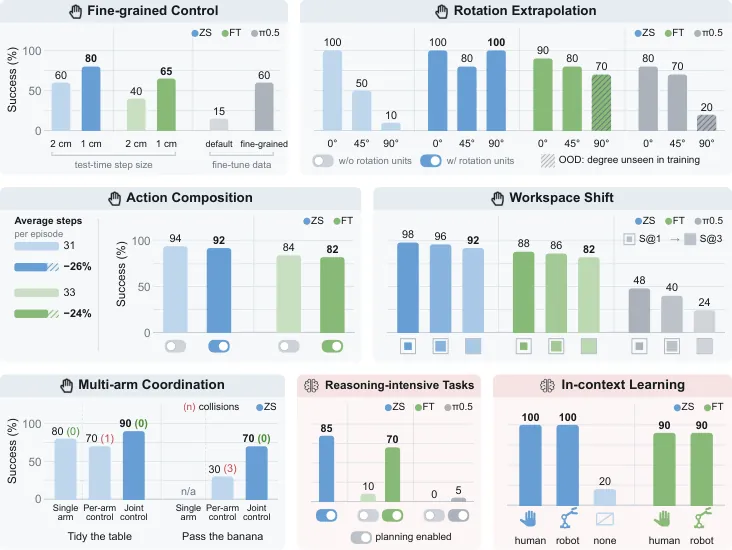
图3:能力分析。左列为物理适应性(细粒度控制、旋转外推、动作组合、工作空间偏移、双臂协调),右列为语义适应性(推理密集任务、视频上下文学习)。
语义适应性:推理与上下文学习。两个需要先推理再操作的任务——在三只倒扣杯子下找积木、把散落字母摆成 SHOW——ZS 加 Situated Planning 拿到 85%,FT 与 π0.5 单独只有 10% 与 0%;给 FT 配上同一份由 Gemini 生成的子任务说明后升到 70%,π0.5 仍停在 5%。语义接口让新指令可以通过可复用的动作空间接地,从而保住了 VLM 的指令跟随弹性。视频上下文学习上,要求按演示顺序收好三件物体:没有演示时 ZS 只拿到 20%(顺序未指定),给了人类或机器人演示视频后 20/20 全对;FT 在同一规划器抽出的任务大纲条件下达到 95%。
插件消融。在真 Franka 上以零样本代理对五个 Plate 任务做留一法消融(默认配置 96% 成功率、平均 30 步/回合)。去掉 Subtask Planning 掉到 60%,典型失败是拖着物体向盘子移动却不抬起;关闭 Action Chunking 仍保 96% 但模型调用变多,全程强制开启则调用变少、成功率掉到 74%,结论是选择性分块;Adaptive Step 只细步精确但易超时、只粗步快但易过冲,自适应切换拿到 96% 与 30 步;去掉 Action History 成功率下降且超时增多,典型失败是在相反动作间振荡;去掉 Failure Recovery 掉到 72%,最难抓的物体掉得最多,主失败模式是未检测到的空抓。Multi-View Guidance 相对只用全局视角提升显著,小物体精确对齐受益最大;去掉 Proprioception 在视觉线索含糊的物体上退化明显。两个默认关闭的插件在专属场景里价值突出:Visual Prompt 把把手感知抓取从 40% 提到 85%(增益来自把语言指令与标记的交互点显式对齐,而非标记本身),Situated Planning 把藏物搜索从 35% 提到 85%。
| 插件(真 Franka,零样本代理,五个 Plate 任务) | 操作 | 结果 | 解读 |
|---|---|---|---|
| 默认配置 | — | 96%,平均 30 步/回合 | Adaptive Step 细步 2 厘米、粗步 4 厘米 |
| Subtask Planning | 移除 | 60% | 模型常拖物不抬,缺显式阶段划分 |
| Action Chunking | 关闭 / 全程强制 | 96% 但调用增多 / 74% | 选择性分块最优 |
| Adaptive Step | 仅细步 / 仅粗步 | 精确但易超时 / 快但易过冲 | 按腕部可见性切换平衡两者 |
| Action History | 移除 | 成功率降、超时增 | 相反动作间振荡暴露为可见循环 |
| Failure Recovery | 移除 | 72% | 空抓未检测,举空夹爪继续搬运 |
| Visual Prompt | 加入(把手抓取场景) | 40% → 85% | 语言指令与标记交互点对齐 |
| Situated Planning | 加入(藏物搜索场景) | 35% → 85% | 推迟未决分支直到视觉证据出现 |
接口本身为什么有效:动作表示消融。作者用 2×2 设计只改六个平移单元的表示、其余 harness 不动:A 语义动作名加书面约定(默认)、B 仅语义名、C 任意符号加约定、D 仅任意符号。D 不提供任何动作先验,代理只能试探未知符号、从前后观测推断效果并记录映射。结果 C 几乎追平默认,B 可用但效率较低,说明约定承担了大部分接地、语义名主要是一个有用的先验;D 在 20 回合里只成功 1 次、推断映射正确率仅 23.3%——单靠视觉变化推断物理动作效果太含糊,显式约定是必要的。前沿模型与思考预算方面,零样本表现大体随模型能力上升;提高思考预算主要减少冗余交互步、对成功率增益有限,却可能带来更高墙钟成本(GPT-5.6-sol 达 3.4 倍);所有模型超过 98% 的响应产出合法动作单元。骨干缩放方面,2B 已是精度与响应速度的好平衡:更大骨干主要帮细粒度任务(堆叠、销孔插入),1B 级模型则在目标附近过度局部调整、回合变长,而在网球任务上小模型反而更好,因为及时纠正运动物体比细精度更关键。
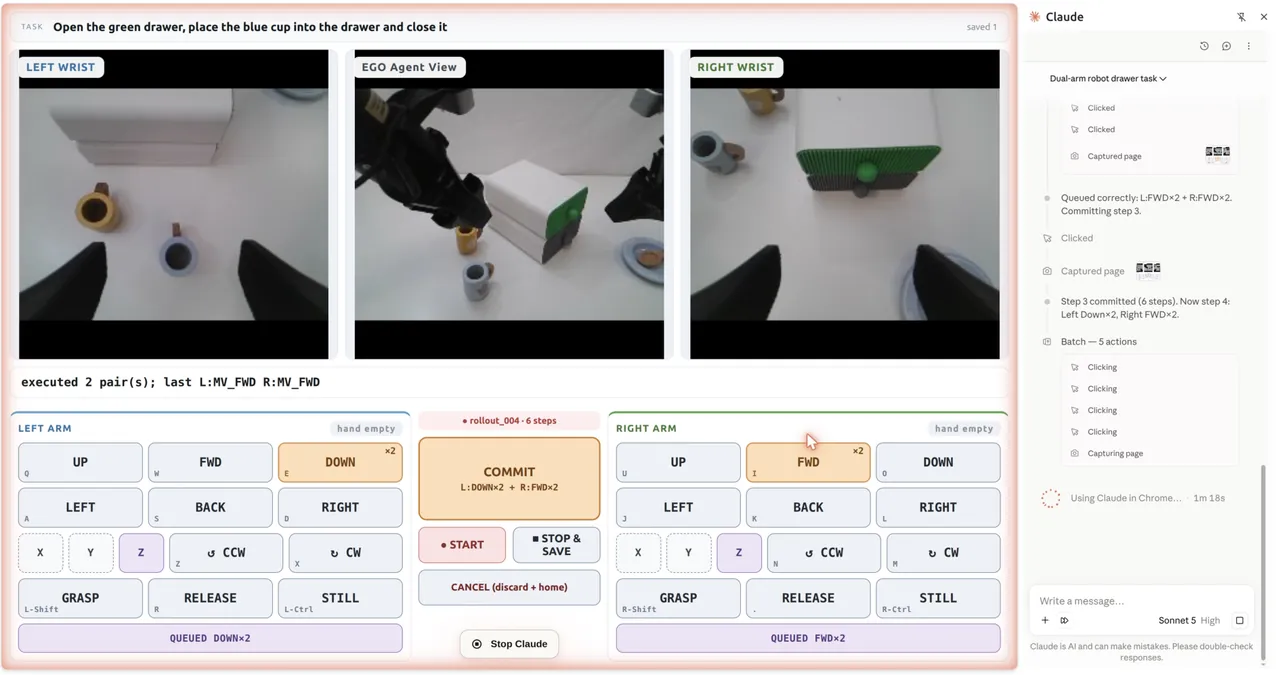
图4:GUMI 界面。人类与前沿代理通过同一套语义控件采集演示,每一步记录执行前观测与所选动作单元。
演示语料。全部演示经 GUMI 采集、统一 2 厘米平移步长:真机 164 回合(7774 步),其中 Franka 9 个任务 101 回合(4969 步、平均 49.2 步/回合)、AgileX 10 个任务 63 回合(2805 步、44.5 步/回合);仿真 230 回合(13523 步),ManiSkill 100 回合(5840 步)、RoboLab 12 个任务 130 回合(7683 步)。另有 19 个 Franka 回合(594 步)专为抓取恢复录制:夹爪从目标点偏前、偏后或偏侧开始,空抓后抬爪重接近而非空手搬运,裁剪后只保留纠正段,因此约 31 步、短于自由采集的约 53 步。
| 平台 | 任务数 | 回合数 | 回合/任务 | 步数 | 步/回合 |
|---|---|---|---|---|---|
| Franka(7 自由度,真机) | 9 | 101 | 11.2 | 4969 | 49.2 |
| AgileX(6 自由度,真机) | 10 | 63 | 6.3 | 2805 | 44.5 |
| 真机合计 | 19 | 164 | 8.6 | 7774 | 47.4 |
| ManiSkill(仿真) | 1 | 100 | 100.0 | 5840 | 58.4 |
| RoboLab(仿真) | 12 | 130 | 10.8 | 7683 | 59.1 |
| 仿真合计 | 13 | 230 | 17.7 | 13523 | 58.8 |
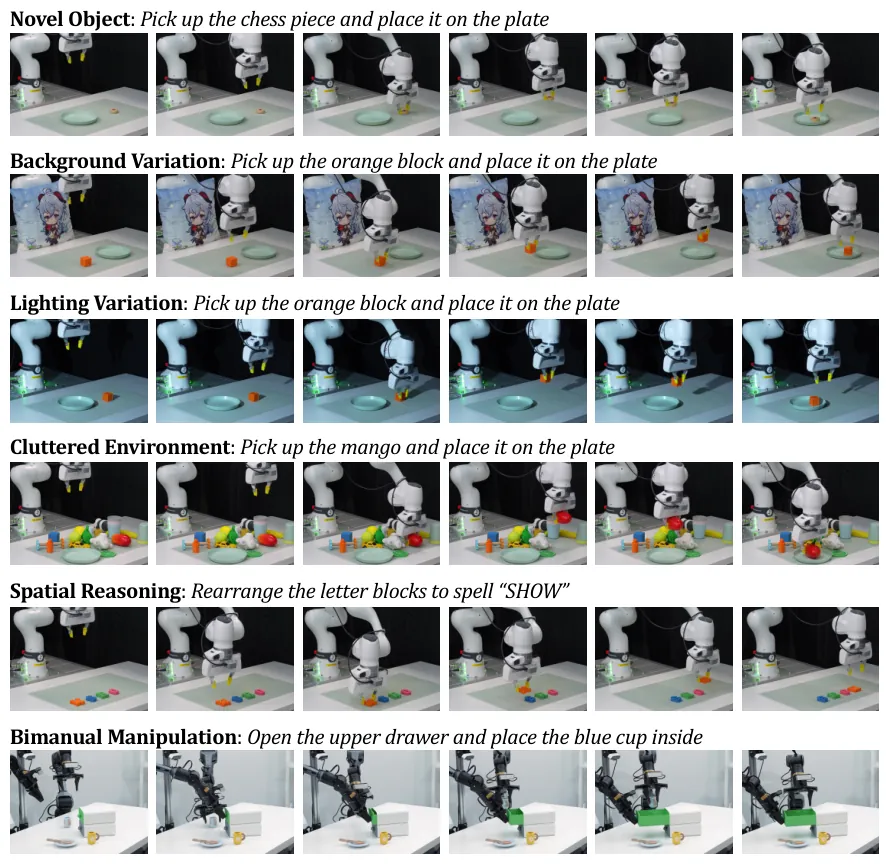
图5:定性演示。新物体、背景与光照变化、杂乱场景、空间推理(把字母块摆成 SHOW)与双臂开抽屉放入物体,同一接口无需重新设计即可复用。
局限性
作者自述。评测目前集中在配平行夹爪的单臂与双臂操作;扩展到更复杂的机体(人形、灵巧手)是有价值的方向。感知侧也尚未纳入触觉与力反馈等具身模态,接触密集、需要力控的精细交互还不在覆盖范围内。
我们的判断。其一,闭环粒度换来的是墙钟成本:回合上限 50 步、典型 30 步/回合,意味着一次抓取放置要数十次模型调用,即便有 Action Chunking 缓解,吞吐仍难与一次输出动作块的 VLA 相比;零样本模式还叠加了闭源 API 的延迟与费用。其二,"接口免训练"不等于"适配免费":步长 σ、旋转增量 θ、运动坐标系映射 R_E 与工作空间限位都要按机体手工标定与配置,解释器质量直接决定上限。其三,主表的仿真到真机一行只填了 FT(13/20),agentic 与 code-as-policy 基线在该格为空缺,这一格的对比强度弱于其它行;且每任务 10 次试验的成功率置信区间较宽,个别任务(如 Banana 到 Bowl 上 ZS 6/10 低于多个基线)提示语义接口在某些摆放组合上并不总是占优。
总结与展望
Show-Harness 的贡献不在新模型,而在新接口:一套语义上对 VLM 透明、物理上由确定性解释器接地的离散动作单元,加上把感知、推理、动作组织成闭环的插件化 harness。它同时验证了两条路径——闭源前沿模型零样本直接控制机器人,以及 2B 级开源模型以约 3% 参数、几 GPU 小时的微调成为可用策略——并在任务、环境、机体三层泛化与仿真到真机迁移上压过代表性 VLA 与 agentic 基线。GUMI 则把同一接口延伸到数据采集,让人类、计算机使用代理与 VLM 代理共用一个键盘可操作的语义空间。往前看,这套接口能否撑住灵巧手与人形的更高维动作、能否吸收触觉与力觉模态、以及语义步长与连续动作块之间的吞吐差距能否被更聪明的分块策略抹平,是它从"能玩"走向"好用"的关键三问。
金句
合适的接口本身就能释放基础视觉语言模型中已经存在的大量具身能力——不需要额外的模型容量,也不需要昂贵的机体专属预训练。