Show-Harness:仅凭一个 VLM 智能体就能「玩」机器人
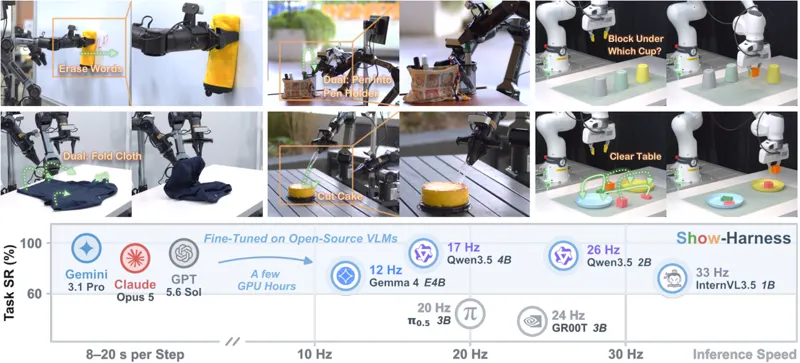
基础视觉语言模型(VLM)对世界已有广泛认知,但把这种认知转成机器人控制仍然困难。我们提出 Show-Harness——一套「具身 harness」,通过连接意图与动作的紧凑语义接口,让 VLM 直接「玩」机器人。Show-Harness 对外暴露 VLM 天然可推理的离散语义动作单元,再由机体专属的解释器把它们确定性地接地为局部机器人动作,使 VLM 始终对细粒度物理决策负责。基于同一接口,我们验证了两条路径:(1)直接解锁闭源前沿 VLM 实现零样本机器人控制;(2)只需几 GPU 小时微调,即可把小规模开源 VLM 适配为低成本部署的策略。我们进一步做出 GUMI(GUI 操作界面),把同一语义动作空间延伸到基于 GUI 的演示采集,让人类与智能体无需专用遥操作硬件即可跨机体「玩」机器人。大量实验表明,装配 Show-Harness 的 VLM 智能体在任务、机体与环境之间稳健泛化,优于代表性的 agentic 与 VLA 范式。这些结果说明:合适的接口本身就能从基础 VLM 中释放大量具身能力,无需额外的模型容量,也无需昂贵的机体专属预训练。
Yanzhe Chen, Zechen Bai, Zhijun Cao2026年9月9日
视觉语言模型Agentic HarnessSemantic Action Interface2026年9月9日