PAPER DEEP DIVE
Dream-RSI:在演化世界中递归自我改进
固定的探索策略无法随搜索空间扩大而自适应,在线优化元策略又要为每个候选策略付出昂贵的长程 rollout。Dream-RSI 把已完成的发现历史组织成发现树,当作可回放的世界:候选探索策略在树里“做梦”式重放,只读取已记录的执行结果即可被打分,再由策略开发智能体改写策略代码,选出回放分最高的版本重新上线,形成递归自我改进闭环。在 Lasso 求解器、三个数学优化问题与 KernelBench 四个 GPU 核任务上,它以少 1.7 倍到 162 倍的智能体调用取得同等或更好的发现质量。
Dream-RSI:把发现历史变成可回放的世界
原标题:Dream-RSI: Recursive Self-Improvement through Evolving Worlds
作者:Tong Zheng、Xidong Wu、Zheng Zhang、Zhankui He、Chaoyi Zhang、Benjamin Coleman、Ruoqiao Wei、Di Bai、Haolin Liu、Rui Liu、Xue Wang、Yue Zhuan、Wang-Cheng Kang、Renkai Xiang、Heng Huang、Xinwu Cheng、Yunsong Guo(共 17 位)
机构:Google、Google DeepMind、马里兰大学帕克分校、弗吉尼亚大学
arXiv:arXiv:2609.14858v1 [cs.CL](2026-09-14)
代码状态:仓库 github.com/zhengkid/Dream-RSI 已建立,README 标注完整代码库与发现程序「准备中」,项目页 dream-rsi.com。可复现材料目前主要在论文里:附录 B 给出在线探索与回放式策略改进的完整提示词,附录 C 给出发现出来的 Lasso 路径求解器全文源码。
一句话总结
把已经跑完的发现历史当成一台可回放的世界模型:候选探索策略在历史树里「做梦」式重放,只读取已记录的执行结果就能被打分、被改写,得分最高的版本再上线继续发现——元层的递归自我改进因此从昂贵的在线试错变成廉价的离线模拟。
背景:递归自我改进卡在探索这一层
递归自我改进(Recursive Self-Improvement, RSI)的常见机制是一个发现循环:智能体生成候选解、评估结果、吸收反馈、改写下一轮的提案方式。这个循环已经在算法设计、开放式数学优化、系统设计与智能体自我改进上产出过真实结果,而这些结果又反过来喂给更强的 AI 系统。随着改进目标变难,发现过程本身越来越长:一次搜索常常要跨越成千上万次「提案—评估」循环。到这个尺度,决定效率的已经不再是单次提案的质量,而是探索的编排——往哪条分支继续深挖、把多少算力并行铺开、什么时候该停。
现有系统大多依赖人工设计、且全程固定的探索策略。固定策略无法从累积的发现经验里学到东西,于是可能反复把算力投在无效方向上。近期工作(如 EvoX)开始尝试在发现过程中在线优化探索策略,但撞上两个结构性瓶颈。第一,元层反馈既延迟又昂贵:评价单个候选解只需要一次执行,评价一条探索策略却必须观察它如何塑造后续许多轮发现。第二,元策略空间巨大:一个新提出的策略可能很差,因此往往要试很多个替代品。两者叠加的后果是,每个候选策略都要先跑完一次长程在线 rollout 才能拿到有用信号,自我改进的闭环在探索这一层很难真正合上。
作者的直觉很朴素:如果有一台又快又便宜的发现模拟器,就能在昂贵上线之前把许多探索策略评一遍。而他们指出,已经完成的发现历史本身就提供了这样一台模拟器。以往工作要么把历史当成静态文本上下文塞回提示词,要么把它当成权重微调的训练数据;但一次完整的发现过程记录下来的其实是一棵结构化的树——过去的探索决策,以及它们真实执行出来的代码结果。
这棵树与 model-based 强化学习里的世界模型是同一类对象。Dreamer 系列从收集到的经验中学一个紧凑的动力学模型,然后在模型内部想象轨迹来改进策略;发现树则是一个「已实现」(realized)的经验世界模型:所有节点的结果都已经存好,换一条策略去走它,只需要按不同的分支子集、不同的顺序、不同的并行分组和不同的停止点去揭示已记录的分支,完全不必重跑底层的编码智能体和评估器。元策略改进因此从昂贵的在线试错,变成一次快速的、基于模拟的「做梦」。
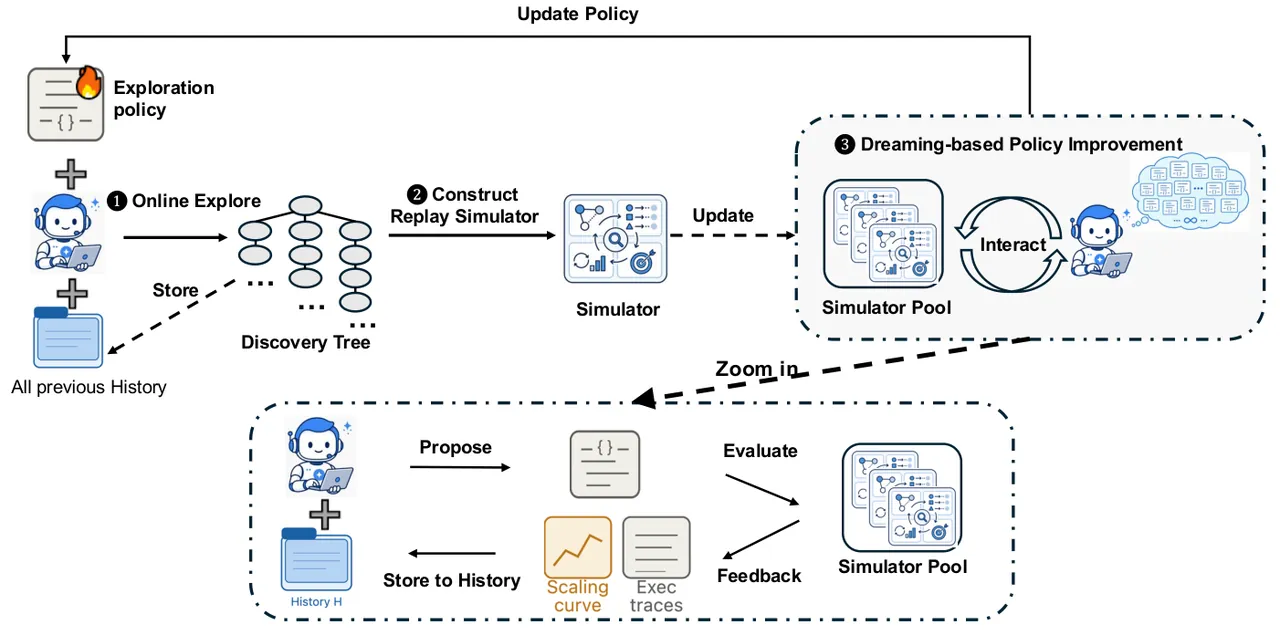
图 1:Dream-RSI 的递归自我改进闭环。① 在线探索:当前策略驱动编码智能体扩展发现树并记录历史轨迹;② 构建回放模拟器:把发现树转成可复用的模拟器池;③ 基于做梦的策略改进:智能体在「脑中」生成大批候选策略,送进回放模拟器模拟执行、拿到即时反馈并不断修订,改进后的策略再上线开启下一轮。
在此基础上,论文提出 Dream-RSI:一个轻量编排层把探索显式化、可编程化(控制分支、并行与停止),底层编码智能体保持不动;在这层之上建立三阶段闭环——在线探索、模拟器构建、基于做梦的策略改进。改进后的策略重新上线产生新的发现经验、扩大模拟器池,闭环在元探索层持续转动。评测覆盖 3 个领域共 8 个科学发现任务:算法工程(Lasso 正则化路径)、数学优化(和差问题、圆填充、自相关不等式)与 GPU 核工程(KernelBench 四个任务)。
预备知识:发现树与共享决策接口
发现树以根节点 $r$ 表示初始工作区状态。每个非根节点 $v$ 恰有一个主父节点(根或先前创建的某个节点),父节点指明这次尝试从哪里开始:发现智能体恢复父节点保存的工作区,把父节点累积的观察当作上下文,产出一次新的尝试。节点 $v$ 保存这份继承来的历史,并记录本次「生成—评估」尝试的结果,包括文件系统快照、生成的产物、评估诊断与分数 $s_v$。分数遵循固定的任务打分协议,数值越大代表质量越好。
在线执行与离线回放共用同一个决策接口。策略观察一棵树 $\mathcal{T}$(初始只含根),从可选节点中挑出一批继续探索。可选节点集合与可行批次集合定义为
$$A(\mathcal{T})=\{r\}\cup\{v\in\mathcal{T}: v\ \text{is a leaf}\},\qquad A(\mathcal{T};W)=\{C\subseteq A(\mathcal{T}): |C|\leq W\}$$
其中叶子由当前已观察到的树决定,$W\geq 1$ 是并行 worker 数量,每个 worker 一次只能执行一个「生成—评估」请求(例如一次并发 API 调用)。策略的动作就是一个批次 $C$:它同时决定了从哪里继续探索,以及并行调度多少次尝试。两个阶段唯一的差别,是选中批次之后发生的转移。
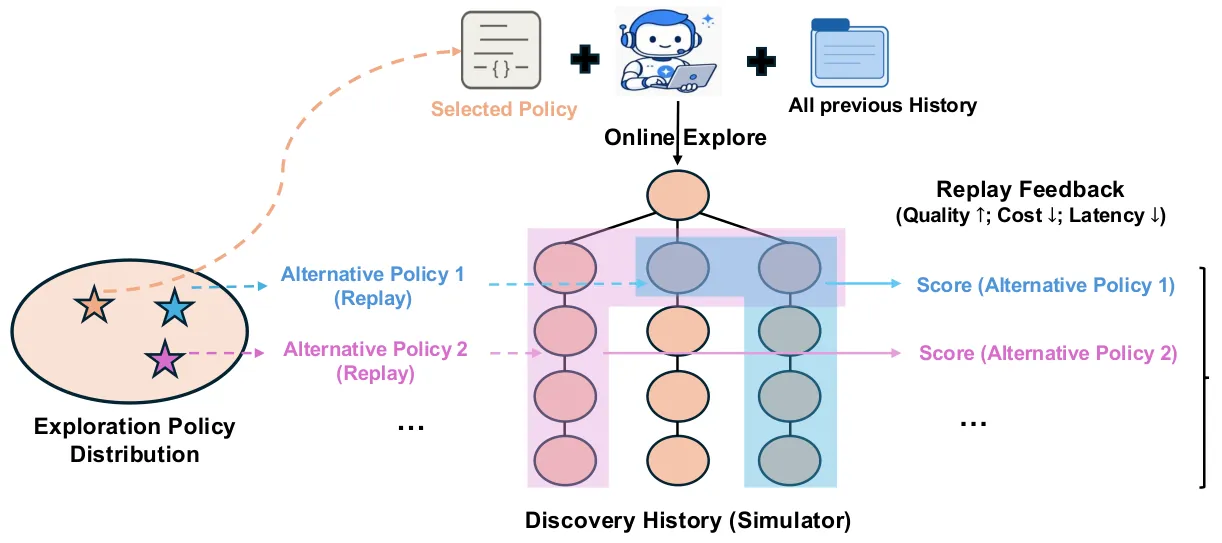
图 2:发现历史即回放模拟器。已部署的策略先在线探索,生成带完整观察的结构化发现树;随后成千上万条候选策略可以在这台模拟器里被测试——换分支子集、换探索顺序、换并发度、换停止规则。由于所有节点结果都已预存,一次昂贵的在线运行就能支撑数千次零执行成本的离线(off-policy)评估。
方法详解
1. 在线 rollout:策略冻结,历史增长
用 $t=1,2,\ldots$ 索引外层迭代,从初始策略 $\pi_1$ 与空历史 $\mathcal{H}_0=()$ 开始。第 $t$ 轮,策略 $\pi_t$ 在已完成发现历史 $\mathcal{H}_{t-1}$ 的上下文里引导一次新的在线 rollout。历史只提供探索上下文,与新构建的树分开存放,并且 rollout 全程策略代码保持冻结。记 $\mathcal{T}_t^{k}$ 为完成 $k$ 个决策轮之后的新树,$\mathcal{T}_t^{0}=\{r\}$,rollout 最多允许 $K_1$ 轮。
在第 $k\leq K_1$ 轮,探索策略选出批次 $C_t^{k}\in A(\mathcal{T}_t^{k};W)$,$C_t^k$ 中每个节点被分给一个 worker。发现智能体用该节点保存的工作区与可用上下文产出新候选,评估器对结果打分。这些尝试并行执行,每个尝试产出其被选父节点的一个新子节点;把完成的子节点挂回当前树就得到 $\mathcal{T}_t^{k+1}$,而所有先前记录的节点保持不变。这个转移是随机的——同一个起始工作区,发现智能体可能生成不同结果。下一轮里,新建的子节点成为延长分支上可选择的叶子,而根节点仍然可选,用于开启更多分支。当策略选出空批次或跑满 $K_1$ 轮时 rollout 结束,最终树记为 $\mathcal{T}_t$ 并追加进历史:
$$\mathcal{H}_t=\mathcal{H}_{t-1}\cup\{\mathcal{T}_t\}$$
2. 离线回放:确定性的 Child 算子
第 $t$ 轮的离线阶段中,历史 $\mathcal{H}_t$ 固定不变,方法构造并评估 $M\geq 1$ 个策略版本 $\pi_t^{0},\ldots,\pi_t^{M-1}$,起点是 $\pi_t^{0}=\pi_t$。每个版本都要在每一棵历史树 $\mathcal{T}_i$($i=1,\ldots,t$)上单独评估完,才根据反馈开发下一个版本。记号上,$m$ 索引策略版本,$i$ 索引回放世界,$k$ 计数一次「策略—世界」评估内部的决策轮数。
对每个策略—树组合 $(m,i)$,回放先重置该策略的 per-rollout 状态,从 $\mathcal{T}_i^{m,0}=\{r\}$ 开始。这里 $\mathcal{T}_i^{m,k}\subseteq\mathcal{T}_i$ 表示 $k$ 轮之后已揭示的子树:完整记录树 $\mathcal{T}_i$ 始终固定,变化的只是策略观察到的部分。每次决策,$\pi_t^{m}$ 依据已揭示的观察选出批次 $C_i^{m,k}\in A(\mathcal{T}_i^{m,k};W)$。与在线执行不同,回放确定性地返回被选节点的已记录子节点,而不生成新候选:
$$\mathcal{T}_i^{m,k+1}=\mathcal{T}_i^{m,k}\cup\bigcup_{v\in C_i^{m,k}}\operatorname{Child}(v;\mathcal{T}_i,\mathcal{T}_i^{m,k})$$
$\operatorname{Child}$ 的规则是整套机制的关键。对 $v\neq r$,返回 $v$ 在 $\mathcal{T}_i$ 上尚未被揭示的那个唯一记录子节点(因为 $v$ 是 $\mathcal{T}_i^{m,k}$ 的叶子,那个孩子必然还没揭示);对 $v=r$,返回根在 $\mathcal{T}_i$ 中创建时间最早、且落在 $\mathcal{T}_i^{m,k}$ 之外的子节点,也就是打开一条此前没走过的分支。两种情况下,若已无记录可续,$\operatorname{Child}$ 返回空集。新揭示的节点会在策略下一次决策之前暴露其存储的观察。回放最多 $K_2$ 个决策轮(每个非空批次算一轮),在策略选出空批次、达到 $k=K_2$、或 $\mathcal{T}_i^{m,k}=\mathcal{T}_i$(所有记录节点都已揭示)时终止,完成轮数记为 $k_i^{m,\star}\in\{0,\ldots,K_2\}$,最终子树为 $\mathcal{T}_i^{m,k_i^{m,\star}}\subseteq\mathcal{T}_i$。
因此回放评价的是三件事:每条已打开的分支该追多深、把尝试怎样分组成并行批次、以及何时再开一条新分支或干脆停下。不同策略在这些决策上可以完全不同,但每条分支都按其记录的父子顺序被遍历,且不会产生任何超出 $\mathcal{T}_i$ 的结果。
3. 回放目标:质量、成本与并行度
令 $N_i^{m}=|\mathcal{T}_i^{m,k_i^{m,\star}}|-1$ 为回放揭示出的非根节点数。回放本身不执行新的发现尝试,但 $N_i^{m}$ 统计的正是这条轨迹所代表的「生成—评估」请求数。给定固定系数 $\beta_1,\beta_2\geq 0$,回放分数为
$$V_i^{m}=\underbrace{\max_{v\in\mathcal{T}_i^{m,k_i^{m,\star}}} s_v}_{\text{discovery quality}}-\underbrace{\beta_1 N_i^{m}}_{\text{execution cost}}+\underbrace{\beta_2\frac{N_i^{m}}{\max\{1,k_i^{m,\star}\}}}_{\text{parallelism bonus}}$$
第一项是回放期间拿到的最好解质量,第二项惩罚尝试次数,第三项(对非空回放)奖励每个决策轮平均执行的尝试数,从而偏向那些把有用的后续尝试批量并行、而不是一条条串行执行的策略。这个式子也解释了为什么回放分数不是「历史最好分」的简单复读:一条策略即使在同一棵树上,也可能因为揭示得更少、并行得更差而拿到更低的 $V_i^m$。
4. 策略改进与选择:带一个有限的单调性保证
策略版本 $\pi_t^{m}$ 的评估分数,是它在固定历史上的平均回放分:
$$V^{m}=\frac{1}{t}\sum_{i=1}^{t}V_i^{m}$$
离线阶段先评估当前策略 $\pi_t^{0}=\pi_t$。对每个 $m=0,\ldots,M-1$,策略开发智能体(一个固定的 LLM 智能体)检查 $\pi_t^{m}$ 的回放轨迹与分数,连同更早修订版本的反馈,识别出成功的决策与反复出现的失败,然后改写可执行的策略代码,产出 $\pi_t^{m+1}$,再在同样的 $t$ 个回放世界上评估它。修订之间,回放反馈对开发智能体始终可见。
$M$ 次修订之后,下一轮的在线策略从所有已评估版本中选出:$\pi_{t+1}=\pi_t^{m^{\star}}$,其中
$$m^{\star}\in\operatorname*{arg\,max}_{m\in\{0,\ldots,M-1\}}V^{m}$$
由于候选集合包含当前策略,这个选择满足 $V^{m^{\star}}\geq V^{0}$:在固定历史 $\mathcal{H}_t$ 上的平均回放分意义下,选出的策略不会比当前策略差。随后它被部署上线去收集 $\mathcal{T}_{t+1}$,扩大下一轮离线改进可用的历史。整条闭环里只有探索策略代码在变,底层模型、评估器与执行接口全部冻结。
flowchart TD
  P0["初始探索策略 pi_1 并行细化 W 个 workspace"] --> ON["在线 rollout 最多 K1 轮 策略代码冻结"]
  ON --> AG["发现智能体恢复父节点工作区 产出新候选"]
  AG --> EV["评估器打分 s_v 保存快照与诊断"]
  EV --> TREE["挂回子节点 得到发现树 T_t"]
  TREE --> HIST["追加历史 H_t = H_t-1 并 T_t"]
  HIST --> SIM["历史树池即回放模拟器 结果全部已记录"]
  SIM --> REP["回放 最多 K2 轮 Child 算子确定性揭示记录子节点"]
  REP --> SCORE["按 V_i^m 打分 质量 减 成本 加 并行奖励"]
  SCORE --> DEV["策略开发智能体读轨迹与分数 改写策略代码"]
  DEV --> MORE{"已评估 M 个版本"}
  MORE -->|否 反馈可见| REP
  MORE -->|是| SEL["取 argmax V^m 得 pi_t+1 满足不低于 V^0"]
  SEL -->|重新部署| ON
  SEL --> OUT["上线收集 T_t+1 模拟器池扩大"]
  OUT --> ON
图:Dream-RSI 的元层闭环。左半是在线侧(策略冻结、树增长、历史累积),右半是离线侧(同一批历史树被 M 个策略版本反复回放、打分、改写),两侧靠 $\operatorname{Child}$ 算子与 $V^m$ 的 argmax 选择相接。
5. 编排层落到代码:提示词里的接口约束
附录 B 的两段提示词把上述抽象落到了具体的代码接口,也暴露了这套方法的工程边界。在线探索提示词要求发现智能体在提出新解之前先检查完整的可用发现历史,显式推理成功与失败的尝试,并避免反复利用一个已经局部饱和的方向。
回放侧的策略改进提示词更严格:只允许编辑一个文件 {method_file},实现 OptimalPolicy.solve(self, question, budget=None),明确禁止智能体自己去解科学任务、也禁止改任何别的程序。环境被描述成一张冻结的、不规则的 branch × attempt 网格:策略要么打开一个根,要么细化一条已打开分支的下一个格子,每揭示一个格子花费一次 probe;策略只能看到自己已经揭示的格子,未揭示的分数未知。评估器扫描策略唯一的 beta 旋钮,并按
pareto.reward = pareto.auc - lambda * parallel_penalty给结果曲线排序:pareto.auc 奖励「用尽量少的总 probe 达到高的 per-trace attainment」,parallel_penalty 是 effective_sequential_rounds / total_probes 在整个扫描上的均值——这与式 (1) 的并行奖励项是同一件事的两种写法。另有一个 plan_grid(context) -> GridPlan 钩子在新网格创建之前运行:它不做 episode 内决策、绝不能窥视当前 episode 的结果,且必须返回非 None 的 GridPlan(branch_count=W, refine_count=R),即使历史为空也要给一个显式的保守 bootstrap 计划并附上事实性理由;W、R 是任意整数而非固定预设,且需满足 0 <= R <= context.hard_max_refine_count。最关键的一句是:在回放中,超出冻结轨迹的 context.trace_branch_count 或 context.trace_refine_count 的请求属于 out of support,拿不到任何回放奖励。这正是「回放只能揭示已记录结果」在接口层的直接体现。
实验结果
三个领域共用一套对照设计:Dream-RSI 与主对照基线 Recursive Fixed Exploration 使用同一个发现智能体、同一个评估器、同一份初始化与同样的资源约束,并且都从同一个人工设计的探索策略出发——一个朴素的并行细化策略:启动多个独立探索 workspace,每个维护自己的局部发现轨迹,并基于该 workspace 内累积的历史反复细化当前候选。因此两种方法在第一轮的搜索行为完全一致;从第二轮起,固定探索保持策略静态,Dream-RSI 则每轮做梦改写并重新部署策略。发现成本用累积的发现智能体调用次数计量。发现智能体通过 Gemini CLI 驱动 Gemini-3.1 Pro 与 Gemini-3.7-Flash:固定探索每轮 Pro 跑 10 个并行 workspace × 最多 11 步细化 = 110 次调用,Flash 跑 32 × 20 = 640 次;Dream-RSI 每轮预算相同,Lasso 任务上两者都跑 5 轮递归,数学任务上跑 10 轮。
算法工程:Lasso 正则化路径
任务定义(附录 A):给定特征矩阵 $X\in\mathbb{R}^{n\times p}$、响应 $y\in\mathbb{R}^{n}$ 与递减序列 $\lambda_1>\cdots>\lambda_K$,
$$F_k(w):=\frac{1}{2n}\|y-Xw\|_2^2+\lambda_k\|w\|_1,\qquad w_k^{\star}\in\arg\min_{w\in\mathbb{R}^{p}}F_k(w)$$
候选求解器返回近似系数 $\widetilde{W}=(\widetilde w_1,\ldots,\widetilde w_K)$,只有通过与基准目标值的比较才算正确:
$$F_k(\widetilde w_k)\leq F_k(w_{k,\mathrm{sklearn}})+10^{-6}\quad\text{for every }k$$
正确性在与计时实例不同的新实例上检查,任一检查失败则搜索分数直接记 0。通过后,令 $\mathcal{I}$ 为计时实例集合、$t_i$ 为在实例 $i$ 上算完整条正则化路径的时间,搜索分数是几何平均运行时的倒数:
$$R_{\mathrm{search}}=\Big(\prod_{i\in\mathcal{I}}t_i\Big)^{-1/|\mathcal{I}|}$$
设置沿用 SimpleTES 的 17 个合成实例,覆盖维度、稀疏度、特征相关性与活跃集结构的多种组合;为了检验发现的算法能否泛化到搜索分布之外,另在 6 个留出的下游数据集(生物与非生物各半)上评估。下表是留出数据集上的平均运行时(毫秒,越低越好)。
| 方法 | 发现智能体 | 调用数 | Gisette | RCV1 | DNA | Leukemia | Colon | Duke Breast | 平均 |
|---|---|---|---|---|---|---|---|---|---|
| sklearn | — | — | 11275.2 | 252881.7 | 93.8 | 227.2 | 229.8 | 374.0 | 44180.3 |
| glmnet | — | — | 9063.6 | 73072.8 | 351.9 | 45.0 | 24.2 | 47.7 | 13767.5 |
| SimpleTES | gpt-oss-120b | 51,200 | 3141.9 | 19625.6 | 15.9 | 15.5 | 11.6 | 18.1 | 3804.8 |
| SimpleTES † | gpt-oss-120b | 51,200 | 8651.0 | 41143.1 | 37.6 | 28.2 | 19.5 | 31.1 | 8318.4 |
| Recursive Fixed Exploration | Gemini-3.1-Pro | 550 | 1861.8 | 19550.1 | 41.5 | 26.1 | 14.5 | 28.4 | 3587.1 |
| Recursive Fixed Exploration | Gemini-3.7-Flash | 3200 | 1133.1 | 13873.0 | 29.8 | 24.1 | 15.7 | 24.4 | 2516.7 |
| Dream-RSI | Gemini-3.1-Pro | 317 | 2841.0 | 14616.0 | 49.9 | 30.2 | 16.4 | 32.5 | 2931.0 |
| Dream-RSI | Gemini-3.7-Flash | 1879 | 1091.9 | 12923.4 | 31.4 | 21.0 | 12.2 | 23.6 | 2350.6 |
表 1:Lasso 路径求解器在 6 个留出数据集上的运行时(毫秒,越低越好)与发现成本(累积发现智能体调用次数)。数据取自论文图 3(a)。
读表要注意两件事。第一,Dream-RSI 在两个 backbone 上都拿到了更好的「质量—算力」折中:Pro 上把平均运行时从 3587.1 ms 降到 2931.0 ms,同时调用数从 550 降到 317(约 1.7×);Flash 上从 2516.7 ms 降到 2350.6 ms,调用数从 3200 降到 1879。也就是说,它不是靠多花算力换质量,而是花得更少还更好。第二,与使用 51,200 次生成的 SimpleTES 相比,Dream-RSI 用少约两个数量级的调用(摘要口径 162×)拿到更低的平均下游运行时。
但表里也有对 Dream-RSI 不利的格子:在 Gisette、DNA、Leukemia、Colon、Duke Breast 这些小规模数据集上,Pro 版 Dream-RSI(2841.0 / 49.9 / 30.2 / 16.4 / 32.5)反而慢于固定探索(1861.8 / 41.5 / 26.1 / 14.5 / 28.4),它的平均优势主要由 RCV1 这一列的大规模矩阵拉开(14616.0 对 19550.1,也是全表该列最低)。论文对此的解释是两个 backbone 发现的程序性格不同:Pro 找到的程序特别适配 RCV1 这类大规模矩阵,Flash 找到的更通用、在各种问题尺度上都稳——Flash 版在 6 个数据集里有 5 个是全表最低。
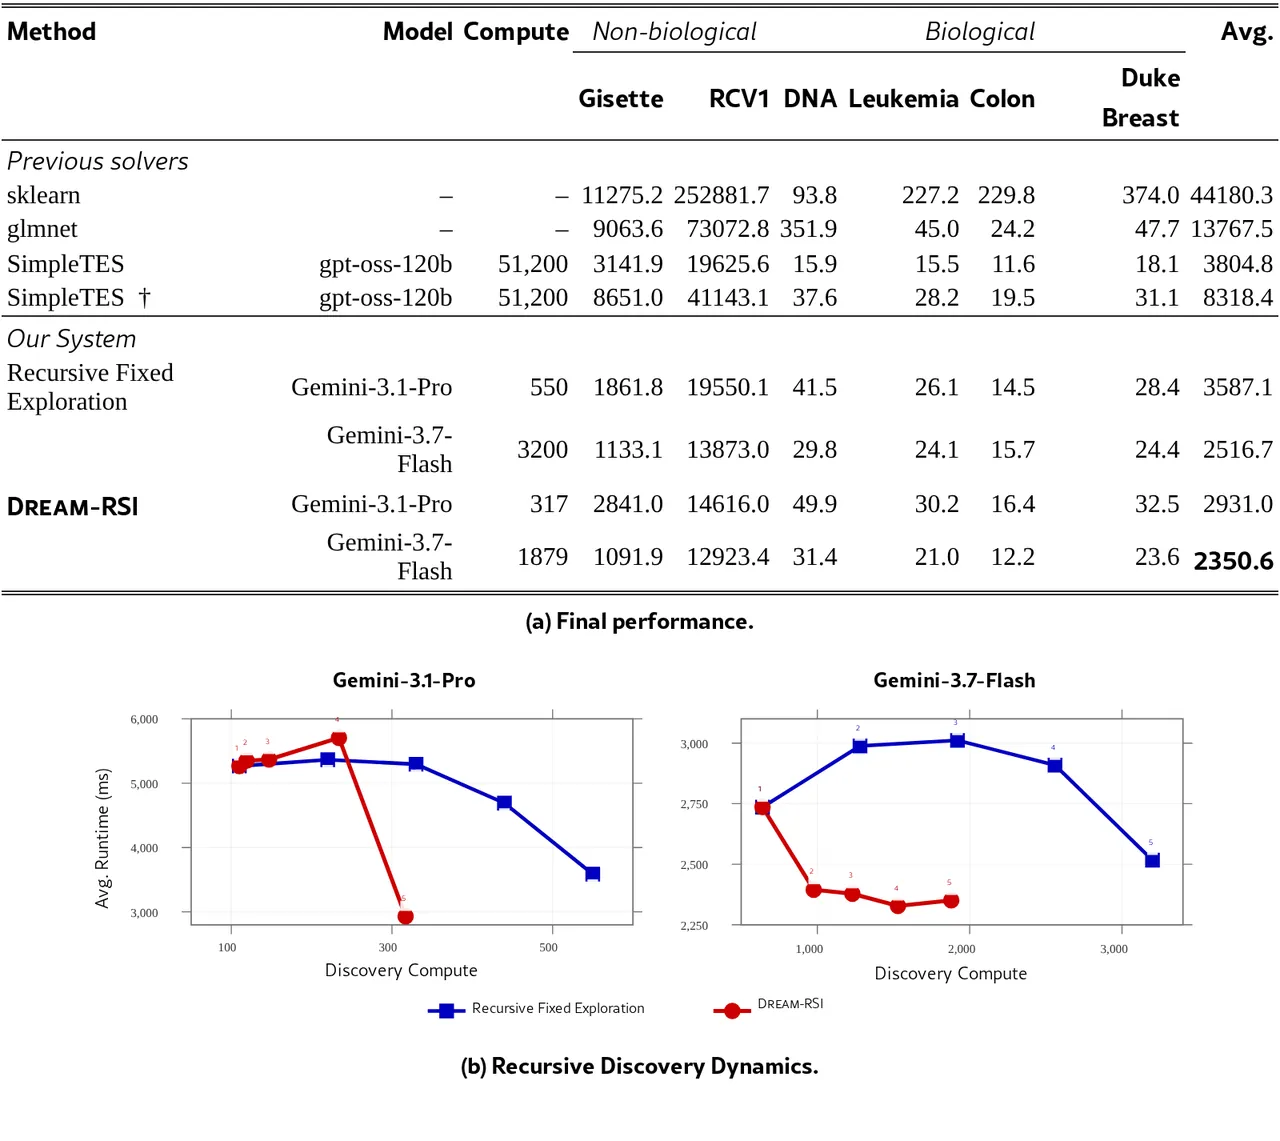
图 3:(a) Lasso 路径发现的最终性能对比;(b) 下游性能随累积发现算力的递归发现动力学。两种方法第一轮完全重合,之后固定探索保持策略静态,Dream-RSI 每轮做梦改写并重新部署策略,两条轨迹明显分叉:在 Pro 与 Flash 两个 backbone 上,Dream-RSI 都同时取得更好的下游性能与更低的累计算力。
发现出来的求解器长什么样
这部分是全文最有说服力的证据之一:它说明改进探索策略最终换来的是结构上不同的算法,而不是同一算法的更好超参。与 SimpleTES 按问题维度在 LARS 与坐标下降之间切换不同,Dream-RSI 发现的求解器把自适应性放进了活跃集优化内部:强规则(strong-rule)筛选叠加基于 Cauchy–Schwarz 的 KKT 剪枝,只有当界无法为某个特征给出判定时才重算精确梯度,剪枝失效时回退到全量刷新;再配合不相交活跃集链表(O(1) 交换删除)、惰性 Gram 矩阵构建与硬件感知实现。
// 附录 C Listing 3:Dream-RSI 发现的 Lasso 路径求解器(节选)
// 无分支软阈值:用 std::abs + std::copysign 取代条件跳转
static inline double soft_thresh(double z, double gamma) {
  double abs_z = std::abs(z);
  double val = abs_z - gamma;
  return std::copysign(val > 0.0 ? val : 0.0, z);
}

// Dual-Phase Adaptive Cauchy-Schwarz KKT Pruning
double d2 = 0.0;
const double* RESTRICT r_curr_ptr = ASSUME_ALIGNED(r_padded, 64);
const double* RESTRICT r_ref_ptr  = ASSUME_ALIGNED(r_ref_padded, 64);
#pragma omp simd reduction(+:d2) aligned(r_curr_ptr, r_ref_ptr: 64)
for (int k = 0; k < n_padded; ++k) {
  double diff = r_curr_ptr[k] - r_ref_ptr[k];
  d2 += diff * diff;
}
两段代码分别对应论文描述的两个手法:软阈值做成无分支形式(避免在坐标下降内层循环里引入分支预测失败),Cauchy–Schwarz 剪枝先用当前残差与参考残差的差平方和 $d_2$ 构造一个可向量化的界,只有界不足以判定时才去算精确梯度;内积循环普遍采用 4 路寄存器分块(sum0..sum3)并对齐到 64 字节。这类细节不是人类提示词里写好的,而是在回放反馈驱动的多轮改写中被发现出来的。
数学优化:三个任务,预算差 50 倍
三个任务分别属于离散组合优化、几何优化与函数优化。和差问题要求构造有限集 $A\subset\mathbb{Z}$,使归一化和集相对归一化差集尽量大:
$$\Gamma(A):=\frac{\log\!\left(|A+A|/|A|\right)}{\log\!\left(|A-A|/|A|\right)},\quad A+A:=\{a+a':a,a'\in A\},\ A-A:=\{a-a':a,a'\in A\}$$
单位正方形内的圆填充($n\in\{26,32\}$)要求圆心 $(x_i,y_i)\in[0,1]^2$、半径 $r_i\geq 0$,满足 $r_i\leq x_i\leq 1-r_i$、$r_i\leq y_i\leq 1-r_i$ 与两两不重叠 $(x_i-x_j)^2+(y_i-y_j)^2\geq(r_i+r_j)^2$,目标是最大化 $\sum_i r_i$。自相关不等式则对支撑在 $[-1/4,1/4]$、满足 $\int_{-1/4}^{1/4}f(x)\,dx=1$ 的非负可积函数,最小化自卷积的峰值 $\Phi_1(f):=\max_{t\in[-1/2,\,1/2]}(f*f)(t)$,其中 $(f*f)(t):=\int_{\mathbb{R}}f(t-x)f(x)\,dx$。
| 方法 | LLM | Sum Diff(越高越好) | Auto Correlation(越低越好) | Circle Packing(越高越好) |
|---|---|---|---|---|
| AlphaEvolve | Gemini-2.0 Pro + Flash | — | 1.455700 | 2.635862 |
| AlphaEvolveV2 | Gemini-2.0 Pro + Flash | 1.121936 | — | 2.635983 |
| OpenEvolve | — | — | 1.460000 | — |
| CodeEvolve | — | — | — | 2.635980 |
| ShinkaEvolve | Mixed | — | 1.457800 | 2.635982 |
| TTS-Discovery | Qwen3-8B | — | — | 2.635983 |
| ThetaEvolve | Distilled-Qwen3-8B | — | 1.493000 | 2.635983 |
| EvoX | Gemini-3.0-Pro | — | 1.458900 | 2.635900 |
| SimpleTES | GPT-OSS-120B | 1.143975 | 1.453675 | 2.635983 |
| Recursive Fixed Exploration | Gemini-3.1-Pro | 1.144047 | 1.456001 | 2.635983 |
| Dream-RSI | Gemini-3.1-Pro | 1.145427 | 1.456375 | 2.635983 |
表 2:数学发现任务对比(论文表 1)。Dream-RSI 与固定探索均用 Gemini-3.1 Pro 跑 10 轮递归。
和差问题上 Dream-RSI 拿到 1.145427,高于固定探索的 1.144047 与 SimpleTES 的 1.143975;圆填充上 2.635983 与已报道的最好结果并列(AlphaEvolveV2、TTS-Discovery、ThetaEvolve、SimpleTES 同为该值)。自相关这一列需要如实读:该指标越低越好,Dream-RSI 的 1.456375 略差于固定探索的 1.456001,更差于 SimpleTES 的 1.453675,论文用的措辞是「保持竞争力」。真正的差距在预算上——SimpleTES 用了 51,200 次生成,Dream-RSI 不到 1,000 次。换句话说,在数学优化这一域,本文的可辩护主张是「用 1/50 的预算打平」,而不是「更好」。
GPU 核工程:KernelBench 四任务
核工程要求同时推理算法结构、访存、并行化与硬件特定优化,是检验方法能否跨域泛化的一个相当不同的测试床。任务取自 KernelBench 的 VGG16、LayerNorm、ConvDiv、ConvMax,候选实现以逆运行时(1/ms)度量,并需通过对照参考实现的正确性检查;发现智能体为 Gemini-3.1 Pro,与固定探索共用评估协议与初始化。
| KernelBench 任务 | Dream-RSI 相对固定探索 | 比较口径 |
|---|---|---|
| VGG16 | 2.43× 更少的生成数 | 达到可比性能 |
| LayerNorm | 1.79× 更少的生成数 | 达到可比性能 |
| ConvDiv | 2.09× 更高的分数 | 相近发现预算 |
| ConvMax | 1.44× 更高的分数 | 相近发现预算 |
表 3:GPU 核工程结果(论文图 4)。四个任务均为越高越好,性能单位 1/ms。
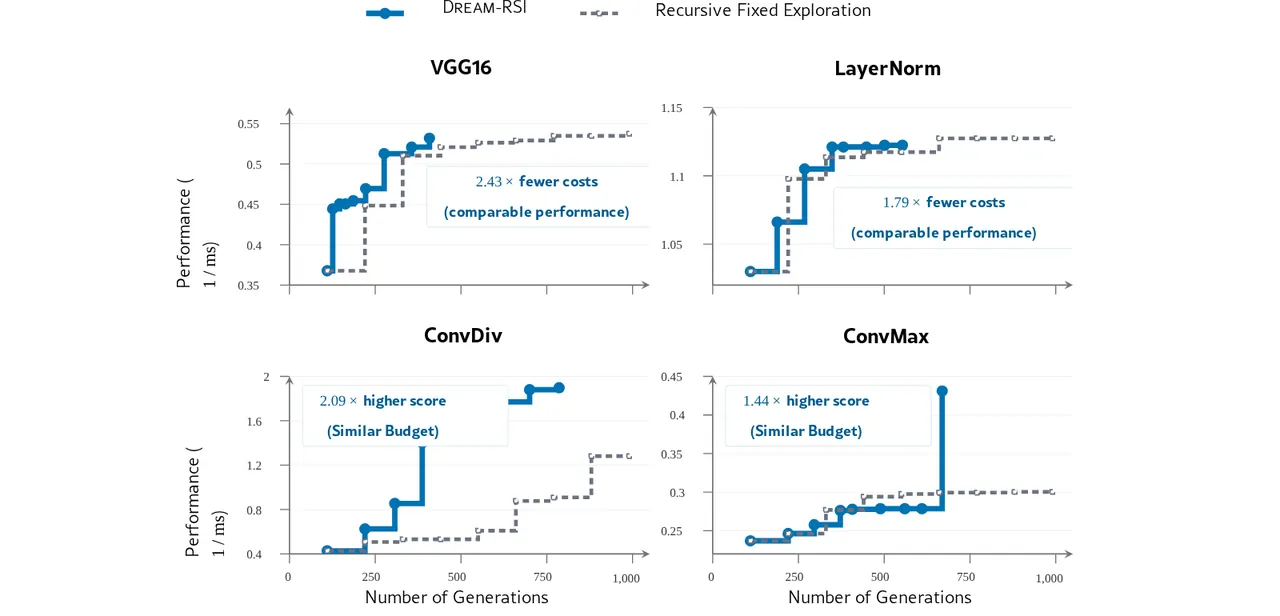
图 4:KernelBench 上的发现性能随生成数的变化。VGG16 与 LayerNorm 上 Dream-RSI 用 2.43× 与 1.79× 更少的生成达到可比性能;ConvDiv 与 ConvMax 上在相近预算下分别取得 2.09× 与 1.44× 更高的性能。
两组分析:语义引导是负面的,探索努力会自适应
第一组分析直接挑战了「把历史总结成建议喂回提示词」这一常见做法。作者构造了一个自然替代方案:把先前轨迹抽象成高层方向性洞见,作为显式语义引导注入后续轮次的提示词,并把它同时加到固定探索与 Dream-RSI 上。结果是在同等发现预算下,带显式方向引导的版本在两种范式中一致地劣于无引导版本。作者的解释是:长程发现同时铺多条并行线程,对「未来该往哪搜」施加强语义归纳偏置,会过度约束搜索空间、阻碍多样化探索。
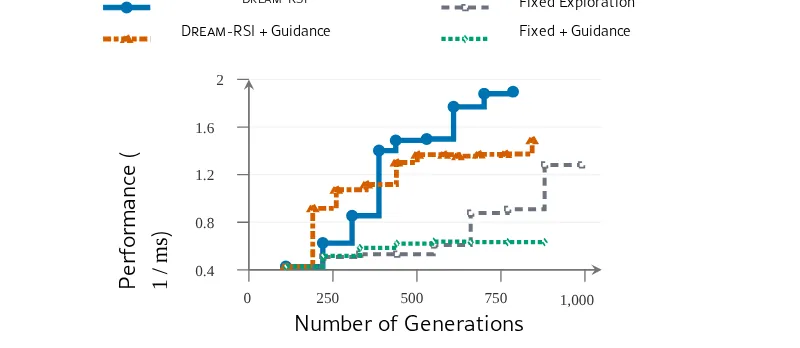
图 5:ConvDiv 上的发现性能。把历史当作可交互的回放模拟器,优于只把它当作语义引导。
第二组分析看策略行为本身如何演化。在 ConvDiv 上,每轮最好性能从 E0 到 E8 单调上升,同时每轮评估的尝试数呈明显的自适应形状:性能快速上升期先把探索努力从 110 次压到 50 次(省算力),当进步出现平台后再抬回约 90 次(重新加大探索),并与随后的性能增益同步。这说明回放目标里的成本项与并行项确实把「该省」和「该铺」写进了策略代码,而不只是把分数推高。
| 递归轮次 | E0 | E1 | E2 | E3 | E4 | E5 | E6 | E7 | E8 |
|---|---|---|---|---|---|---|---|---|---|
| 每轮最好性能(1/ms) | 0.427 | 0.625 | 0.855 | 1.403 | 1.488 | 1.499 | 1.770 | 1.880 | 1.898 |
表 4:ConvDiv 上跨递归执行轮次的最好性能(论文图 6(a))。图 6(b) 显示同期评估尝试数由 110 降到 50、平台期后回升到约 90。
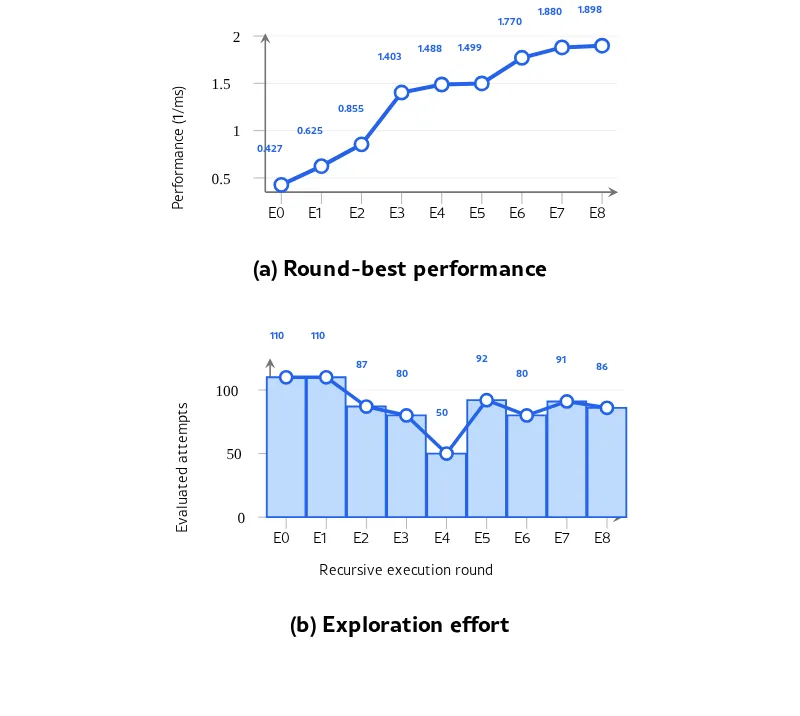
图 6:ConvDiv 上探索行为的演化。(a) 每轮最好性能;(b) 每轮评估的尝试数——策略先省算力、在进步停滞后重新加大探索。
局限性
1. 回放只能揭示已记录的结果,无法评价真正新颖的方向。这是作者自己在提示词层面写明的约束:回放中超出冻结轨迹 trace_branch_count / trace_refine_count 的计划属于 out of support,拿不到任何回放奖励。因此这台「世界模型」只在已实现(realized)的搜索空间上有效——它能重排分支、重分组并行、重设停止点,却不能为一个历史上从未尝试过的方向打分。历史池的覆盖面直接构成做梦的上限,而这与 model-based RL 里模型偏差(model bias)导致策略利用模型漏洞的问题是同一类风险。
2. 单调性保证的范围比标题给人的印象窄。$V^{m^{\star}}\geq V^{0}$ 只在「固定历史 $\mathcal{H}_t$ 上的平均回放分」意义下成立,并不等价于下一轮在线发现性能一定更好;论文也没有给出回放分与在线收益之间的相关性度量、置信区间或理论界。选择压力还可能偏向「善于在旧树上摘果子」的策略,而不是善于开新分支的策略。
3. 数学优化上的质量收益很薄,自相关一项实际略退。Dream-RSI 的 1.456375 差于固定探索的 1.456001(越低越好),圆填充与多个系统并列 2.635983,和差问题只领先第四位小数。可辩护的优势是预算(不到 1,000 次生成对 51,200 次),而不是解的质量。
4. 关键消融只覆盖单任务,超参与复现材料不足。语义引导的负面结论只在 ConvDiv 一条曲线上给出,没有跨任务、跨预算的统计显著性;$\beta_1$、$\beta_2$、$M$、$K_1$、$K_2$ 在正文中始终以符号出现,未给具体取值,beta 扫描范围也只在提示词里定性描述。加上仓库代码尚未放出,第三方复现目前只能依赖附录 B/C 的提示词与源码。
5. 评测面较窄。发现智能体只有 Gemini 系列两个型号,任务集中在算法工程、数学优化与 GPU 核工程三类可自动打分的领域;论文没有独立的 limitations 章节,上述边界需要从正文与附录里读出来。对需要真实物理交互、评估本身不可重复的任务(例如机器人实机实验),回放模拟器的适用性尚未被检验。
总结与展望
Dream-RSI 的贡献不在某个新网络结构,而在于把「历史」这个对象的地位从上下文升级成环境。三条可迁移的结论值得记住:其一,元层优化的贵不在算力,而在反馈延迟——只要能为反馈找到一个已记录的替身,闭环就能提速一到两个数量级;其二,「可执行的策略代码 + 冻结的决策接口」是让 LLM 改写自身编排层而不失控的最小结构,本文的 OptimalPolicy.solve 与 GridPlan 就是这个接口的具体形态;其三,结构化的经验重放可能比语义化的经验总结更有用,这与大量把历史摘要塞回提示词的工程直觉相反。
对机器人与具身智能场景,这套思路有一个直接对应物:真机数据采集昂贵,而一条已经执行过的技能树(含成功轨迹、失败诊断与代价记录)天然就是一个回放世界。可以在其中离线重排「先试哪条分支、并行铺多少条、何时停止」,而不必每次都在硬件上重跑;数字孪生与仿真资产进一步提供了补充历史池的手段。但同样要记住它的边界:回放世界只覆盖已实现的动作与状态,凡是需要新的物理交互才能验证的方向,仍然必须上线。换句话说,Dream-RSI 省掉的是编排层的试错成本,而不是探索本身的成本。
金句
一次昂贵的在线发现运行,可以支撑数千次零执行成本的离线策略评估——因为所有执行结果都还在那棵树里,评价一条新策略只需要读记录,不需要重跑智能体。
解读基于 arXiv:2609.14858v1 全文(含附录 A 任务定义、附录 B 提示词、附录 C 发现程序源码)。原文链接:https://arxiv.org/abs/2609.14858。