PAPER DEEP DIVE
Navi-Agent:无定位单目导航智能体
Navi-Agent 仅用单目 RGB 构建无坐标视觉锚点图,以视觉重访做地点确认、进度校验与失败恢复,R2R-CE_100 成功率 33.4%。
一句话总结
Navi-Agent 只靠一个单目 RGB 相机,把「到过哪里、怎么走的」组织成无坐标的视觉锚点图:节点是六视图视觉访问点,边是已执行的运动历史;在这张图上完成目标选择、局部执行、访问校验、探索与回溯的闭环,在 OpenNav_R2R-CE_100 上以 33.4% 成功率超过所有不使用深度与坐标的零样本方法。
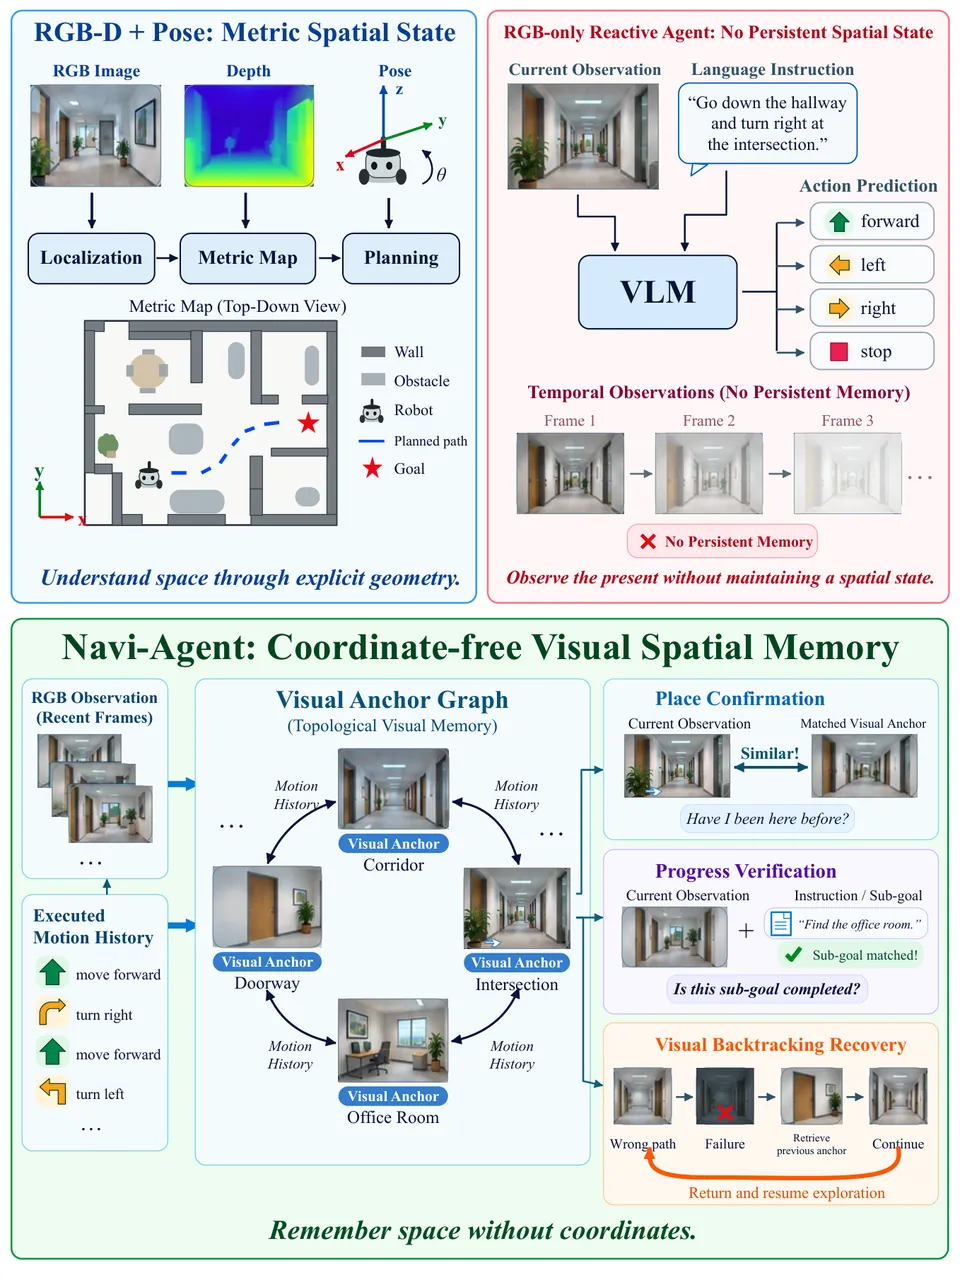
图 1:论文概念图。左上为依赖 RGB+深度+位姿的传统度量空间状态(定位、度量地图、规划);右上为仅 RGB 但无持久空间状态的反应式智能体;下方为 Navi-Agent 的坐标无关视觉空间记忆:以视觉锚点图保存地点身份与运动历史,支撑地点确认、进度校验与视觉回溯恢复,图注原文为「Remember space without coordinates」。
研究背景与动机
连续环境中的视觉语言导航(VLN-CE)要求具身智能体在未知环境中执行长时程自然语言指令:没有专家轨迹可供模仿,智能体必须一边理解指令、一边感知环境、一边在连续观测流中挑选动作。随着视觉语言基础模型的成熟,零样本 VLN-CE 已从设想变为可工程化的系统形态,Habitat 等模拟器上的 R2R-CE 基准成为主要战场。
现有零样本系统逐渐收敛到同一条范式:把长指令分解为有序子任务,为每个子任务执行局部动作,再用后续观测估计进度、更新记忆、决定阶段切换。这条范式里最关键的部件是跨时间步关联观测的空间表征——显式 BEV 或体素地图、3D 场景图、地标图等。它们让「现在看到的」与「之前看到的」可以对齐,从而支撑障碍建模、距离计算与路径规划。
但这些表征的构建都直接或间接依赖全局坐标:深度传感器、相机位姿、里程计或 SLAM/SfM 输出。为了检验基础模型自身的空间推理能力、也为了跨平台部署时摆脱传感器束缚,近期工作开始探索几何受限导航(geometry-constrained navigation):深度与全局一致坐标都不可用。在这一设定下已有两条补偿路线——DreamNav 用局部相对轨迹与预测的未来观测去比较「执行的动作」与「可能的视觉结果」;LightZeroNav 保留短期观测历史与阶段级视觉基线,靠图像级比较估计子任务进度。
这两条路线证明了局部视觉证据足以支撑动作选择与阶段推进,但仍有三件事做不好:其一,判断当前观测是否对应之前到过的地点;其二,校验刚执行的运动是否真的完成了预期转移;其三,在偏离指令后恢复到可靠位置。没有持久空间状态,这三件事都只能靠短期记忆硬撑。这正是本文的中心问题:在没有显式几何定位的前提下,智能体如何从视觉观测中维护持久空间状态、校验当前地点与任务进度、并通过视觉重访从失败中恢复?
Navi-Agent 的回答是把「基于度量定位的导航拓扑」改造成「基于导航历史的拓扑」:节点由观测到的视觉场景表示,边由已执行的运动历史表示。在这张图上,地点确认、进度校验与失败恢复都变成图上的检索与匹配操作,而不需要任何坐标。论文据此给出三项贡献:首个在几何受限零样本 VLN-CE 下构建空间状态的框架;以视觉场景为节点、运动历史为边的无坐标拓扑表征;以及融合历史视觉检索、运动历史回溯与视觉匹配确认的闭环恢复机制。
预备知识:几何受限设定下的问题定义
论文研究几何受限室内环境中的零样本 VLN-CE:智能体只有一个前向 RGB 相机,从 episode 给定初始位姿出发,按自然语言指令 $I$ 导航到目标,全程没有深度、没有度量坐标。在时刻 $t$,给定观测 $o_{t}$,策略输出
$$a_{t}=\pi(o_{t},I,\mathcal{M}_{t})\in\{\texttt{move\_forward},\texttt{turn\_left},\texttt{turn\_right},\texttt{stop}\}$$其中记忆图 $\mathcal{M}_{t}=(\mathcal{A}_{t},\mathcal{E}_{t})$ 由视觉锚点节点 $\mathcal{A}_{t}$ 与已执行运动边 $\mathcal{E}_{t}$ 构成。目标是在距目标点给定距离阈值内正确发出 stop。信息协议写得很死:深度、绝对位姿、里程计、SLAM/SfM 坐标、全局度量地图一律不可用;模拟器位姿只出现在评测端的距离计算里,策略永远看不到。
动作粒度沿用 R2R-CE 惯例:前进一步 0.25 m,转向一次 10 度,每个 episode 上限 500 个动作;成功定义为 stop 时与目标的测地距离不超过 3 m。系统组件全部是现成模块、不做任务微调:GroundingDINO 与 SAM 负责 RGB 目标定位与分割,ViNT 负责局部视觉导航,KLT 负责视觉点跟踪,冻结的 LLM/VLM 负责语言推理与视图排序。换句话说,论文的贡献不在任何一个感知模块,而在把它们组织成闭环的记忆与校验结构。
方法详解
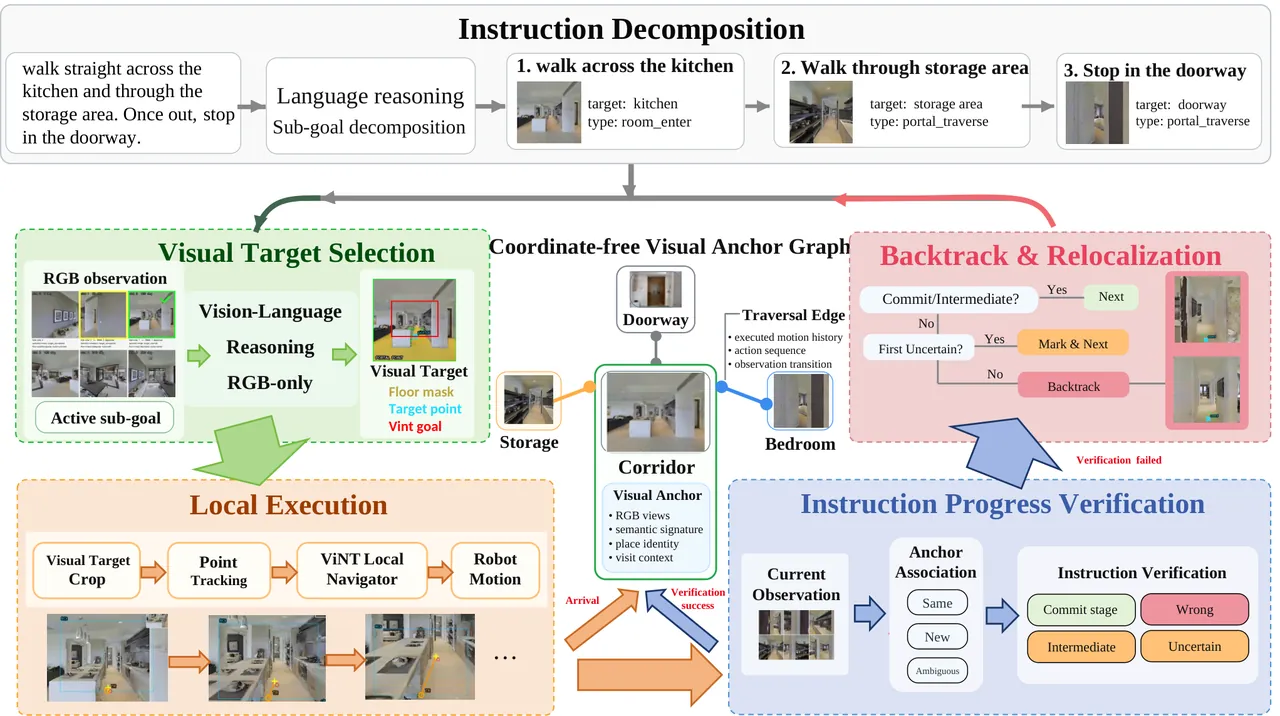
图 2:系统总览。长指令先经 Decompose 分解为有序带类型子目标;对每个活跃子目标,SelectTarget 用 VLM 对六个 RGB 视图排序并接地出视觉目标(地板掩膜、可跟踪点、ViNT 目标裁剪);ExecuteLocal 以点跟踪加 ViNT 完成运动段;每次物理停止都登记进无坐标视觉锚点图,节点保存 RGB 视图、语义签名、地点身份与访问上下文,边记录已执行运动;Associate 把新访问判为 Same/New/Ambiguous,VerifyProgress 决定 Commit/Intermediate/Wrong/Uncertain;校验失败时探索备选方向或沿记录的边回溯以重新确认父地点。
Navi-Agent 把长时程导航组织为一串「可校验的局部回路」:不直接让 VLM 预测动作,而是先确定活跃子目标、选出可执行的视觉目标、跑一段点跟踪引导的运动、再把到达的地点对照指令校验一遍。只有校验通过的阶段才推进指令;否则观测被保留下来供探索或回溯。Algorithm 1 把这个循环写成了显式伪代码,也是理解全文的骨架。
1. 指令分解:Decompose
episode 开始时,冻结的 LLM 执行 $\textit{Decompose}(I)$,把指令转成有序子目标序列
$$G=\{g_{1},\ldots,g_{N}\}$$每个子目标描述一个可独立观测的事件:到达某物体、进入某房间、穿过某门洞、沿某方向行进。子目标记录完成类型(如 room_enter、portal_traverse、portal_stop)、目标实体、空间关系或方向、序数,以及一条指令接地的视觉查询语句。论文给出的例子把「左转穿过厨房与储物区,出去后右转停在门口」拆成三个子目标,各自的视觉查询分别是「kitchen entrance doorway」「storage area entrance」「doorway on the right」。控制器只有在 VerifyProgress 返回 Commit_stage 之后才推进到下一个子目标,分解因此不是软提示而是硬状态机。
2. 视觉目标选择:SelectTarget
对活跃子目标 $g_{i}$,SelectTarget 把语言翻译成可执行的视觉目标。智能体原地旋转,采集六个间隔 60 度的标准 RGB 视图;VLM 结合子目标描述、目标实体、空间关系与可通行性线索对这六个视图排序,选出候选方向;再在粗选方向附近以正负 30 度补拍三张视图做细化,得到用于局部执行的目标图像 $v$。
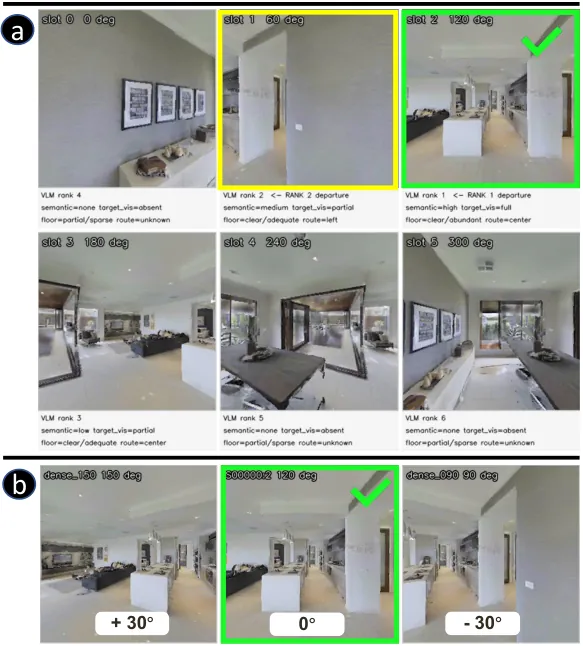
图 3:SelectTarget 的两阶段。(a) 原地旋转采集六个标准视图,VLM 依据子目标文本与可走路线证据排序,绿色为 Rank-1 出发视图、黄色为 Rank-2;(b) 在粗选方向正负 30 度范围内三视图细化,中间 0 度视图被选中。
选定视图后,开放词汇检测与分割(GroundingDINO + SAM)在 $v$ 中定位物体实例;对门洞、走廊、楼梯等目标,地板掩膜提供可通行区域。函数最终输出 $(v,p)$,其中 $p$ 是所选 RGB 观测中的一个可跟踪点。论文特别强调:这是一个视觉参考,而不是坐标定义的 waypoint——它没有坐标,只有「在图像里跟着它走」的操作语义。
3. 局部执行:ExecuteLocal
$\textit{ExecuteLocal}(v,p,g)$ 初始化 KLT 点跟踪器,并把 $p$ 周围的裁剪图喂给预训练的 ViNT 局部导航器。跟踪器在每一帧 RGB 中更新点的位置,目标裁剪随之移动,ViNT 依据当前视觉状态选择前进与转向动作。该模块只做短程连续运动,不做长时程规划。Algorithm 1 中的两步更新即
$$(v,p)\leftarrow\textit{SelectTarget}(o_{t},g,\mathcal{M})$$ $$(s_{\mathrm{exe}},o_{\mathrm{stop}},a_{\mathrm{local}})\leftarrow\textit{ExecuteLocal}(v,g)$$到达判定完全由点跟踪几何触发,这是全文最干脆的设计之一:对物体、地板与路线点,当有效跟踪点向下移动并从 RGB 观测的下边界退出(bottom_exit)时,判定到达所选局部视觉目标,返回 $s_{\mathrm{exe}}=\texttt{Arrival}$、局部动作序列 $a_{\mathrm{local}}$ 与停止观测 $o_{\mathrm{stop}}$。VLM 推理、深度估计、模拟器位姿都不触发该事件;它只表示局部视觉运动结束,任务是否完成要等物理停止之后由校验环节决定。反之,跟踪点离开图像边界或丢失即返回 $s_{\mathrm{exe}}=\texttt{Failure}$,进入探索或回溯分支。
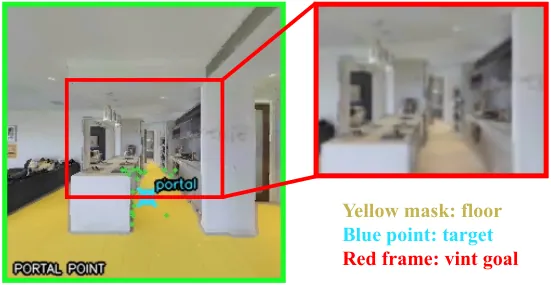
图 4:ExecuteLocal 的目标构造。左为所选视图 $v$,黄色为地板掩膜、蓝色为被跟踪目标点 $p$(portal point);右为 $p$ 周围的目标裁剪(红框),喂给 ViNT 局部导航器;跟踪器逐帧更新 $p$,裁剪跟随移动,直到 $p$ 从图像底部退出。
4. 锚点构建:BuildVisit 与锚点图
对停止观测 $o_{\mathrm{stop}}$,BuildVisit 采集一次六视图 RGB 扫描($0^{\circ},60^{\circ},\ldots,300^{\circ}$),存为一条 visit,内容包括六张视图、子目标上下文、语义描述与运动证据。未见过的地点初始化一个新的 AnchorNode;重访地点则并入已有锚点。每个锚点保存规范访问、视觉特征、语义签名与六个相对方向槽;已执行的运动与观测被记录为有向 TraversalEdge。
由此得到的锚点图在无显式坐标的前提下维护地点身份与已确认转移。论文同时诚实指出其表达力的边界:方向槽没有距离、也没有全局角度;前向边不蕴含反向路径——从 A 走到 B 的记录,并不自动告诉你怎么从 B 走回 A,回程要靠回溯机制另行建立。
5. 地点关联:Associate
$\textit{Associate}(\textit{visit},\mathcal{M})$ 执行由粗到细的 RGB 地点关联:先做全局描述子检索并配合循环视图对齐(cyclic view alignment),再用 RANSAC 局部特征匹配细化,最后做语义验证。输出三态
$$\textit{state}\in\{\texttt{Same},\texttt{New},\texttt{Ambiguous}\}$$Same 表示重访已知地点,New 表示新地点,Ambiguous 表示证据不足。歧义访问会被保留在记忆中,但既不能推进指令,也不能作为回溯目标——这一约束防止系统在没把握的地方把错误固化进图结构。
6. 进度校验:VerifyProgress
$\textit{VerifyProgress}(g,\textit{state},\textit{visit},\mathcal{M})$ 接收运动完成情况、访问关联结果,以及子目标的目标实体、完成类型、空间关系与历史。Associate 决定「视觉地点状态」,VerifyProgress 决定「该状态是否满足当前指令阶段」,输出四态
$$\textit{decision}\in\{\texttt{Commit\_stage},\texttt{Intermediate},\texttt{Wrong},\texttt{Uncertain}\}$$满足完成条件即 Commit_stage,控制器推进 $G$;地点确认无误但子目标尚未完成则记为 Intermediate,存为锚点但不推进指令;Wrong 与 Uncertain 都不推进任务,转而触发探索或回溯。把「地点对不对」与「阶段完没完成」拆成两个判断,是这套校验结构能复用的关键:同一个 Associate 结果可以服务进度校验,也可以服务回溯后的重定位确认。
7. 探索与回溯:Explore 与 Backtrack
进度未提交时,CanExplore 检查当前锚点是否还有探索预算;有则 Explore 选一个新方向,再次调用 SelectTarget 与 ExecuteLocal。被拒绝的方向会记录在锚点记忆中,同一子目标下不会重复探索。当探索预算耗尽、或当前分支被判定与指令不一致时,系统激活 Backtrack。
与几何回溯不同,Backtrack 不依赖位姿或度量地图。每次锚点转移都保存了局部执行期间的历史 RGB 观测与运动轨迹;恢复时,智能体检索历史观测,把当前视图与存储轨迹匹配,从匹配到的历史状态中恢复出一个视觉目标 $(v^{\prime},p^{\prime})$,再复用 ExecuteLocal 迭代地返回先前地点;若找不到可靠的视觉对应,恢复过程终止。每完成一步恢复,BuildVisit 与 Associate 都会校验返回位置:只有与目标锚点判为 Same 的返回才被接受,歧义或错误返回被拒绝。回到确认锚点后,失败方向仍留在记忆里,SelectTarget 会在同一子目标下改选其他候选。
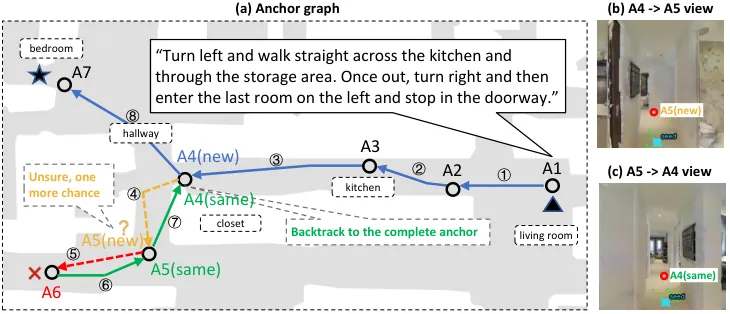
图 5:无坐标锚点图与视觉回溯。(a) 锚点 A1 至 A7 由 BuildVisit 从六视图 RGB 访问创建,按执行顺序以有向 TraversalEdge(蓝色实线编号)相连,房间标签即 Associate 使用的语义签名;在 A5 处分支先被判为不确定(橙)后失败(红)。(b) 边 A4 到 A5 存储的出发视图。(c) 沿同一条边 Backtrack 返回后的视图,Associate 把返回访问判为与 A4 相同(SAME,绿),从而提交反向边并从 A4 恢复探索。俯视图仅用于可视化,策略永远拿不到。
8. 闭环结构一览
把上述模块串起来,就是 Algorithm 1 的主循环:对每个子目标,只要 decision 不是 Commit_stage,就选目标、执行、登记访问、关联、校验;执行失败或校验未通过则探索或回溯。下图按论文真实控制流绘制:
flowchart TD
    A["Decompose I
ordered typed sub-goals G"] --> B["SelectTarget
six RGB views at 60 deg
VLM ranking then refine at plus/minus 30 deg
GroundingDINO + SAM gives v and p"]
    B --> C["ExecuteLocal
KLT tracking + ViNT
bottom_exit means Arrival
lost point means Failure"]
    C -->|Failure| E["Explore within budget
rejected directions recorded"]
    C -->|Arrival| D["BuildVisit
six-view scan 0 to 300 deg
new AnchorNode or merge"]
    D --> F["Associate
descriptor retrieval + cyclic alignment
RANSAC matching + semantic check
Same or New or Ambiguous"]
    F --> G["VerifyProgress
Commit_stage or Intermediate
or Wrong or Uncertain"]
    G -->|Commit_stage| H["advance to next sub-goal"]
    G -->|Intermediate| E
    G -->|Wrong or Uncertain| E
    E -->|budget left| B
    E -->|budget exhausted or branch inconsistent| I["Backtrack
match current view to stored edge RGB + motion
reuse ExecuteLocal with recovered target
accept only Same on return"]
    I --> B
    H -->|all sub-goals committed| J["stop"]
这张图里最值得注意的不是主干,而是两条回边:Explore 把未通过的观测留在图里继续试错,Backtrack 把智能体沿历史边送回已确认锚点。二者都消费同一张锚点图,也都往同一张锚点图写回结果——记忆因此既是决策依据又是决策产物,闭环由此成立。
实验结果
主结果:无深度无坐标下的最优成功率
评测在 Habitat 的 R2R-CE 上进行,使用 OpenNav 协议修正后的 100 条 val_unseen episode 子集(OpenNav_R2R-CE_100)。指标为成功率 SR(stop 于目标 3 m 测地距离内)、Oracle 成功率 OSR、导航误差 NE 与路径效率 SPL。下表按是否直接使用深度与坐标/位姿分组对比:
| 方法 | 深度 | 坐标/位姿 | SR ↑ | OSR ↑ | NE ↓ | SPL ↑ |
|---|---|---|---|---|---|---|
| MapGPT-CE | 是 | 是 | 7.0 | 21.0 | 8.16 | 5.04 |
| DiscussNav | 是 | 是 | 11.0 | 15.0 | 7.77 | 10.51 |
| InstructNav | 是 | 是 | 31.0 | – | 6.89 | 24.00 |
| Open-Nav | 是 | 是 | 16.0 | 23.0 | 7.25 | 12.90 |
| CA-Nav | 是 | 是 | 25.3 | 48.0 | 7.58 | 10.80 |
| SmartWay | 是 | 是 | 29.0 | 51.0 | 7.01 | 22.46 |
| Fast-SmartWay | 是 | 是 | 27.8 | – | 7.72 | 24.95 |
| DreamNav | 是 | 否 | 32.8 | 41.0 | 7.06 | 28.95 |
| LightZeroNav | 否 | 否 | 27.0 | 39.0 | 7.45 | 20.00 |
| Navi-Agent(本文) | 否 | 否 | 33.4 | 48.3 | 5.79 | 18.73 |
表 1:OpenNav_R2R-CE_100 上与零样本 VLN-CE 方法的对比;Y/N 表示策略是否直接使用深度或坐标/位姿信息。
三个读数值得展开。第一,Navi-Agent 的 33.4% SR 不仅是不用深度/坐标方法中的最高值,也超过了表中所有使用度量先验的方法,包括 SmartWay 的 29.0 与 InstructNav 的 31.0;NE 5.79 m 同样是全表最低,说明失败 episode 里它也停得离目标更近。第二,OSR 48.3 低于 SmartWay 的 51.0,意味着轨迹曾到达目标区域的比例并非第一,部分潜力在「到过但没停对」上损失。第三,SPL 18.73 明显低于 DreamNav 的 28.95 与 Fast-SmartWay 的 24.95——回溯与探索会绕路,路径效率是这套恢复机制明码标价的成本,后文的消融把这笔账算得更清楚。
消融:语义骨干与锚点图的价值
更换 VLM 骨干而固定其余配置,三种模型都能达到或超过基线水平,其中开源的 Qwen3.6-Plus 以 33.4% SR 取得最佳,闭源的 GPT-5.6-sol 与 GPT-5.5 分别为 26.3 与 28.6。作者据此提出一个附带观察:这套系统对骨干模型的空间判断足够敏感,未来或可作为评测多模大模型具身能力的基准。
| 语义模型 | SR ↑ | OSR ↑ | NE ↓ | SPL ↑ |
|---|---|---|---|---|
| Qwen3.6-Plus(开源) | 33.4 | 48.3 | 5.79 | 18.73 |
| GPT-5.6-sol(闭源) | 26.3 | 46.6 | 6.50 | 18.37 |
| GPT-5.5(闭源) | 28.6 | 47.3 | 6.24 | 16.82 |
表 2:VLM 骨干消融,其余模块与评测协议固定。
锚点图与恢复策略的消融更直接地回答了「这张图值不值」。完全禁用图构建与恢复(w/o anchor graph and recovery)时,智能体退化为贪心前进直到主动停止或步数上限,SR 降到 28.33,但 SPL 反而升到全表最高的 22.45——不回溯自然不走回头路。把回溯深度从 1 hop(完整系统,SR 33.43)放宽到 2 hop 与 3 hop,SR 骤降到 21.67 与 14.67:多 hop 恢复让图沿错误分支过度扩张、误差复合放大。论文的结论是受限的 1 hop 恢复在纠错与路径简洁之间取得了最优平衡;换句话说,恢复能力是真实的,但恢复的「半径」必须被刻意限制。
| 配置 | SR ↑ | OSR ↑ | NE ↓ | SPL ↑ |
|---|---|---|---|---|
| 无锚点图与恢复 | 28.33 | 46.33 | 5.64 | 22.45 |
| 1 hop(完整 Navi-Agent) | 33.43 | 48.33 | 5.79 | 18.73 |
| 2 hops | 21.67 | 40.33 | 6.58 | 14.39 |
| 3 hops | 14.67 | 32.67 | 9.83 | 11.72 |
表 3:探索与恢复策略消融;本基准上完整系统使用 1 hop 探索预算。
空间状态本身可靠吗:回溯与地点确认
为独立检验锚点图作为空间记忆的质量,论文设计了不依赖指令的回溯评测:给定轨迹段,智能体仅凭存储的视觉目标与运动历史返回先前锚点,返回成功以指示函数
$$\mathbb{I}\!\left(d(p_{\mathrm{return}},p_{\mathrm{anchor}})<\delta\right)$$定义。结果是返回位置误差 2.32 m、物理重访成功率 80.3%——在完全无位姿的条件下,这个精度足以支撑「回到上一个确认地点再换方向」的恢复语义。视觉地点确认一侧,Acc 0.71、Prec 0.68、Recall 0.75、F1 0.71,说明 Associate 能在视觉相似地点之间做出多数正确的区分,但仍有约三成判断需要靠 Ambiguous 态与后续校验兜底。
| 评测 | 指标 | Navi-Agent |
|---|---|---|
| 物理重访 | 返回误差 ↓(m) | 2.32 |
| 物理重访 | 返回成功率 ↑(%) | 80.3 |
| 视觉地点确认 | Acc / Prec / Recall / F1 | 0.71 / 0.68 / 0.75 / 0.71 |
表 4:空间状态校验与恢复评测,对应论文 Table IV。
真机部署与延迟
真机实验在室内图书馆完成,平台为 AGV 与轮腿机器人各一台,两者都只有单目 RGB 相机,无深度、无 IMU、无先验地图;固定控制间隔下前进步长约 0.5 m、转向正负 30 度,平台差异只体现在相机高度与运动学。两个目标导向任务从同一房间出发:T1 出房间右转停在木门(10.5 m),T2 出房间沿走廊停在绿植旁(21.5 m)。两平台成功率都在 0.7 到 0.8 之间;初期失败集中在复杂出口与转弯处,1 hop 探索触发后恢复模块成功回溯到正确拓扑节点并完成导航,长时程任务上恢复成功率达 2/2。跨平台一致性说明这套无地图、无深度框架对 embodiment 差异不敏感。
| 任务 | 距离(m) | AGV 成功 | AGV 恢复 | 轮腿成功 | 轮腿恢复 |
|---|---|---|---|---|---|
| T1:出口→右转→木门 | 10.5 | 8/10 | 2/2 | 8/10 | 1/1 |
| T2:出口→走廊→绿植 | 21.5 | 7/10 | 2/2 | 8/10 | 2/2 |
表 5:真机部署结果;Succ. 为 10 次试验成功数,Rec. 为恢复成功/触发次数。
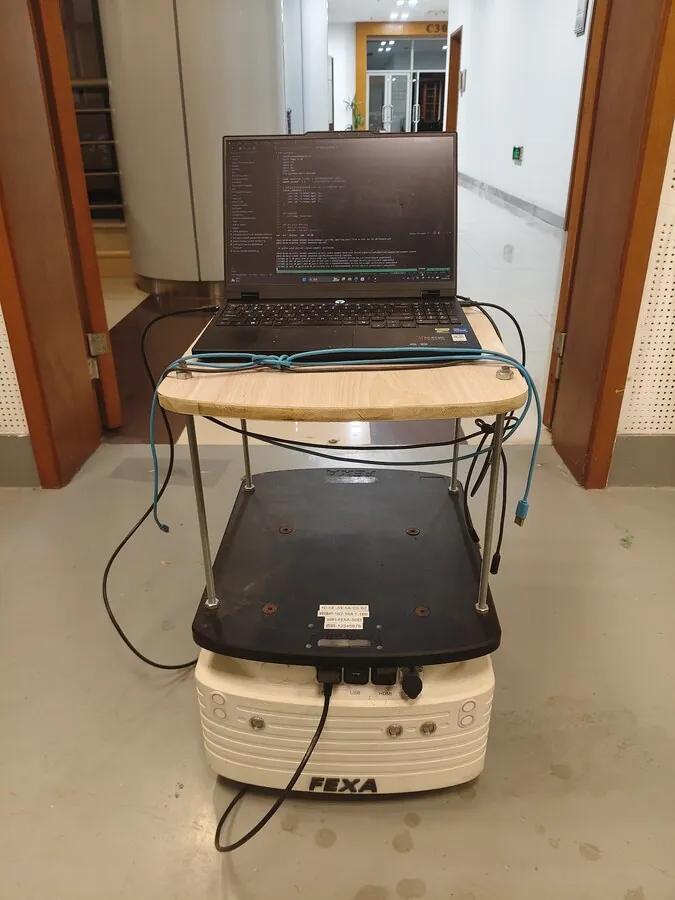
图 6:真机部署平台之一:图书馆走廊中的 AGV,顶部笔记本运行整套 Navi-Agent 流水线,传感仅为一台前向 RGB 相机。
延迟分析给出每个导航循环的成本:视觉目标选择(VLM)8.3 s,局部执行每步 0.2 s,锚点构建与图更新 4.6 s,进度校验 3.7 s,回溯与视觉重访为上述之和。一次「选目标—走一段—登记—校验」的循环约 17 s,说明当前系统面向的是正确性与恢复能力的验证,而非实时控制;VLM 调用是最大单项开销。
| 组件 | 延迟 |
|---|---|
| 视觉目标选择(VLM) | 8.3 s |
| 局部执行(ViNT + 跟踪) | 0.2 s/步 |
| 锚点构建与图更新 | 4.6 s |
| 进度校验 | 3.7 s |
| 回溯与视觉重访 | 上述之和 |
表 6:导航循环各组件延迟,按 episode 平均。
局限性
第一,锚点图的表达力有明确边界,这是作者自述的限制:方向槽不含距离与全局角度,前向边不蕴含反向路径;被保留的 Ambiguous 访问既不能推进指令也不能作为回溯目标;若找不到可靠视觉对应,恢复过程直接终止。作者把未来工作指向更高层的语义空间记忆与推理——从「转移记录」走向「空间关系推断」与歧义配置下的推理。
第二,恢复半径与成功率强耦合,这是消融暴露的结构性脆弱:1 hop 预算下 SR 33.43,放到 2 hop 即跌到 21.67、3 hop 只剩 14.67。恢复机制本身有效(真机 2/2 恢复),但「多退一步」在当前图结构下几乎必然引入复合误差,说明锚点图还不足以支撑多跳层的拓扑推理,预算是被实验逼出来的硬约束而非设计选择。
第三,地点关联精度与效率账还有空间:Associate 的 F1 为 0.71,在视觉相似地点(同层重复走廊、相似门洞)上仍有约三成错误需要靠 Ambiguous 态与重试兜底;SPL 18.73 低于同样不用坐标的 DreamNav(28.95),回溯绕路的代价在主结果里清晰可见;单循环约 17 s 的延迟也使系统离实时部署尚远。此外主结果只在 100 条 episode 的子集上报告,真机仅两个任务各 10 次试验,规模上仍是原理验证。
总结与展望
Navi-Agent 的核心主张可以一句话概括:空间状态不必是坐标的函数,也可以是历史的函数。用视觉访问点做节点、用执行过的运动做边,地点确认、进度校验与失败恢复就都成为图上的检索与匹配问题;bottom_exit 到达判定与 Same-only 回溯接受准则,则把「什么时候算到了」「什么时候算回去了」这两件最容易含糊的事变成了可判定的几何与匹配条件。在零样本、无深度、无坐标的严格设定下,这套结构拿到了 33.4% SR 与 5.79 m NE,并在两种真机平台上复现。
对机器人开发者而言,这篇工作的可借鉴处在于记忆结构的取舍:它没有追求更丰富的地图,而是刻意保留了一张表达力有限但每条边都可验证的图,并把所有不确定性显式地放进 Ambiguous 与 Uncertain 两个态里。作者指出的下一步——从转移记录升级到语义空间关系推理——恰好是这张图目前最缺的一层;而 1 hop 预算的脆弱性也提示,多跳恢复需要的可能不是更大的预算,而是带距离与方向语义的更强边。