PAPER DEEP DIVE
MemoryVLN:分层记忆驱动视觉语言导航
MemoryVLN 以遗忘曲线压缩、位姿感知表示与分层记忆库,将长时程导航历史变为可检索复用的经验,成功率提升约 2% 与 6.5%。
论文元信息
标题:MemoryVLN: From Ego-Aware Memory Representation to Cross-Context Memory Reuse in Vision-Language Navigation(MemoryVLN:从自我中心感知的记忆表示到跨上下文记忆复用的视觉语言导航)
作者:Xueyao Wei, Yifei Wang, Delun Li, Shaoan Wang, Junzhi Yu, Wenjie Song, Xingyu Chen(北京理工大学 / 中关村学院 / 北京大学)
链接:arXiv arxiv.org/abs/2610.18478 · 代码 github.com/ZGCA-HMI-Lab/MemVLN · 项目页 zgca-hmi-lab.github.io/MemVLN · 模型卡 huggingface.co/xiaoxiaoxiaoyyy/MemVLN
代码状态:已发布,但仅发布评测代码。仓库包含 Habitat VLN-CE 闭环评测入口、记忆模块实现与配置清单;训练脚本与模型权重未随仓库提供(论文附录说明权重因 50MB 上传限制被省略),复现需自行按附录 A.3 的配置重训。
一句话总结
MemoryVLN 把长时程视觉语言导航的历史观测改造成一种分层记忆:用遗忘曲线抽样压缩序列、用 2D 外观 + 3D 几何 + 6D 位姿给每条记忆打上"在哪里看到"的烙印、用情景内双池加跨情景记忆库管理存取,再按当前状态检索 Top-K 记忆残差融合进当前帧,从而在 R2R-CE 与 RxR-CE 上比数据可比的最强基线分别高出约 2% 与 6.5% 的成功率。
研究背景与动机
视觉语言导航(VLN)要求机器人仅凭第一人称 RGB 观测和一句自然语言指令,在未见过的室内环境中走到目标位置。连续环境基准 VLN-CE(R2R-CE 与 RxR-CE)把动作空间限制为前进、左转、右转、停止四个离散动作,一条轨迹动辄上百步,RxR 的指令更是长达数十词的跨语言描述。这类长时程任务对基于大视觉语言模型(LVLM)的导航策略提出了一个尖锐的工程矛盾:模型的上下文窗口是有限的,而观测流是无限增长的。
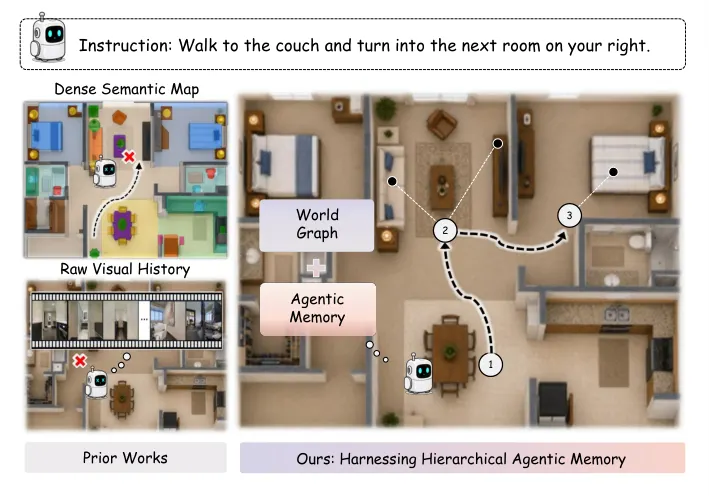
现有做法大致分三类。第一类直接把全部历史帧塞进上下文,轨迹一长就触发显存溢出或注意力稀释;第二类把历史压成固定长度的隐状态或拓扑地图,压缩是不可逆的,一旦丢弃就再也找不回某个关键路口的视觉证据;第三类依赖深度图、全景图或预先构建的语义地图,把空间对齐的负担转嫁给传感器与建图模块。MemoryVLN 的观察是:这三类做法都没有回答"哪些观测值得留下、留下时如何记录它的位置、留下之后又如何在需要时取回"这三个连续的问题。
作者把这三个问题组织成记忆构建与记忆管理两个阶段。构建阶段负责压缩与表示:Long Sequence Compression 在有限 token 预算下保留"近期密集、远期稀疏但有代表性"的观测;Ego-Aware Visuospatial Representation 把 ViT 的 2D 语义 token、冻结 VGGT 的 3D 几何 token 与 6D 位姿编码绑定在一起,使每条记忆同时携带"看到了什么"和"在哪里看到"。管理阶段负责存取:Hierarchical Memory Bank 用情景内短期/长期双池保存当前轨迹的证据,用跨情景的 Context-Level Bank 保存环境级经验,并通过 warm start 与置信门控写回连接两者;Memory Enhancement 在每一步按当前状态检索最相关的 Top-K 记忆并融合进当前帧 token。
这个设计的动机还有一层现实约束:它不引入任何额外导航数据,也不做 DAgger Rollout。训练只使用标准 VLN 轨迹,几何分支 VGGT 全程冻结,可训练的部分只有视觉投影、记忆融合与动作预测头。换言之,论文声称的收益不来自数据规模,而来自"如何组织历史"这一结构性选择,这使它与依赖大规模跨任务预训练的方法处在不同的比较维度上。
与相关工作的边界也值得说清。世界模型通过预测未来来支持规划,但不解决历史证据的保留与检索;语义地图与 BEV 表示显式组织地标关系,但通常依赖深度或预建地图且只服务于单集定位;DUSt3R 与 VGGT 提供强几何先验,但它们只是感知骨干,不决定哪些观测应当存活。MemoryVLN 的定位是把冻结的几何先验装进一个可压缩、可检索、可更新的记忆结构里,让历史观测真正参与当前决策。
预备知识
在 VLN-CE 设定中,智能体在第 t 步收到观测 o_t(单目 RGB 图)与指令 I,从离散动作集中选择 a_t。长时程决策需要的不仅是当前观测,还有轨迹内积累的证据与同环境中过往情景的经验。MemoryVLN 因此把策略显式写成条件于两个记忆库的形式,而不是条件于完整历史。
骨干网络是 Qwen2.5-VL(7B),负责把指令 token 与视觉 token 映射为动作分布;几何分支采用 VGGT,从多视角图像回归相机位姿与点云特征,训练中完全冻结。评测指标为导航误差 NE、Oracle 成功率 OS、成功率 SR、路径加权成功率 SPL 与归一化动态时间规整 nDTW,均在 Matterport3D 场景的 val-unseen 分割上报告。
序列压缩的灵感来自 Ebbinghaus 遗忘曲线:记忆强度随时间指数衰减,因此越久远的观测保留概率越低。论文把这条心理学曲线改造成一个确定性的两级抽样预算:块间按指数衰减分配帧配额,块内再按同样的衰减做关键帧抽样,从而在数学上保证"近期密集、远期稀疏"。
方法详解
总体策略:条件于记忆而非历史
MemoryVLN 的策略定义为
$$a_t \sim p_\theta\left(a_t \mid I,\ o_{\leq t},\ \mathcal{B}^{\mathrm{epi}}_t,\ \mathcal{B}^{\mathrm{ctx}}\right)$$
其中 o_≤t 是经过压缩后的观测序列,B^epi_t 是情景内记忆库,B^ctx 是跨情景记忆库。指令 token 全程不被压缩,只有不断增长的视觉历史被选择性保留。压缩、位姿注入、记忆维护、Top-K 增强与置信门控写回都在闭环推理中在线执行;情景内库每集重置,上下文库在同一环境范围内持续存在,这种非对称生命周期防止单集的瞬时动作噪声跨集传播,同时允许可靠的环境经验随时间累积。
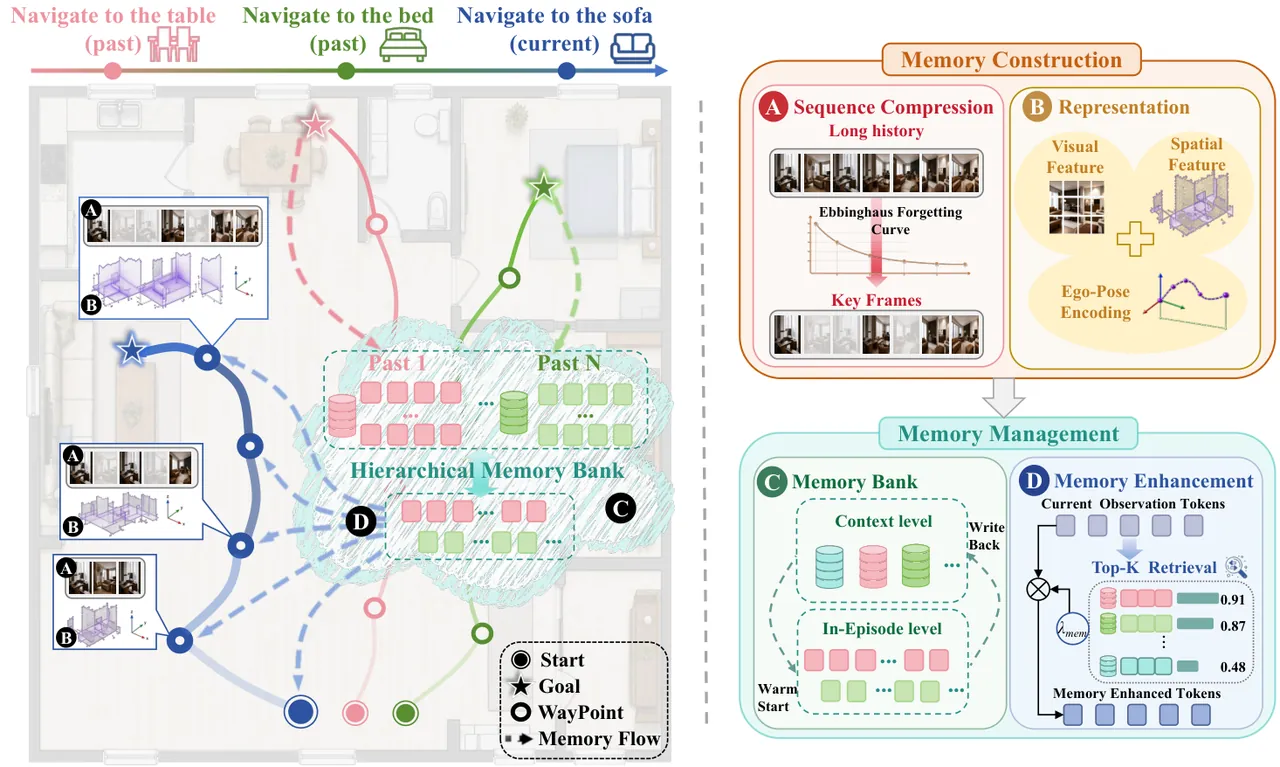
图1:概念总览。左侧为同环境中多条历史轨迹(粉/绿)与当前轨迹(蓝)共享一个分层记忆库;右侧为记忆构建(压缩 + 表示)与记忆管理(记忆库 + 增强)两阶段四模块。
模块一:长序列压缩(两级 Ebbinghaus 抽样)
第一级决定"总共留多少帧"。给定已观测 N 帧,全局预算为
$$B(N) = \min\left\{N,\ \max\left[B_{\min},\ a + b\sqrt{N}\right]\right\}$$
平方根增长使预算随轨迹长度亚线性扩张:N=100 时约 24 帧,N=200 时约 32 帧(a=4, b=2, B_min=16,见附录表 3)。第二级决定"这些配额怎么分"。历史被切成大小为 8 的块,块 i 的年龄 age_i 定义为距最新块的块数,块间权重与初始配额为
$$w_i = \exp\left(-\mathrm{age}_i / S_{\mathrm{inter}}\right), \qquad M_i^{(0)} = \min\left\{|C_i|,\ \lfloor B(N)\,\hat{w}_i \rfloor\right\}$$
其中 ŵ_i 是归一化权重,S_inter=3.0 控制衰减速度。配额取整后的余量先按最大小数部分、再按轮转方式补齐,且每块配额不超过该块实际帧数。第三级在块内做关键帧抽样,帧 k 的被选概率为
$$p_{i,k} = \frac{\exp\left(-\mathrm{age}_{i,k} / S_{\mathrm{intra}}\right)}{\sum_{j \in C_i} \exp\left(-\mathrm{age}_{i,j} / S_{\mathrm{intra}}\right)}$$
S_intra=5.0 比块间更平缓,保证块内仍保留若干有代表性的远帧。最后 EnsureFirstLast 强制保留首帧与最新帧:首帧锚定轨迹起点,最新帧是当前决策的直接依据。消融显示去掉整个压缩模块在两个基准上都直接 OOM——压缩在这里不是效率优化,而是长时程推理能跑起来的前提。
模块二:自我中心感知的视觉空间表示
被保留的帧要变成"带位置的记忆"。2D 分支取 ViT 视觉 token T^2D,3D 分支取冻结 VGGT 输出的几何 token T^3D,二者与 6D 位姿 p=[x, y, z, roll, pitch, yaw] 的正弦编码 φ(p) 融合:
$$V = Z^{\mathrm{2D}} + \lambda_{\mathrm{geo}} \cdot \mathrm{Align}\left(Z^{\mathrm{3D}}\right), \quad Z^{\mathrm{2D}}_t = \mathrm{Merge2D}\left(T^{\mathrm{2D}}_t + B(\phi(p_t))\right)$$
位姿编码以加性方式注入 2D 与 3D 两条流,使外观相同的走廊在不同坐标下产生不同的记忆 token。消融中恢复位姿编码可让 R2R-CE 的 SR 与 SPL 分别回升 2.01 与 1.01 个点、NE 降到 3.52,RxR-CE 的 nDTW 回升 1.51 个点,验证了位姿在区分"视觉相似但位置不同"观测上的作用。源码中该编码由 position_encoding.py 的 PositionEmbeddingSine6D 实现,输入张量最后一维必须为 6,否则直接抛错。
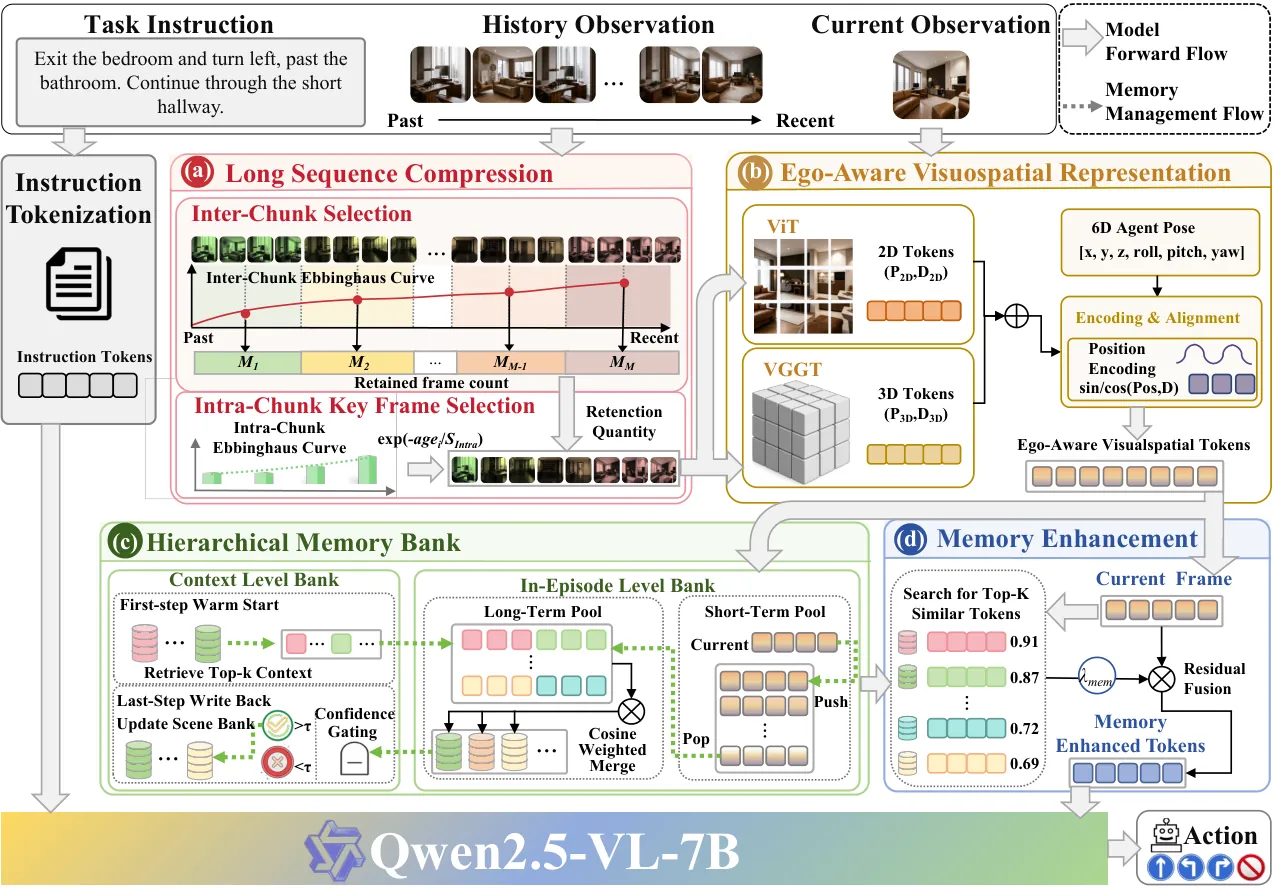
图2:详细流水线。(a) 块间预算分配 + 块内关键帧抽样;(b) ViT 2D token、VGGT 3D token 与 6D 位姿正弦编码融合;(c) 上下文级记忆库(warm start、置信门控写回)与情景内双池(FIFO 短期池、余弦加权合并的长期池);(d) Top-K 检索与残差融合,最终送入 Qwen2.5-VL-7B 输出动作。
模块三:分层记忆库与跨上下文复用
情景内库分两池:短期池按 FIFO 原样保留最近 4 帧的完整 patch,长期池容量 12,新帧进入时按余弦相似度对旧条目做加权合并,被合并的条目年龄与使用计数同步更新。跨情景的 Context-Level Bank 容量 300,条目以"场景键 + 场景值"形式保存,满时按 LRU 替换。
场景键混合视觉与语言两路信息,避免纯视觉键在相似房间间串味:
$$k = \mathrm{Norm}\left((1-\beta)\,\mathrm{Norm}(k^v) + \beta\,\mathrm{Norm}(k^I)\right)$$
代码默认 β=0.3(scene_key_lang_weight),即语言占三成权重。新情景的第一步执行 warm start:检索余弦相似度超过阈值 0.6 的场景值 c*,与当前首帧 token 均值 x_0 混合成初始隐状态
$$h_0 = (1-\tau_w)\,x_0 + \tau_w\, c^*, \qquad \tau_w = 0.5$$
情景结束时的写回不是无条件的。只有当短、长两池的平均帧置信度均值越过阈值 δ=0.4 时,本集总结才允许进入场景库:
$$\gamma = \tfrac{1}{2}\left[\mathrm{Mean}(c_s) + \mathrm{Mean}(c_l)\right] \geq \delta$$
这道门把"走得乱七八糟的一集"挡在环境经验之外。源码 memory.py 的 finalize_episode_write_back 与该式逐字对应:先算 0.5*(sc+lc),低于 memory_writeback_conf_threshold 就直接返回 False,并可在 MEM_DEBUG=1 时打印跳过原因;retrieve_scene_prior 则实现阈值 0.6 的余弦检索与命中后的 LRU 时钟更新。
模块四:记忆增强(Top-K 检索 + 残差融合)
每一步决策前,当前帧的帧级表示 q_t 对记忆池做余弦检索,取 Top-K(默认 K=16)条记忆,注意力权重与增强向量为
$$\alpha_{t,j} = \mathrm{softmax}\left(\cos(q_t, m_j)/\tau_m\right), \quad \bar{m}_t = \sum_j \alpha_{t,j}\, m_j, \quad v^{\mathrm{mem}}_t = (1-\rho)\,q_t + \rho\,\bar{m}_t$$
随后以残差方式写回当前帧的全部 token:先对每帧 token 做平均池化得到帧级表示,在帧级完成融合,再把帧级偏移量广播回帧内每个 token,即 Ṽ = V + λ_mem (V^mem − V)。这种"帧级检索、token 级广播"的折中既让检索粒度与记忆粒度对齐,又保留帧内空间结构。τ_m=0.2 使注意力尖锐化,ρ=0.2(update_ratio)限制记忆对当前观测的改写幅度,避免历史证据压过眼前画面。
flowchart TD
  O[历史观测流 o_1 到 o_t] --> A[长序列压缩
全局预算 B N 平方根增长
块间指数配额 + 块内关键帧抽样
强制保留首帧与最新帧]
  A --> B[自我中心视觉空间表示
ViT 2D token 加 冻结 VGGT 3D token
加 6D 位姿正弦编码]
  B --> S[情景内记忆池
FIFO 短期池 4 帧
余弦加权长期池 12 帧]
  B --> C[上下文级记忆库
容量 300 满时 LRU 替换
键为视觉与语言混合]
  C -->|首步检索 相似度阈值 0.6| W[warm start
h0 混合首帧均值与场景先验
tau 0.5]
  W --> Q[当前帧 token]
  S --> R[Top-K 检索
softmax 余弦相似度 除 tau_m]
  Q --> R
  R --> F[残差融合
帧级偏移广播回 token
V 加 lambda_mem 乘 V_mem 减 V]
  S -->|集末置信门 gamma 阈值 0.4| C
  F --> P[Qwen2.5-VL 动作预测
前进 左转 右转 停止]
上图即论文方法的执行顺序:压缩与表示属于记忆构建,双池、场景库、warm start、写回门与 Top-K 融合属于记忆管理,两条虚线(首步 warm start、集末写回)正是跨上下文复用的进出通道。
实验结果
主结果在 R2R-CE 与 RxR-CE 的 val-unseen 分割上报告。MemoryVLN 只用单目 RGB、不用 DAgger、不加额外导航数据;对照方法按各自发表设置评测,因此带星号的行(使用 waypoint predictor 或额外数据)并非完全数据可比。与同样只吃 VLN-CE 专家轨迹的 JanusVLN 相比,MemoryVLN 把 R2R-CE 的 NE 从 5.17 压到 3.52(降幅约 32%),SR 从 52.8 提到 54.76;RxR-CE 上 SR 从 51.4 提到 57.84、SPL 从 44.3 提到 50.42、nDTW 从 59.1 提到 63.52,即论文摘要所说的约 2% 与 6.5% 的成功率增益。
| 方法 | R2R NE↓ | R2R OS↑ | R2R SR↑ | R2R SPL↑ | RxR NE↓ | RxR SR↑ | RxR SPL↑ | RxR nDTW↑ |
|---|---|---|---|---|---|---|---|---|
| Reborn* | 5.40 | 57.0 | 50.0 | 46.0 | 5.98 | 48.6 | 42.0 | 63.3 |
| COSMO | 5.58 | 53.3 | 47.0 | 42.7 | 6.24 | 48.7 | 40.9 | – |
| StreamVLN-RGB-only | 5.10 | 64.0 | 55.7 | 50.9 | 6.16 | 51.8 | 45.0 | 62.1 |
| NaVILA | 5.22 | 62.5 | 54.0 | 49.0 | 6.77 | 49.3 | 44.0 | 58.8 |
| InternVLA-N1 | 4.89 | 60.6 | 55.4 | 52.1 | 6.41 | 49.5 | 41.8 | 62.6 |
| JanusVLN†(数据可比) | 5.17 | 58.0 | 52.8 | 49.2 | 6.46 | 51.4 | 44.3 | 59.1 |
| MemoryVLN(本文) | 3.52 | 59.98 | 54.76 | 50.26 | 3.33 | 57.84 | 50.42 | 63.52 |
读这张表要注意两点。其一,NE 的改善幅度远大于 SR:3.52 与 3.33 的导航误差比所有对照低至少 1.3 米,说明记忆机制首先改善的是"离目标有多近",其次才是"是否判定成功"。其二,绝对 SR 并非全场最高:StreamVLN-RGB-only 的 R2R SR 为 55.7、InternVLA-N1 为 55.4,都高于 54.76,但二者使用了额外导航数据或跨任务训练,不在数据可比的比较范围内。论文的增益主张因此是"同数据条件下的结构性收益",而非无条件 SOTA。
消融实验逐模块移除组件。移除长序列压缩在两个基准上都直接 OOM,无法给出数字;移除位姿编码使 R2R SR 掉到 52.75;移除情景内库使 R2R SR 掉到 53.34、RxR SPL 掉到 48.13;移除上下文库使 R2R SR 掉到 54.16。完整模型在所有 R2R 指标与 RxR 的 SR/SPL/nDTW 上均为最佳,四个模块的贡献互补:压缩提供可扩展性,位姿提供空间对齐,情景内池保留轨迹内证据,上下文库提供跨集复用。
| 变体 | R2R NE↓ | R2R SR↑ | R2R SPL↑ | RxR NE↓ | RxR SR↑ | RxR SPL↑ |
|---|---|---|---|---|---|---|
| 去掉长序列压缩 | OOM | OOM | ||||
| 去掉位姿编码 | 3.66 | 52.75 | 49.25 | 3.35 | 57.24 | 48.74 |
| 去掉情景内库 | 3.57 | 53.34 | 49.06 | 3.30 | 56.69 | 48.13 |
| 去掉上下文库 | 3.55 | 54.16 | 49.65 | 3.29 | 57.37 | 49.09 |
| 完整 MemoryVLN | 3.52 | 54.76 | 50.26 | 3.33 | 57.84 | 50.42 |
附录 B 还给出了逐集配对显著性检验:在 1839 个 R2R 配对情景上 SR/SPL 提升 2.0/1.2 个点但不显著;在 3669 个 RxR 配对情景上 SR 提升 6.2 个点(精确 McNemar 检验显著)、SPL 提升 5.2 个点(双侧 Wilcoxon 符号秩检验显著)。训练数据曲线则显示增益随训练推进扩大:在 46.4% 数据处 MemoryVLN 的 SR/SPL 为 48.6/44.7,对照 JanusVLN 为 44.4/37.6。实现配置上,训练用 64 张 A100 80GB、全局 batch 64、bfloat16、AdamW 加 3% 预热的余弦调度,单一随机种子 42、单一训练运行。
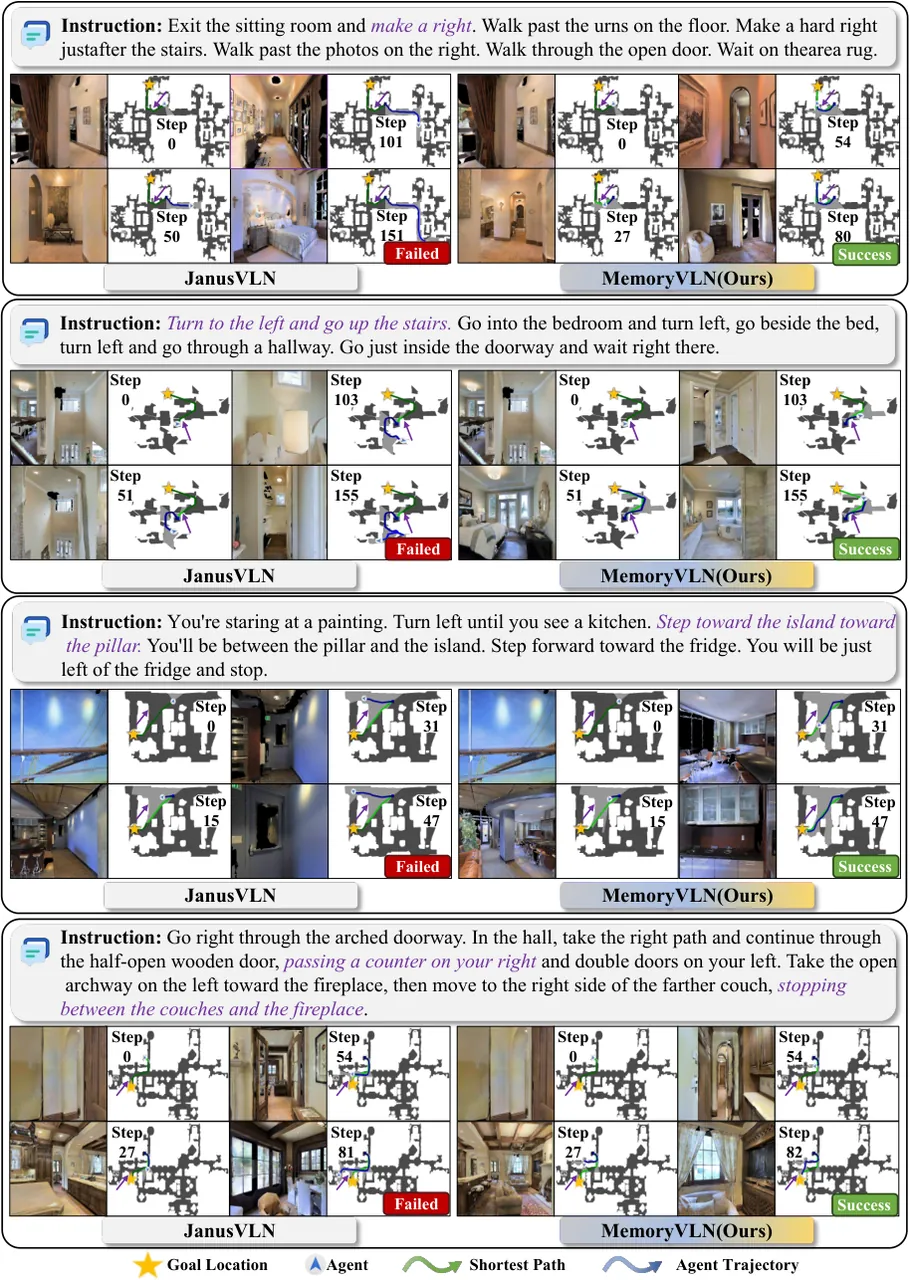
图3:四条相同指令下 JanusVLN 与 MemoryVLN 的定性对比。左列 JanusVLN 出现路线偏离、未达目标或错误停止;右列 MemoryVLN 进入目标区域并正确停止,顶视图同时给出目标星号、最短路径与执行轨迹。
真机实验用宇树 GO2 四足平台在真实办公环境完成,推理只靠单张 RTX 4090。五条指令分别要求停在打印机、咖啡机、指定房间、饮水机与会议室讲台前,模型穿过门洞、走廊与办公地标后正确停止,说明仿真中学到的记忆构建与管理机制可以迁移到物理环境。
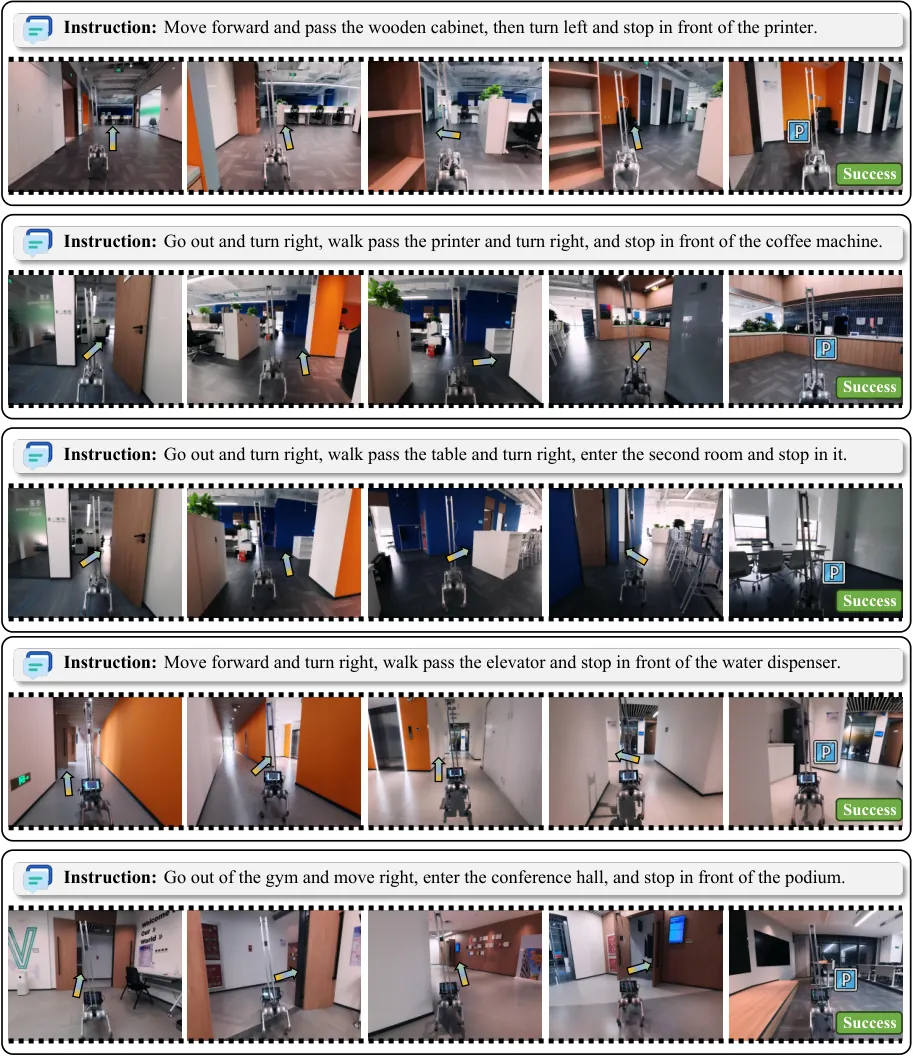
图4:真实办公环境中 GO2 执行五条自然语言指令的第一人称序列,全部成功停止在请求目标前。
局限性
作者自述的失败模式(附录 C)。论文挑选四个可复现的失败 Rollout 做定性分析:其一为房间级语义分支混淆,指令要求穿过门厅与厨房进入餐厅停在长桌旁,模型前段正确却在后段选错房间分支,终止于书房区域;其二为末端门洞级定位失败,模型在桑拿、泳池、吧台与两段楼梯之后未能选对"第一个右转",60 步即停止而参考轨迹需 82 步,最终 NE 10.76 米、Oracle NE 6.08 米;其三为上下文记忆未能纠正的地标转弯错误,模型错过"在灯前等待"所需的左转,沿上层走廊走进台球区;其四为长指令进度丢失,参考轨迹需 204 步的 RxR 指令模型 44 步就提前 STOP,NE 16.40 米。作者把第四类的根源归结为"已完成与待完成子目标没有被显式表示",即记忆记住了去过哪里,却没记住指令还剩多少。
统计效力与单一运行。附录 A.4 明确所有结果来自种子 42 的单次训练运行,不报告跨运行方差;附录 B 的配对检验也承认 R2R 上 2.0/1.2 个点的提升不显著。换言之,R2R-CE 上的headline数字处在噪声范围内,真正稳健的增益集中在 RxR-CE。
我们的判断:比较口径与发布完整性。第一,"比 SOTA 高 2%/6.5%"的表述只在数据可比子集内成立;若读者按表 1 的绝对值比较,R2R-CE 的 SR 与 OS 都低于使用额外数据的 StreamVLN-RGB-only(55.7 / 64.0),标题级结论需要带着这个限定阅读。第二,仓库只发布评测代码与配置,训练代码和权重缺席,HuggingFace 卡片亦无可用权重文件,独立复现主表数字需要按附录重训一次 64 卡训练,门槛不低。第三,配置存在论文与代码的漂移:表 3 写情景内池为 4 短 + 12 长,而 memory.py 的推理路径 configure_inference_memory_pool 使用 8 短 + 24 长;表 3 的预算下界 B_min=16 只出现在 evaluation.py 的评测入口,memory.py 内部的 _compute_global_max_frames 下界为 1。评测时以哪套配置为准,直接决定复现数字。第四,Context-Level Bank 是进程内列表,不持久化、不跨进程共享(除非开启 DDP 同步),因此论文展望的"终身记忆"在当前实现中并不存在,场景库随进程退出即消失。
总结与展望
MemoryVLN 的贡献不在某个单点模块,而在于把"记忆"当作一等公民重新组织了 VLN 策略的输入:压缩决定留下什么,表示决定留下时记住多少空间信息,记忆库决定何时存、何时取、何时丢弃,增强决定取回后如何参与决策。四个模块各自可消融、各自有明确的失败对应物,且全部在闭环推理中在线运行,不需要离线建图或额外传感器。实验上,NE 的大幅下降与 RxR-CE 上统计显著的 SR/SPL 增益支持了"长时程瓶颈是记忆组织而非上下文长度"这一主张;真机 GO2 的初步迁移则给出了仿真到现实的早期证据。
作者给出的未来方向是更持久的终身记忆、更显式的地图式记忆、以及记忆与规划的更紧耦合。从失败案例看,最迫切的补强可能是"指令进度"这一维度的记忆:当前记忆只回答"我去过哪里",不回答"我还差哪几步",而这正是长指令提前 STOP 的直接原因。对社区而言,这篇论文也留下了一个开放问题:当记忆库本身成为策略的一部分,它的容量、替换与置信门控是否应当端到端学习,而非手工设定 300、0.6、0.4 这些常数。
金句
长时程视觉语言导航的核心瓶颈不只是上下文长度,而是缺少一个分层的导航记忆:只有当历史被压缩、被定位、被管理、被检索,观测才能变成经验。