PAPER DEEP DIVE
HAM-VLN:用分层智能体记忆实现零样本视觉语言导航
视觉语言导航(VLN)要求机器人在从未见过的环境中按自然语言指令走到目标位置或目标物体。近期出现了一条免训练范式:机器人把当前观测交给多模态大模型,由模型理解场景并规划下一步动作。但无论用图像流还是稠密地图做长程导航,都会不可避免地引入不断膨胀的记忆与推理瓶颈。本文提出 HAM-VLN——一种与决策耦合、由智能体自己撰写的记忆机制,为机器人配上一张持久的、由深度反投影落地的世界图。在选择下一个动作的同一次模型调用里,HAM-VLN 同时记录语义与反思信息,包括房间类型、看到的物体、指令执行进度以及失败原因。最近的航点在有限窗口内原文保留,更久远的历史只有通过检索才会重新进入上下文,检索按相关性、时近性与显著性打分,并做一跳拓扑扩展。这个设计不需要在逐航点决策之外增加任何大模型调用。相比已有方法,HAM-VLN 不仅提升了多项导航指标,还把上下文长度压缩了 65% 以上:在完全不训练的前提下,VLN-CE R2R 成功率 61.0%,VLN-CE RxR 52.7%,HM3D-v2 ObjectNav 79.7%。
一句话总结
HAM-VLN 让规划用的那一次大模型调用顺手把「房间类型、看到的物体、指令进度、失败原因」写进一张由深度反投影建立的世界图,旧历史只在被当前子目标检索到时才回到上下文里:不训练、不加额外模型调用,在 VLN-CE R2R 上拿到 61.0% 成功率、RxR 52.7%、HM3D-v2 ObjectNav 79.7%,同时把每条 episode 的上下文压缩了 67%。
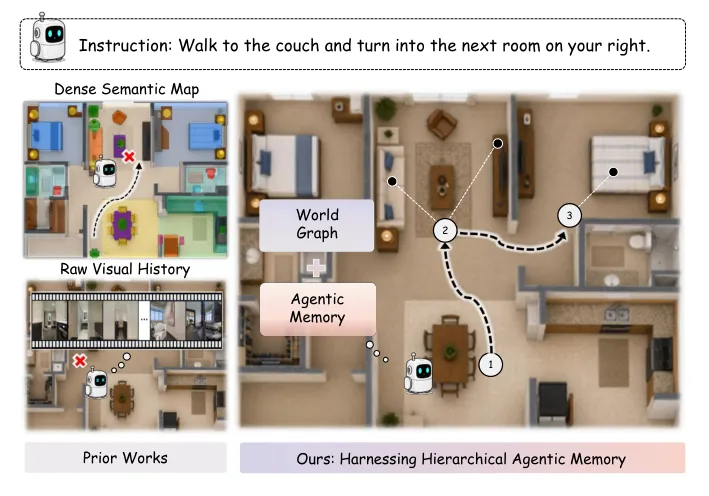
图 1:已有系统(左)用稠密语义地图(存储随面积增长)或原始视觉历史(上下文随轨迹增长)来呈现导航历史;HAM-VLN(右)把长期历史存进一张深度锚定的世界图,并用分层智能体记忆决定「什么留在上下文里、什么按需检索」。
研究背景:零样本 VLN 的真正瓶颈是记忆,不是模型
视觉语言导航(VLN)要求机器人在从未见过的环境里跟随一条自然语言指令走到目标位置或目标物体。多模态大模型(MLLM)让「不训练也能导航」成为可能:在每个 waypoint 上,机器人把当前观测交给模型,让它理解画面并选择下一个动作。这套 zero-shot 范式的诱惑力在于它把导航能力从「有多少条轨迹可以监督」解耦成了「预训练模型懂多少常识」。
但每一次模型调用只能对它当次看到的信息做推理。轨迹一长,后面的决策就需要知道三件当前画面里没有的事:机器人去过哪些地方、指令执行到哪一步了、哪条岔路已经试过并且失败了。把这些信息喂给模型而又不让上下文无限膨胀,就是本文所说的记忆瓶颈。
论文把现有做法归成两类,并指出它们各自的失效模式。第一类是稠密语义地图:把张量对齐到像素或体素上(无论是闭集类别标签还是开放词表特征),存储随已建图面积增长;更要紧的是,这些内容是在导航决策之外单独构建的,于是「卧室里的那张桌子」「朝厨房方向的那条走廊」这类指令片段必须再被匹配回度量网格单元,语义与几何之间隔着一层映射。第二类是原始视觉历史:把过去的全景图不断追加进模型上下文。地标信息被淹没在其他视觉细节里,上下文每一步都在涨,而且一条走过的死路并不会被标记成「应该避开的分支」。
作者的诊断很尖锐:这两种表示都让过去的观测「可获得」,但MLLM 并没有决定为后续决策保留什么。换句话说,历史是被被动累积的,不是被智能体主动书写的。
另一条线索来自 LLM 智能体的记忆研究。Generative Agents 用相关性、时近性与重要性三项组织记忆流,并对累积经验做反思;MemGPT 用外部记忆管理有限的模型上下文;Reflexion 把失败尝试的语言反馈保留下来指导后续行为。具身导航给这套机制加了一个额外要求:有用的记忆必须记住物体是在哪里被看到的、已访问区域如何连通、指令进展到哪一步、以及此前的决策在哪里失败。HAM-VLN 的定位就是把 Generative Agents 的记忆原则接到机器人的空间经验与当前子目标上。
预备知识:waypoint、四项指标与双过程分工
理解本文的实验数字需要先分清两个粒度。仿真里的低层动作 $A_t \in \mathcal{A}_{\mathrm{robot}}$ 是连续环境下的可执行动作(前进一小段、转一个小角度),而决策 waypoint 是机器人停下来、环视四周并做一次高层决定的位姿。大模型只在 waypoint 上被调用,waypoint 之间由确定性控制器连续执行。论文报告的 token 开销因此都是「每次决策」和「每条 episode」两个尺度。
指标方面:NE(navigation error)是停止点到目标的直线距离,越小越好;SR 是成功率;OSR 是 oracle 成功率,即轨迹上任意一点曾进入成功范围就算成功;SPL 用最短路径与实际路径之比给成功加权,衡量效率;RxR 因为指令更长,额外报告 nDTW(归一化动态时间规整)来衡量与参考路径的贴合程度。SR 高而 SPL 低,通常意味着「找到了但绕了远路」——这个组合在本文的消融里会反复出现。
架构上,HAM-VLN 沿用分层 VLA 与双系统 VLN 的思路:一个慢的、负责审慎推理的 System 2 决定「去哪里、为什么」,一个快的、反应式的 System 1 把这个高层意图落到当前观测的像素空间,再转成可执行运动指令。这种分工同时也是一个算力分工:昂贵的推理只在 waypoint 上发生一次,感知到动作的闭环由轻量模型与几何控制器承担。
方法详解
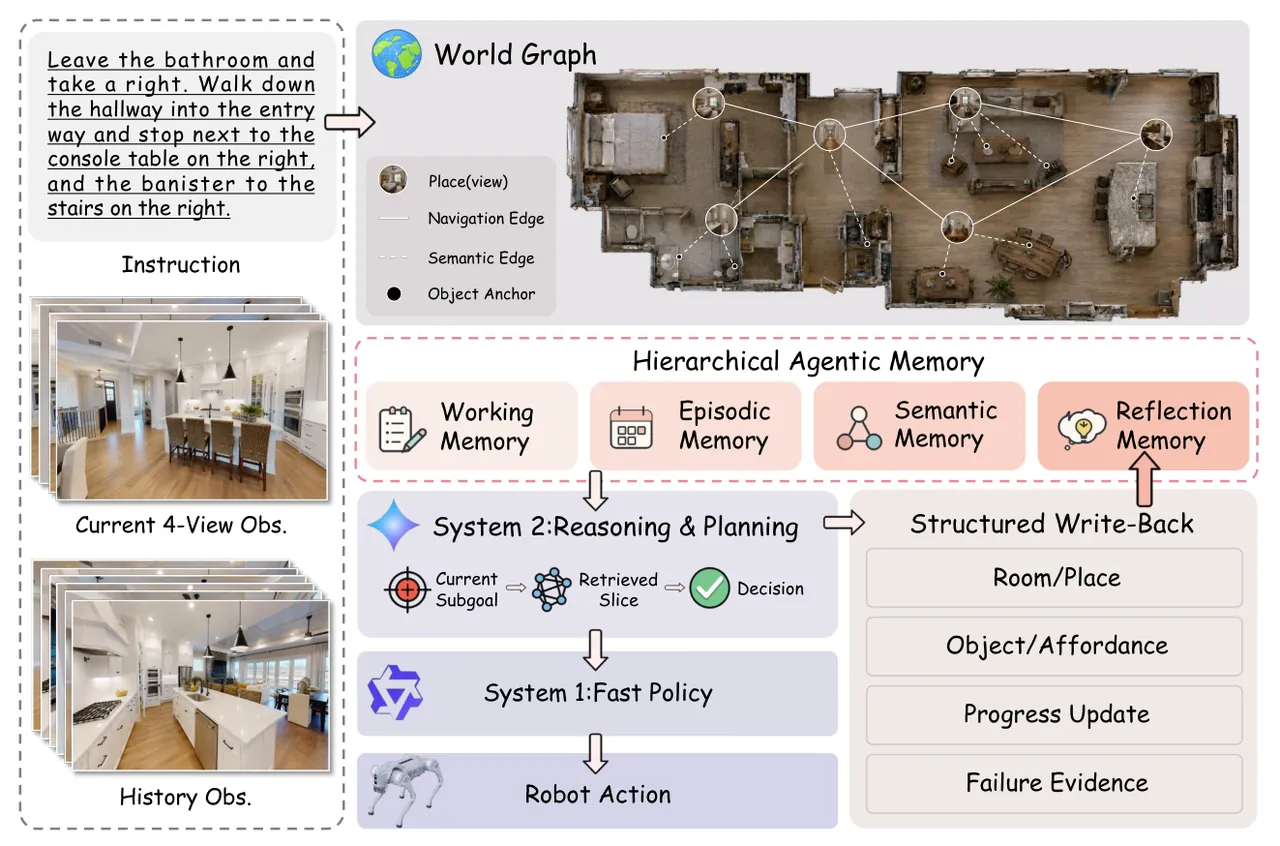
图 2:HAM-VLN 总览。每个 waypoint 上,System 2 读入当前全景、有界的 K 个 waypoint 工作记忆与检索出的图切片,在一次结构化调用里同时输出导航动作与记忆写入(房间类型、物体、进度、失败备注);System 1 把选定方向 grounding 到像素,控制器执行。当前子目标检索出的任务相关切片会重新进入下一次规划的上下文。
1. 双过程架构:一次调用做两件事
整步策略被分解为一个复合映射:
$$A_{t}=\pi_{\mathrm{robot}}\big(\varphi_{1}\big(\varphi_{2}(\mathcal{T},O_{t},M_{t})\big),\,D_{t},P_{t},\mathbf{K}_{\mathrm{cam}}\big)$$
其中 $\mathcal{T}$ 是导航指令,$O_t$ 是当前 waypoint 的观测,$M_t$ 是检索得到的记忆上下文,$D_t$ 是对应的深度观测,$P_t$ 是里程计位姿,$\mathbf{K}_{\mathrm{cam}}$ 是相机内参。论文用小写 $a_t$ 表示 System 2 产出的高层决策,以区别于仿真动作空间里的低层动作 $A_t$。
System 2(推理与规划)由 $\varphi_2$ 承担,是一个大 MLLM,每个 waypoint 调用一次——也就是机器人停下、环视、决策的那个位姿。它读入 $\mathcal{T}$、$O_t$ 与 $M_t$,提交一个离散决策:继续某个方向、回溯到此前访问过的某个 waypoint、或在验证后停止。关键在于这个决策是包在一条结构化 JSON 记录里返回的,同时携带进度分析与动作理由——这正是「决策与记忆写入耦合」的落点:写记忆不是额外一次调用,而是同一次调用的副产品。
System 1(快速策略)由 $\varphi_1$ 承担,是一个轻量的、grounding 专用的 MLLM。它观察被选中的那个视角与规划器给出的目标描述,直接预测目标的 bounding box,不依赖预训练的 waypoint 预测器。作者强调这一点是为了保留 grounding 远处语义线索的能力,例如「走廊开口」这类目标往往并不对应任何显式的中间 waypoint。随后确定性控制器 $\pi_{\mathrm{robot}}$ 在预测框内选一个代表像素,用深度图与相机内参把它反投影到 3D,再用里程计位姿变换到世界坐标系,最后在一张轻量局部可通行地图上跑快速行进规划,执行一段短时程轨迹。
2. 记忆状态:工作记忆、进度记录与世界图
在决策 waypoint $t$,$W_t$ 表示最近 $K$ 次已完成 waypoint 转移所保留的帧流,$L_t$ 是有序的指令进度记录,$G_t$ 是本条 episode 里累积起来的长期世界图。当前子目标 $q_t$ 从 $L_t$ 中导出(取第一个未完成项),供给 System 2 的记忆上下文写作:
$$M_{t}=W_{t}\oplus L_{t}\oplus\mathcal{R}(G_{t},q_{t})$$
$\mathcal{R}$ 是查询条件化的读算子,$\oplus$ 表示组装进规划上下文;当前全景 $O_t$ 属于即时感知,单独供给而不占记忆预算。这里 $K$ 的定义很关键:它是一条固化边界——窗口内的视觉历史逐字保留,窗口之外的旧观测只能通过 $G_t$ 的结构化读出回来。全文所有实验都用 $K{=}1$,也就是说逐字保留的只有最近一次转移的帧。
长期状态被表示成一张带类型的「地点—物体」图:
$$G_{t}=\big(\mathcal{V}^{P}_{t},\ \mathcal{V}^{O}_{t},\ \mathcal{E}^{PP}_{t},\ \mathcal{E}^{PO}_{t}\big)$$
地点节点 $\mathcal{V}^P_t$ 由增量式 single-link 聚类形成,每个地点状态聚合空间锚点、智能体书写的语义上下文、访问统计,以及可选的失败证据。物体节点 $\mathcal{V}^O_t$ 把一次深度锚定的类别观测与开放词表描述、地点/类别层面的软属性关联起来。地点—地点边 $\mathcal{E}^{PP}_t$ 编码导航连通性,地点—物体边 $\mathcal{E}^{PO}_t$ 编码语义包含关系及其置信度。
这张图与稠密语义地图的差别在于增长的自变量:它随机器人发现的地点与实体增长,而不是随已建图面积增长,同时仍然保留了召回与回溯所需的几何与拓扑。这是论文第一条贡献的实质。
3. 决策耦合的更新:谁写、谁自动
System 2 的调用产出一条结构化决策记录 $J_{t}=(a_{t},w_{t},r_{t})$:$a_t$ 是高层动作,$w_t$ 装载地点语义、观测到的物体与指令进度更新,$r_t$ 是动作理由。令 $\Gamma(O_t,D_t,P_t)$ 表示从当前 RGB-D 观测与位姿提取的、已锚定的几何证据,那么进度状态与世界模型的演化是联合发生的:
$$L_{t+1}=\mathcal{U}_{L}(L_{t},w_{t}),\qquad G_{t+1}=\mathcal{U}_{G}\!\left(G_{t},w_{t},\Gamma(O_{t},D_{t},P_{t})\right)$$
$\mathcal{U}_L$ 施加进度更新,$\mathcal{U}_G$ 把观测关联到地点与物体、融合重复证据并更新拓扑。当 $a_t$ 是回溯动作时,第 3.4 节的事件专属更新会把 $r_t$ 作为失败证据挂上去。这里有一条清晰的职责边界:$w_t$ 与 $r_t$ 由智能体书写,而 grounding、关联、投影与图维护都是自动操作。开放集检测与分割由 Grounding DINO 与 SAM 提供,结果经深度投影后合并成地点级的物体状态。
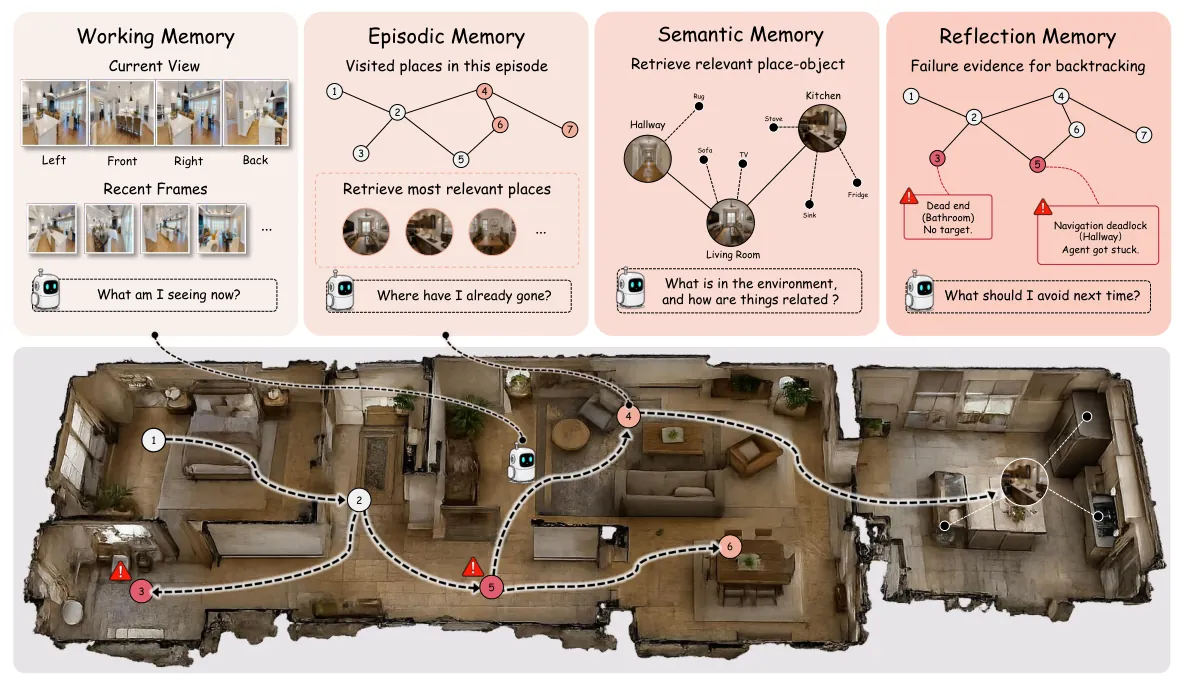
图 3:同一条 episode 上的四种功能记忆视图。(1)工作记忆:K 个 waypoint 窗口内的近期第一人称帧流,是规划器逐字看到的部分;(2)情景记忆:对已访问地点的时间检索,提供时近性;(3)语义记忆:对地点—物体图的内容检索,提供相关性;(4)反思记忆:挂在被放弃地点上的备注,在该地点被检索到时逐字浮现。
论文强调这四个视图不是四份独立存储,而是同一个式(2)状态在不同读取方式下的呈现:情景记忆读 $G_t$ 里的访问轨迹与时间元数据(供 recency),语义记忆读地点—物体内容与拓扑(供 relevance),反思记忆返回挂在被检索地点上的失败证据。检索分数里的 salience 是一个基于地标与物体证据的重要性项;反思与打分正交,只有当它所属的地点被检索到时才会重新进入上下文。
4. 子目标条件化检索:三项打分与一跳拓扑扩展
在 waypoint $t$,$L_t$ 中第一个待办项定义当前子目标 $q_t$。一个本地句向量编码器(bge-large-en-v1.5,常驻每张 worker GPU)把 $q_t$ 与每个地点状态 $p\in\mathcal{V}^P_t$ 的摘要嵌入到同一空间,然后按三项加权打分:
$$s_{t}(p)=\alpha\,\mathrm{rel}(q_{t},p)+\beta\,\mathrm{rec}_{t}(p)+\gamma\,\mathrm{sal}(p)$$
$\mathrm{rel}$ 是查询与地点的余弦相似度,$\mathrm{rec}_t(p)=\rho^{\,t-\tau(p)}$ 以最近一次访问 $\tau(p)$ 为基准做指数衰减,$\mathrm{sal}$ 综合地标一致性与物体丰富度。全部实验固定 $(\alpha,\beta,\gamma)=(1.0,0.3,0.3)$、每 waypoint 衰减率 $\rho=0.85$——相关性是主导项,时近性与显著性各占约三成权重。三项分别对应任务相关性、时间连续性与感知重要性。
读出算子 $\mathcal{R}(G_t,q_t)$ 并不只是取 top-k:它以种子预算 $K_s=3$ 取得分最高的三个地点作为种子,向外扩展一跳,并入当前地点的邻域,最后保留至多 $K_p=5$ 个地点。得到的地点—物体子图被序列化进 $M_t$,包含语义内容、相对几何、拓扑以及关联的失败证据。这一步是「拓扑感知」的价值所在:导航决策需要的往往不是语义上最像的那个房间,而是它旁边的走廊与连通关系。
5. 接地失败记忆:把回溯建模成控制—记忆的耦合转移
在部分可观测的导航里,一条被放弃的分支不只是需要撤销的运动,它还是关于「当前子目标与某个已探索区域是否兼容」的负证据。因此当 System 2 决定回到此前访问过的 waypoint $b_t$ 时,被放弃的后缀 $\mathcal{B}_t$ 会被映射到它关联的地点状态,决策理由 $r_t$ 被存成接地的失败证据。算法里的写法是:
$$\mathcal{F}_{t}\leftarrow\mathrm{Places}(\mathcal{B}_{t})\setminus\{p(b_{t})\},\qquad G_{t+1}\leftarrow\mathrm{MarkFailure}(G_{t+1},\mathcal{F}_{t},r_{t})$$
一个容易忽略但设计上很重要的区分:返回目标是 waypoint 级的(为了保住可执行几何),而证据是地点级的(这样才能跨重复访问持续存在)。
这条证据是建议性而非禁止性的:它既不改变打分 $s_t(p)$,也不封禁任何地点;只有当 $\mathcal{R}(G_t,q_t)$ 检索到相关区域时它才重新进入 $M_t$,让 System 2 在当前子目标下重新解释那次失败。于是回溯同时改变了智能体的位姿与后续决策所依赖的记忆状态,闭合了「动作与失败 → 接地写入 → 条件化召回 → 修正动作」这个环。
算法 1 把整条 episode 串起来:初始化 $L_0$(由指令 $\mathcal{T}$ 得到)与空的 $G_0,W_0$;每个 waypoint 接收 $(O_t,D_t,P_t)$,导出 $q_t$,组装 $M_t$,调用 $\varphi_2$ 得到 $(a_t,w_t,r_t)$,更新 $L$ 与 $G$;若 $a_t$ 是 Stop 则返回,是 Backtrack 则标记失败并回到锚点 $b_t$,否则由 $\varphi_1$ 给出目标 $g_t$ 交给控制器执行;最后用 $\mathrm{UpdateWindow}(W_t,O_t;K)$ 滚动工作记忆窗口。
flowchart TD
  OBS["当前 waypoint 观测<br/>全景 O_t + 深度 D_t + 位姿 P_t"] --> SUB["从进度记录 L_t 取第一个未完成项<br/>得到子目标 q_t"]
  SUB --> READ["读算子 R(G_t, q_t)<br/>本地 bge 编码打分 s_t(p)<br/>K_s=3 种子 + 一跳扩展 + K_p=5"]
  WM["工作记忆 W_t<br/>最近 K 次转移的帧, K=1"] --> CTX["组装上下文<br/>M_t = W_t + L_t + R(G_t, q_t)"]
  READ --> CTX
  CTX --> S2["System 2: Gemini-3.1-Pro<br/>一次调用输出 JSON<br/>J_t = (a_t, w_t, r_t)"]
  S2 --> WL["U_L 更新指令进度 L_t+1"]
  S2 --> WG["U_G 更新世界图 G_t+1<br/>Grounding DINO + SAM + 深度反投影"]
  S2 --> BR{"a_t 是哪一类?"}
  BR -->|"方向"| S1["System 1: Qwen3.6-35B<br/>预测目标 bbox"]
  S1 --> CTRL["控制器: bbox 内取像素<br/>深度反投影到世界系<br/>快速行进局部规划"]
  BR -->|"回溯到 b_t"| FAIL["MarkFailure<br/>把 r_t 挂到被放弃后缀的地点上"]
  FAIL --> CTRL
  BR -->|"验证后停止"| DONE["episode 结束"]
  CTRL --> WM
实验结果
主结果:训练-free 路线第一次在四项指标上全面领先
在 R2R-CE val-unseen 上,HAM-VLN 相对此前最强的训练-free 基线全面改善:NE 从 5.87 m 降到 3.92 m,OSR、SR、SPL 分别提高 27.7、22.7、19.0 个百分点。在指令更长、更难对齐的 RxR-CE 上,同一套配置把 NE 从 8.80 m 降到 6.27 m,SR、SPL、nDTW 分别提高 18.9、19.6、8.6 个百分点——作者特别指出这是没有做基准专属重调的结果。
| 方法 | 类型 | R2R NE ↓ | R2R OSR ↑ | R2R SR ↑ | R2R SPL ↑ | RxR NE ↓ | RxR SR ↑ | RxR SPL ↑ | RxR nDTW ↑ |
|---|---|---|---|---|---|---|---|---|---|
| NaVILA | 有监督 | 5.22 | 62.5 | 54.0 | 49.0 | 6.77 | 49.3 | 44.0 | 58.8 |
| StreamVLN | 有监督 | 4.98 | 64.2 | 56.9 | 51.9 | 6.22 | 52.9 | 46.0 | 61.9 |
| JanusVLN | 有监督 | 4.78 | 65.2 | 60.5 | 56.8 | 6.06 | 56.2 | 47.5 | 62.1 |
| OmniNav | 有监督 | 3.74 | 74.6 | 69.5 | 66.1 | 3.77 | 73.6 | 62.0 | – |
| SPAN-Nav | 有监督 | 4.07 | 75.3 | 66.3 | 59.3 | 4.20 | 69.7 | 60.1 | 67.9 |
| InstructNav | 训练-free | 6.89 | 47.0 | 31.0 | 24.0 | – | – | – | – |
| GC-VLN | 训练-free | 7.30 | 41.8 | 33.6 | 16.3 | 8.80 | 33.8 | 13.8 | – |
| LaViRA | 训练-free | 6.54 ±0.27 | 48.7 ±2.1 | 38.3 ±0.6 | 28.3 ±0.9 | – | – | – | – |
| Three-Step Nav | 训练-free | 5.87 | 39.0 | 34.0 | 29.1 | 9.21 | 22.0 | 16.1 | 45.7 |
| HiMemVLN | 训练-free | 6.65 | 36.0 | 30.0 | 26.9 | – | – | – | – |
| HAM-VLN(本文) | 训练-free | 3.92 ±0.15 | 78.7 ±3.1 | 61.0 ±1.7 | 48.1 ±0.2 | 6.27 ±0.23 | 52.7 ±1.5 | 35.7 ±2.6 | 54.3 ±0.3 |
表 1(节选自论文表 1):VLN-CE R2R 与 RxR val-unseen 主结果。本文数字为 3 个种子的均值 ± 标准差,其余为各原文报告值。
有两处需要读者自己把握分寸。其一,HAM-VLN 在 R2R 上的 OSR(78.7)已经高于表中所有有监督方法,但最强的训练系统 SR 与 SPL 仍然更高——作者自己给出的解释是:智能体式探索在不确定下采样下一个方向,而学出来的策略会走「学到的捷径」。OSR 与 SR 的落差(78.7 对 61.0)正是这个差别的量化表现:机器人经常路过正确位置却没有停下来。其二,评测用的是 100 episode 子集而非完整 val-unseen;论文引用 Ding 等人的结论说明这些子集上的 SR 与完整划分相差不过 1.1 个百分点,但这仍然是需要在心里打的一个折扣。
在 HM3D-v2 ObjectNav 上,HAM-VLN 取得 SR 79.7 ±0.5、SPL 43.2 ±0.6,比此前最强的训练-free 结果分别高 3.5 与 4.5 个百分点,也超过了表中最好的有监督结果(FiLM-Nav 77.0 / 41.3)2.7 与 1.9 个百分点。作者把这一点归因于 MLLM 预训练里学到的房间级语义先验:「去卧室找床」这类目标-房间关联,在 zero-shot 路线里是白拿的,在有监督路线里必须由数据覆盖。
| 方法 | 类型 | SR ↑ | SPL ↑ |
|---|---|---|---|
| DD-PPO | 有监督 | 27.9 | 14.2 |
| PIRLNav | 有监督 | 70.4 | 34.1 |
| Uni-NaVid | 有监督 | 73.7 | 37.1 |
| FiLM-Nav | 有监督 | 77.0 | 41.3 |
| VLFM | 训练-free | 62.6 | 31.0 |
| ApexNav | 训练-free | 76.2 | 38.0 |
| DSCD-Nav | 训练-free | 73.0 | 38.7 |
| ReMemNav | 训练-free | 67.8 | 36.6 |
| HAM-VLN(本文) | 训练-free | 79.7 ±0.5 | 43.2 ±0.6 |
表 2(节选自论文表 2):HM3D-v2 ObjectNav 主结果。这是全文唯一一处训练-free 方法同时压过有监督 SOTA 的基准。
成本与窗口敏感性:更长的视觉上下文是负资产
表 3 是这篇论文最有说服力的一组对照,因为它把「记忆」与「上下文长度」这两件事拆开测量了。原始视觉历史把窗口从 $K{=}3$ 扩到 $K{=}5$、$K{=}10$ 直到全量,两类 token 开销单调上升,而 SR 与 SPL 并没有随之改善:从 $K{=}3$ 到全量,每条 episode 的 API token 增加 98.7%,SR 反而下降 4.7 个百分点、SPL 下降 6.6 个百分点。HAM-VLN 用 $K{=}1$ 的工作窗口加上图检索,SR/SPL 比最好的原始历史配置高 2.7 与 3.4 个百分点,同时每次决策只用 17.9k System 2 token、每条 episode 只用 244.9k API token——相对 $K{=}3$ 分别降低 45.1% 与 34.8%,相对全量历史降低 69.0% 与 67.2%。
| 配置 | SR ↑ | SPL ↑ | System 2 token / 决策 ↓ | API token / episode ↓ |
|---|---|---|---|---|
| HAM-VLN | 61.0 ±1.7 | 48.1 ±0.2 | 17.9k | 244.9k |
| 原始历史 K=3 | 58.0 ±1.4 | 44.7 ±0.5 | 32.6k | 375.5k |
| 原始历史 K=5 | 54.3 ±2.1 | 38.4 ±0.3 | 39.8k | 457.8k |
| 原始历史 K=10 | 58.3 ±0.9 | 41.6 ±1.2 | 48.7k | 534.0k |
| 原始历史(全量) | 53.3 ±1.2 | 38.1 ±0.7 | 57.7k | 746.1k |
表 3(论文表 3):R2R-CE val-unseen 上的规划器—记忆受控对照与推理成本。所有配置使用同一个规划器、grounding 模型与控制器。
作者对这条曲线的解释值得单独记下来:原始历史保留的是互相重叠、与当前子目标无关的全景图,而且缺少一个可供选择性检索的地点—物体索引。换句话说,多塞图像并不等于多给信息,它同时提高了注意力被稀释的概率。这也解释了为什么 $K{=}5$ 比 $K{=}3$ 更差而 $K{=}10$ 又略好——曲线本身不平滑,说明这不是一个可以通过调窗口长度稳定优化的量。
消融:图本身不够,三个记忆视图各有分工
| 配置 | NE ↓ | OSR ↑ | SR ↑ | SPL ↑ |
|---|---|---|---|---|
| HAM-VLN(完整) | 3.92 ±0.15 | 78.7 ±3.1 | 61.0 ±1.7 | 48.1 ±0.2 |
| 去掉世界图(K=1 窗口) | 4.97 ±0.21 | 72.6 ±1.8 | 51.7 ±1.3 | 39.3 ±1.2 |
| 去掉世界图(全量原始历史) | 4.62 ±0.19 | 68.3 ±0.9 | 53.3 ±1.2 | 38.1 ±0.7 |
| 去掉情景记忆 EM | 4.53 ±0.37 | 72.0 ±3.6 | 53.3 ±2.6 | 41.6 ±1.4 |
| 去掉语义记忆 SM | 4.72 ±0.29 | 74.0 ±2.7 | 53.3 ±0.5 | 42.1 ±0.7 |
| 去掉反思记忆 RM | 4.41 ±0.17 | 76.0 ±1.4 | 55.7 ±1.3 | 36.9 ±0.9 |
| 三个视图全去掉 | 4.63 ±0.22 | 75.7 ±1.9 | 50.7 ±1.7 | 31.5 ±1.1 |
表 4(论文表 4):R2R-CE val-unseen 上的组件消融。两组「去掉世界图」变体分别保留 K=1 工作窗口或全量原始视觉历史;其余变体保留图但移除 EM / SM / RM。去掉 RM 仍保留回溯能力,只是关闭失败备注的写入与序列化。
消融给出三条独立结论。第一,世界图是空间精度的主要来源:去掉图后 NE 从 3.92 m 恶化到 4.97 m,SR 掉 9.3 个百分点到 51.7;即便用全量原始历史替代图,SR 也只回到 53.3,仍比完整模型低 7.7 个百分点,SPL 更是从 48.1 掉到 38.1。第二,情景与语义检索各自贡献成功率:去掉 EM 或 SM,SR 都从 61.0 掉到 53.3,SPL 分别降到 41.6 与 42.1,说明时间访问线索与地点—物体相关性都在起作用。第三,反思记忆主要买的是效率而不是成功:去掉 RM 后 SR 只降 5.3 个百分点到 55.7,SPL 却掉了 11.2 个百分点到 36.9——失败备注让机器人少走回头路,而不是让它更容易找到终点。三个视图全去掉时 SR 50.7、SPL 31.5,说明光有图不够,规划器还需要这三种读法。
回溯行为的量化与一次真实轨迹
在 100 条 R2R-CE episode 上,智能体在 1288 次 waypoint 决策中回溯了 175 次,即每条 episode 平均 1.75 次、占全部决策的 13.6%。这个数字本身就有信息量:回溯不是罕见异常,而是约每七次决策就有一次的常规操作,把它建模成一等公民而不是失败兜底是合理的。
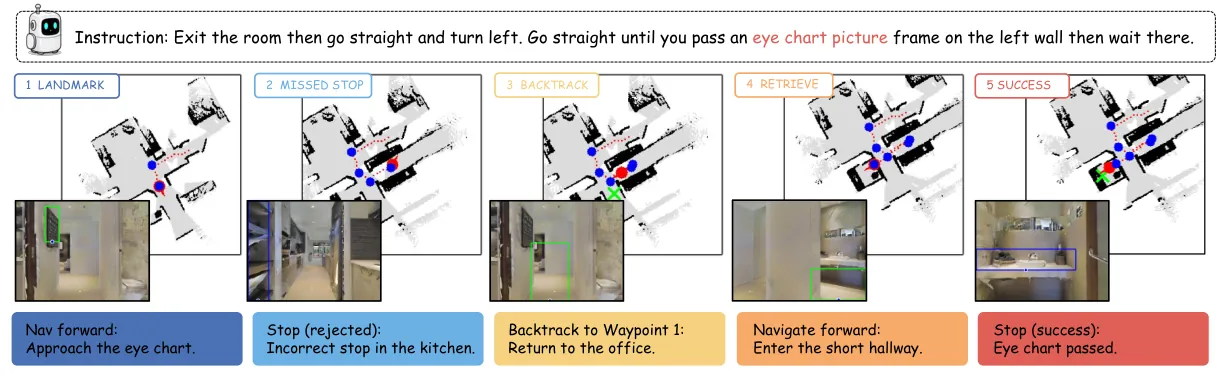
图 4:反思记忆驱动回溯的一个实例。机器人在厨房做出一次被拒绝的停止后写下备注,随后回溯到 waypoint 1(办公室)重新定向,在走廊交叉口检索到该备注并选择较短的那条走廊,经过视力表画框,最终成功停止。
论文给了完整的语言痕迹:在厨房一次被拒绝的停止之后,智能体写下「我将回溯到 waypoint 1(办公室)以重新定向,寻找左侧墙上挂着眼科视力表画框的那条走廊」;到达走廊交叉口时,System 2 检索到这条备注,选择较短的那条走廊,经过视力表画框,成功停止。这是「接地失败记忆」最直白的证据——备注里同时含有空间指代(waypoint 1、办公室)、语义地标(眼科视力表画框)与相对方位(左墙),三者都必须由图上的地点状态承载,否则召回后无法被复用。
局限性
论文没有单独的局限性章节,但在结果讨论里有两处作者自述的边界。其一,作者明确承认最强的有监督系统在 R2R 与 RxR 上的 SR 与 SPL 仍然更高,并给出机制解释:智能体式探索在不确定下采样方向,而学习到的策略会走捷径。这意味着 HAM-VLN 换来的是零训练成本与跨基准通用性,而不是绝对精度上限。其二,评测建立在 100 episode 子集上,作者需要引用他人结论(子集与完整划分的 SR 偏差不超过 1.1 个百分点)来支撑可比性,这本身就是一处方法学上的让步。
以下是我从系统设计角度补充的几点判断。第一,成本被压低了但没有被消除:每条 episode 仍然要消耗 244.9k API token 的 Gemini-3.1-Pro 调用,按 waypoint 计约 13 次决策,这对真机上的实时性与账单都不是小数目;论文只对比了 token 数,没有报告墙钟延迟或单条 episode 的美元成本。第二,对深度与里程计的强依赖:世界图的建立依赖 $\Gamma(O_t,D_t,P_t)$,即深度反投影加里程计位姿。仿真里这两者都是干净的,真机上的深度噪声、玻璃与反光面、以及里程计漂移会直接进入图的几何与拓扑,论文没有给出任何真机或含噪感知的实验。第三,超参完全没有搜索:$(\alpha,\beta,\gamma)=(1.0,0.3,0.3)$、$\rho=0.85$、$K_s=3$、$K_p=5$、$K=1$ 在三个基准上一模一样。作者把「无需重调」当成优点,但这也意味着检索的敏感性没有被刻画——例如在 RxR 这类长指令场景下,$K_p=5$ 是否足以覆盖一条指令涉及的地点数量,论文没有回答。第四,失败证据是建议性的,没有失效机制:备注只在其所属地点被检索到时浮现,且永不影响打分。当环境本身发生变化(门开了、物体被移动)或备注本身写错时,系统没有任何机制去衰减或撤销它,反复访问同一地点会让同一条错误备注一再进入上下文。第五,语义粒度停留在地点与类别:物体节点承载开放词表描述与软属性,但图里没有实例级身份与跨房间的对象同一性,「跟着刚才看到的那个人」「回到我放杯子的那张桌子」这类指令超出了当前表示。
总结与展望
HAM-VLN 的贡献不在于提出了一个新的记忆库,而在于把记忆的写入权交回给做决策的那个模型,并让这份记忆挂在一张由深度锚定的稀疏世界图上。三个设计决定串成了它的效果:写入与决策共用一次调用(成本不增加),历史按子目标条件化检索而不是按时间顺序堆积(上下文不膨胀),失败作为地点级证据被保留而不是被丢弃(回头路变成信息)。表 3 与表 4 一起说明,这三件事都不是锦上添花:去掉图,SR 掉 9.3 个百分点;把图换成全量原始历史,token 涨三倍而 SR 还低 7.7 个百分点;去掉反思记忆,SPL 掉 11.2 个百分点。
对做真机导航的人来说,这篇论文可迁移的部分是清晰的:把「记忆」实现为一个与决策同频更新的结构化状态,而不是一个事后总结的文本缓冲区;给检索加上拓扑扩展,因为导航问题里语义相似度与可达性经常不一致;把失败显式建模成可召回的负证据,但让它保持建议性,避免把探索空间提前剪死。反过来,需要警惕的是它没有触及的部分——真实传感器噪声、实时预算、以及长时程下的图维护(聚类漂移、拓扑断裂)在本文里都还是仿真假设。
顺着论文自己的逻辑,下一步自然的方向有三个:把世界图跨 episode 持久化,让机器人在重复环境里复用已有拓扑;给失败证据加上时间与置信度维度,让它可衰减、可被新证据推翻;以及把地点级语义提升到实例级,使记忆能够支撑需要对象同一性的长程指令。