PAPER DEEP DIVE
LidarVerse:跨任务、跨传感器的实时统一 LiDAR 世界模型
NVIDIA 等提出 LidarVerse:统一条件生成框架下的实时 LiDAR 世界模型。通用 tokenizer 将 32/64/128 线距离序列映射到共享潜空间,双向教师模型以 LiDAR 前缀、HD-Map、持久空间缓存与可选文本为条件;蒸馏出的四步自回归因果学生模型配合滚动时序 K/V 缓存与世界对齐空间缓存,在单张 H100 上以 11 FPS 实现长时程一致 rollout,在三种评测协议的大部分指标上达到 SOTA。
Into the LidarVerse: A Real-Time Unified LiDAR World Model Across Tasks and Sensors
Henry Che(NVIDIA / UIUC)、Xuanchi Ren(University of Toronto)、Sanja Fidler(University of Toronto / NVIDIA)、Shenlong Wang(UIUC)、Laura Leal-Taixé(NVIDIA)、Shengyu Huang(NVIDIA)
arXiv:2610.19201v1 [cs.CV],提交于 2026-10-13 · arXiv:2610.19201 · 项目页 NVIDIA SIL / lidarverse · 代码仓库 nv-tlabs/LidarVerse
代码状态:已开源。仓库放出了 tokenizer(NATTEN 版 Transformer VAE)、扩散训练与推理代码、SF-DMD 自强制蒸馏训练器,以及三阶段配置 diffusion/training/config/text2world_hdmaptolidar/experiment_lidarverse.py;权重托管在 HuggingFace nvidia/lidarverse。
一句话总结
LidarVerse 把 LiDAR 仿真的两个流派——需要一小时级逐场景优化的重建式仿真,与记不住长程几何的生成式仿真——收进同一个条件生成模型:一个全注意力 range-image tokenizer 提供跨传感器共享的潜空间,一个由 Cosmos-Transfer2.5-2B 初始化的双向教师学会「LiDAR 前缀 / HD 地图 / 持久空间缓存 / 文本」四路可独立开关的条件接口,再用自强制分布匹配蒸馏成四步块自回归因果学生,配上 9 帧滚动 K/V cache 与 0.15 m 世界对齐体素缓存。同一份权重在单张 H100 上以 11.18 FPS(HD 地图条件)跑新场景生成、11.30 FPS 跑动作条件生成,并且零逐场景优化地做点云预测与可泛化重仿真。任务的差别不在参数里,而在推理时手上有多少现场证据。
一、问题:重建派保得住几何,生成派扩得出世界,两边都缺一半
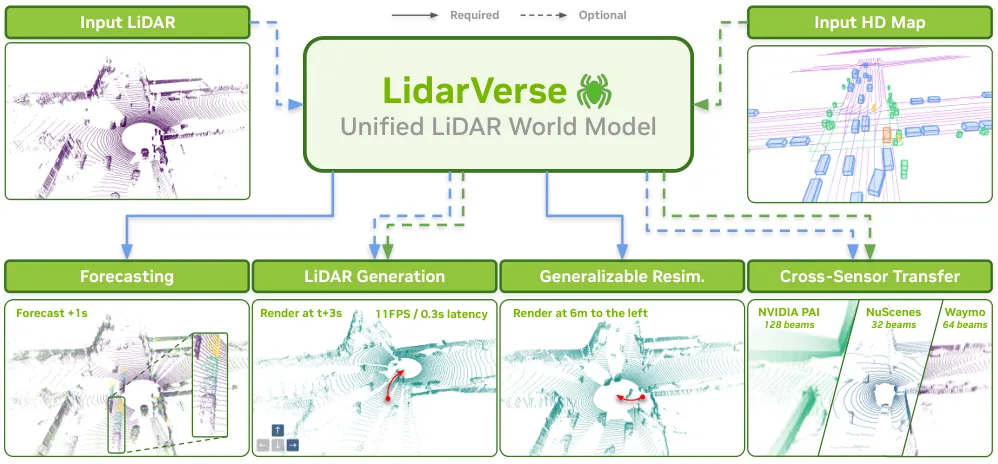
图1(论文 Figure 1,teaser):同一个蒸馏后的因果检查点,按可用现场证据的不同组合,分别去做生成新世界、预测未来点云、沿新传感器轨迹重演已采集场景,三者都是实时长程推理。
论文开篇把需求讲得很直白:机器人和自动驾驶要在一条无法穷举采集的长尾上安全运行,所以传感器仿真必须同时具备两种能力——保住一个已经观测到的世界、只改传感器轨迹,以及造出记录之外的新世界。NVIDIA Omniverse NuRec 代表前者,OmniDreams 代表后者。LiDAR 在这个位置上尤其关键:它给出的是直接的几何测量,在恶劣光照下依然可靠,但它的回波稀疏、且强依赖视角,仿真起来并不讨好。一个能用的 LiDAR 模拟器还得同时满足三条工程约束:观测要准、传感器运动下时间要连贯、速度要快到能交互。
神经 LiDAR 仿真沿同一条裂缝发展。重建式方法(LiDAR4D、LiDAR-RT、SplatAD 等)给一段采集日志拟合一个显式神经场景表示,再从新的传感器位姿渲染 LiDAR。持久 3D 表示带来强几何一致性和精确的视角控制,因此天然适合场景重仿真;代价是拟合单个场景可能要花数小时优化,而且得到的模拟器与那段人工采集的日志绑死——它能在一个场景里改轨迹,却没法扩展到一个多样化的新环境分布上。
生成式方法把场景建模摊销到整个数据集上,学一个可以采样新场景的分布。这条路的瓶颈不在扩散模型,而在表示:直接处理无序点集效率低,也没法复用成熟的图像/视频生成基础设施;range image 保留了 LiDAR 的扫描拓扑、是传感器原生的结构化替代,但高分辨率 range 序列用像素空间扩散直接建模非常贵;为 RGB 视频造的 tokenizer 与 range image 不匹配,而已有的 LiDAR tokenizer 大多只针对单一扫描模式。结果就是:现有生成器往往绑定一种传感器配置、只能出短序列、或者需要很多去噪步。
LidarVerse 的关键重述是:生成、预测、重仿真这三个任务,本质上只在「推理时能拿到多少现场证据」这一点上不同。没有任何观测几何时,模型从场景级条件生成新世界;给一段观测到的 LiDAR 前缀,同一个模型变成点云预测器;给一个由观测扫描累积出来的持久空间缓存(PSC),它就被锚定在某个特定世界上,可以在新轨迹下做可泛化重仿真,而且不需要逐场景优化。所以这不是三个架构,而是同一个条件先验的三种查询方式。
二、预备:range image 与两条互为逆的投影公式
模型的一切输入输出都建立在 range image 上。第 $j$ 行第 $i$ 列的像素由射程 $r_{j,i}$ 携带,球坐标到笛卡尔坐标的映射是
$$\mathbf{p}_{j,i}=\begin{bmatrix}x_{j,i}\\ y_{j,i}\\ z_{j,i}\end{bmatrix}=r_{j,i}\begin{bmatrix}\cos\phi_{j}\cos\theta_{i}\\ \cos\phi_{j}\sin\theta_{i}\\ \sin\phi_{j}\end{bmatrix}$$
反向投影(把点云写回 range image)按传感器标定表查行/列角度:
$$\theta_{k}=\operatorname{atan2}(y_{k},x_{k}),\qquad \phi_{k}=\arcsin(z_{k}/r_{k}),\qquad r_{k}=\lVert\mathbf{p}_{k}\rVert_{2}$$
多个点投到同一条射线上时只保留最近回波;有效射程被夹到 $[r_{\min},r_{\max}]$ 并归一化到 $[-1,1]$。另有一张有效性掩码 $\mathbf{M}\in\{0,1\}^{H\times W}$ 区分真实测量与缺失回波,默认表示是通道拼接 $\mathbf{I}=[\mathbf{R}\mid\mathbf{M}]$;有强度时把强度图裁到 $[0,255]$ 再归一化到 $[0,1]$,作为第三通道附上。堆叠 $T$ 帧得到 $\mathbf{X}=\operatorname{Concat}(\mathbf{I}_{1},\ldots,\mathbf{I}_{T})\in\mathbb{R}^{T\times H\times W\times C_{\mathrm{in}}}$,其中 $C_{\mathrm{in}}=2$(带强度则 3)。
三、方法之一:通用 LiDAR tokenizer,为什么必须是注意力而不是卷积
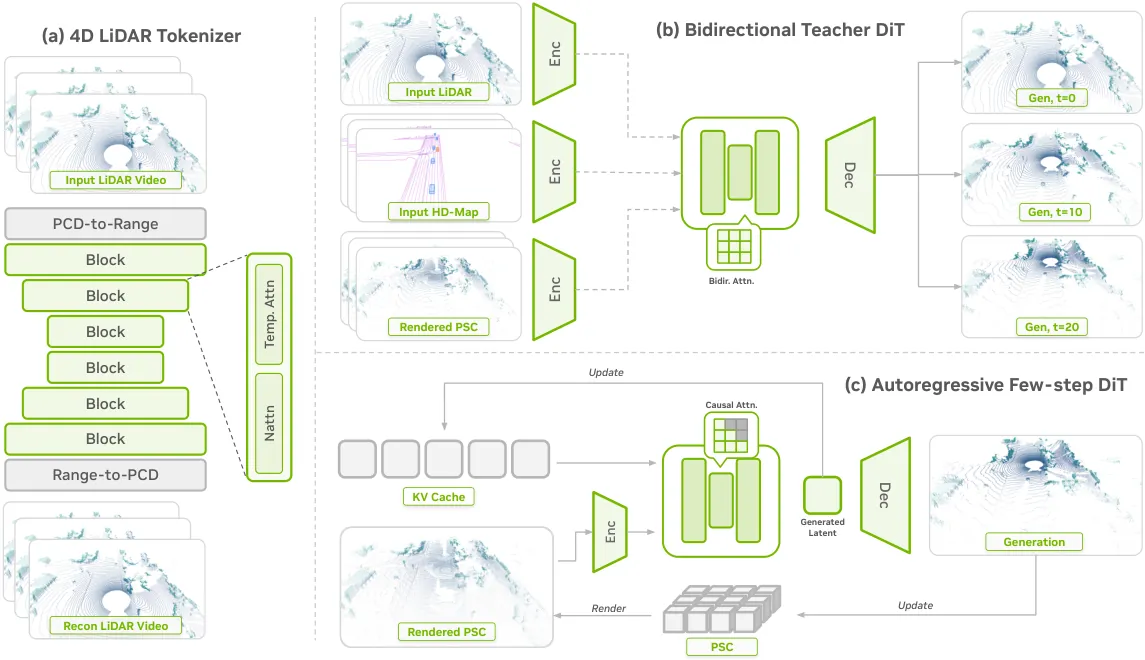
图2(论文 Figure 2,架构图):三阶段训练分别解决表示、任务统一与高效部署——(a) 全注意力 LiDAR tokenizer 学出共享潜空间并保留时空结构;(b) 双向教师学会「前缀 / HD 地图 / 持久空间缓存 / 文本」的统一条件接口;(c) 因果蒸馏 + 滚动空间缓存让同一套条件接口实时长程推理。
编码器把 $\mathbf{X}$ 映射到潜变量 $\mathbf{z}=\mathcal{E}(\mathbf{X})\in\mathbb{R}^{\frac{T}{p_{t}}\times\frac{H}{p_{s}}\times\frac{W}{p_{s}}\times c}$,解码器重建 $\widehat{\mathbf{X}}=\mathcal{D}(\mathbf{z})$。RGB 视频 tokenizer 惯例用卷积骨干(Wan、Cosmos CV 都是),但论文指出这在 LiDAR 上行不通:range image 上相邻的角度 bin,在 3D 里可能对应相距好几米的两个表面。固定的卷积聚合会把深度不连续处糊掉,正是先前工作里观察到的「深度渗漏」与波浪状边界。
替代方案是邻域注意力 NATTEN:在每个局部邻域内做内容自适应的聚合,同时避开全局自注意力的平方级显存。空间块用 $5\times 35$ 的邻域窗口、不做膨胀,并按 Nakashima 等人的做法做环形填充处理方位角断点(360° 处左右相邻)。时间上下文则通过把每个空间 NATTEN 块与时间自注意力交错注入,时间注意力只在两个低分辨率阶段使用,并施加因果掩码——每帧的表示只依赖当前与之前的帧,因此 tokenizer 天然兼容因果、变长 rollout。
跨传感器能力来自两个决定的叠加。其一是 $p_{t}=1$:LiDAR 帧率远低于 RGB 视频(Waymo 是 10 Hz),时间冗余本来就少,压缩时间等于白丢几何;保留每帧一个潜切片,还让潜表示不绑定某个固定采集频率。其二是纯注意力骨干的内容自适应聚合,本身就能容纳不同的空间采样模式。二者合起来,一个 tokenizer 检查点可以同时适配不同线数、不同角分辨率、不同帧率的传感器。
具体规格:对称 Transformer,通道宽度 $[128,256,512]$,空间深度 $[4,2,4]$,注意力头 $[4,16,16]$,编解码器各 10 个空间 Transformer 块;输入 $2\times 2$ patch embedding,MLP 扩张比 3,两层潜映射,潜通道 $c=64$。空间 $8\times 8$ 压缩,把单帧 $2\times 64\times 1024$ 映成 $64\times 8\times 128$,时间分辨率原样保留。总参数 64.5M,训练 120k 迭代。损失是四项加权和
$$\mathcal{L}_{\mathrm{tokenizer}}=\lambda_{\mathrm{depth}}\mathcal{L}_{\mathrm{depth}}+\lambda_{\mathrm{point}}\mathcal{L}_{\mathrm{point}}+\lambda_{\mathrm{mask}}\mathcal{L}_{\mathrm{mask}}+\lambda_{\mathrm{KL}}\mathcal{L}_{\mathrm{KL}}$$
其中 $\mathcal{L}_{\mathrm{depth}}$ 是有效重建 range 上的 $\ell_1$,$\mathcal{L}_{\mathrm{point}}$ 是用式 (1) 把重建 range image 反投成 3D 点后算的 $\ell_1$(沿用 LiDM 的做法,直接把几何误差算在点云空间),$\mathcal{L}_{\mathrm{mask}}$ 是掩码的 BCE,$\mathcal{L}_{\mathrm{KL}}$ 是潜后验对标准正态先验的 KL(重参数化)。权重 $\lambda_{\mathrm{depth}}=\lambda_{\mathrm{point}}=\lambda_{\mathrm{mask}}=1$,$\lambda_{\mathrm{KL}}=10^{-6}$。KL 权重小到几乎不约束潜空间,说明这里要的是重建保真度,而不是可采样性——采样交给后面的扩散模型。
四、方法之二:双向教师与四路可独立开关的条件
教师从 Cosmos-Transfer2.5-2B 初始化:28 个 DiT 块、隐藏宽度 2048、16 个注意力头,每块做时空自注意力 + (需要时的)文本交叉注意力 + 带 AdaLN-LoRA 时间条件的 MLP,保留 3D 旋转位置编码与 flow matching 形式,只把输入/输出投影改到 LiDAR 潜空间与条件通道。给定干净潜变量 $\mathbf{z}$,采样 $\bm{\epsilon}\sim\mathcal{N}(\mathbf{0},\mathbf{I}_{\mathrm{lat}})$ 与流时间 $\tau\in[0,1]$,构造
$$\mathbf{z}_{\tau}=(1-\tau)\mathbf{z}+\tau\bm{\epsilon},\qquad \mathbf{v}^{*}=\frac{\partial\mathbf{z}_{\tau}}{\partial\tau}=\bm{\epsilon}-\mathbf{z}$$
教师学着预测速度场 $\mathbf{v}^{*}$。四路条件编码的是不同形态的现场证据,而不是任务身份:
(1)LiDAR 前缀:$K$ 个已观测扫描转成 range image、经 tokenizer 编码,其干净潜变量占据前 $K$ 个时间位,与带噪目标潜变量在时间维拼接;二值掩码标出已观测位,生成损失只加在目标位上。这条通道支持「从一帧或多帧观测继续往下长」。
(2)HD 地图与演员布局:包含车道中心线、路面标线、道路边界、人行横道与 3D 框。给定静态图元 $\mathcal{M}$、演员框 $\mathcal{B}_{t}$、目标 LiDAR-to-world 位姿 $\mathbf{T}_{t}$,把它们变换到目标 LiDAR 坐标系并栅格化成 range 对齐的表示
$$\mathbf{H}_{t}=\Pi_{\mathrm{map}}(\mathcal{M},\mathcal{B}_{t};\mathbf{T}_{t})$$
$\Pi_{\mathrm{map}}$ 按式 (2) 在每条标定射线上只保留最近的元素,预处理直接用 Cosmos-Drive-Dreams 放出的工具。得到的 range image 编码成 $\mathbf{h}_{t}=\mathcal{E}(\mathbf{H}_{t})$,在通道维与带噪 LiDAR 潜变量拼接。
(3)持久空间缓存 PSC:世界对齐的几何记忆 $\mathcal{G}$,由观测或先前生成的点云累积而成。在目标位姿处投影成 range image
$$\mathbf{G}_{t}=\Pi_{\mathrm{geometry}}(\mathcal{G};\mathbf{T}_{t})$$
$\Pi_{\mathrm{geometry}}$ 把世界系点变换到目标 LiDAR 系并在每条射线上保留最近射程,编码为 $\mathbf{g}_{t}=\mathcal{E}(\mathbf{G}_{t})$ 后同样在通道维拼接。教师训练时 $\mathcal{G}$ 由真值扫描构造成两种模式:静态背景模式先剔除标注动态框内的点再累积;冻结动态模式额外把每个演员在自己的局部坐标系里累积,再按时刻 $t$ 的框位姿摆放。因果模型用完全相同的投影、编码、注入流程,只是 $\mathcal{G}$ 改为在线由生成历史构建——这是「同一个条件接口贯穿三阶段」的关键。
(4)文本:沿用 Cosmos-Drive-Dreams 的做法,用 Qwen2.5-VL-7B-Instruct 把场景描述改写成带多样天气与外观属性的 caption,再用 Cosmos-Reason1 文本编码器映射成 token embedding,作为每个 DiT 块的交叉注意力上下文。文本管环境属性,空间条件管场景几何,两者职责不重叠。
统一条件阶段的所有因子独立采样:以 0.5 的概率让前缀长度 $K$ 从 $\{1,2,4,8,10,12,16\}$ 均匀抽取,否则 $K=0$;HD 地图以 0.5 概率用 null token 丢掉;PSC 在「空几何 / 静态背景 / 冻结动态」上分别以 $0.1/0.45/0.45$ 采样,冻结动态模式下源扫描数 $N_{\mathcal{G}}$ 从 $\{1,2,4,8,10,12,16,20\}$ 均匀抽;文本走 20% 的 classifier-free dropout。这种因子化采样让模型见过大量证据组合,却不需要任何任务专用 token 或专用目标。
训练课程也不是直接混合条件:270k 迭代分三段——先 150k 迭代在 9 帧片段上只做 HD 地图条件生成,再 100k 迭代换成 21 帧片段,最后 20k 迭代在 21 帧上做统一条件。论文明说这个课程比一上来就联合条件训练效果更好。全局 batch 32,AdamW,$\mathrm{lr}=10^{-5}$,$\beta=(0.9,0.999)$,权重衰减 0.01,RF 时间步 shift 5。
五、方法之三:因果蒸馏与自强制分布匹配
双向教师的全序列注意力 + 迭代去注声不适合交互仿真,所以要先蒸成一个少步、块自回归的因果学生。因果初始化阶段从教师权重出发,把完整时间注意力换成块因果模式:为了支持从单帧起步,用一个单例 attention sink,后接 4 帧一块;前序块的干净真值潜变量存进 K/V cache,当前活动块独立加噪、独立去噪。这一步在 21 帧片段上跑 10k 迭代 teacher forcing,目的只是让权重先适应因果注意力。
接着是自强制分布匹配蒸馏 SF-DMD:学生顺序采样每个 4 帧块,每块用 4 步 shifted rectified-flow SDE,采完把生成的干净潜变量提交进 K/V cache、更新循环条件状态,再采下一块。因此训练时看到的时间历史与几何历史,就是推理时它自己会产生的那一套——这正是「自强制」的含义,也是它与普通蒸馏的差别。目标不是把 rollout 回归到配对的真值序列,而是让它的分布对上真实 LiDAR 潜分布。设自 rollout 序列为 $\widetilde{\mathbf{z}}$,加噪到 $\widetilde{\mathbf{z}}_{\tau}$ 后,一个冻结的真实数据去噪器与一个可学习的生成数据去噪器分别给出干净估计 $\widehat{\mathbf{z}}_{0}^{\mathrm{real}}$ 与 $\widehat{\mathbf{z}}_{0}^{\mathrm{gen}}$;对一个回放的去噪步定义自适应尺度 $a=\operatorname{mean}\lvert\widetilde{\mathbf{z}}-\widehat{\mathbf{z}}_{0}^{\mathrm{real}}\rvert+\varepsilon$,学生的干净预测 $\widehat{\mathbf{z}}_{0}^{\mathrm{stu}}$ 按
$$\mathcal{L}_{\mathrm{SF\text{-}DMD}}=\mathbb{E}\!\left[\frac{1}{2}\left\|\widehat{\mathbf{z}}_{0}^{\mathrm{stu}}-\operatorname{sg}\!\left[\widetilde{\mathbf{z}}-\frac{\widehat{\mathbf{z}}_{0}^{\mathrm{gen}}-\widehat{\mathbf{z}}_{0}^{\mathrm{real}}}{a}\right]\right\|_{2}^{2}\right]$$
优化,$\operatorname{sg}$ 是 stop-gradient,$a$ 做自适应归一。真实数据去噪器全程冻结;生成数据去噪器由它初始化,并在自 rollout 上用 rectified-flow 目标继续训练。这一阶段只跑 2k 迭代,每个 cycle 更新一次 fake-score 网络、每五个 cycle 更新一次学生;学生 $\mathrm{lr}=2\times10^{-6}$,fake-score $\mathrm{lr}=4\times10^{-7}$,蒸馏教师 CFG 3.0,$\eta=1$ 的四步 SDE 噪声阶梯是 $(1,\,15/16,\,5/6,\,5/8,\,0)$,0 表示干净端点。最终学生维护 9 帧滚动 K/V cache,其中含 1 个持久 sink 帧。
六、方法之四:滚动持久空间缓存,把「记住」这件事从注意力里搬出来
有限的时间 K/V cache 只留得住最近的潜上下文,加长它的显存和算力代价都在涨;而一旦某个观测滑出窗口,模型就可能忘掉先前生成过的场景结构。论文的解法是维护一张稀疏的、世界对齐的体素图 $\mathcal{V}$ 作为滚动 PSC:条件接口与 3.2 节完全一致,但底层几何在线由生成历史构建。生成完第 $b$ 块后,把每个潜变量 $\widetilde{\mathbf{z}}_{t}$ 解码成点云 $\widetilde{\mathcal{X}}_{t}$,用对应位姿配准到公共世界系,再更新体素图:
$$\mathcal{V}_{b}=\mathcal{U}(\mathcal{V}_{b-1},\mathcal{Y}_{b}),\qquad \mathcal{Y}_{b}=\bigcup_{t\in\mathcal{T}_{b}}\mathbf{T}_{t}\widetilde{\mathcal{X}}_{t}$$
每个被占据的体素 $v$ 存三样东西:最近一次配准进来的点 $\mathbf{p}(v)$、观测计数 $n^{\mathrm{obs}}(v)$、移除计数 $n^{\mathrm{rem}}(v)$,且每个源帧对同一体素最多贡献一次观测。被观测到就更新点、加观测计数、清零移除计数;有有效的自由空间证据与它矛盾就加移除计数。要求重复观测,是为了不让瞬时生成错误进入持久记忆;要求重复矛盾,是为了不让一帧不一致的扫描删掉有效结构。生成第 $b+1$ 块之前,只保留已确认且未被移除的体素,并在每个请求的目标位姿上渲染:
$$\mathcal{P}(\mathcal{V}_{b})=\left\{\mathbf{p}(v)\mid n^{\mathrm{obs}}(v)\geq N_{\min},\; n^{\mathrm{rem}}(v)<N_{\mathrm{rem}}\right\}$$
$$\mathbf{g}_{t}^{\mathrm{cache}}=\mathcal{E}\!\left(\Pi_{\mathrm{geometry}}(\mathcal{P}(\mathcal{V}_{b});\mathbf{T}_{t})\right),\qquad t\in\mathcal{T}_{b+1}$$
实现细节给得很实:$0.15\,\mathrm{m}$ 立方体素;陈旧几何的检测方式是把候选缓存点投进最后一个扫描的 range image,若其周围 $3\times3$ 像素有有效回波、且比缓存点远超过 $0.75\,\mathrm{m}$,就给该体素加一次移除计数;只有 $n^{\mathrm{obs}}\geq N_{\min}=3$ 的体素才参与渲染 PSC;累计 $N_{\mathrm{rem}}=2$ 次矛盾的体素连同计数一起删除,之后若再被观测到必须重新攒够观测阈值。缓存更新只在块生成之后发生,因此每个块查询到的几何只可能来自更早的块——既不自条件,也不泄露未来。
flowchart TB
    RI[Range image 2x64x1024
射程 R 加有效性掩码 M] --> TOK[通用 tokenizer
空间 NATTEN 5x35 环形填充
因果时间注意力 pt=1]
    TOK --> LAT[共享潜空间 64x8x128
c=64 与 64.5M 参数]
    LAT --> TEA[双向教师 28 块 2048 宽
Cosmos-Transfer2.5-2B 初始化
flow matching 预测 v]
    PRE[条件一 LiDAR 前缀 K 帧
p=0.5 K 取 1 2 4 8 10 12 16] --> TEA
    MAP[条件二 HD 地图与演员框
H_t 通道维拼接 丢弃概率 0.5] --> TEA
    PSC[条件三 持久空间缓存 G_t
空 0.1 静态背景 0.45 冻结动态 0.45] --> TEA
    TXT[条件四 文本 caption
Qwen2.5-VL 改写 CFG 丢弃 20%] --> TEA
    TEA -->|课程 150k 加 100k 加 20k| INIT[因果初始化 10k 迭代
1 个 sink 帧加 4 帧块
teacher forcing]
    INIT -->|SF-DMD 2k 迭代
学生每 5 cycle 更新一次| STU[四步因果学生
SDE 阶梯 1 15/16 5/6 5/8 0
9 帧滚动 K/V cache]
    STU -->|每块解码并世界系配准| ROLL[滚动物素图 0.15 m
U 更新 V_b 加 Y_b
N_min=3 与 N_rem=2 与 0.75 m]
    ROLL -->|只在块生成之后回灌| STU
    STU --> OUT[一份权重 单张 H100 11 FPS]
    OUT --> G1[无观测证据 到 生成新世界]
    OUT --> G2[给前缀 到 点云预测]
    OUT --> G3[给 PSC 到 可泛化重仿真 零逐场景优化]
图解:三阶段训练与推理时的证据谱系。注意滚动 PSC 那条回边——它把学生自己的输出写回体素图,再作为下一块的条件,但严格滞后一个块。
推理侧因此形成一条连续谱系:每种模式都会拿到请求的目标传感器位姿,HD 地图可选;把观测到的 LiDAR 证据逐步加多(先前缀、再 PSC),同一个因果检查点就从「生成新世界」滑到「预测一段已观测序列的未来」,最后滑到「重演某个特定采集场景」。重仿真模式下,稀疏观测扫描被累积成一个固定的冻结动态 PSC,再在新目标位姿上渲染,既不需要 HD 地图条件,也不需要任何逐场景优化;生成模式下 PSC 是滚动的、由生成扫描构建;动作条件生成则由用户给的自车动作决定未来传感器位姿。
七、代码对照:论文里每个常数,仓库里都有一个配置键
对应一:环形 NATTEN 就是方位轴上的 circular pad。论文说「$5\times35$ 邻域窗口、无膨胀、环形填充以处理方位角断点」,在 tokenizer/networks/transformers/transformer_vae.py 里是注意力前后各一段填充/裁剪,中间调 NATTEN 的 2D 核:
def before_attn(self, q, k, v):
    if not self.circular:
        return q, k, v
    padding = self.kernel_size[1] // 2
    q = F.pad(q, (0, 0, 0, 0, padding, padding), mode="circular")
    k = F.pad(k, (0, 0, 0, 0, padding, padding), mode="circular")
    v = F.pad(v, (0, 0, 0, 0, padding, padding), mode="circular")
    return q, k, v

# residual() 内
h = natten.functional.na2d(
    query=q, key=k, value=v,
    kernel_size=self.kernel_size,
    dilation=self.dilation,
    scale=1.0,
    **self._inference_natten_kwargs,
)注释也直接写着这条轴的语义是周期的:# periodic: it is circularly padded before the neighborhood attention;关掉 circular 时 NATTEN 会在宽度边缘截断邻域。教师侧的 diffusion/training/networks/neighborhood_attn.py 则把 NATTEN 的性能开关打开(use_kv_parallelism_in_fused_na(True)、set_memory_usage_preference("unrestricted")),并按 window_size / stride / dilation / is_causal 做自适应配置——论文的「避免全局注意力平方显存」是靠这套 fused kernel 落地的。
对应二:PSC 的全部数值都在 stage3 配置里。论文「Cache Implementation」段的 $0.15\,\mathrm{m}$、$3\times3$、$0.75\,\mathrm{m}$、$N_{\min}=3$、$N_{\mathrm{rem}}=2$、9 帧 K/V cache、1 个 sink 帧、4 步、$\eta=1$,逐条对得上 diffusion/training/config/text2world_hdmaptolidar/experiment_lidarverse.py:
stage3_config["model"].update(
    sfdmd_num_steps=4,
    sfdmd_sde_eta=1.0,
    sfdmd_kv_cache_frames=9,
    sfdmd_kv_sink_frames=1,
    sfdmd_tbptt_blocks=2,
    sfdmd_fake_updates_per_cycle=1,
    sfdmd_student_update_freq=5,
    sfdmd_spatial_map_radius_m=100.0,
    sfdmd_spatial_map_voxel_m=0.15,
    sfdmd_spatial_map_voxel_policy="persistent_static",
    sfdmd_spatial_map_observation_unit="block",
    sfdmd_spatial_map_static_min_observations=3,
    sfdmd_spatial_map_free_space_clear=True,
    sfdmd_spatial_map_free_space_margin_m=0.75,
    sfdmd_spatial_map_free_space_misses_to_remove=2,
)
缓存本体是 diffusion/training/datasets/lidar_dataset/forecast_warp.py 里的 TorchSpatialPointMap,类文档串把式 (8)(9) 的语义讲得比论文更细:体素「在被足够多的观测单元占据之后才提升」(persistent_static 策略,block 单元表示每个已提交块最多计一次),最新一帧可以作为临时层保留以免当前动态物体消失;自由空间清除「只在多条在射程内的当前射线穿过该体素打到更远回波之后」才移除已确认体素,更近的回波、缺失射线、超射程体素都算不可观测;渲染时查一个常驻 GPU 的粗 XY 单元索引,再对临时子集施加精确的目标局部半径掩码,全局图不被修改。论文那句「每个源帧对同一体素最多贡献一次观测」,对应的就是 observation_unit="block" 这一档。
对应三:SF-DMD 的自适应尺度与四步阶梯都是显式函数。diffusion/training/utils/sf_dmd.py 里 fixed_sde_sigmas(num_steps=4, shift=5.0) 直接返回 [1.0, 15/16, 5/6, 5/8, 0.0],并留了一行注释「Preserve the original four-step schedule exactly for existing runs」;dmd_pseudo_target 构造的正是式 (7) 里的伪目标:
weight = 1.0 / ((generated.detach() - teacher_x0.detach())
                .abs().mean(dim=reduce_dims, keepdim=True) + eps)
vsd_grad = fake_x0.detach() - teacher_x0.detach()
target = generated.detach() - weight * vsd_grad
return target.detach(), weight.detach()
这里的 weight 就是 $1/a$($a$ 用 generated 与 teacher_x0 的绝对差均值加 $\varepsilon$),vsd_grad 是 $\widehat{\mathbf{z}}_{0}^{\mathrm{gen}}-\widehat{\mathbf{z}}_{0}^{\mathrm{real}}$,整体 detach 对应 $\operatorname{sg}[\cdot]$。配套的 sde_renoise 实现了 $\eta$ 混合:eps_used = (1-eta)*eps_implied + eta*eps_fresh,再按 (1-sigma)*x0 + sigma*eps_used 前进一步;rf_velocity_to_x0 则是把仓库约定的速度「noise − clean」换算成干净 $\mathbf{x}_0$ 的一行减法。
八、实验:三套协议、一份权重
主训练与主评测都在 Waymo Open Dataset 上:训练 798 段、验证 202 段,每段约 20 秒 10 Hz,合起来约 16 万扫描、4.4 小时传感器数据、14.28 万个可重叠的 21 帧训练片段。跨传感器实验另外在 NVIDIA PAI(111,988 段)、Waymo、nuScenes(722 段)上联合微调 tokenizer 与教师,约 64 万个唯一 21 帧片段,三个数据集等概率采样,以防体量大得多的 PAI 主导训练。
8.1 tokenizer:几何保真度是主要收益,分布指标不是全胜
所有基线都用同一套 range-image 表示从头重训,并且都配上同一个 DiT 架构、训练配方与评测协议(9 帧序列),这样才能把「潜表示好不好建模」这件事从骨干差异里剥出来。
| 方法 | 时空压缩率 | CD ↓ | $L_1$ ↓ | AbsRel ↓ | JSD ↓ | MMD ↓ | FUD ↓ | ICP Avg ↓ | TFLOPs/帧 ↓ |
|---|---|---|---|---|---|---|---|---|---|
| 256× 压缩档 | |||||||||
| Cosmos CV | 8x8x4 | 0.439 | 0.790 | 0.031 | 0.061 | 6.41 | 46.26 | 0.089 | 0.058 |
| Wan2.1 | 8x8x4 | 0.297 | 0.395 | 0.017 | 0.057 | 5.72 | 37.52 | 0.077 | 0.911 |
| Ours | 16x16x1 | 0.175 | 0.143 | 0.008 | 0.061 | 6.87 | 32.84 | 0.072 | 0.400 |
| 32× / 64× 压缩档 | |||||||||
| LiDM | 4x8x1 | 0.297 | 0.371 | 0.016 | 0.057 | 5.48 | 36.22 | 0.088 | 0.212 |
| Cosmos LiDARGen | 8x8x1 | 0.384 | 0.609 | 0.025 | 0.062 | 7.99 | 85.37 | 0.085 | 0.302 |
| Ours | 8x8x1 | 0.115 | 0.072 | 0.005 | 0.065 | 9.14 | 18.17 | 0.059 | 0.250 |
表1(论文 Table 2 精简):同一个 DiT 下的 tokenizer 对比。MMD 已乘 $10^5$。
重建侧的优势是压倒性的:在 $8\times8\times1$ 档,CD 0.115 对 LiDM 的 0.297(−61%),$L_1$ 0.072 对 0.371,AbsRel 0.005 对 0.016,而 LiDM 用的还是更低的 32× 压缩率;感知侧 FUD 18.17 对 36.22(−50%)。在被拉到同一 256× 压缩档时,不压时间的设计把 CD 降 41%、AbsRel 降 53%,TFLOPs/帧 0.400 只有 Wan2.1(0.911)的 44%。但要如实读表:分布类指标 JSD(0.065 对 LiDM 0.057)与 MMD(9.14 对 5.48)在低压缩档并不是最好的。BEV 统计分布更接近、单帧几何与特征空间质量显著更好,这两件事在这里并不等价,论文的主张也落在前者。
8.2 自回归生成:4 步打 256 步,帧率差两个数量级
| 方法 | 采样步数 | JSD ↓ | MMD ↓ | FUD ↓ | CTC@1 ↓ | CTC@4 ↓ | ICP Avg ↓ | FPS ↑ |
|---|---|---|---|---|---|---|---|---|
| HD 地图条件生成 | ||||||||
| LiDARCrafter | 256 | 0.065 | 14.13 | 97.24 | 0.278 | 0.519 | 0.120 | 0.127 |
| LaGen* | 35 | 0.075 | 19.19 | 50.29 | 0.205 | 0.390 | 0.071 | 0.402 |
| Sensor2Sensor* | 35 | 0.047 | 5.210 | 37.96 | 0.225 | 0.404 | 0.081 | 0.421 |
| Ours(因果) | 4 | 0.046 | 4.390 | 25.01 | 0.210 | 0.331 | 0.068 | 11.18 |
| 交互式动作条件生成(给首帧真值 再生成 128 帧 无 HD 地图) | ||||||||
| LiDARCrafter | 256 | 0.137 | 54.383 | 70.38 | 0.258 | 0.483 | 0.104 | 0.135 |
| LaGen* | 35 | 0.064 | 12.51 | 42.31 | 0.256 | 0.550 | 0.074 | 0.754 |
| Ours(因果) | 4 | 0.054 | 7.391 | 24.17 | 0.213 | 0.347 | 0.068 | 11.30 |
表2(论文 Table 3 精简):MMD 已乘 $10^5$;带 * 的是作者用自家 tokenizer + 匹配 DiT 重训的复现版本(LaGen 与 Sensor2Sensor 在实验期间未公开代码)。Sensor2Sensor 没有注入自车位姿的原生机制,故不参与动作条件评测。
最有说服力的一组对比是速度:LiDARCrafter 用 256 步采样、FUD 97.24、0.127 FPS;LidarVerse 用 4 步、FUD 25.01、11.18 FPS。约 88 倍的吞吐差同时伴随约 3.9 倍的 FUD 改善,说明「少步」不是拿质量换的。短时程时间一致性上它与基线互有胜负(CTC@1 0.210 对 LaGen* 的 0.205),但长时程 CTC@4 0.331 是全场最好,论文把这归因于因果蒸馏保住了教师的质量、同时滚动缓存撑住了长程连贯。图 9 的分窗 FUD 曲线显示它随时间退化得慢得多,而基线在 100 帧之后肉眼可见地崩掉。
8.3 点云预测:没有预测头,只换证据量
协议沿用 Khurana 等人:3 秒历史预测 3 秒未来,10 Hz 下即 30 帧进 30 帧出,报 1s / 2s / 3s 三个时点的 $L_1$、AbsRel 与内侧 Chamfer 距离。值得注意的是这一任务上作者把 K/V cache 从 9 帧调到 21 帧,因为经验上预测更吃长上下文——这也侧面说明缓存长度是一个任务相关的旋钮,而不是全局常量。
| 方法 | $L_1$ @1s ↓ | $L_1$ @3s ↓ | AbsRel 聚合 ↓ | CD @1s ↓ | CD @3s ↓ | CD 聚合 ↓ |
|---|---|---|---|---|---|---|
| Raycasting | 2.461 | 3.768 | 0.193 | 1.584 | 6.049 | 2.739 |
| 4D-Occ | 2.146 | 3.052 | 0.126 | 2.173 | 4.575 | 2.924 |
| UnO* | 2.040 | 2.654 | 0.126 | 1.000 | 1.440 | 1.070 |
| Ours | 1.482 | 2.554 | 0.108 | 0.485 | 1.328 | 0.676 |
表3(论文 Table 4 精简):* 表示作者尽力复现(UnO 未公开代码)。聚合列为 1s/2s/3s 的合并结果。
聚合 CD 0.676 对 UnO* 的 1.070,是 37% 的改善;1 秒处的 0.485 对 1.000 更夸张。定性上(论文 Figure 10)模型保住了交通参与者的形状并给出合理的未来运动,而在未来视角揭示出历史里根本没观测过的区域时,朴素 raycasting 直接失效,共享生成先验却能把场景结构补全——这正是「预测不是一个独立预测架构,而是同一个世界模型的中间推理档位」的证据。
8.4 可泛化重仿真:零优化时间对上 76–90 分钟
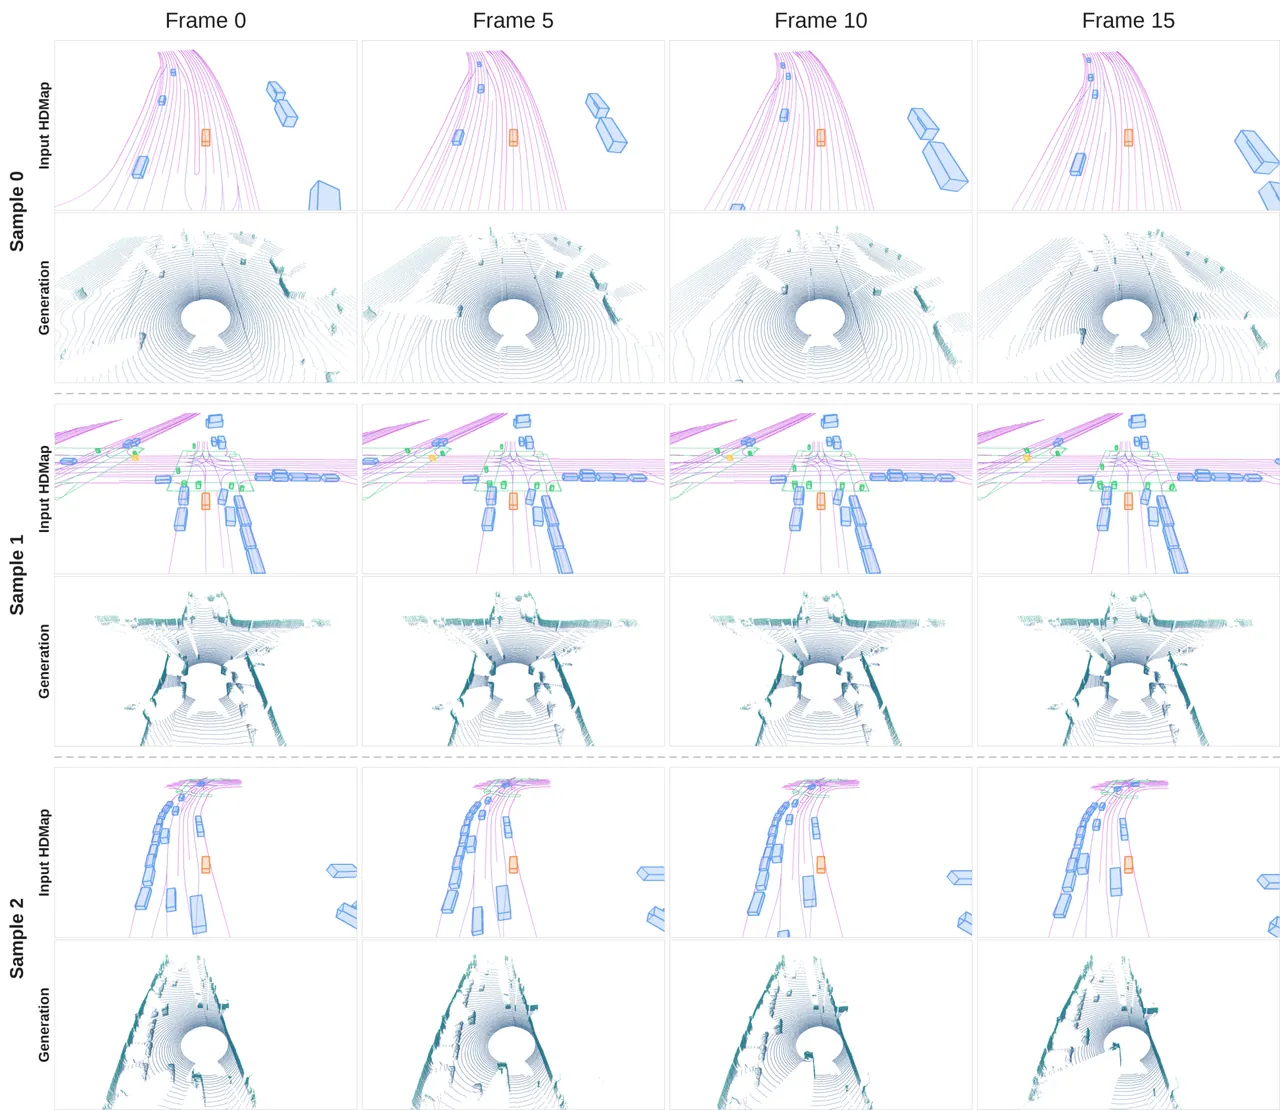
图3(论文 Figure 4):双向教师的 HD 地图条件生成,21 帧条件对应 21 帧地图序列。Sample 0 是高速路,Sample 1 是行人密集的路口,Sample 2 是一辆从后方逼近的卡车;每段都只给了 HD 地图这一个条件。
评测协议:20 帧不重叠片段,用第 0、4、9、14 帧作输入,其余 16 帧里 11 帧是内插(0–14 去掉四个输入帧)、5 帧是外推(15–19)。除了 202 段全量验证集,作者还按整段自车路径长度排序取前 20 段、每段切 9 个不重叠 20 帧窗口,得到 180 个窗口的「长行驶距离子集」。
| 方法 | All-202 内插 $L_1$ ↓ | All-202 外推 $L_1$ ↓ | All-202 聚合 $L_1$/CD ↓ | Top-20 聚合 $L_1$/CD ↓ | 逐场景优化时间 ↓ | 实时渲染 |
|---|---|---|---|---|---|---|
| LiDAR4D | 1.129 | 1.881 | 1.364 / 0.273 | 2.401 / 1.239 | 89.8 分钟 | 否 |
| LiDAR-RT | 1.089 | 1.593 | 1.247 / 0.256 | 2.277 / 0.709 | 76.3 分钟 | 是 |
| SplatAD | 1.799 | 2.325 | 1.964 / 0.309 | 3.603 / 0.542 | 15.0 分钟 | 是 |
| Ours(双向教师) | 1.124 | 1.376 | 1.202 / 0.200 | 1.536 / 0.237 | 0.00 | 否 |
| Ours(因果学生) | 1.279 | 1.682 | 1.405 / 0.285 | 1.787 / 0.294 | 0.00 | 是 |
表4(论文 Table 6):基线用各自公开代码库、为每条测试序列单独优化一个场景表示;LidarVerse 一份检查点通吃所有场景、测试时零优化。双向教师作为质量参考列出。
这张表要分两半读。全量 202 段上,因果学生的聚合 $L_1$ 1.405 / CD 0.285 其实不如 LiDAR-RT(1.247 / 0.256)和 LiDAR4D(1.364 / 0.273)——它换来的是优化时间从 76–90 分钟降到 0,且渲染实时。真正的全胜在长行驶距离子集:1.787 / 0.294 对 LiDAR-RT 的 2.277 / 0.709、LiDAR4D 的 2.401 / 1.239、SplatAD 的 3.603 / 0.542,每一项都赢,而且 CD 领先幅度在 2.4 倍以上。这个分布很合理:跑得越远,逐场景重建的表示越要外推到输入扫描稀疏甚至没扫过的区域,而生成先验恰好擅长补全合理结构。双向教师几乎在所有指标上是质量上限(All-202 聚合 1.202 / 0.200),代价是不实时。
8.5 强度、跨传感器与消融
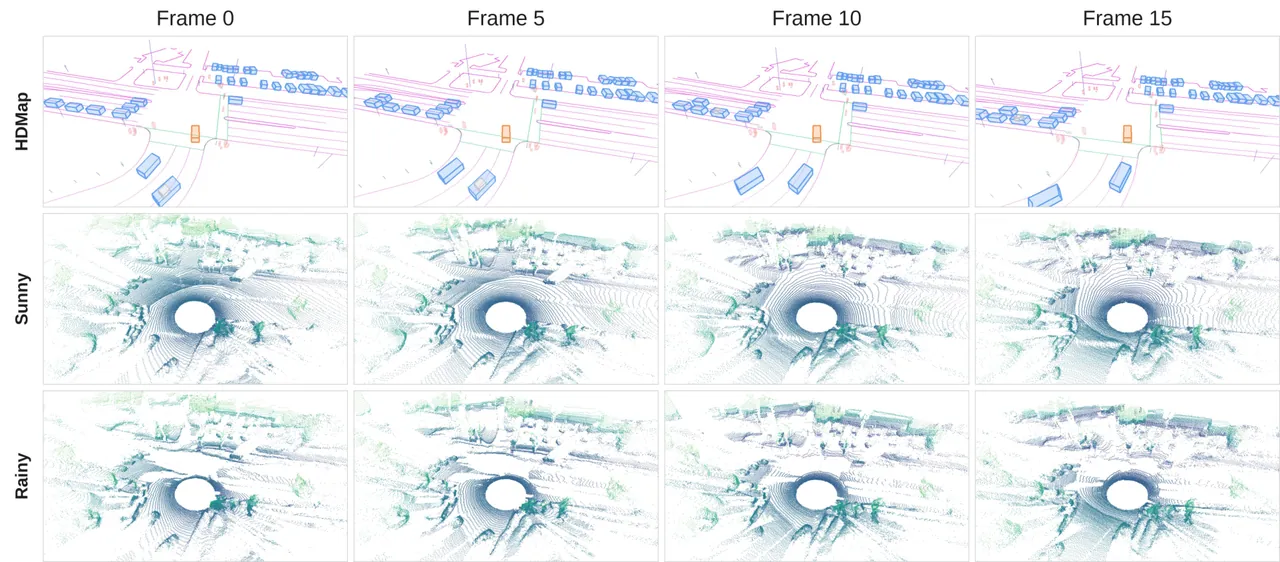
图4(论文 Figure 7):文本控制的天气生成。把原本的晴天场景 prompt 改成要求雨天,微调后的文本条件双向教师在 NVIDIA PAI 数据上给出同一场景的雨天版本——文本管外观,空间条件管几何,两者不打架。
强度建模走的是「微调 tokenizer 重建强度 → 在 range-intensity 联合潜表示上微调双向教师」,在 Top-20 子集上强度 RMSE 内插 0.078 / 外推 0.091 / 聚合 0.082,与 LiDAR4D 的 0.077 / 0.094 / 0.082 打平,明显好于 SplatAD 的 0.115 / 0.134 / 0.121。跨传感器部分则给出一个反直觉的结果:联合训练比各自专家更好——通用 tokenizer 在 nuScenes / Waymo / NVIDIA PAI 上的 $L_1$ 是 0.065 / 0.037 / 0.087,而只在单一数据集上训练的专家是 0.087 / 0.056 / 0.286;CD 上除 nuScenes 略逊(0.568 对 0.557)外也全面占优(0.710 对 0.718、1.135 对 1.240)。它还能直接泛化到训练里没出现过的 PandaSet 扫描模式,并且换一个传感器 embedding,就能从同一份 Waymo HD 地图生成 nuScenes / PAI / Waymo 三种不同的扫描图案。
三组消融把设计选择逐条钉住。(i)注意力 vs 卷积骨干(同为 $8\times8\times1$、同潜维度、同 DiT 与训练协议):$L_1$ 0.072 对 0.297、CD 0.115 对 0.278、AbsRel 0.005 对 0.015、FUD 18.17 对 26.54、CTC@4 0.339 对 0.341、TTCE@4 2.463 对 2.496,而 TFLOPs/帧 0.250 对 0.575——算力降 57% 的同时全面更好;两者都只在 9 帧序列上训练,却在 202 段验证集的 129 帧序列上评测,注意力骨干超出训练时域后依然更稳。(ii)缓存配置:时间 K/V cache 在 $\{5,9,13,17,21\}$ 上扫、PSC 开或用学到的 null 条件替代。去掉空间缓存会显著恶化时间一致性而对 FUD 影响很小;加长 K/V cache 改善时间一致性但同时降低吞吐与保真度——所以最终选 9 帧 + 空间缓存这一折中(吞吐在单张 H100 的 10 段匹配片段上测)。(iii)体素确认阈值:$N_{\min}\in\{1,2,3,4,5\}$,直接注册最新生成扫描($N_{\min}=1$)的时间一致性指标最好但保真度更差,最终取 3。(iv)统一 vs 专家:同等训练预算下,统一模型在生成 MMD(6.843 对 6.950)与 ICP Avg(0.044 对 0.047)上更好,专家在 FUD(14.67 对 16.05)与重仿真 $L_1$/CD(1.380/0.235 对 1.536/0.237)上更好——一份检查点覆盖两个范式,代价是这几项上的小幅让步。
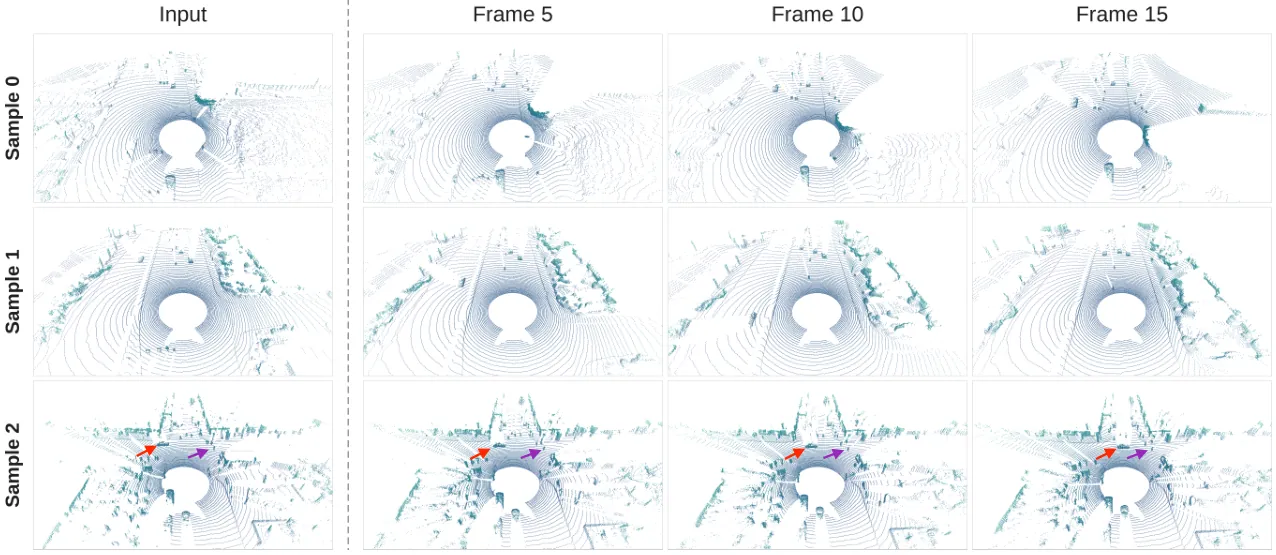
图5(论文 Figure 6):双向教师的首帧条件生成。红箭头标出一辆正在穿过路口的车,紫箭头标出人行横道上的行人;Sample 0 高速、Sample 1 城市车流、Sample 2 拥挤路口。只给一帧观测,剩下的动态由模型自己长出来。
九、局限
作者自述的四条。其一,目前只建模单台旋转式 LiDAR,固态 LiDAR 与多 LiDAR rig 的联合生成留作未来工作(可用 Waymo、Argoverse 2 数据)。其二,动态重仿真在训练与推理两侧都依赖标注的物体位姿——冻结动态模式要把每个演员按框位姿摆进缓存——这直接限制了它扩展到无标注场景的能力;无标注的可泛化重仿真仍是 LiDAR 侧的开放问题。其三,模型只做 LiDAR,相机与 LiDAR 的同步联合生成才是更完整的自动驾驶仿真。其四,结论段自己承认:尚未评测完整的闭环系统,交互式动作条件与指定位姿重仿真只是通往闭环的关键能力,不是闭环本身。
读表之后我补充的四条。第一,表 3 里的 LaGen* 与 Sensor2Sensor*、表 4 里的 UnO* 都是作者自行复现(原方法实验期间未公开代码),复现强度无从外部校验,这几行的领先幅度要打折看;LiDARCrafter 与三个重仿真基线用的是官方代码库,可比性更强。第二,「实时」只属于因果学生:强度建模、跨传感器生成、文本控制天气这三块结果都出自微调后的双向教师,而教师在表 6 里被明确标为「非实时渲染」。把这些能力算进同一个模型的宣传口径时,需要留意它们目前的运行档位不同。第三,重仿真的胜出高度依赖子集选择:全量 202 段上因果学生的 $L_1$/CD 落后于 LiDAR-RT 与 LiDAR4D,赢面集中在长行驶距离子集——这个子集恰好是逐场景重建最吃亏的地方,结论成立,但它不是「在所有设置下都更好」。第四,主协议以 Waymo 为中心(PAI 与 nuScenes 只出现在跨传感器实验里),且没有任何规划器在环的闭环指标,所以严格说它是一个传感器模拟器,还不是一个可用于策略评估的世界模型。
十、总结与展望
LidarVerse 的贡献可以拆成三层,且三层是相互支撑的。表示层:一个不压时间、用环形 NATTEN 做空间聚合的纯注意力 tokenizer,让 32/64/128 线共用一份检查点,并且潜空间对下游扩散明显更好建模(FUD 减半、算力还降 57%)。接口层:把「前缀 / HD 地图 / PSC / 文本」做成四路可独立丢弃的条件,用因子化采样而不是任务 token 训练,于是一个双向教师同时表达生成、预测、重仿真三种行为。部署层:因果初始化 + SF-DMD 把它压到 4 步块自回归,滚动体素缓存补上有限 K/V 窗口之外的持久几何,最终在单张 H100 上跑过 LiDAR 原生 10 Hz。
对做机器人/自动驾驶仿真的人,直接可用的结论有三条。一,如果你已经在用 range image,把卷积骨干换成环形邻域注意力几乎是白拿的收益:更准、更省、超出训练时域还更稳。二,长程一致性问题不一定要靠加长注意力窗口解决——把「记住」这件事挪到一个显式的世界对齐体素缓存里,配上重复观测才提升、重复矛盾才删除的保守策略,比单纯堆 K/V 长度在质量与吞吐上都更划算。三,任务统一是可以做到的,但要接受小幅让步:统一模型在 FUD 与重仿真 $L_1$ 上确实不如预算相同的专家,换来的是部署面减半。下一步的自然方向是作者点出的三条——固态与多 LiDAR、无标注动态重仿真、相机与 LiDAR 联合生成——再加上论文没做的那一条:把规划器接进这个 11 FPS 的循环里,看它能不能真正评估策略。
金句
“Generation, forecasting, and resimulation are therefore different ways of querying the same learned world, distinguished by the available evidence rather than by model parameters.”
生成、预测与重仿真是查询同一个已学世界的不同方式,区别在于手上有多少可用证据,而不在于模型参数。
“Changing the conditions, rather than the architecture, moves one model between generative simulation and reconstruction-grounded resimulation.”
改变条件、而不是改变架构,就能让同一个模型在生成式仿真与重建支撑的重仿真之间来回切换。