PAPER DEEP DIVE
Social-WM:面向机器人社交导航的安全感知隐空间世界模型
社交导航不只要求机器人预判动作后果,还要求它判断一条名义动作在当前物理与社交约束下是否真能执行。Social-WM 从第一视角 RGB 序列训练一个轻量隐空间世界模型,把名义动作与可实现动作之间的系统性偏差直接用作安全信号:冻结的 DINOv2-small 把 224×224 画面编码为 16 个 384 维 token,六层 Transformer 在 T=8 的历史上预测 H=8 的未来隐状态;再用可实现逆动力学目标,以里程计恢复出的真实运动而非下发指令来监督隐空间转移。部署时 CVAE 一次提出 K=8 条动作块,全部在世界模型中想象,由逆动力学估计每条转移的可实现动作,残差超阈值的候选在执行前即被判为不安全并剔除,其余按目标代价择优。在 Habitat Social-HM3D 上取得 63.77% 成功率与 94.37% 个人空间合规率,与人碰撞率降至 21.67%(相对 NavThinker 降低 44.6%),零样本迁移到 Social-MP3D 仍为成功率最高、碰撞率最低,全程只用离线 RGB 轨迹,不需显式行人跟踪、特权人体状态或在线强化学习。
论文元信息
标题:Social-WM: Safety-Aware Latent World Models for Robot Social Navigation
作者:Zhihao Zheng、Mooi Choo Chuah(美国 Lehigh 大学 P.C. Rossin 工程与应用科学学院计算机科学与工程系)
链接:arXiv:2609.40177(v2,cs.RO,2026-10-01)· arXiv HTML 全文 · 许可 CC BY-NC-SA 4.0 · 正文 9 页、5 图、6 表
代码状态:本文未提供公开代码——全文(含脚注与结论)没有仓库链接,按标题与作者检索 GitHub 也没有官方实现。可复现路径依赖三个公开组件:隐空间世界模型骨干 LeWM(arXiv 2603.19312,github.com/lucas-maes/le-wm,项目页 le-wm.github.io,论文表 III 的 MPC 基线即沿用它的规划配置);训练数据与评测协议来自 Falcon 放出的 Social-HM3D / Social-MP3D 划分(arXiv 2409.13244,github.com/Zeying-Gong/Falcon);视觉编码器是冻结的 DINOv2-small(facebookresearch/dinov2)。论文未披露、复现时必须自己定的三处细节:逆动力学权重 $\lambda_{\mathrm{id}}$ 与其余 $\lambda$ 的取值、CVAE 提议头的层数与 KL 权重 $\beta$、以及安全阈值 $\tau$ 的数值及其敏感性。
一句话总结:Social-WM 把「发出的命令」与「真正走得出来的动作」之间的差值当作安全信号——冻结 DINOv2 patch token 构成紧凑隐空间世界模型,用里程计恢复的可实现动作监督逆动力学头,部署时让 CVAE 提议 8 条动作块、在世界模型里想象它们的未来、由逆动力学估出每条的可实现动作,只从残差低于阈值的安全集合里挑目标代价最低的那一条;在 Social-HM3D 上取得 63.77% 成功率与 21.67% 行人碰撞率(相对 NavThinker 降 44.6%),零样本迁移到 Social-MP3D 仍是 54.15%/23.34%,全程不用行人跟踪、不用特权人类状态、不做在线强化学习。
研究背景与动机
在有人环境里跑,机器人要同时满足两件性质完全不同的事:把目标走到,以及不撞上、也不贴着身边行人挤过去。作者把这一难点归到「耦合动力学」上——机器人的运动影响周围的人,而行人与场景几何反过来限定机器人哪些动作是能被安全执行的。更要命的是观测条件:论文设定机器人只有一个前向 RGB 相机,遮挡与有限视场让它天然处于部分可观测状态,场景地图与人类状态都不可直接观测。于是他们沿用 NavThinker 的记号,把底层状态写成
$$s_{t}\triangleq\big(x_{t},\;\mathcal{M},\;\{h_{t}^{(i)}\}_{i=1}^{N}\big) \tag{1}$$其中 $x_{t}$ 是机器人位姿,$\mathcal{M}$ 是静态环境,$h_{t}^{(i)}$ 是第 $i$ 个行人的状态;$\mathcal{M}$ 与所有 $h_{t}^{(i)}$ 都不可观测。机器人每一步拿到的是 RGB 观测 $I_{t}$、自身位姿 $x_{t}$ 和一个目标描述 $g$,输出的是机体系连续动作 $a_{t}=(a_{t}^{\mathrm{fwd}},a_{t}^{\mathrm{lat}},a_{t}^{\mathrm{yaw}})\in\mathbb{R}^{3}$,并在 $H$ 步动作块 $\mathbf{a}_{t:t+H-1}\in\mathbb{R}^{H\times 3}$ 上做规划。
世界模型是获得「先想后做」能力的自然机制。但作者指出,社交导航领域已有的未来推理都停在预测环境这一侧:Falcon 预测行人未来轨迹以做社会化策略学习,NavThinker 把动作条件世界模型与 DD-PPO 策略耦合起来、预测未来场景与交互表征。这些工作证明了未来预测的价值,却留下一个没被充分追问的问题——世界模型能不能顺便回答「这个名义动作在当前物理与社会约束下究竟能不能被执行」。这正是本文的切口。
为此论文显式区分两个动作概念。名义动作 $a_{t}$ 是发出的命令;可实现动作 $\tilde{a}_{t}$ 是与 $x_{t}$ 到 $x_{t+1}$ 的实际位姿变化对齐的那个动作,它把环境里的物理与社会约束都吸收进去了。自由空间里两者一致,$a_{t}\approx\tilde{a}_{t}$;一旦命令与障碍物或身边行人冲突,实际发生的运动就会被约束甚至完全停住,于是 $a_{t}\neq\tilde{a}_{t}$。作者的关键判断是:这个差值不是执行噪声,而是安全相关的信号。这一判断在数据采集层面得到了支撑——训练轨迹是在 Habitat 里用 Falcon 的 Social-HM3D 训练划分收集的,采集时一道 keep-out gate 会拒掉即将进入行人的名义动作,使不安全命令产生「停住」或「受限」的实际运动。这类被阻断的 transition 占全部 transition 的 18.1%,也就是说世界模型在离线数据里就大量见过「命令被现实否决」的后果,而训练时并没有把人类状态或 keep-out 信号本身喂给模型。
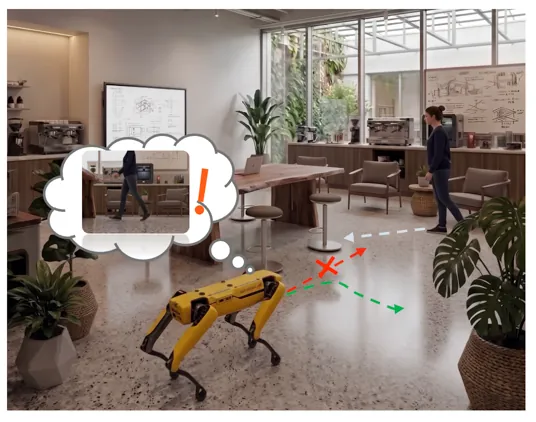
图1:论文动机图。一个在当前观测下看似可行的名义动作,真正执行时可能并不安全;Social-WM 在执行之前就预测它的未来后果与对应的可实现动作,让规划器得以否决不安全候选、改选更稳的那一条。
另一条设计取向是「不重建、不显式建模」。Social-WM 全程在隐空间里预测,不重建 RGB 图像,不估深度,也不显式估计行人轨迹或人类状态。这样做换来两点好处:一是模型小、单步规划快(A5000 上 51 ms),二是学到的动力学与可实现性模型都是目标无关的,同一套世界模型既能服务位置目标导航也能服务图像目标导航——目标只通过任务代价 $c_{\mathrm{task}}$ 进入选择环节。
预备知识
联合嵌入预测式世界模型。Social-WM 建在 LeWM 的紧凑隐空间世界模型设计上:用视觉编码器把观测压成低维隐状态,再在隐状态层面做动作条件的未来预测,而不是像像素级世界模型那样生成图像。LeWM 的训练含一步 teacher-forcing 目标与一个表征正则项;Social-WM 在此之上追加了多步开环目标,理由是规划器要做 $H$ 步 rollout,多步训练能显著压低累积预测误差。论文的骨干选择本身也是一个实验结论:表 VI 的表征消融显示 LeWM 自己的 CLS 与 patch 表征在前向运动维度上的可解码性都是负的,反而是冻结 DINOv2 的空间 patch token 全面更好——所以 Social-WM 保留了 LeWM 的预测器结构,却把编码器换成了冻结的 DINOv2-small。
逆动力学的常规用法与本文的改动。逆动力学模型(ID)预测连接相邻两个状态的动作,长期被用来学习「控制相关」的表征(如 INTACT)。标准写法是把观测到的 transition 与记录下来的动作关联起来。在社交导航里这一步就错了:发出的命令未必等于发生的运动。论文因此把监督目标换成由里程计恢复的可实现动作 $\tilde{a}_{t}$,并在推理时把同一个模型套用到想象出来的 transition 上——命令动作与预测可实现动作之间的差值就成了候选动作的安全分数。这是全文最核心的一处概念改动。
多模态动作生成。规划需要候选。论文用一个轻量条件变分自编码器(CVAE)在给定近期隐状态与动作历史的条件下并行采样出多种局部行为(前进、转向、等待、绕行),而不是像 MPC 那样在动作空间里做优化搜索,也不像扩散策略那样迭代去噪。表 III 显示这三种提议器在成功率、碰撞率与延迟上的取舍,CVAE 拿到综合最优。
方法详解
第一步:视觉表征。冻结的 DINOv2-small 把每帧 RGB 观测 $I_{t}$(输入分辨率 $224\times 224$)编码成空间 patch token。作者丢掉 class token,把 patch 网格自适应池化到 $M$ 个 token,再经一个轻量投影头得到隐表征 $z_{t}\in\mathbb{R}^{M\times D}$。实现里 $M=16$、$D=384$。丢掉 CLS 是有针对性的一步:表 VI 里 DINOv2-CLS 的前向运动可解码性 $R^{2}_{x}=-0.10$、目标排序误差 Err@Min 0.756 m,都是四种表征里最差或次差的,而 DINOv2-Patch 是唯一在所有位姿维度上 $R^{2}$ 为正的表征,Err@Min 降到 0.320 m。也就是说,社交导航需要的是保留了几何信息的空间表征,不是被全局语义稀释过的单一 token。
第二步:动作条件的未来预测。给定隐状态历史与对应的名义动作,一个六层 transformer 预测器 $F_{\phi}$ 预测下一步隐特征:
$$\hat{z}_{t+1}=F_{\phi}\!\left(z_{t-T+1:t},a_{t-T+1:t}\right) \tag{2}$$历史长度 $T=8$。这一式子里最容易被读过去的是它的不对称性:条件项是名义动作,而预测目标 $z_{t+1}=E(I_{t+1})$ 是实际观测到的未来。于是一个被现实否决的命令,配对的不是一个「假设它被完整执行了」的想象未来,而是那个真实的、停住的或受限的未来。安全相关的后果就这样直接写进了动力学,不需要任何额外的碰撞标签或行人状态。训练目标是三项之和:
$$\mathcal{L}_{\mathrm{pred}}=\lambda_{\mathrm{tf}}\mathcal{L}_{\mathrm{tf}}+\lambda_{\mathrm{ol}}\mathcal{L}_{\mathrm{ol}}+\lambda_{\mathrm{sig}}\mathcal{L}_{\mathrm{sig}} \tag{3}$$分别是一步 teacher-forcing 项、多步开环项与表征正则项。作者特别强调多步开环项的作用:规划器要在隐空间里连续 rollout $H=8$ 步,只训一步预测会让误差逐步累积,想象出来的后半段轨迹就失去参考价值。
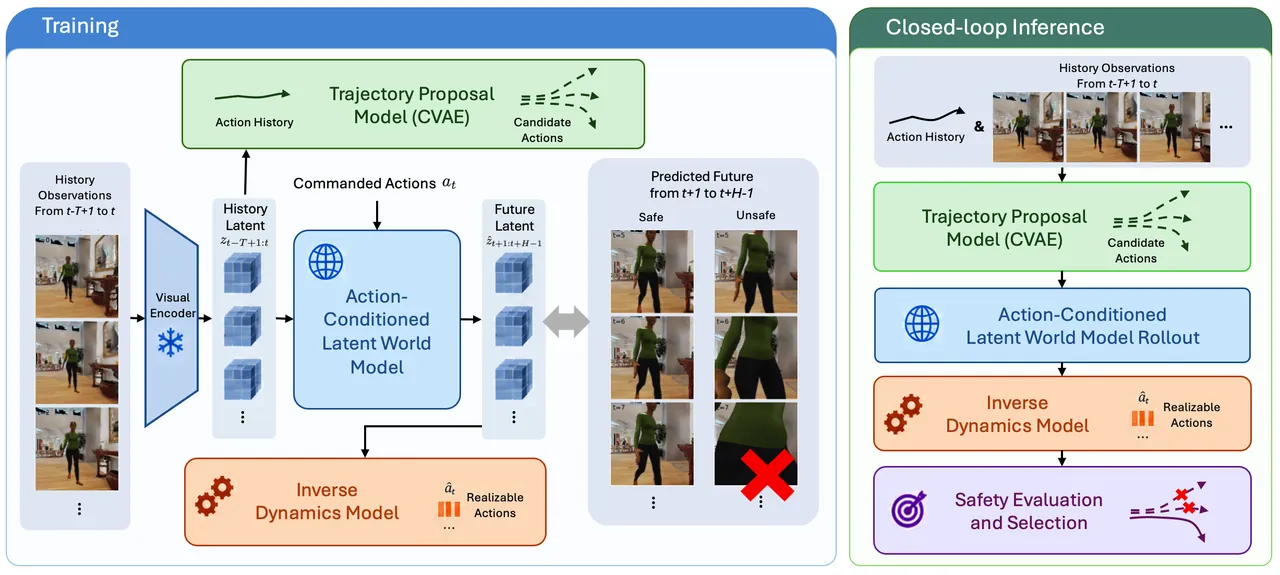
图2:Social-WM 总览。候选动作块由提议器生成,经隐空间世界模型想象;可实现动作逆动力学为每一次想象出的 transition 估计对应运动,使候选的挑选同时依据目标推进与动作可实现性。
第三步:可实现逆动力学。未来预测目标已经让世界模型见过名义动作的真实后果(包括被阻断、被拒绝的 transition),但隐空间预测本身并不显式说明「名义动作里有多少被真正执行了」。作者因此引入可实现逆动力学目标:仿照 INTACT,用一个局部意图 $m_{t}^{\ell}=z_{t+1}-z_{t}$ 与当前隐状态一起预测可实现动作
$$\hat{\tilde{a}}_{t}=I_{\psi}\!\left(z_{t},\,m_{t}^{\ell}\right) \tag{4}$$监督信号则是从相邻机器人位姿里恢复出来的可实现动作,而非示范里记录的命令:
$$\mathcal{L}_{\mathrm{id}}=-\log p_{\psi}\!\left(\tilde{a}_{t}\mid z_{t},\,m_{t}^{\ell}\right) \tag{5}$$这一改动的意义在于:名义动作 $a_{t}$ 本身并不透露它是被完整执行、被约束、还是被彻底拒绝;要求模型预测 $\tilde{a}_{t}$,就等于强迫隐空间 transition 保留与安全有关的那部分场景信息。与预测目标合并后,完整训练目标是
$$\mathcal{L}_{\mathrm{WM}}=\lambda_{\mathrm{tf}}\mathcal{L}_{\mathrm{tf}}+\lambda_{\mathrm{ol}}\mathcal{L}_{\mathrm{ol}}+\lambda_{\mathrm{sig}}\mathcal{L}_{\mathrm{sig}}+\lambda_{\mathrm{id}}\mathcal{L}_{\mathrm{id}} \tag{6}$$同一批导航经验因此被榨出两份互补信息:动作条件世界模型预测名义动作导致的真实未来,逆动力学则把得到的隐空间 transition 与可实现动作绑定。实现细节上,逆动力学头是随机初始化后接在一个预训练 trunk 上,并以 trunk 学习率的十倍训练——这个不对称的学习率设置是论文里少见的、明确写出的工程选择。
第四步:轨迹提议。世界模型只预测后果,不生成动作。作者用一个轻量生成模型 $G_{\theta}$,在近期隐状态与动作历史的条件下产出 $K$ 条看起来合理的 $H$ 步动作块:
$$\mathbf{a}^{(k)}_{t:t+H-1}=G_{\theta}\left(z_{t-T+1:t},a_{t-T+1:t},\epsilon^{(k)}\right),\quad k=1,\ldots,K \tag{7}$$$\epsilon^{(k)}$ 提供随机性,实现里 $K=8$、$H=8$。默认提议器是 CVAE,理由是它紧凑的随机隐变量能并行生成多样的局部行为(前进、转向、等待、绕行)。提议器同样是目标无关的:它的职责只是给出若干合理备选,目标推进与可实现性都留到候选被世界模型想象之后再评。CVAE 用标准的重建加 KL 目标训练:
$$\mathcal{L}_{\mathrm{CVAE}}=\mathbb{E}_{q(u\mid\mathbf{a},c_{t})}\left[\|\mathbf{a}-D_{\theta}(u,c_{t})\|_{1}\right]+\beta D_{\mathrm{KL}}\left(q(u\mid\mathbf{a},c_{t})\|p(u)\right) \tag{8}$$第五步:安全评估与选择。部署时每条候选动作块都被送进冻结的世界模型 rollout,得到想象隐轨迹 $\hat{z}^{(k)}_{t+1:t+H}$;再把逆动力学模型套到每一次想象 transition 上,在执行之前估出它的可实现动作。名义动作与预测可实现动作之间的差异被度量成
$$c_{\mathrm{safe}}^{(k)}=\frac{1}{H}\sum_{\tau=t}^{t+H-1}\left\|a_{\tau}^{(k)}-I_{\psi}\left(\hat{z}_{\tau}^{(k)},\hat{z}_{\tau+1}^{(k)}-\hat{z}_{\tau}^{(k)}\right)\right\| \tag{9}$$残差小说明想象出的未来与名义动作一致;残差大说明这条候选很可能被约束。论文给的直观例子很清楚:如果一条候选命令机器人朝着行人前进,而世界模型预测出的是「停住」的未来,那么逆动力学也会估出停住的动作,$c_{\mathrm{safe}}^{(k)}$ 随之升高。作者把动作可实现性当作可行性硬约束而非软代价,只保留残差低于阈值 $\tau$ 的候选
$$\mathcal{C}^{\mathrm{safe}}_{t}=\left\{\mathbf{a}^{(k)}\mid c_{\mathrm{safe}}^{(k)} < \tau\right\} \tag{10}$$再在这个安全集合里挑目标代价最低的一条:
$$\mathbf{a}^{\star}=\arg\min_{\mathbf{a}^{(k)}\in\mathcal{C}^{\mathrm{safe}}_{t}}c_{\mathrm{task}}^{(k)}(g) \tag{11}$$安全评估本身与目标表示无关,目标只通过 $c_{\mathrm{task}}$ 进入。位置目标场景下,基准给出最终目标位置 $p_{g}$,每条候选做运动学积分后按离目标的最近距离排序:
$$c_{\mathrm{task}}^{(k)}=\min_{\tau}\left\|\hat{x}^{(k)}_{\tau}-p_{g}\right\| \tag{12}$$同一个式子也接受一个中间位置子目标替代最终目标。作者在这里写得很坦白:这个几何代价不考虑人类也不考虑障碍物,所以名义推进很强的候选仍可能被可实现性约束否掉——安全这件事完全由残差门承担,任务代价只管往目标走。图像目标场景下,目标图像 $I_{g}$ 由同一个冻结视觉编码器编码,候选按想象隐状态与目标隐状态的相似度排序:
$$c_{\mathrm{task}}^{(k)}=-\max_{\tau\in\mathcal{T}_{k}}\cos\!\left(z_{\tau}^{(k)},z_{g}\right) \tag{13}$$其中 $\mathcal{T}_{k}$ 是参与比较的 rollout 步集合。论文明确把目标的模态与粒度视为与 Social-WM 正交的维度,并在实验里分开研究。
第六步:闭环执行。选中的动作块 $\mathbf{a}^{\star}$ 只执行第一个动作,随后机器人观测新的 RGB 帧,每一步都重跑完整的「提议—想象—评估—选择」循环。候选生成与隐空间 rollout 并行求值,因此既保住了紧凑 LeWM 骨干的效率,又提供了社交导航所需的多步前瞻。
flowchart TD
  OBS["egocentric RGB I_t at 224x224"] --> ENC["frozen DINOv2-small encoder
drop CLS token, adaptive pool to M=16 tokens
lightweight projector to z_t in R^(16x384)"]
  ENC --> HIST["latent and nominal action history
z_(t-T+1..t) and a_(t-T+1..t), T=8"]
  HIST --> CVAE["CVAE proposer G_theta
K=8 action chunks, each H=8 steps
51 ms per planning step on A5000"]
  CVAE --> IMAG["frozen latent world model F_phi
6-layer transformer, multi-step open-loop rollout
imagined z_hat_(t+1..t+H) for every candidate"]
  IMAG --> ID["realizable inverse dynamics I_psi
local intent m = z_hat_(tau+1) - z_hat_tau
predicts the motion actually achievable"]
  ID --> RES["safety residual c_safe Eq.9
mean L2 norm of nominal minus realizable"]
  RES --> GATE{"c_safe below tau ?"}
  GATE -->|"yes"| SAFE["admissible set C_safe Eq.10"]
  GATE -->|"no"| REJ["candidate rejected before execution
likely blocked by pedestrian or obstacle"]
  SAFE --> COST["goal cost c_task
position Eq.12 min distance to p_g
image Eq.13 max cosine to z_g"]
  COST --> STAR["select a_star = argmin c_task Eq.11"]
  STAR --> EXEC["execute only the first action of a_star"]
  EXEC --> OBS
图A:Social-WM 的闭环规划回路(依据论文 III-C 至 III-F 节绘制)。名义动作只作为世界模型的条件与残差的比较对象,真正决定候选去留的是逆动力学在想象未来上估出的可实现动作;只有第一个动作被执行,下一步重新提议。
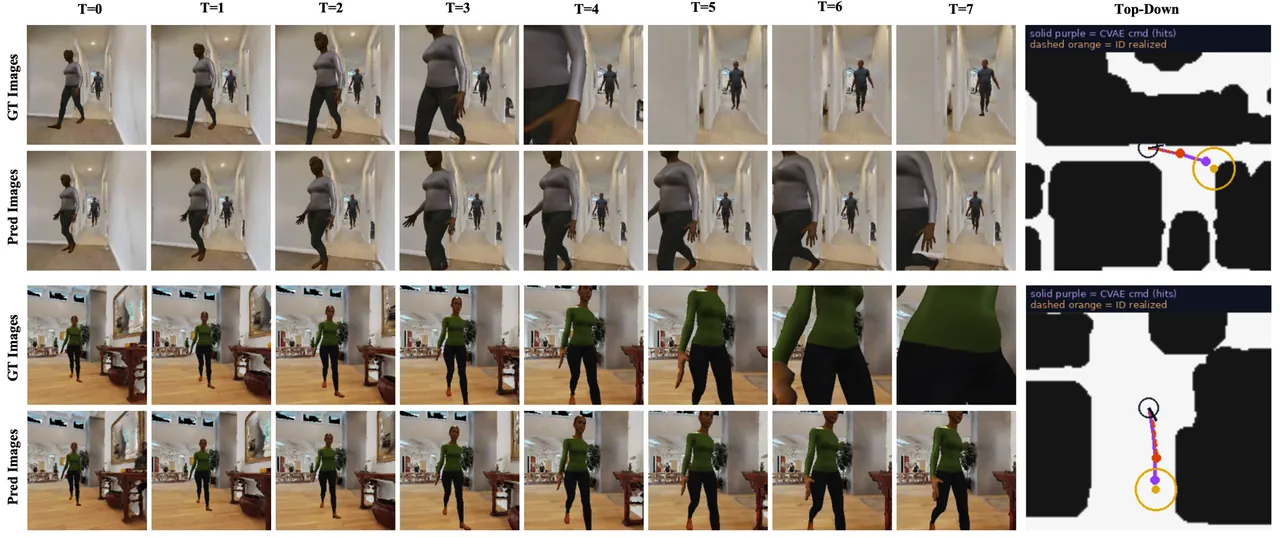
图3:名义未来与可实现未来的定性可视化。每组上排是 CVAE 提议动作块对应的真实观测,下排是 Social-WM 预测的未来;俯视图里紫色实线是提议的名义运动,橙色虚线是逆动力学预测的可实现运动,小黄点为行人位置、大黄圈是其安全区,黑圈标出机器人起点。当名义动作与行人冲突时,模型预测出受限的未来,推断出的可实现运动偏离名义运动,于是在执行之前就暴露了这条不安全候选。(世界模型只在隐空间工作,图中的预测帧是用数据集里最近邻观测反查出来的可视化。)
实验结果
设置。训练轨迹在 Habitat 中用 Falcon 的 Social-HM3D 训练划分采集,覆盖 200 个场景、11676 个 episode、463645 个 transition,其中 18.1% 的 transition 出现被阻断的名义动作。评测沿用 NavThinker 的单机器人协议,指标为成功率 SR、路径长度加权成功率 SPL、个人空间合规率 PSC 与行人碰撞率 H-Coll;另外在不重训、不适配的前提下零样本迁移到 Social-MP3D。模型总参数 58M:LeWM 骨干 18M,替换进来的冻结 DINOv2 编码器 22M,逆动力学头 2.4M,CVAE 5M。所有模块用 AdamW 训练,视觉编码器冻结;单步规划在 NVIDIA A5000 上 CVAE 方案 51 ms,扩散策略 126 ms,LeWM 风格 MPC 139 ms。
| 方法 | HM3D SR↑ | HM3D SPL↑ | HM3D PSC↑ | HM3D H-Coll↓ | MP3D SR↑ | MP3D SPL↑ | MP3D PSC↑ | MP3D H-Coll↓ |
|---|---|---|---|---|---|---|---|---|
| A*(规则) | 44.81 | 43.99 | 90.38 | 54.80 | 45.67 | 44.69 | 91.97 | 54.00 |
| ORCA(规则) | 37.44 | 32.91 | 92.23 | 39.77 | 38.81 | 34.65 | 94.03 | 39.86 |
| Habitat-official(RL) | 38.99 | 33.53 | 90.37 | 55.48 | 37.00 | 31.76 | 92.03 | 52.33 |
| Falcon | 56.26 | 52.05 | 89.76 | 41.22 | 51.67 | 45.54 | 92.53 | 40.67 |
| NavThinker | 59.46 | 55.00 | 89.91 | 39.09 | 47.33 | 41.71 | 93.68 | 37.67 |
| Social-WM(本文) | 63.77 | 49.62 | 94.37 | 21.67 | 54.15 | 44.32 | 93.95 | 23.34 |
表1(对应论文表 I):Social-HM3D 结果与向 Social-MP3D 的零样本迁移。
主结果怎么读。Social-HM3D 上 Social-WM 的 SR(63.77%)与 PSC(94.37%)都是最高的,H-Coll 压到 21.67%,相对 NavThinker 的 39.09% 是 44.6% 的相对下降——这是全文最有说服力的一个数字,因为它说明安全提升不是靠牺牲任务成功换来的,两者同时改善。零样本迁到 Social-MP3D,SR 54.15% 与 H-Coll 23.34% 仍是最优,比 NavThinker 的 47.33% 高 6.82 个百分点,而这套模型在 MP3D 上没有任何重训或适配,说明学到的动力学跨环境有效。需要指出的代价是效率:SPL 49.62% 低于 NavThinker 的 55.00% 与 Falcon 的 52.05%,MP3D 上 44.32% 也略低于 Falcon 的 45.54%。这与方法的机制是自洽的——可实现性门会否掉那些名义推进很快但贴近行人的候选,机器人因此更常减速或等待,路径效率自然受损。论文没有正面讨论这笔取舍,只在局限性里承认剩余失败以超时为主。
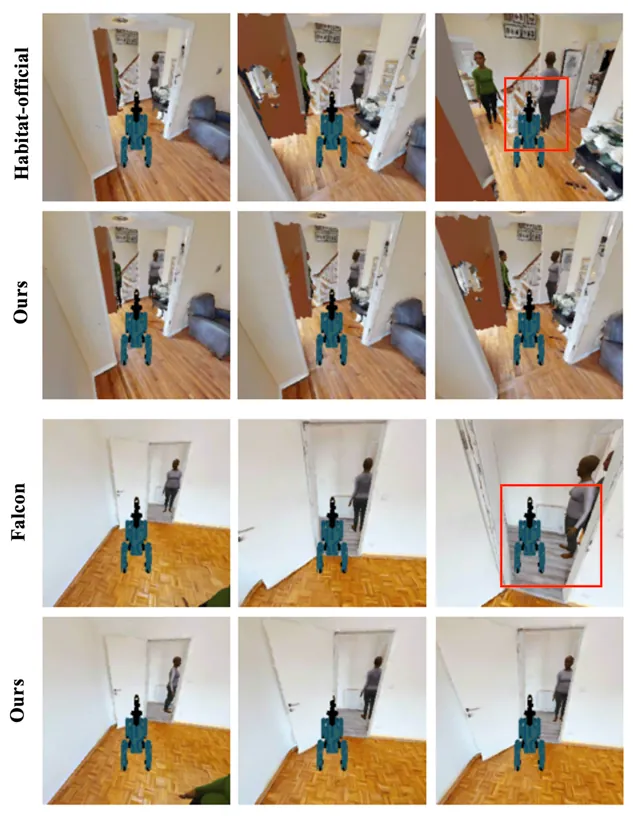
图4:Social-HM3D 上与 Habitat-official、Falcon 的闭环行为对比。红框标出行人间距不足的不安全交互;两个基线继续朝行人占据的区域做目标导向动作,Social-WM 则在预期推进无法安全实现时减速、等待或调整动作。
可实现动作学习到底贡献了多少。表 IV 把这一个问题单独隔离出来,用「图像子目标 + MPC」的组合做公平比较(因为 CVAE 与扩散提议器在世界模型隐空间变化后都需要重训)。三档结果构成一条清晰的因果链:纯隐空间世界模型 SR 51.33%、H-Coll 44.97%;只加逆动力学训练目标($\mathcal{L}_{\mathrm{id}}$)而不在规划里用残差,SR 升到 53.08%、SPL 从 26.49% 升到 30.16%、H-Coll 降到 42.12%;再把名义—可实现差值显式用于安全评估,SR 到 56.08%、H-Coll 到 31.33%。完整版相对纯隐空间基线把行人碰撞率压低 13.64 个百分点。这个分解很有价值:它说明 $\mathcal{L}_{\mathrm{id}}$ 本身就在改善世界模型对「可实现未来」的表征(第一档到第二档的提升),而把它当门控用又带来独立的、更大的一跳(第二档到第三档)——两份收益是互补的,不是同一件事被数了两遍。
| 变体 | $\mathcal{L}_{\mathrm{id}}$ | 安全评估 | SR↑ | SPL↑ | PSC↑ | H-Coll↓ |
|---|---|---|---|---|---|---|
| Latent WM(纯隐空间世界模型) | ✗ | ✗ | 51.33 | 26.49 | 90.26 | 44.97 |
| + 可实现逆动力学 | ✓ | ✗ | 53.08 | 30.16 | 90.34 | 42.12 |
| Social-WM(完整) | ✓ | ✓ | 56.08 | 32.72 | 91.34 | 31.33 |
表2(对应论文表 IV):可实现动作学习的消融,图像子目标 + MPC 设置。
残差真的是安全信号吗。作者没有停在端到端指标上,而是做了一个 transition 级别的诊断:对每个观测到的 transition $(z_{t},z_{t+1})$,用逆动力学预测可实现动作 $\hat{\tilde{a}}_{t}$,按式 9 的方式算残差 $\|a_{t}-\hat{\tilde{a}}_{t}\|_{xy}$,再按名义平移是否因安全约束被阻止给每个 transition 打上 blocked / free 标签。评测规模是 584 个留出 episode 的 22512 个 transition,并额外切出 blocked 比例约 13% 的 Easy 子集与 36.8% 的 Hard 子集(全集为 18.1%)。结果 blocked transition 的平均残差 0.97,free 只有 0.26,整体 AUROC 0.961,且在 Easy(0.988)与 Hard(0.995)上都保持强分离。同样关键的是另一个数字:逆动力学在 free transition 上预测可实现动作的 MAE 只有 0.10,说明它并没有退化成「一律输出小动作」——它保留了对正常运动的刻画能力,否则残差门只会把所有候选一并否掉。
| 子集 | blocked 平均残差 | free 平均残差 | AUROC↑ |
|---|---|---|---|
| 全部(blocked 占 18.1%) | 0.97 | 0.26 | 0.961 |
| Easy(blocked 约 13%) | 0.99 | 0.09 | 0.988 |
| Hard(blocked 36.8%) | 0.99 | 0.10 | 0.995 |
表3(对应论文表 V):名义—可实现残差在 blocked 与 free transition 上的分离度(22512 个 transition,584 个留出 episode)。
| 表征 | $R^{2}_{x}$↑ | $R^{2}_{y}$↑ | $R^{2}_{\mathrm{yaw}}$↑ | Err@Min↓ (m) | Regret↓ (m) |
|---|---|---|---|---|---|
| LeWM-CLS | -0.36 | -0.00 | 0.37 | 0.659 | 0.422 |
| LeWM-Patch | -0.41 | 0.15 | 0.58 | 0.740 | 0.503 |
| DINOv2-CLS | -0.10 | 0.16 | 0.31 | 0.756 | 0.520 |
| DINOv2-Patch(本文采用) | 0.12 | 0.29 | 0.42 | 0.320 | 0.083 |
表4(对应论文表 VI):隐空间表征消融。位姿可解码性用一个轻量回归探针从两帧隐特征预测真实相对运动 $(\Delta x,\Delta y,\Delta\mathrm{yaw})$ 的 $R^{2}$;目标排序用隐空间目标代价挑一帧候选,Err@Min 是它与目标的物理距离,Regret 是它相对几何最近候选多出的物理误差。
表4 是全文里最容易被跳过、但对复现最有用的一张。LeWM-CLS 与 LeWM-Patch 的前向运动 $R^{2}_{x}$ 都是负的,意味着从这些表征里几乎读不出「往前走了多少」;DINOv2-Patch 是唯一在三个位姿维度上 $R^{2}$ 全为正的表征,目标排序误差从 0.659 m 降到 0.320 m、Regret 从 0.422 m 降到 0.083 m。这解释了为什么一个「换了编码器」的改动值得单独做消融:式 12 与式 13 的目标代价都直接定义在隐空间上(一个做运动学积分,一个算余弦相似度),表征里若没有几何信息,排序就是在挑错的候选,安全门再准也救不回来。同时也要看到 $R^{2}$ 的绝对值仍然很低(最高 0.29),说明这套隐空间只是相对更适合排序,远谈不上把位姿解码出来。
| 目标引导 | SR↑ | SPL↑ | PSC↑ | H-Coll↓ |
|---|---|---|---|---|
| 最终图像目标 | 42.91 | 27.07 | 92.11 | 26.26 |
| 图像子目标 | 59.52 | 35.23 | 93.16 | 27.04 |
| 最终位置目标 | 63.77 | 49.62 | 94.37 | 21.67 |
| 位置子目标 | 68.65 | 58.72 | 93.28 | 22.09 |
表5(对应论文表 II):目标模态与引导粒度对 Social-HM3D 结果的影响,世界模型、CVAE 提议器与安全评估保持不变。
目标设定与提议器的取舍。表5 里子目标的收益非常一致:图像目标 SR 从 42.91% 抬到 59.52%(SPL 27.07% → 35.23%),位置目标 SR 从 63.77% 抬到 68.65%(SPL 49.62% → 58.72%)。实现方式是沿参考路径建一个拓扑记忆,每步先定位机器人当前节点、取路径上最近的节点作为即时子目标,位置子目标用它的坐标、图像子目标用它的观测。而 PSC 与 H-Coll 在四档之间几乎没有变化——作者的解读是中间引导主要改善长程路径推进,局部安全则一直由可实现性机制负责,两者互不干涉。这条正交性其实是本文设计的一个有力旁证:换目标模态不需要重训世界模型。位置引导始终优于图像引导,尤其在没有子目标时差距最大(63.77% 对 42.91%),原因是从短时程隐空间 rollout 里直接匹配一张遥远的目标图像太难。
| 提议器 / 规划器 | SR↑ | SPL↑ | PSC↑ | H-Coll↓ | 延迟 (ms)↓ |
|---|---|---|---|---|---|
| MPC(LeWM 配置) | 56.08 | 32.72 | 91.34 | 31.33 | 139 |
| CVAE(默认) | 59.52 | 35.23 | 93.16 | 27.04 | 51 |
| 扩散策略 | 58.84 | 40.15 | 94.08 | 31.49 | 126 |
表6(对应论文表 III):三种轨迹提议器在图像子目标设置下的比较(该设置的规划难度介于直接位置目标与更难的最终图像目标之间),动力学、安全评估与目标设定均固定。
CVAE 拿到综合最优:SR 最高(59.52%)、H-Coll 最低(27.04%),延迟只有 MPC 的约三分之一、扩散策略的约五分之二——论文因此说默认方案分别比扩散与 MPC 快约 $2.5\times$ 与 $3\times$。扩散策略在 SPL(40.15%)与 PSC(94.08%)上更好,但推理成本更高;MPC 既慢又不占优。因为候选生成与隐空间 rollout 都在低维空间里并行完成,58M 参数的模型规模并没有拖慢规划,这一点支撑了「紧凑世界模型 + 多候选并行评估」这条工程路线。
局限性与开放问题
一、剩余失败以超时为主,长程路径选择完全没被这套机制触及(作者自述)。论文承认,虽然行人碰撞率大幅下降,整体成功率却只提升有限,因为剩下的失败很多是超时。当前的世界模型主要推理短时程的安全与动作可实现性,长程路径选择能力与不加这套机制时并无差别。图5 是代表性案例:一个行人持续占据名义路径上的窄通道,Social-WM 成功避开了行人附近的不安全运动,却无法判断这个阻塞会不会持续、也没有去寻找替代路线,最终 episode 超时。作者指出,当局部决策需要一个更长程的绕行时,会出现同类失败。
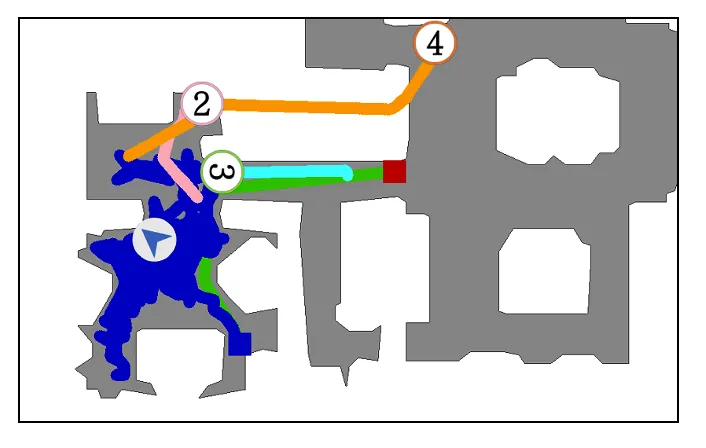
图5:行人持续阻塞导致的超时失败。灰色区域是可通行地面、白色为不可通行空间,绿色曲线是通往红色目标的测地路径,深蓝轨迹是机器人实际走过的路径,彩色轨迹是行人 2–4 的全程运动。一名行人反复占据名义路径上的窄通道,机器人因此始终留在起始房间里——它避免了行人附近的不安全运动,却缺乏判断「要不要改道」的长程推理能力。
二、图像目标在长时程上难用(作者自述)。最终目标图像在其内容还不可见时几乎提供不了引导;而沿路径采样的图像子目标一旦机器人偏离名义路径较多就变得不可靠。表5 的数字印证了这一点:最终图像目标 SR 只有 42.91%,比位置目标低 20.86 个百分点,SPL 更是低到 27.07%。作者据此提出未来方向:把当前的局部安全推理与路径级重规划、空间记忆、自适应子目标选择结合起来。
三、位置目标依赖特权信息,而任务代价对人类视而不见(笔者判断)。表 I 的主结果建立在「基准给出最终目标位置 $p_{g}$」之上,这是一个仿真里才有的特权量;式 12 的代价是纯几何的最近距离,作者自己也写明它不考虑人类与障碍物。这意味着在位置目标设定下,整个方案的安全性 100% 由残差门 $c_{\mathrm{safe}} < \tau$ 承担,任务侧对社交行为没有任何偏好。这一分工解释了 H-Coll 为什么能压这么低,但也说明该方法与「社会化路径规划」(例如主动让出通道、选择人少的路线)是两件事,论文标题里的 social 更多体现在约束满足而非社交礼仪上。
四、关键超参与阈值未披露,且缺少敏感性分析(笔者判断)。式 10 把可实现性当成硬约束,于是 $\tau$ 的取值直接决定安全集合 $\mathcal{C}^{\mathrm{safe}}_{t}$ 的大小:$\tau$ 过小会把候选全部否掉(论文没有说明此时如何回退),过大则等于关掉安全门。表3 显示 free transition 的平均残差是 0.26、blocked 是 0.97,$\tau$ 显然应该落在这个区间里,但论文既没给出实际数值,也没给出 SR/H-Coll 随 $\tau$ 变化的曲线。同样缺失的还有 $\lambda_{\mathrm{id}}$ 与其余权重的取值。对一篇主张「残差即安全信号」的工作来说,这是一处明显的证据缺口。
五、仅仿真验证,且观测是单目部分可观测(笔者判断)。所有结果都在 Habitat 的 Social-HM3D / Social-MP3D 上取得,没有任何真机实验。仿真里的行人由目标驱动、遵循基准行为模型,而 keep-out gate 造成的「命令被否决」现象本身也是仿真采集管线的产物——真实机器人上名义动作与可实现动作的差异来源要复杂得多(轮子打滑、动力学延迟、控制跟踪误差),这些都会被同一个残差混在一起,未必都能被解释成社交约束。此外单前向 RGB 相机意味着背后的行人根本不在观测里,可实现性判断只对视野内的约束有效。
总结与展望
Social-WM 的贡献不是又训了一个更大的世界模型,而是给世界模型加了一个此前没被明确提出的输出:这条命令能不能被真正执行。它的三个组件环环相扣——冻结 DINOv2 patch token 提供了带几何信息的紧凑隐空间(表4),动作条件预测把「命令被现实否决」的后果写进动力学(数据里 18.1% 的 blocked transition 是免费的监督),可实现逆动力学则把这种后果翻译成一个可比较的标量残差(式 9),最终在部署时变成一个执行前的可行性门(式 10、式 11)。表 IV 的消融证明「训练时用它」与「规划时用它」各有独立收益,表3 的 AUROC 0.961 与 free 上 0.10 的 MAE 则证明这个残差确实对应被阻断的执行,而不是模型偷懒输出小动作的结果。
代价同样明确:SPL 低于 NavThinker 与 Falcon,剩余失败被超时主导,长程路径选择没有任何改善。这提示下一步的自然方向就是作者自己点出的那几条——路径级重规划、空间记忆、自适应子目标——以及笔者补充的两条:把 $\tau$ 从固定阈值换成随场景密度自适应的量,以及在真机上把「社交约束导致的不可实现」与「控制跟踪误差导致的不可实现」区分开来。对做社交导航的工程师,本文最可迁移的一点是那个数据采集技巧:用一道 keep-out gate 让不安全命令在离线数据里自然产生受限的实际运动,于是「什么是不可执行」这件事根本不需要人工标注。
金句:机器人发出的命令与它真正走出的那一步之间的差值,本身就是最便宜的安全传感器——Social-WM 只是把这个差值学了出来,并在抬脚之前先读一遍。