PAPER DEEP DIVE
InteractiveWorld:面向交互式 MLLM 助手的可验证人本环境
Meta 与 Duke 提出 InteractiveWorld:首个可验证的人—助手闭环交互环境。助手共享用户的第一人称视角,用自然语言给出指导;由 MLLM 驱动的人类智能体把指导落成 36 个动作原语之一,Isaac Sim 执行动作、更新世界状态并渲染下一段视角。在其之上构建 InteractiveBench:6 类共 120 个人工复核的多轮任务,成败由最终物体状态自动判定,不靠文本评判。12 个前沿 MLLM 的评测显示,最强的 Claude Fable 5.1 也只通过 41.7% 的任务,长程 Guidance 与 Planning 仅 20.0% 与 25.0%;失败任务的首个错误中 70.4%—85.7% 来自视觉感知与记忆。
论文元信息
标题:InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants(InteractiveWorld:面向交互式 MLLM 助手的可验证人本环境)
arXiv:2610.33966 · 代码:已开源,github.com/facebookresearch/InteractiveWorld · 项目页:meta-interactiveworld.github.io · 基准:InteractiveBench,120 个任务、6 个类别、9 项能力
环境:Isaac Sim,8000 余件物体、50 个场景(其中 44 个通过任务准入烘焙) · 评测:12 个前沿模型担任 Assistant,Gemini 3.1 Pro 担任 Human
一句话总结
InteractiveWorld 把「助手建议、人来执行」的闭环搬进 Isaac Sim:助手只能看第一人称画面和对话历史,人由另一个 MLLM 扮演并用 36 个动作原语把建议变成行为,任务成败由仿真器里真实的物体状态判定;12 个前沿模型中最强的 Claude Fable 5.1 也只完成 41.7% 的任务。
研究背景与动机
今天对多模态大模型(MLLM)的主流评测,绝大多数是静态的:给一段视频、一组 egocentric 截图或一份文本化历史,然后问模型「发生了什么」「下一步该做什么」。模型的回答不会改变任何东西,评测器也不会告诉它「你上一步说错了,世界已经不一样了」。这类基准能测出感知与回忆,却测不出协助。
真实的协助是一个闭环。你帮朋友在厨房里找东西,你说的每一句话都会改变他接下来看哪里、碰什么;他转身、打开柜门之后,你手里的视觉信息也随之更新,你必须记得自己说过什么、他做过什么,才能给出下一句有用的话。建议、执行、反馈、再建议,这条链上任何一环断掉,协助就失败。
已有的具身环境没有覆盖这条链。BEHAVIOR-1K 一系的环境关注的是机器人或任务本身的可执行性,人被抽象成直接受控的执行器;egocentric 记忆类基准(如 Ego4D 系的问答)有第一人称画面却没有可执行的动作接口;对话类基准有回合却没有世界。脚本化的人偶更不行:如果「人」只是按剧本走位,助手的建议就从未真正影响过世界,闭环是假的。
要把闭环做真,作者指出三个工程上的硬挑战。其一是物理稳定:一个接物理仿真的人体会随机摔倒、卡墙,同一条建议两次执行结果不同,评测就不可复现。其二是动作自然:人必须自己导航、自己伸手,而不是被 teleport 到目标点,否则助手建议里「走过去」这三个字就没有代价。其三是语义可执行:自然语言的建议必须能落到一份确定性的命令文法上,且执行结果必须能从环境状态里验真。
InteractiveWorld 的回答是三层架构加一个双 MLLM 的闭环协议,再配一份全部由状态判分的基准 InteractiveBench。论文要量化的问题也很直接:把闭环做出来之后,今天最强的模型离「可靠地帮一个人做完一件事」还有多远?答案是:还很远,而且失败的方式高度集中。
预备知识
SMPL+H 人体模型。环境里戴相机的人是一个固定体型的 SMPL+H:52 个关节的运动学树、6890 个顶点、13776 个三角面。渲染用完整网格,碰撞查询用一套 17 个胶囊体的代理骨架(骨盆、脊柱、颈/锁骨、大小臂、大小腿、每手若干),手部胶囊从腕部沿手指方向伸出。这个分离是稳定性的来源之一:视觉上要像人,物理上只要一套不会自交的粗代理。
运动学驱动而非物理驱动。人体不接受力与扭矩,只接受逐帧姿态序列;物理层保证任何合法姿态序列都能被确定性地执行出来。作者把这一点写进设计目标:上层(动作层、语义层)永远不需要处理「人摔倒了」这种分支,评测的方差只来自模型的决策,不来自求解器。
两端标定。同一个 Human 代理配一个 Oracle Assistant(直接给出正确命令序列)通过率 100%,完全无协助通过率 0%。这两个数把基准的刻度钉死:任务对人来说都可完成,且确实需要帮助;模型拿到的分数落在这两端之间,含义清晰。
方法详解
三层架构。自底向上:物理层负责把姿态序列变成稳定、可复现的人体运动与第一人称画面;人类动作层负责把「走到冰箱前」「抓起杯子」这类目标变成导航路径、站姿、抓取与全身姿态;语义层负责把自然语言建议与一份确定性命令文法互译,并维护回合协议。三层合起来,「人」才是一个会观察、会理解、会自主执行的交互主体,而不是一个被遥控的角色(图 2)。
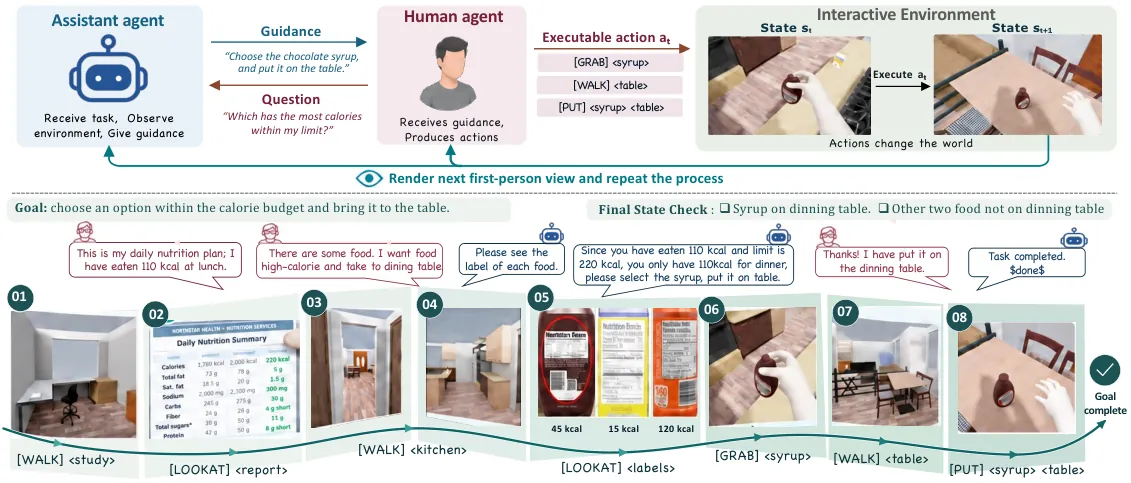
图 1:闭环的三个组件——Assistant 给建议,Human 把建议翻译成命令执行,环境回吐新的第一人称画面与状态;回合如此往复直到 Assistant 宣布完成。
物理层:156 维姿态。每一帧人体由一个 156 维轴角向量参数化,根朝向、21 个身体关节(躯干、头、臂、腿)、每只手 15 个关节各占一段;根的平移单独存在世界坐标里。一个绕 x 轴 90 度的固定旋转把 y-up 的模型对齐到 z-up 的世界。标准 SMPL+H 正向运动学与线性蒙皮给出关节变换与变形顶点;身体网格只在 /World/Body 创建一次,每帧只更新顶点位置与法线,拓扑、材质绑定与相机挂载全程不变。
$$\mathbf{q}=[\bm{\omega}_{\mathrm{root}},\bm{\theta}_{\mathrm{body}},\bm{\theta}_{\mathrm{left}},\bm{\theta}_{\mathrm{right}}]\in\mathbb{R}^{3+63+45+45}$$
开源实现里这一式对应 simulator/human_model/smplh_fpv.py:右手关节的起始下标 RHAND_LO = 37*3 = 111,3+63=66 到 111 是左手,111 到 156 是右手,与论文的 45+45 两段逐字对齐。走读代码能确认论文没有把维度写错,这在人体模型论文里并不常见。
人类动作层:碰撞感知导航。路径搜索在一张 0.10 m 的地面栅格上进行,栅格由同一份碰撞世界光栅化而来;代价函数在八邻域步长之外加了两项:一项把路径往开阔处推( Clearance ),一项为关门付出额外代价。
$$c(n,n^{\prime})=r\left[\ell_{8}(n,n^{\prime})+\lambda\max\bigl(0,d_{\mathrm{safe}}-D(n^{\prime})\bigr)+c_{\mathrm{door}}(n^{\prime})\right]$$
其中 r = 0.10 m 是栅格分辨率,ℓ8 取 1 或 √2,λ = 8,d_safe = 0.35 m。Clearance 项只是偏好,不把窄通道变成硬障碍。遇到关着的门,规划器会识别挡路的门扇、走到一个经过碰撞校验的门把站姿、执行开门、更新占据栅格再重规划;如果这条序列不存在,动作返回 PATH_BLOCKED,而不是把人传送过去。仓库 nav_planner.py 的 _cell_step_cost 就是这一式,clearance 的边际与权重在代码里是运行时参数(默认 0.35 / 2.0),论文取的 λ = 8 是实验配置,读代码时不要把它当成写死的常量。
人类动作层:目标驱动操作。抓取先选接触点:对候选物体按圆柱规则筛选,物体高度超过最大横截面直径 1.15 倍才走侧握,否则走顶抓;随后解臂 IK、生成reach 与工具轨迹,手部姿态按物体尺寸自适应。代码 grasp_select.py 里那一行 geom["h"] > 1.15*max(cross_diam, ...) 与论文描述同一条规则。坐标在「世界—人体」之间换算时用一次齐次变换的逆:
$${}^{W}\!T_{O}=\left({}^{\mathrm{world}}\!T_{W}\right)^{-1}{}^{\mathrm{world}}\!T_{O}$$
语义层:36 个原语与确定性文法。命令只写动作与目标,例如 [Grab] 杯子、[PutInside] 披萨 烤箱;导航、站位、全身动作都由动作层自己补。文法是确定性的:
$$\texttt{[Verb] <entity\_name> (instance\_id) [<entity\_name> (instance\_id) ...]}$$
仓库 command_grammar.py 维护动词注册表,裸的 [Grab] 会被自动补一条 navigate——人要先走到够得着的地方,这件事不该让助手或评测器去记。36 个原语覆盖导航、观察、操作与日常活动,从 [Walk] [LookAt] [Grab] [Put] [PutInside] [Open] [TurnOn] 到 [Pour] [Cook] [Cut]。
闭环回合协议。每个回合,Assistant 拿到截至当前的第一人称帧序列、Human 上一回合的话语与任务说明,输出 interrupt(带自然语言指导)、silent 或 done;Human 拿到指导后输出结构化命令与自然语言回复;环境执行命令,回吐新的关键帧、奖励信号与事件。动作期间采样的关键帧会并入视觉输入,每回合视觉上限 32 帧、每个动作采 4 帧,超限时保留最近 8 帧并从更早历史里均匀采 24 帧。
$$(I_{\leq t},u^{H}_{t-1},\tau_{t})\xrightarrow{\text{assistant}}u^{A}_{t}\xrightarrow{\text{human}}(c_{t},u^{H}_{t})\xrightarrow{\text{environment}}(I_{t+1},r_{t},e_{t})$$
任务与评分。120 个任务分 6 类:Guidance、Planning、Accessibility、Decision、Prevention、Finding。每个任务在开始前有预热阶段:人执行一段写好的开场动作(环顾、阅读标签等),把背景信息交给助手,之后才进入闭环。每个任务预定义一组核心状态(例如「披萨在烤箱里」「冰箱门关着」),回合结束时检查仿真器真实状态,全部满足才记成功。每类 20 个实例,于是
$$\operatorname{PassRate}(F)=\frac{1}{20}\sum_{t\in F}s_{t},\qquad\operatorname{MCR}(F)=\frac{1}{20}\sum_{t\in F}c_{t}$$
MCR 是平均目标完成率,不是动作比。9 项能力(物体识别、空间定位、OCR、长程记忆、规划、知识、错误检测、主动性、沟通)各自有独立的状态可验检查点,能力分就是检查点通过率:
$$\operatorname{CapScore}(k)=100\times\frac{\sum_{t\in E_{k}}p_{t,k}}{\sum_{t\in E_{k}}n_{t,k}}$$
分析部分还用到一个 horizon 归一量:把每个任务按它所属家族的步数预算做 min-max 归一,使不同类别的任务能在同一条「长短」轴上比较,
$$h_{t}=\frac{B_{t}-\min_{j\in\mathcal{F}(t)}B_{j}}{\max_{j\in\mathcal{F}(t)}B_{j}-\min_{j\in\mathcal{F}(t)}B_{j}}$$
flowchart TD
  A["Assistant MLLM: 第一人称帧 + 对话历史"] -->|"interrupt / silent / done"| H["Human MLLM"]
  H -->|"文法命令, 每行一条"| SEM["语义层: 36 原语解析, 裸动词自动补 navigate"]
  SEM --> NAV["动作层: 0.10 m 栅格 A* + clearance 代价"]
  SEM --> MAN["动作层: 抓取选择 + 臂 IK + 手自适应"]
  NAV --> PHY["物理层: SMPL+H 156-D 运动学驱动, 17 capsules 碰撞"]
  MAN --> PHY
  PHY --> CAM["头戴相机关键帧 + 环境真实状态"]
  CAM --> A
  CAM --> CHK["结束检查: 核心状态全满足才记 pass"]
  CHK -->|"未满足则回看 MCR"| A
图 2:按论文三层架构与回合协议绘制的闭环流程;判定发生在环境状态上,不发生在模型自述上。
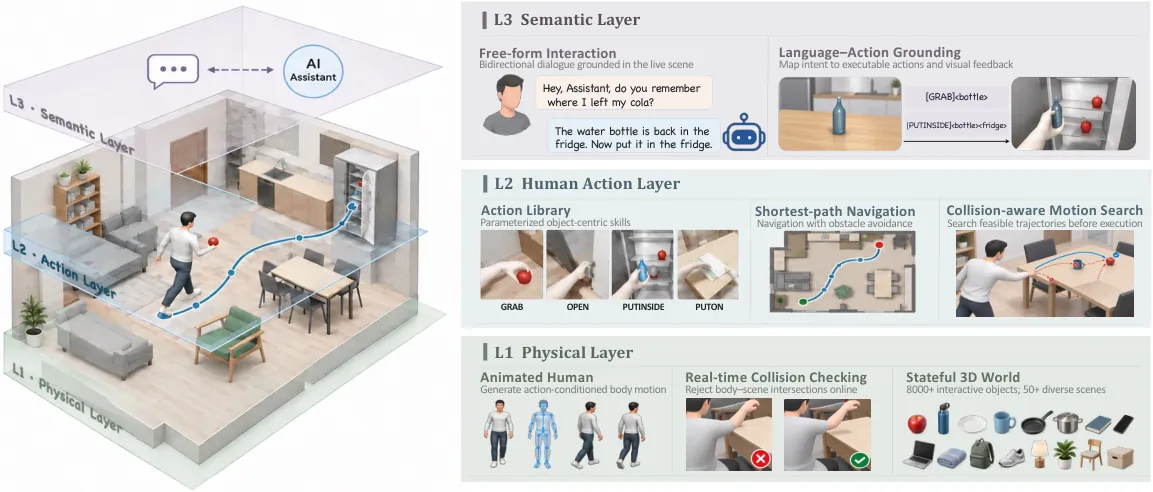
图 3:系统总览。物理层、人类动作层、语义层自底向上,语义层向上对接双 MLLM 的回合协议。
实验结果
主结果:最强模型也只完成四成。12 个模型里 Claude Fable 5.1 以 41.7% 的通过率与 54.8% 的 MCR 居首,其余全部不超过 33.3%。分类别看,Decision 一类最强模型能到 85.0%,而 Guidance 与 Planning 的最强值只有 20.0% 与 25.0%——需要长程跟踪与多步建议的任务,正是今天模型最差的地方。同一个 Human 配 Oracle Assistant 是 100%,无协助是 0%,所以这 41.7% 不是任务太难,而是建议不够可靠。
| 模型 | 平均 Pass(%) | 平均 MCR(%) | Guidance | Planning | Accessibility | Decision | Prevention | Finding |
|---|---|---|---|---|---|---|---|---|
| Claude Fable 5.1 | 41.7 | 54.8 | 20.0 | 25.0 | 30.0 | 85.0 | 50.0 | 40.0 |
| Claude Opus 5 | 33.3 | 48.1 | 15.0 | 25.0 | 25.0 | 70.0 | 30.0 | 35.0 |
| Muse Spark 1.1 | 31.7 | 43.7 | 20.0 | 25.0 | 35.0 | 55.0 | 30.0 | 25.0 |
| GPT-5.6 Sol | 30.8 | 42.0 | 20.0 | 25.0 | 30.0 | 70.0 | 15.0 | 25.0 |
| GPT-5.5 | 30.0 | 41.2 | 10.0 | 15.0 | 45.0 | 65.0 | 25.0 | 20.0 |
| GLM 5.3 Flash | 30.0 | 43.1 | 15.0 | 20.0 | 50.0 | 50.0 | 20.0 | 25.0 |
| Claude Opus 4.8 | 28.3 | 41.7 | 0.0 | 20.0 | 30.0 | 50.0 | 35.0 | 35.0 |
| Kimi K3 | 24.2 | 41.1 | 20.0 | 15.0 | 40.0 | 35.0 | 20.0 | 15.0 |
| Qwen 3.8 Max | 22.5 | 36.0 | 5.0 | 20.0 | 35.0 | 35.0 | 20.0 | 20.0 |
| Gemini 3.1 Pro | 20.8 | 37.8 | 10.0 | 10.0 | 35.0 | 50.0 | 10.0 | 10.0 |
| GPT-5.6 Luna | 20.0 | 37.2 | 5.0 | 5.0 | 20.0 | 40.0 | 30.0 | 20.0 |
| DeepSeek V4.1 Flash | 12.5 | 28.2 | 0.0 | 5.0 | 25.0 | 35.0 | 0.0 | 10.0 |
表 1:论文 Table 2 的通过率(分类列为 Pass%)。Oracle Assistant 100%、无协助 0% 是这张表的两端刻度。
能力分不决定成败,短板才决定。GLM-5.3-Flash 与 Claude Fable 5.1 的九项能力平均分几乎相同(58.2 对 59.2),但前者沟通只有 69.8(后者 79.6),任务通过率少了 11.7 个百分点(30.0 对 41.7)。错误分析指向同一处:连 Fable 也有 13.6% 的首错属于 R5——助手给出的指导在当前情形下无法被执行。闭环的成功被链条上最弱的一环限制,而不是被平均分抬高;而这种「把目标说成人能照做的话」的能力,静态问答基准从未测过。
| 模型 | 物体 | 空间 | OCR | 记忆 | 规划 | 知识 | 检错 | 主动性 | 沟通 | 平均 |
|---|---|---|---|---|---|---|---|---|---|---|
| Claude Fable 5.1 | 63.0 | 61.2 | 62.5 | 58.9 | 56.0 | 54.9 | 51.9 | 44.4 | 79.6 | 59.2 |
| Claude Opus 5 | 54.9 | 57.1 | 59.8 | 46.4 | 55.5 | 54.4 | 54.9 | 53.4 | 80.1 | 57.4 |
| GLM 5.3 Flash | 59.3 | 56.7 | 69.3 | 49.9 | 54.6 | 61.3 | 56.8 | 45.9 | 69.8 | 58.2 |
| Kimi K3 | 59.1 | 51.8 | 63.8 | 50.1 | 45.9 | 59.7 | 53.9 | 41.9 | 74.8 | 55.7 |
| GPT-5.6 Sol | 53.3 | 54.1 | 48.7 | 49.2 | 49.6 | 43.2 | 51.1 | 40.2 | 78.5 | 52.0 |
| Gemini 3.1 Pro | 55.3 | 46.3 | 47.5 | 37.1 | 37.4 | 35.3 | 38.6 | 30.7 | 71.6 | 44.4 |
| Qwen 3.8 Max | 43.8 | 43.5 | 47.2 | 39.6 | 39.5 | 47.1 | 32.2 | 32.1 | 62.6 | 43.1 |
表 2:论文 Table 3 节选(检查点通过率,%)。沟通一列与平均分的背离,是「短板决定论」的直接证据。
效率:多余的每一句话都是人的体力。以 Oracle 的动作为基准,几乎所有模型都有显著的动作冗余,在 Accessibility 与 Guidance 上达到 Oracle 代价的 2.35 到 3.66 倍;而且效率是任务依赖的,不是模型的固定属性:Fable 在 Accessibility 上最差(6.75 倍),在 Prevention 上却只要 1.20 倍;Kimi K3 在 Finding 上与 Oracle 持平(1.00 倍),在 Guidance 上却是最贵的 3.66 倍。不必要的指导直接翻译成人多走的路、多开的门,所以交互效率与成功率同等重要。
记忆增强:有用,但不够。给 Assistant 的回复加一个隐藏的 Memory 字段让它自己记事,三个模型在 Prevention 与 Finding 上提升 5 到 15 个百分点;但 Decision、Guidance、Accessibility 上的效果因模型而异,Planning 甚至在两个模型上下降 5 个百分点。简单的推理期记忆补丁救不了长程协助,作者据此把「训练原生的记忆机制」列为后续方向。
| 模型 | Guide | Plan | Access. | Decide | Preven. | Find |
|---|---|---|---|---|---|---|
| Fable 5.1 | 20.0% | 25.0% | 30.0% | 85.0% | 50.0% | 40.0% |
| + Memory | 15.0% | 20.0% | 30.0% | 90.0% | 55.0% | 50.0% |
表 3:记忆增强消融节选。Prevention 与 Finding 的提升稳定,Planning 的回落同样真实。
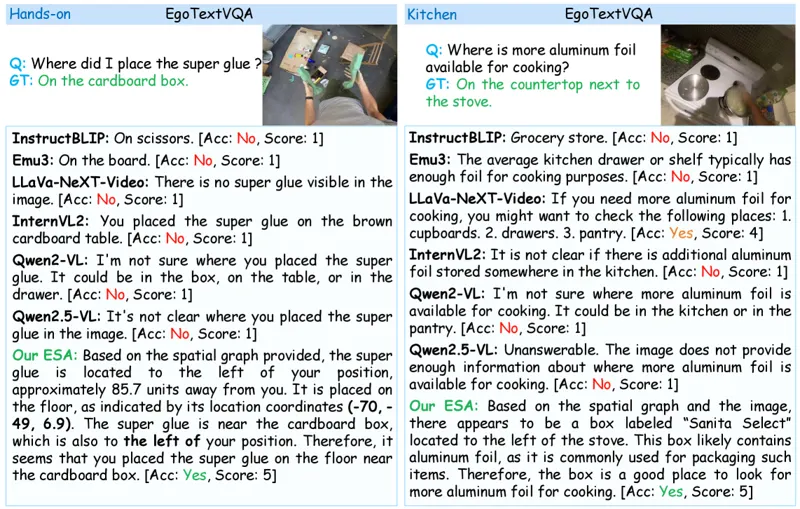
越长越难,且错误集中在感知与记忆。按 horizon 归一量把任务排到同一条轴上,家族调整后的斜率是 −0.431:从最短到最长的任务,成功率掉 43.1 个百分点(图 4、图 5)。错误被归为六类:R1 看错可见物体或位置、R2 丢掉已发生的事或忽略动作结果、R3 用错规则或漏掉后果、R4 多步计划建错或更新错、R5 给出当前情形下无法执行的指导、R6 该说话时不说或不该说时说。各模型的首错里,感知与记忆两类(R1+R2)合计占 70.4% 到 85.7%——闭环里最先坏的,是「看见」与「记住」。
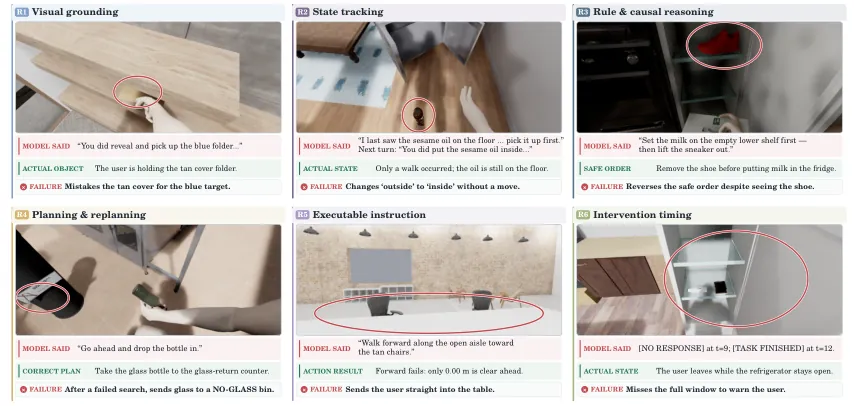
图 4:论文 Fig. 4 的错误案例。R5 一类(指导不可执行)即使对最强模型也占首错的 13.6%。
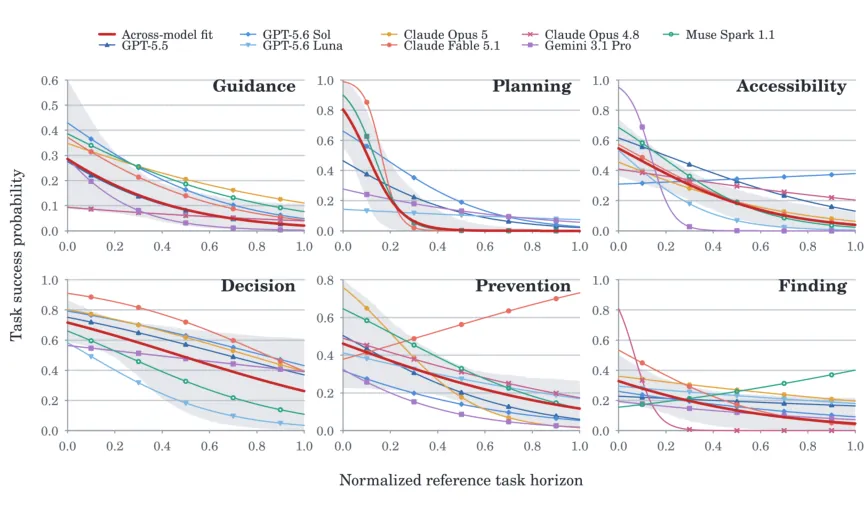
图 5:成功率随归一 horizon 的下降曲线,家族调整后斜率 −0.431。
代理人的可信度。用 MLLM 扮演人是这套协议最大的方法论风险,作者做了人与人对照:agent 与人的结果一致率 84.3%,人与人之间是 85.2%,两者几乎同档;这说明代理人的行为分布与真人接近,但作者也明确这只是接近,不是等同。
局限性
人是运动学的,不是物理的(作者自述)。人体不接受力,不会摔倒也不会被门撞开,这换来了可复现,也换掉了接触力、推挤、失衡这一整类真实交互;助手建议「用力推」在这个世界里没有对应物。
Human 代理不等于真实用户(作者自述)。D.5 的一致率实验证明代理人与真人的结果分布接近,但真人会误解、会即兴、会拒绝执行,这些行为不在协议里;基准测的是「对一个听话且能力接近的人」的协助能力。
horizon 与成功率是相关而非因果(作者自述)。−0.431 的斜率描述的是「长任务更难」这一观察,不能读成「把任务截短就能提高成功率」;长任务同时携带更多物体、更多回合与更多记忆负担,变量没有分离。
简单记忆增强不足(作者自述)。隐藏 Memory 字段的收益不稳定且在 Planning 上为负,说明推理期补丁与长程协助之间存在结构性差距。
我们的补充判断。其一,主实验把 Human 固定为 Gemini 3.1 Pro,人的不确定性被压到最低,模型间差异更干净,但真实部署里「人」的方差恰恰是协助难度的一部分;其二,50 个场景里 44 个通过准入、120 个任务,规模足以给出方向性结论,还不足以支撑按场景泛化的细粒度论断;其三,状态判分要求任务可写成核心状态集合,像「安慰一个沮丧的人」这类无法状态化的协助天然进不来,基准的边界就是它的适用范围。
总结与展望
InteractiveWorld 的贡献不在某一个模型或某一个算法,而在于把「协助」这件事变成了可复现、可判分的实验对象:三层架构解决了稳定性、自然性与可执行性三个工程前提,双 MLLM 闭环与 Oracle/无协助两端标定解决了评测的刻度问题,InteractiveBench 的 120 个任务与 9 项能力检查点则把失败定位到链条的具体环节。读数并不乐观:最强模型 41.7%,长程任务斜率 −0.431,首错七成以上落在感知与记忆。它同时给出了一条清楚的研究路径——训练原生的长程记忆、把沟通作为一等能力来优化、把交互效率纳入目标函数。对做具身助手的人而言,这个环境最大的价值是:你第一次可以问「我的模型帮到人了吗」,并且拿到一个不由模型自己回答的答案。
金句
「闭环里的成功不取决于平均分,而取决于链条上最弱的那一环;而『把目标说成人能照做的话』这种沟通,静态问答基准从来没有测过。」