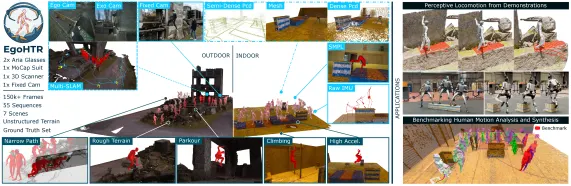
首个野外粗糙地形4D人-场景运动数据集,使用 Project Aria 眼镜+Rokoko 动捕服+Leica BLK2GO 3D扫描仪多传感器设置,重建精确 SMPL 身体序列和高分辨率3D场景,MPJPE 73.2mm 达竞争力精度。
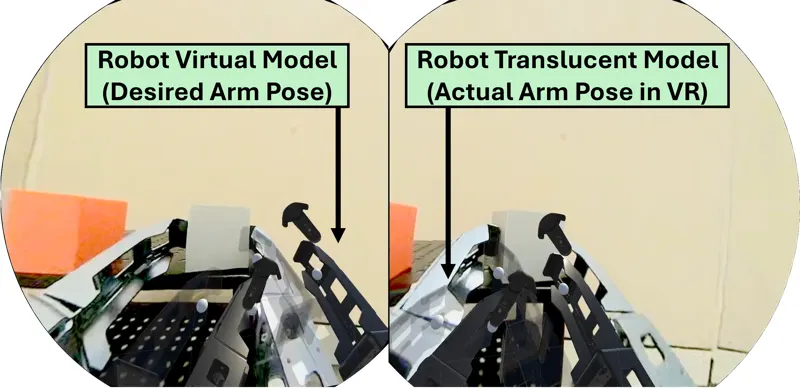
VR+RL 驱动小型人形机器人的遥操作移动操作,含步态控制和操作协调模块,探索小型平台的 loco-manipulation 能力。
在并发师生框架中引入世界模型(深度残差网络预测未来地形状态)和动量目标编码器(BYOL 式 EMA),通过预测损失强制教师编码器学习时空感知表示,为 student 提供稳定蒸馏目标,解决连续楼梯平滑运动问题。
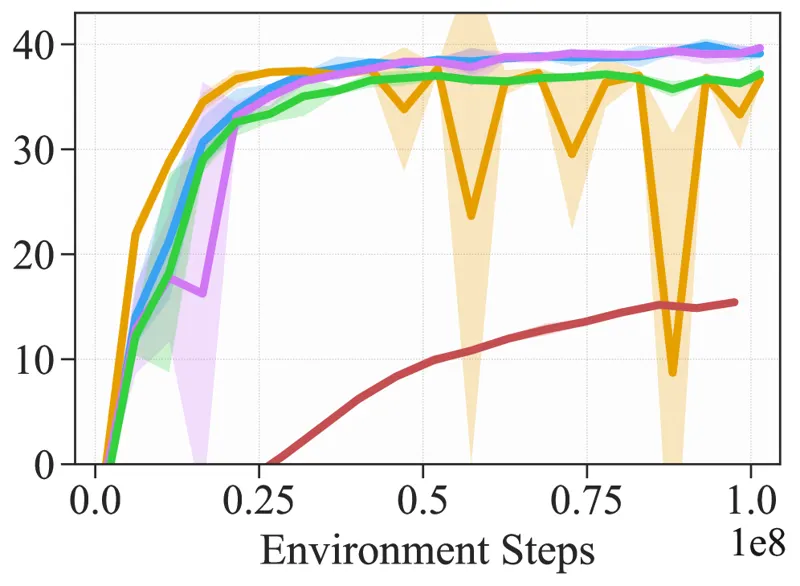
对目标动作施加均值中心 tanh 截断映射,仅用于 Bellman 备份中目标 Q 值计算,用变量替换推导一致熵项——减少极端目标动作方差放大,在 MuJoCo Playground 和 HumanoidBench 上实现更快更可靠的离策略 RL 训练。
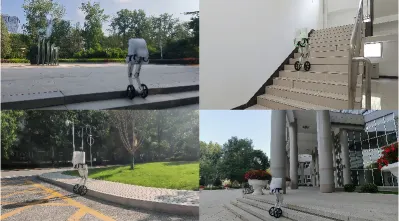
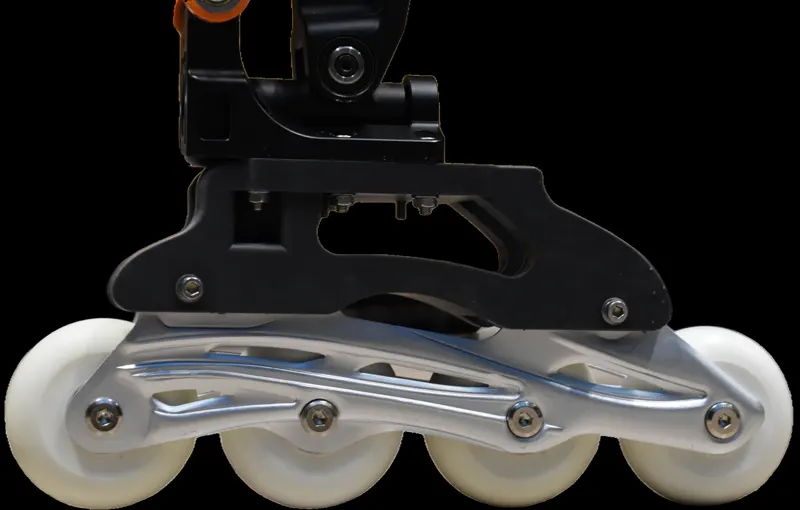
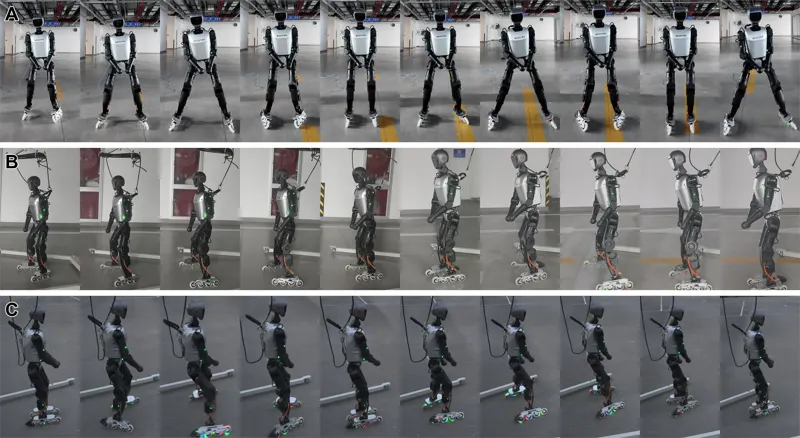
将强化学习与人形机器人结合,解决被动轮滑的欠驱动复杂力学问题,实现动态轮滑步态的新形态。
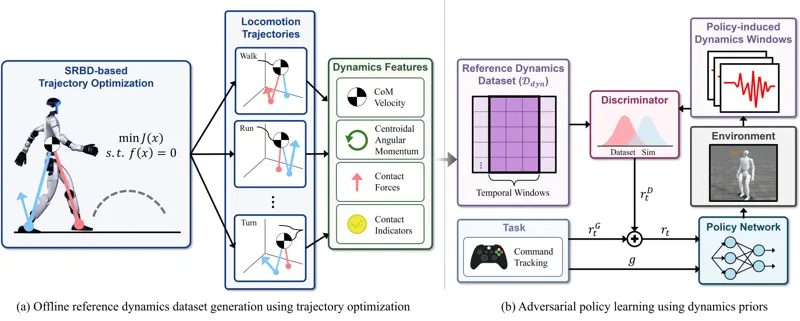
用轨迹优化生成参考动力学特征(质心运动、动量、触地力),通过对抗判别器正则化策略生成的动力学窗口而非模仿关节级运动学,实现对外部扰动更强韧的人形运动恢复。相比 AMP 成功率提升 18 个百分点。
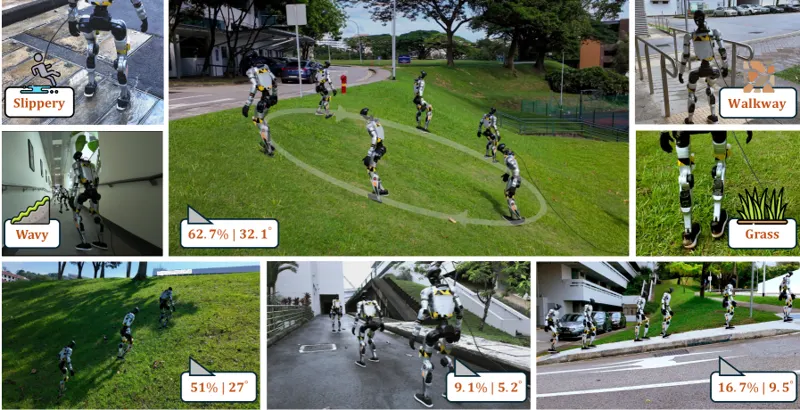
两阶段框架:Stage I 用坡面自适应 ZMP 正则化建立平衡先验,Stage II 用生物力学步态适配器(BSGA)根据地形描述符调节质心高度和下肢协调——上坡髋驱动、下坡膝制动。盲感知在 Unitree G1 上实现 36° 陡坡行走。
用 AMP-PPO 框架和切片圆柱体轮仿真模型,让人形机器人学会 Pump Glide(足部开合产生动力)和 Push Glide(交替支撑推进)两种被动轮滑步态,在 Booster T1 上实现仿真和真实机器人持续轮滑。
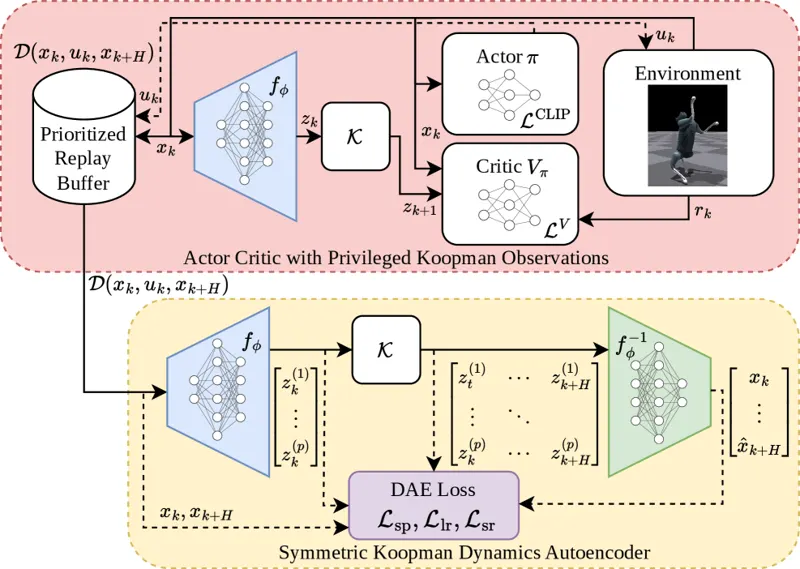
将形态对称性(C2反射)与 Koopman 动力学自编码器结合,在 actor-critic RL 中为 critic 提供线性化动力学预测作为特权观测,显著提升样本效率和跨对称任务泛化能力。在 Cyberdog2 双足任务上验证。
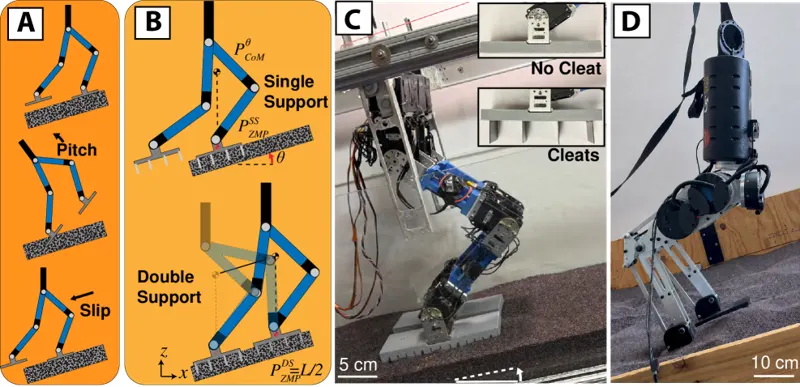
在松软颗粒斜坡上,通过设计足部防滑钉的间距和深度来主动改造地形——将局部颗粒应力维持在屈服阈值附近——从身体中心转向肢体中心范式,让 BLUEY 和 HECTOR 在 20°-30° 颗粒斜坡上稳定行走。
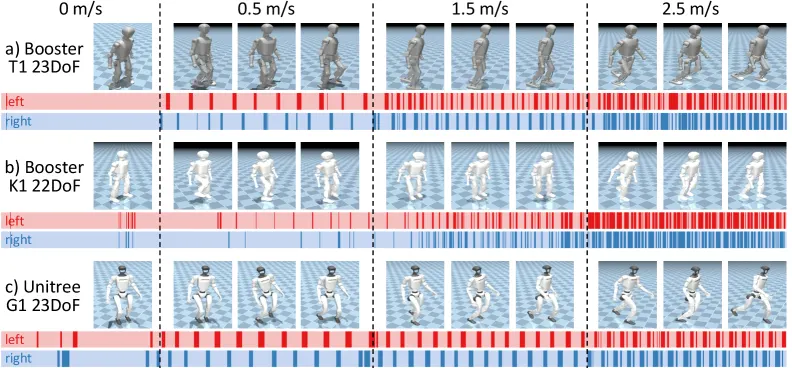
将预训练行走策略当作种子技能,通过 GaitWave 节奏生成、H-SLIP 步态动态塑形和残差适应三个模块,让一个策略连续覆盖行走→慢跑→跑步,在五种人形形态上实现零样本迁移。
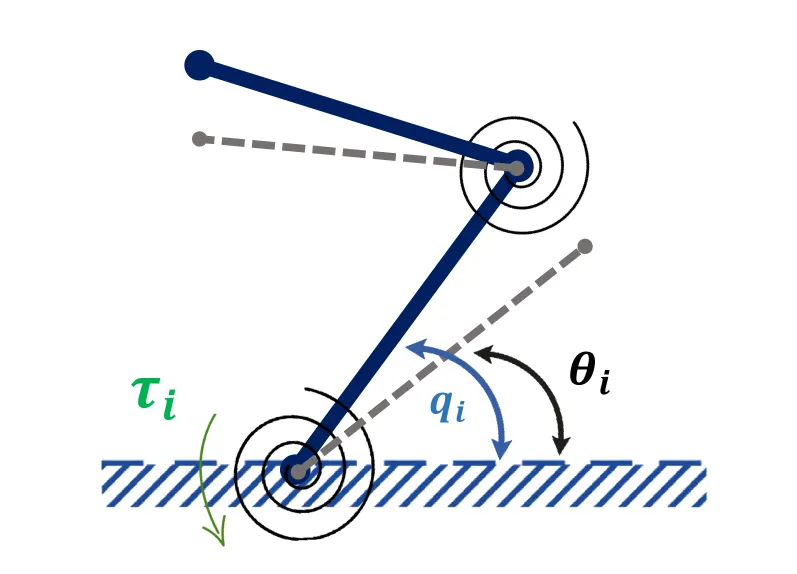
提出结合比例-阻尼(P+d)控制器与TD3深度强化学习agent的混合控制方法,在关节柔性与时变通信时延下实时调节远端增益,降低振动并提升跟踪性能,基于Lyapunov-Krasovskii分析保证有界时延下的稳定性。