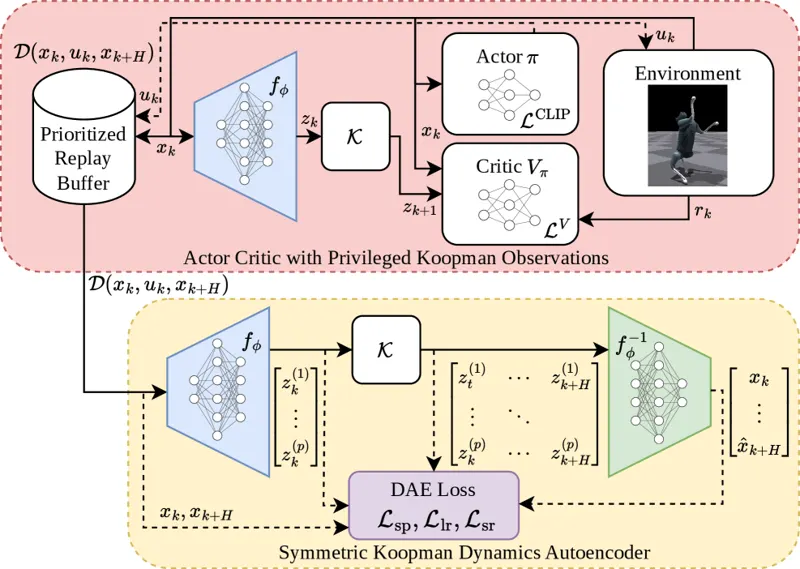
将形态对称性(C2反射)与 Koopman 动力学自编码器结合,在 actor-critic RL 中为 critic 提供线性化动力学预测作为特权观测,显著提升样本效率和跨对称任务泛化能力。在 Cyberdog2 双足任务上验证。
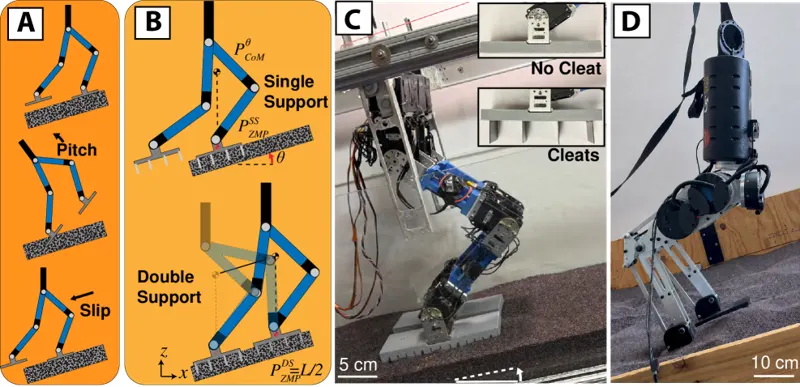
在松软颗粒斜坡上,通过设计足部防滑钉的间距和深度来主动改造地形——将局部颗粒应力维持在屈服阈值附近——从身体中心转向肢体中心范式,让 BLUEY 和 HECTOR 在 20°-30° 颗粒斜坡上稳定行走。
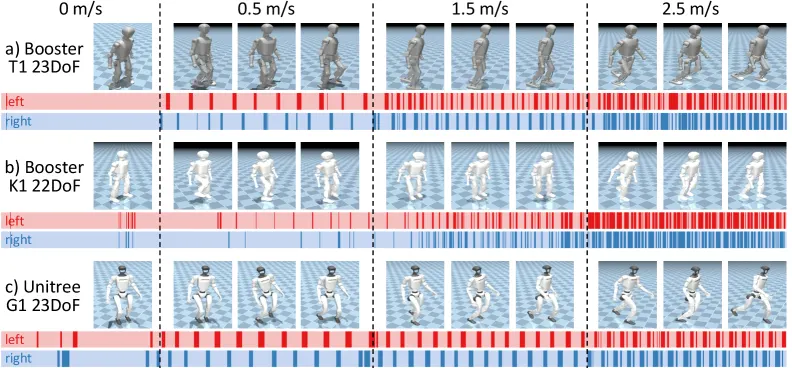
将预训练行走策略当作种子技能,通过 GaitWave 节奏生成、H-SLIP 步态动态塑形和残差适应三个模块,让一个策略连续覆盖行走→慢跑→跑步,在五种人形形态上实现零样本迁移。
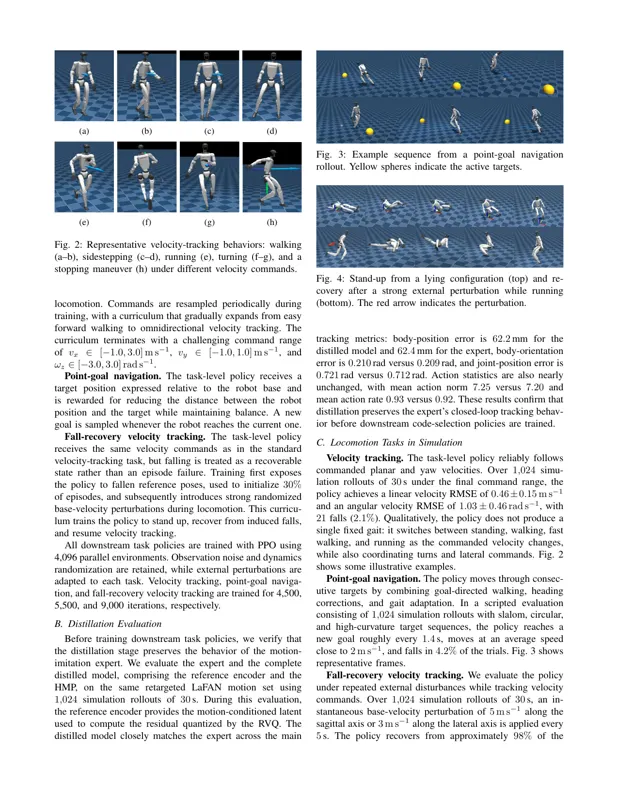
从运动模仿中学习可复用的混合运动先验,让 RL 策略能跨步态任务迁移而非每次从零训练,提升人形运动控制的样本效率和泛化能力。
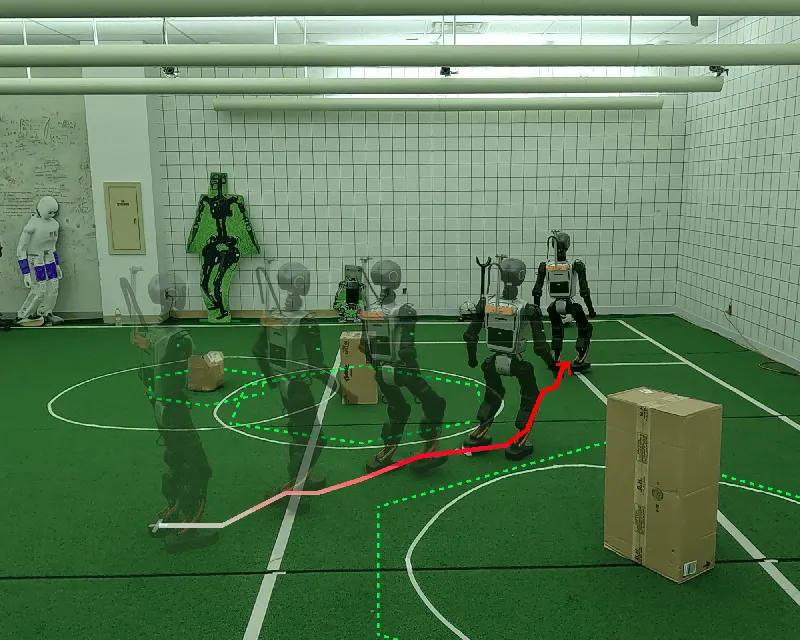
用可见图做长时程路径规划,结合无碰撞 MPC 处理短时动态和安全约束,实现动态环境中的鲁棒人形导航步态控制。