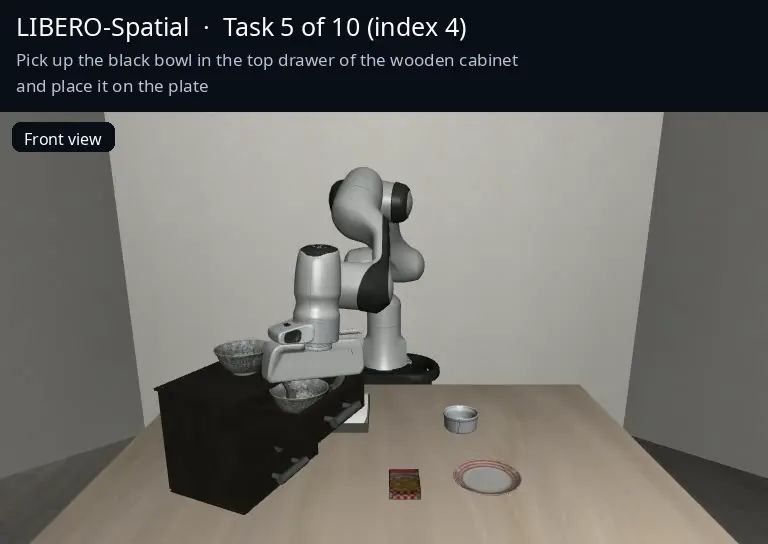
提出WorldDiT,统一扩散架构同时建模世界与动作,在世界模型与动作生成上取得平衡,服务于具身智能。
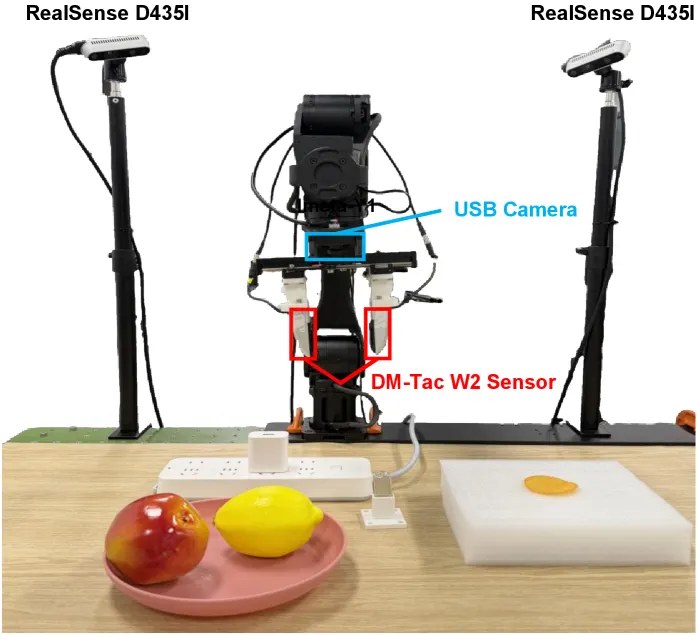
提出FeelWorld视触觉世界模型,实现分层接触预测与规划,服务于contact-rich操作的视触觉感知。
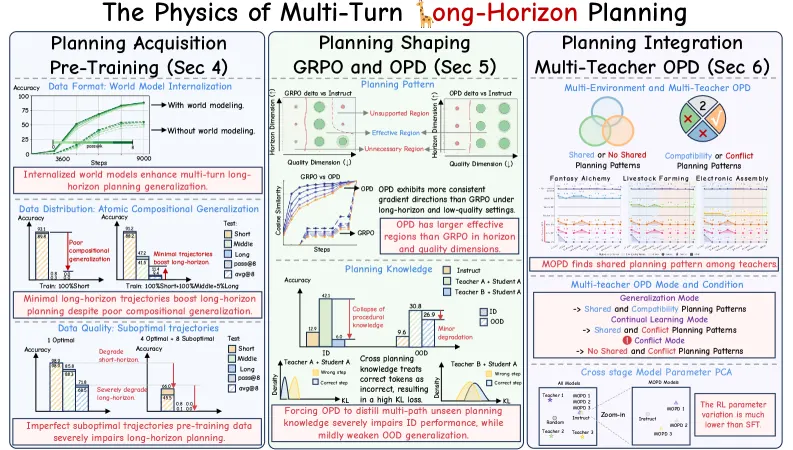
研究多回合长时程规划的物理,从预训练到后训练全流程,服务于世界模型与agent的长时程规划。
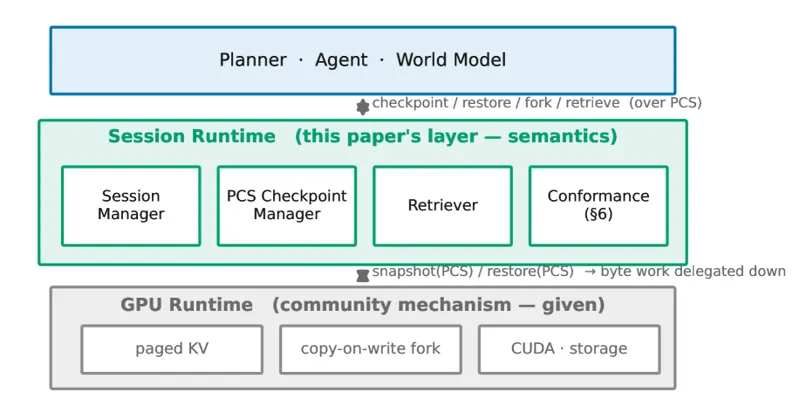
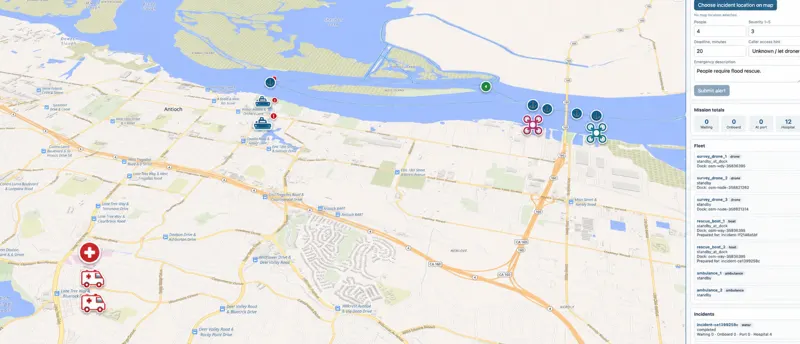
生成式世界模型日益作为模拟器使用,本文提出以会话为中心的持久计算状态运行时。
TRACE-RealWorld 解决世界模型作为物化视图的数据管理一致性问题,提供可审计契约。
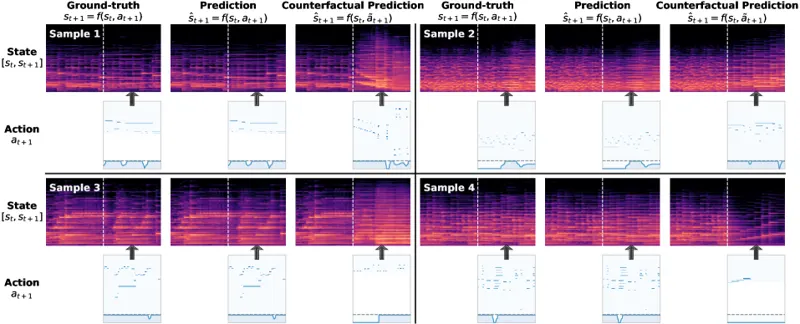
联合嵌入预测架构(JEPA)近期兴起,本文将其扩展为从动作学习声音的世界模型。
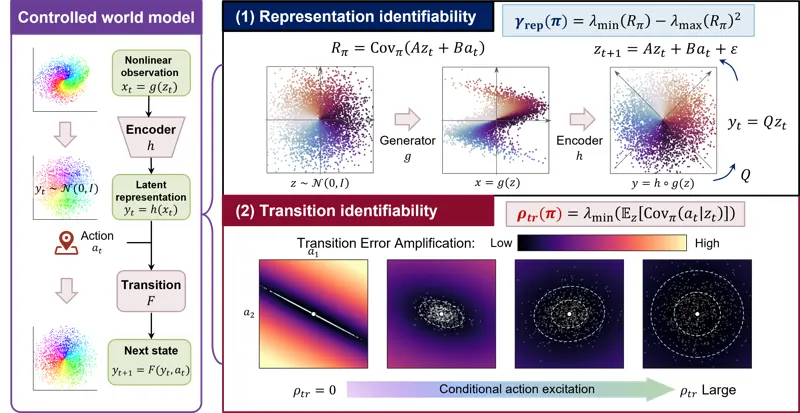
研究从人类交互中推断环境动力学的世界模型的可辨识性问题。
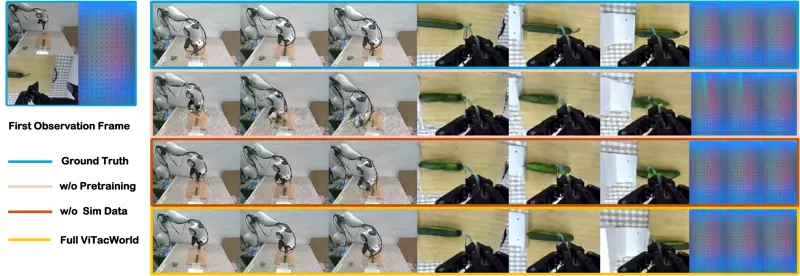
接触密集型机器人操作需要物理交互,ViTacWorld 扩展视触觉世界模型以支持此类操作。
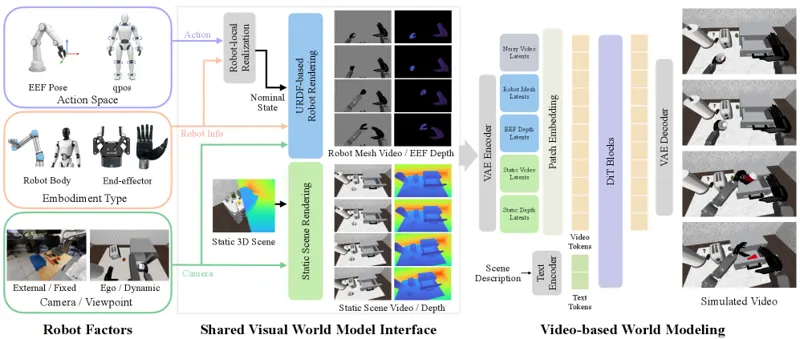
动作条件视频世界模型预测未来观测,本文提出通过机器人渲染构建机器人分解的世界模型。
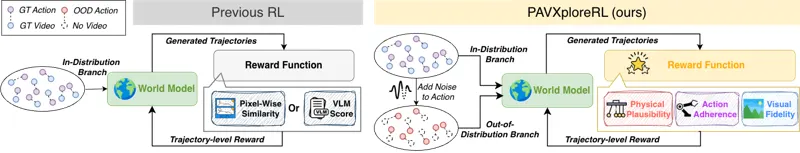
PAVXploreRL提出物理-动作-视觉世界模型强化学习方法,通过动作探索实现具身智能体的环境理解和策略优化。
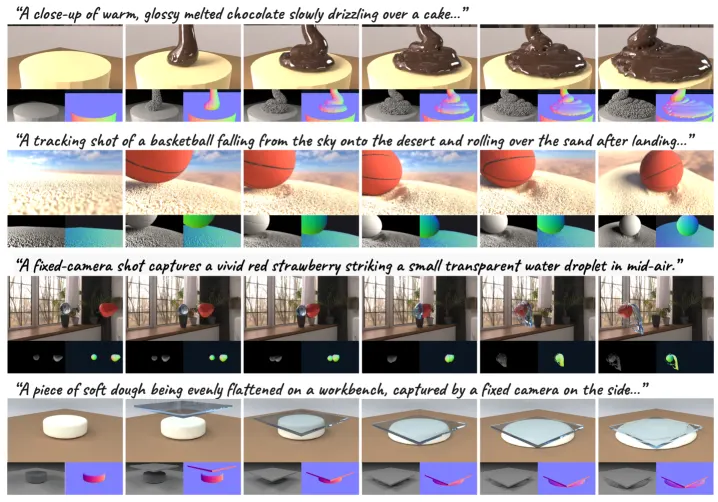
从自然语言描述创建动态且物理真实的4D世界既迷人又具挑战性。GS-Agent利用生成式仿真技术,结合3D高斯泼溅创建物理一致的4D动态世界。
仿真与现实的差距仍是部署仿真训练机器人策略的根本挑战。World Translation通过反向动力学提取和无配对域翻译学习真实世界转移动力学,最小化sim-to-real差距。