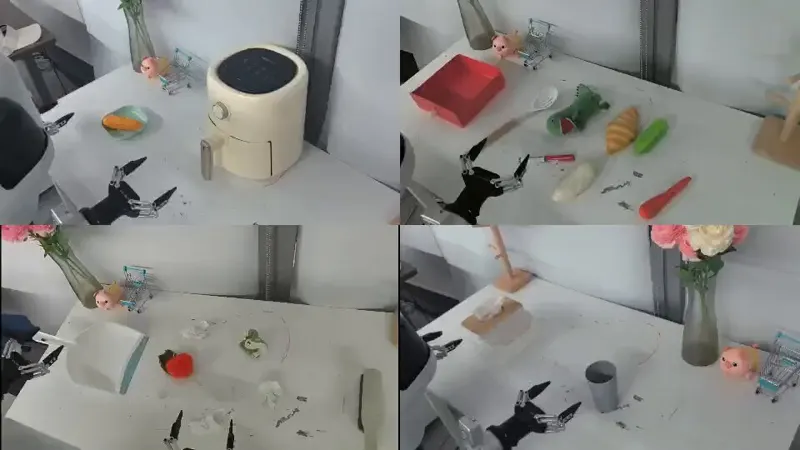
对比世界动作模型的视觉表征与融合机制:通用表征提升鲁棒性,通道级联合预测最优;R²-WAM 成功率达 84.7% 与 92.8%。
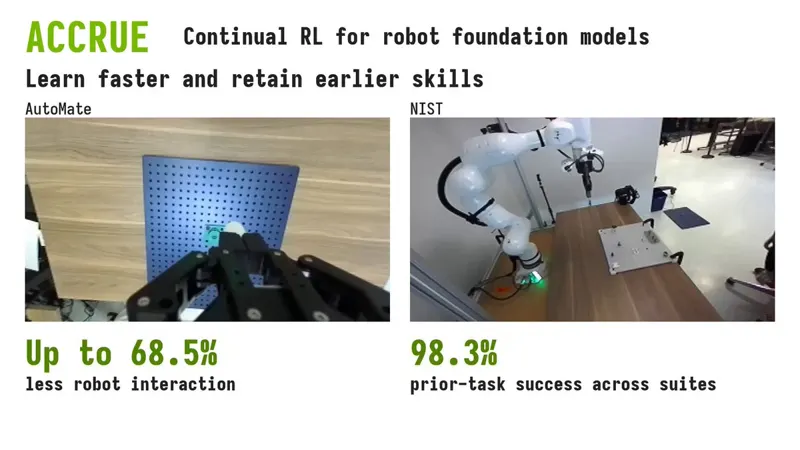
ACCRUE 冻结基础模型、只训小 actor-critic,跨任务继承并蒸馏旧技能;真机后续任务 4-12 分钟达 95% 成功,旧任务成功率 98.3%。
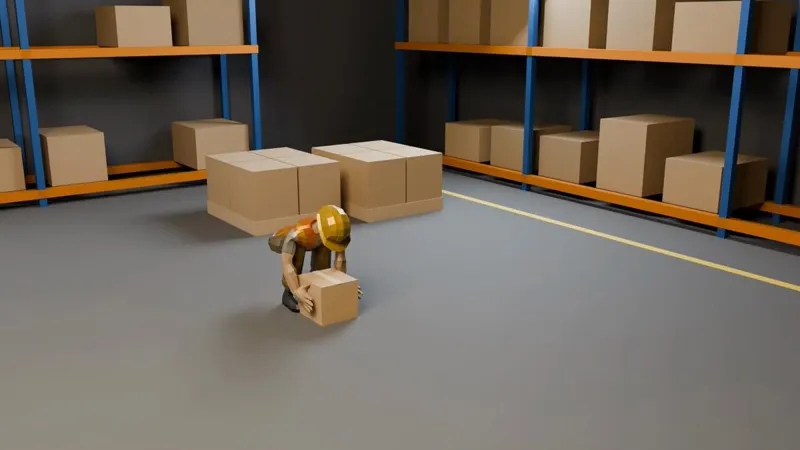
用 MuJoCo 让 Unitree G1 演示 ZMP 论文:6kg 载荷时零力矩点滑向脚尖、机器人后仰收回;16kg 时越过脚趾边缘,脚底再无力可撑。
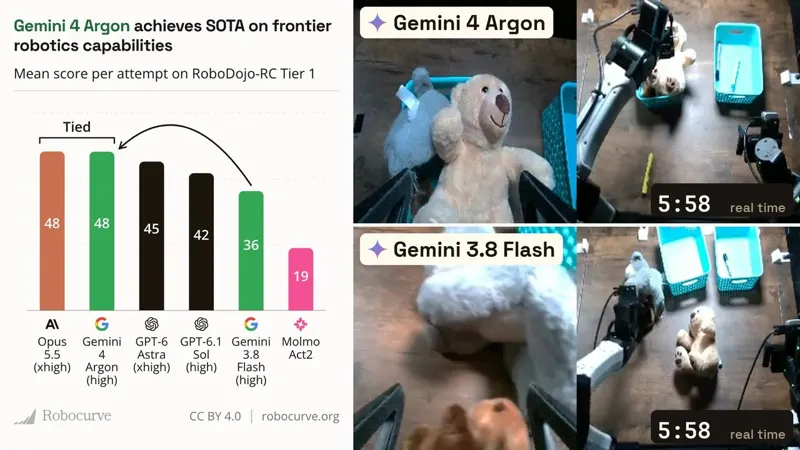
Argon 与 Opus 5.5 真机操作榜同以 48 分并列第一,高于 GPT-6 Astra;视频对比两代模型实时表现。
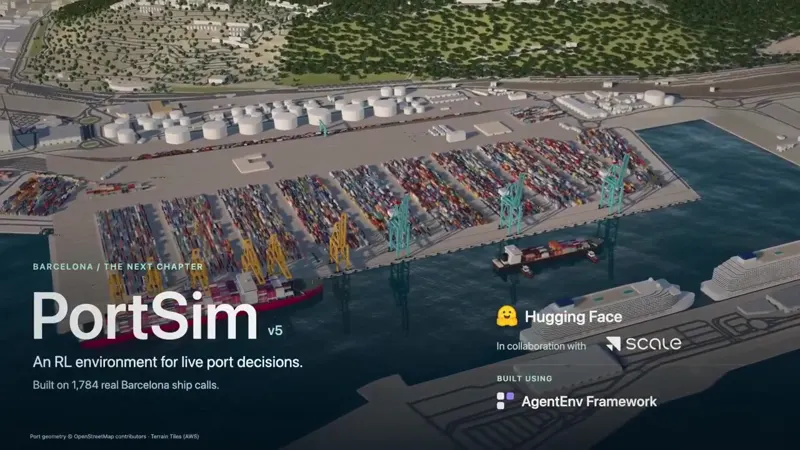
基于2024年巴塞罗那港1784次船期记录的确定性RL环境:智能体重排一周内各船的到港时间、泊位与岸桥分配,由Scale AI AgentEnv框架构建。
NVIDIA 实证研究 GPT-6 Astra 原生机器人策略:RoboLab-120 上 Agentic 配置 74.8% 登顶,但每次推理 18.56 秒、每成功回合 3090 万 token。
TacitVLA 让动作专家从不关注本次生成的推理文本:训练阶段仍用推理监督塑造骨干表征,部署阶段把记忆台账的生成挪进动作执行窗口。四个基准上与显式推理精度相当而单次调用延迟最多降 3.4 倍,RoboMME 计数 82.7%、RMBench 77.5% 均超过已发表最好成绩。
Jack Lu, Yurong You, Boyi Li
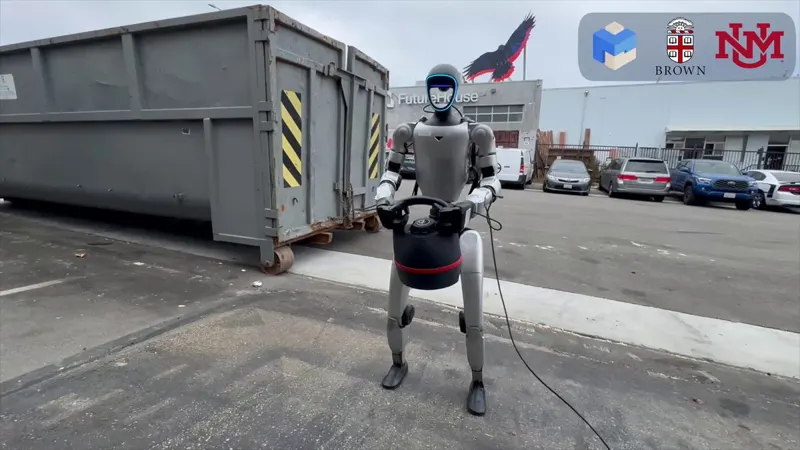
BRACE 把地形与手部力指令折进参考轨迹,双教师蒸馏成只靠本体感觉的流匹配策略;G1 真机负重爬坡,20N 负载跟踪误差 283mm 对基线 470mm。
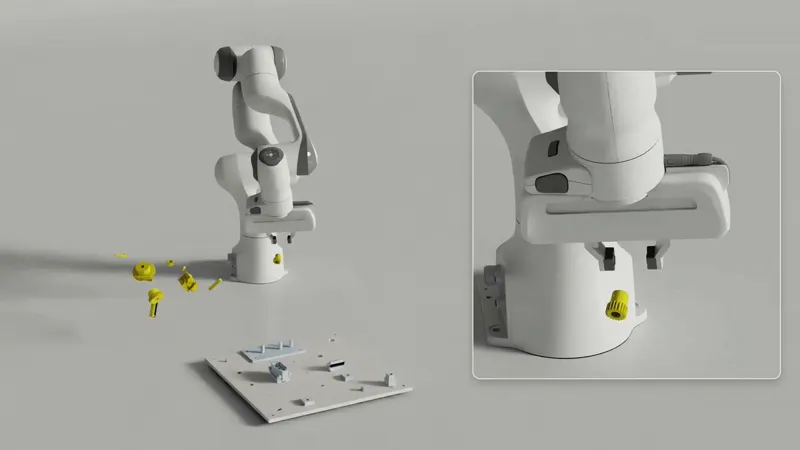
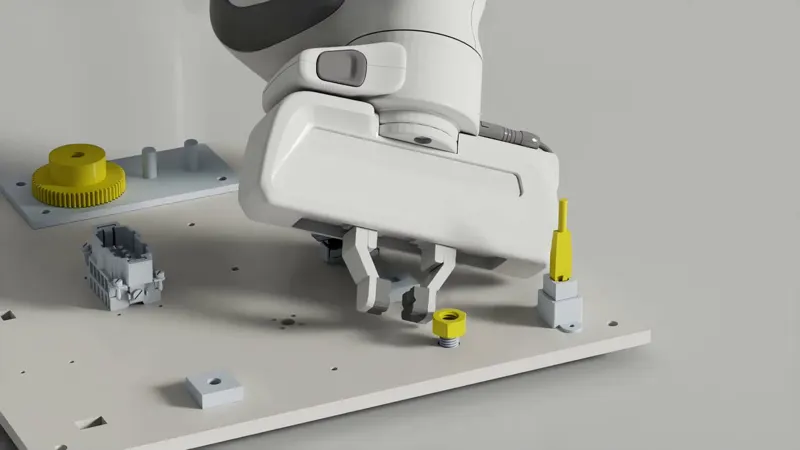
AlphaNIST 用单一强化学习策略完成 NIST 二十项精密装配,在全部任务上取得 98.2% 成功率,并仅凭末端二值奖励连续完成 10 个装配任务。
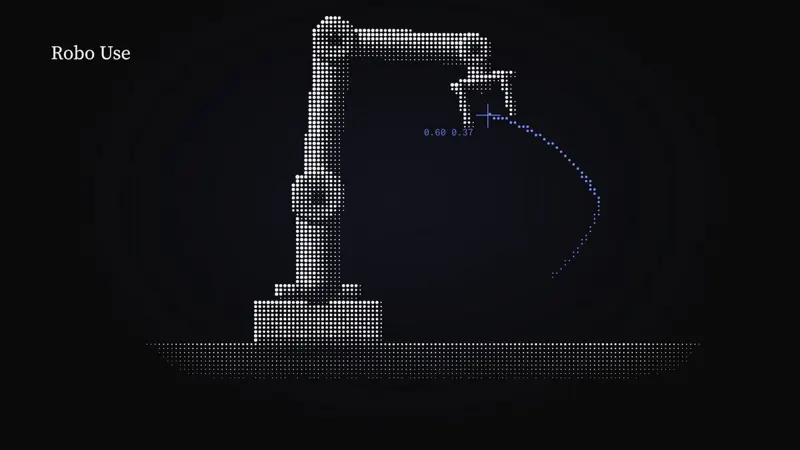
Robo Use 为智能体提供通往物理世界的 API:32 种 embodiment、100+ 场景、11 个智能体、2500+ 次试验,pip 一行接入。
AlphaNIST 线程首帖:只用二进制奖励加控制成本,在 20 项 NIST 装配任务上达到 98.2% 仿真成功率,无需密集奖励工程。
AlphaNIST 用单一二进制奖励从零训出一个策略,连续完成 10 项 NIST 装配任务;OmniReset 重置加 SGS 任务采样支撑多任务训练。
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。