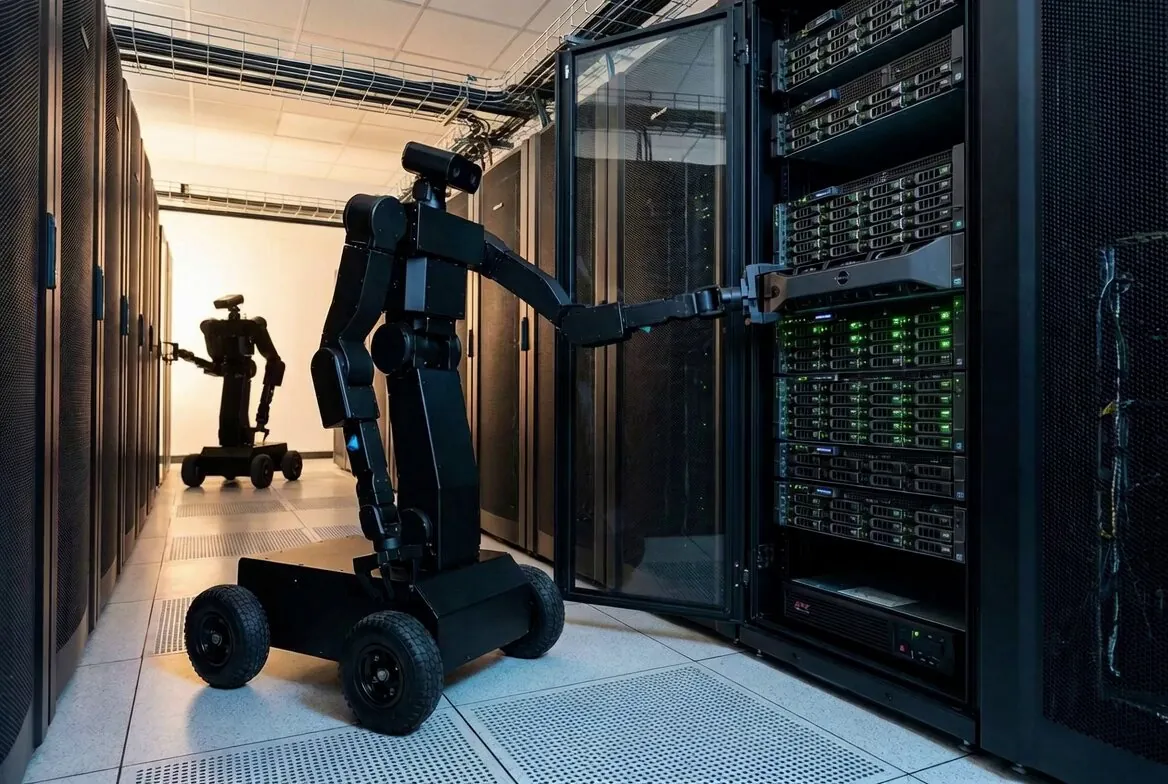
强化学习为何样本效率极低
视频加载中
视频加载中图灵奖得主指出纯奖励驱动的强化学习必须不断试错真实世界,缺乏世界模型导致样本效率存在下限
Category: research
Author: @cybernetic_lab
Date: 2026-07-31T00:00:00
Duration: 6.041s
图灵奖得主指出纯奖励驱动的强化学习必须不断试错真实世界,缺乏世界模型导致样本效率存在下限
 0:45
 0:06
 0:16
 0:46
 0:39
 0:19
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。