OneCanvas:把视频帧重投影成一张全景画布,让现成 2D VLM 直接学会 3D 空间推理——SQA3D/VSI-Bench/SPBench 三榜 SOTA,训练算力省一个数量级
视频加载中
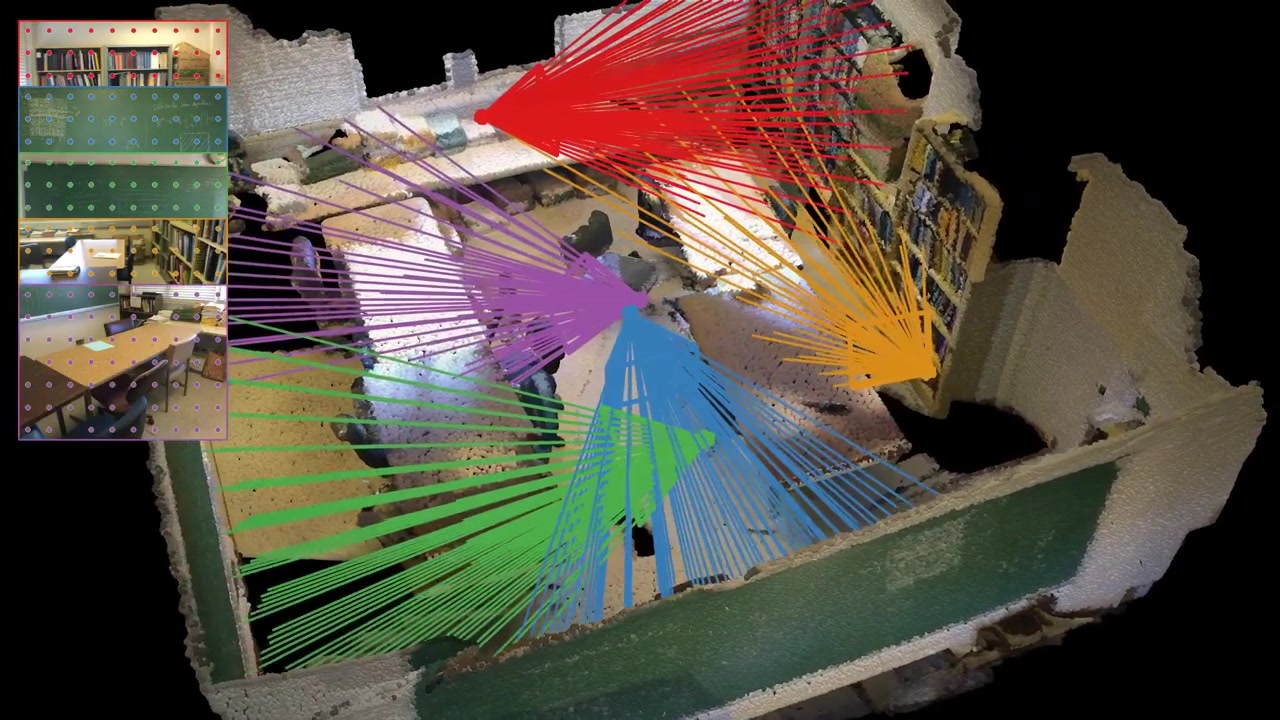
视频加载中TUM 教授 Matthias Nießner 团队(@baranowskibrt、@davech2y,arXiv 2606.19253,44 秒演示视频)发布 OneCanvas:不做复杂的几何编码器、不烧大训练预算,把 3D 场景理解「压」进一张图。方法分三步:①用冻结的 VLM 视觉编码器从各视角视频帧提取 patch 特征,借助度量深度与相机位姿反投影到世界坐标;②把每个 patch 放到一张等距柱状全景画布上——按其 3D 位置相对画布原点的连续经纬度放置,不栅格化到像素网格、不跨视角聚合,每个 patch 都是一个独立 token,共享同一空间坐标系;③给 patch 特征加上 3D 位置嵌入,补回坍缩到角度坐标时丢失的深度信息。预训练 VLM 把画布当普通图片消费,主干网络无需融合或大改。因为画布可以以任意位姿为中心,同一表示直接支持「以智能体自身视角为原点」的 situated reasoning——机器人与具身 AI 的刚需。更妙的是空间预训练课程:把真实图像的 patch 特征按程序化选择的 3D 位置放到空画布上,外观与大小/位置解耦,几何成为唯一可解信号——零人工标注地批量生成空间推理监督,并控制答案分布防止捷径学习。两阶段训练(Stage 1 LoRA+位置嵌入学几何,Stage 2 合并后用低秩适配器适配下游格式)。结果:SQA3D 65.3 EM@1(超此前 SOTA 2.3 分)、VSI-Bench 70.1(route planning +11.3)、SPBench 零样本 72.1(+4.8),训练算力比最强对手少一个数量级。
Category: perception
Author: @unknown
Date: 2026-06-19T00:00:00